Nature Medicine:3967篇临床预测模型论文仅12.2%含代码共享声明,14项可复现性特征参差
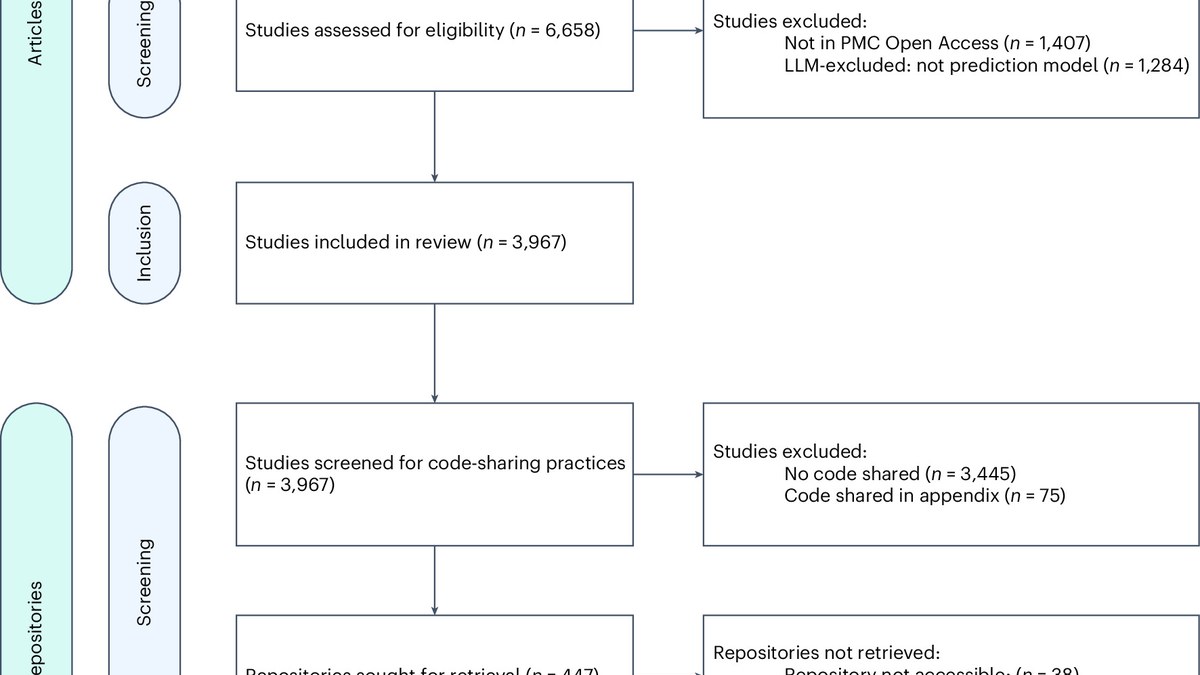
Nature Medicine于2026年10月9日在线发表一项范围综述:研究团队用大语言模型辅助流水线筛查引用TRIPOD或TRIPOD+AI的3967篇文献,提取代码仓库链接并按14项预设可复现性特征评估。其中482篇(12.2%)含代码共享声明,共享率在期刊与国别之间差异显著,仓库评估显示各项可复现性特征存在明显异质性。
3967篇论文筛出482份代码声明,12.2%这个分母要写清楚
事实报道 × 监管与合规专家 | 趋势前瞻 × 药企研发负责人 | 深度研报
2026年10月9日,Nature Medicine在线发表一项针对临床预测模型代码共享现状的系统性评估。研究团队以引用TRIPOD或TRIPOD+AI报告的文献为入口,共筛查3967篇文章,其中482篇含有代码共享声明,占比12.2%。
这个数字最容易被读成一句话:近九成的临床预测模型论文不给代码。方向大致没错,精度不够。分母是有条件的,分子衡量的也不是代码本身能不能跑起来。对合规侧的读者来说,这条研究的价值恰恰在于它把口径摆到了台面上,一项要写进规范的东西,先得说清它管的是哪一段。
开场:3967篇论文里,只有482篇留了代码的去处
临床预测模型是医学AI里最容易落地、也最容易出问题的一类研究。它的产物不是一句结论,而是一套别人可以拿去复算的公式与流程。代码因此不是附属材料,而是研究本体的一部分。缺了代码,读者能核对的就只剩正文里那几行公式与几张表。
TRIPOD与TRIPOD+AI是这一领域通行的报告规范,作用是对齐论文该交代哪些信息。它们长期把重点放在数据来源、样本定义、模型设定与性能报告上,对代码这一层的约束相对模糊,TRIPOD-Code的提出正是为了补上这一层。
所以这次评估的时机值得注意。它不是在给领域打分,而是在为一份尚未成文的规范做基线测量,摘要明确写到研究目的是为TRIPOD-Code报告规范的制定提供依据。先量现状、再定条款,这个顺序是对的;也正因如此,12.2%应当被读成基线,而不是终局判决。
12.2%的分母:3967篇是怎么被选出来的
先说分母。3967篇不是全部临床预测模型文献,而是引用过TRIPOD或TRIPOD+AI报告的那些文献。这是两层筛选:先是预测模型研究,再是其中愿意引用报告规范的那一批。
这个限定条件有个容易被忽略的偏向。引用报告规范本身是一种自我选择行为,愿意在论文里引TRIPOD的作者,通常也是对方法学规范更上心的那批人。换句话说,这3967篇大概率是领域里相对最讲究规范的一群。在这群人里有482篇给出代码声明,放到全体文献里比例只会更低。
正确的读法因此是:12.2%是在已关注报告规范的人群中测得的声明率,它不构成对全体文献的估计。反过来用,说成规范约束之下仍有九成不肯共享,属于把自我选择的方向读反了。
另一处口径在筛查环节。摘要提到流水线由大语言模型辅助,负责筛查、提取代码仓库链接、评估检索到的仓库三个环节。LLM参与意味着效率,也意味着误差会沿三个环节累积。摘要未给出人工复核的比例,也未给出筛查与提取的一致性与准确率指标,这是评估这批数字时最实的一处信息缺口。
14项特征:交出一串链接不等于别人能复现
再看分子。482篇是含代码共享声明的篇数,不是代码可取、更不是代码可运行的篇数。声明与可用之间隔着好几层:链接是否有效、仓库是否公开、有没有许可证、装不装得上、跑不跑得起来。
研究用14项预设的可复现性相关特征去评估检索到的仓库,说明作者承认了这一层差距,并把可复现性拆成了可核查的条目。这个拆解本身就是TRIPOD-Code最可能采纳的形态:规范要管的不是给不给,而是给到什么程度。
摘要给出的仓库评估结论是,各项可复现性特征之间存在明显异质性。这句话的分量不轻。它意味着即便在愿意给代码的这482篇里,质量也是参差的,某些特征满足度高,某些特征普遍缺失。对合规侧而言,不均匀比整体偏低更难处理,因为它没法用一条统一条款覆盖。
作者随后点明了除代码可得之外还需要明确的三件事:文档、依赖说明与可执行结构。这三件恰好对应复现失败最常见的三个原因,文档解决不知道怎么用,依赖说明解决装不上,可执行结构解决跑不通。把它们写进规范,比笼统要求共享代码可操作得多。
需要提醒的是,摘要未给出14项特征的具体清单,也未给出各项的满足率。异质性到什么程度、哪一项最薄弱,目前只能等正文或附录。
期刊与国别的落差:规范约束有多大作用
摘要给出的另一条结果是,代码共享率在不同期刊与不同国家之间差异显著。这条结果把问题从作者个人意愿推进到了制度层面。
如果共享率主要由作者自觉决定,差异应该更接近随机分布。期刊之间有落差,提示投稿要求确实在起作用;国家之间有落差,则提示资助与评价体系的导向差异也会传导到这一层。
这对规范制定是个好消息。既然约束能改变行为,一份被期刊与资助方共同采纳的TRIPOD-Code就有机会把12.2%往上推。
但这里要收住。摘要未给出具体期刊名称、国家名称与各自的数值,也未给出是否调整了研究类型、发表年份、资助来源等混杂因素的分析。差异显著只说明分组之间不均,不能直接推出某本期刊的政策导致了某一档共享率。因果链条需要更细的分层数据才能立住,现在还差一步。
冷静观察:TRIPOD-Code要管的,比给不给代码更多
先把没有的部分列出来。摘要未见14项特征的完整清单与各项满足率,未见LLM辅助筛查与提取环节的人工复核比例及一致性指标,未见具体期刊与国别的分层数值,未见对混杂因素的调整分析,也未见TRIPOD-Code本身的条目草案与发布时间表。这些缺席决定了它现在的身份是一份基线测量,不是一份可执行的合规清单。
因此正确的表述是:在引用TRIPOD或TRIPOD+AI的3967篇文献中,482篇含代码共享声明,声明率12.2%,已声明的仓库在14项可复现性特征上表现不均。不能写成九成论文造假,也不能写成临床预测模型的结果整体不可信。这项研究评估的是材料披露的充分性,不是这些研究结论的正确性,两者是不同层面的事,把它读成品控指控属于误读。
对研发端还有一层现实含义。一旦TRIPOD-Code落地,代码会连同文档、依赖说明与可执行结构一起进入审稿清单。届时受影响的不只是学术界,凡拿已发表模型做内部复用的团队,都要按同一套口径重新整理代码资产,提前准备的成本远低于事后补。
接下来该追问的是四件事。其一,14项特征的确切条目与各项满足率何时公布。其二,LLM辅助筛查的准确率与人工复核比例是多少,测量误差有多大。其三,期刊与国别的分层数据能否给出,差异是否由政策差异直接导致。其四,TRIPOD-Code的条目草案何时公开,文档、依赖说明与可执行结构会被写成强制项还是建议项。这四件事没有答案之前,12.2%应被当作基线使用,而不是结论。
原文链接:Nature Medicine论文
千方医数集编辑部 出品
