Nature Medicine同日两篇:Dresden本地部署医疗AI Agent达到云端水平,用一致性信号划出可自主处理的病例边界
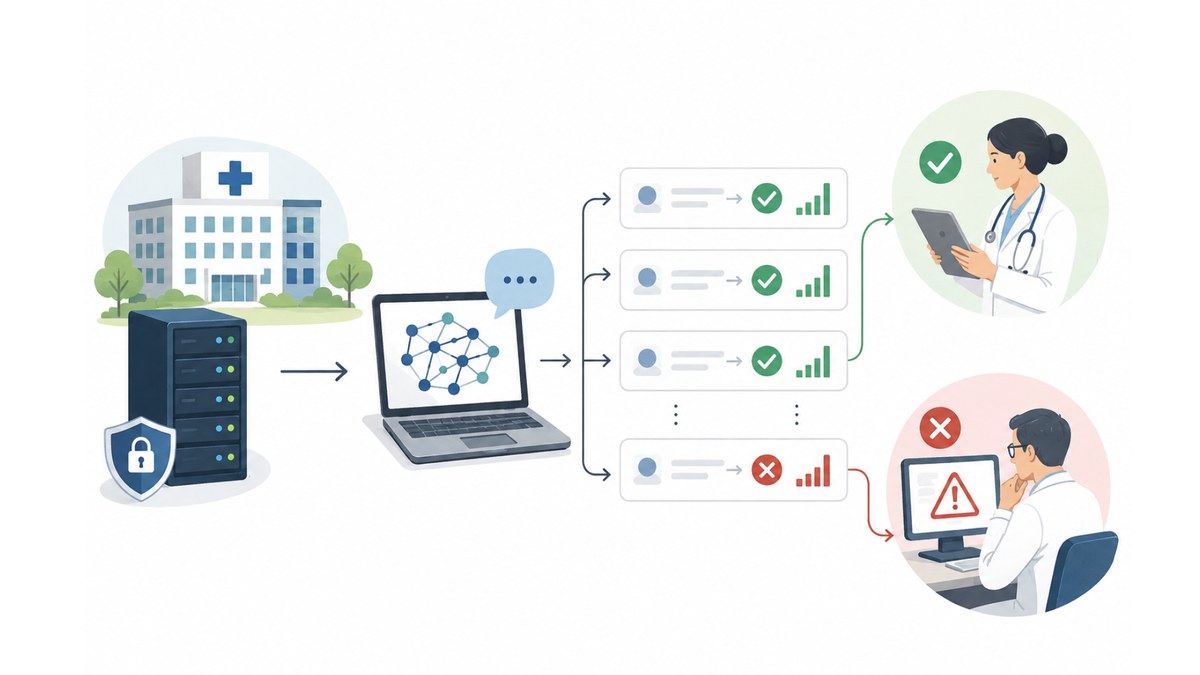
9月15日,德国德累斯顿工业大学Else Kröner Fresenius数字健康中心与德累斯顿大学医院团队在《Nature Medicine》发表研究,开发了一套完全本地部署的医疗AI Agent系统。该系统在来自MIMIC-IV数据的七病种基准上达到90.04%诊断准确率,接近云端基线GPT-5.2的90.7%;在四病种急性腹症基准上达83.8%。研究发现,模型在重复运行中是否给出一致诊断,是判断结果正确性最有效的单一指标(AUC 0.860,压力测试下0.875)。以0.90一致性阈值为界,系统自主保留49.4%的病例,这部分准确率达98.9%。
90%准确率背后:医院本地部署的AI Agent,用行为一致性给自己划定了下班线
数据视角 × 数据从业者与工程师 | 深度研报
2026年9月15日,《Nature Medicine》发表题为 On-Premise Medical AI Agents for Reliable Clinical Decision-Making 的论文。研究由德累斯顿工业大学Else Kröner Fresenius数字健康中心(EKFZ)与德累斯顿大学医院完成,通讯作者为该校临床人工智能教授Jakob Nikolas Kather,第一作者为Li Zhang。系统完全在医院本地基础设施内运行,模型与数据均不出院。主基准上七病种诊断准确率90.04%,接近云端基线GPT-5.2的90.7%。
一、开场:院内部署与可靠性判断,临床AI的两道门槛
这篇论文处理的是两个在工程上互相纠缠的问题。
第一个是部署位置。系统构建于2026年6月发布的MIRA AI Agent之上,完全在医院本地基础设施内运行,模型与数据均不出院。这意味着机构可以直接控制数据处理位置、模型版本、访问权限与监控流程。对医院IT与合规团队来说,这是一组可以被审计、被管理的变量。
第二个是可靠性判断。一个本地Agent给出诊断结论时,临床医生凭什么相信这一次的输出?论文没有停在准确率数字上,而是去量化决策时可用到的信号,试图回答系统在什么条件下可以自主、什么条件下必须交给人类。这两道门槛,构成了院内临床AI能否成立的完整条件。
二、成绩单:90.04%与83.8%两个基准,和云端基线差在哪里
评估方式值得先说清楚。在模拟环境中,医师AI Agent与患者AI Agent交互,病例基于匿名化电子患者数据,包含诊断、实验室值、用药与体格检查发现。医师Agent可以追问并索取临床与化验结果,据此给出诊断与理由。测试病种覆盖阑尾炎、胆囊炎、肺炎、肺栓塞、尿路感染等。
主基准上,七病种任务取得90.04%的诊断准确率。对照的云端基线是GPT-5.2的90.7%,该基准来自MIMIC-IV数据。0.66个百分点的差距,在临床AI的评价体系里基本可以视为同一水平。这个对照的意义在于,本地部署没有以显著的准确性代价换取数据主权。
第二组数据来自另一个基准:四病种急性腹症2400例,准确率83.8%。外部评估使用VivaBench的990个病例,覆盖十个专科组。多基准、多来源的验证结构,比单一高分更能说明系统的实际边界。
三、关键发现:行为一致性为什么比模型自评置信度更可信
论文里最有工程价值的发现,是团队量化的三类决策时信号:内部似然,即模型内部置信度;语言类信号;以及行为稳定性。
结果指向一个明确结论。行为一致性对正确与错误诊断的区分能力最强,AUC达到0.860,压力测试下进一步升到0.875。而模型的内部似然分数预测正确性的效果较弱。
压力测试暴露了更尖锐的问题。移除系统中的可靠信息后,诊断准确率大幅下降,但模型的概率类信号没有反映出来。也就是说,模型变错的时候,它的自评置信度没有相应地变低。对于一个要进入临床决策的系统,这是危险的性质。
行为一致性的逻辑不同。它观察的不是模型说自己有多确定,而是它在多次交互中的行为是否稳定。这个信号不需要模型自我报告,也难以被模型的表述习惯带偏。对做评测的人来说,这是一个可以直接测量的对象。
四、选择性自主:49.4%与98.9%这组数字如何划定人机边界
基于上面的信号,团队给出了一个可执行的机制:以0.90行为一致性为阈值,系统自主保留49.4%的病例,在这个子集上准确率达到98.9%;低于阈值的病例转交医务人员复核。
这组数字的读法值得细想。系统主动放弃了对一半以上病例的自主权,换来的是保留子集上接近99%的准确率。这不是把模型能力拉满的做法,而是把它切成两段:一段交给机器高速处理,一段交给人。
医生一致性验证给出了另一层支持:181个随机抽取病例中,自动化评估与医生共识的一致性超过90%。这说明自动化的判断标准与临床医生的实际判断没有出现系统性偏离。
Kather的表述与这套机制一致。他说目标是具有选择性自主权的AI Agent,系统应支持临床决策但绝不完全接管,AI生成结果必须让临床医生可理解、并明确标示不确定性;诊断与治疗的责任始终属于人类。
五、行业含义:模型不是护城河,可靠性层才是
Kather还有一个判断值得记录。他认为要求放缓AI发展的呼吁方向不对,医学领域仍在早期,患者获益还很少,应当更快推进,关键是安全、透明并保持数据主权,例如全部在医院内运行。
这个立场与论文的技术选择互为支撑。本地部署解决数据主权,行为一致性解决可靠性判断,选择性自主解决责任边界。三者组合起来,指向一个工程判断:在医院场景里,把一个大模型接进来并不构成门槛,能判断它何时可信、何时该停的可靠性层才是。
对做医疗AI工程的人来说,这篇论文的可取之处在于它没有把准确率当作终点。90%的准确率只说明模型能用,行为一致性阈值与49.4%的自主比例才说明系统敢用在哪。
原文链接:TU Dresden EKFZ
千方医数集编辑部 出品
