Nature Biotechnology:Visionary AI用眼底图像预测子痫前期,开发队列AUC 0.91,外部验证降至0.81
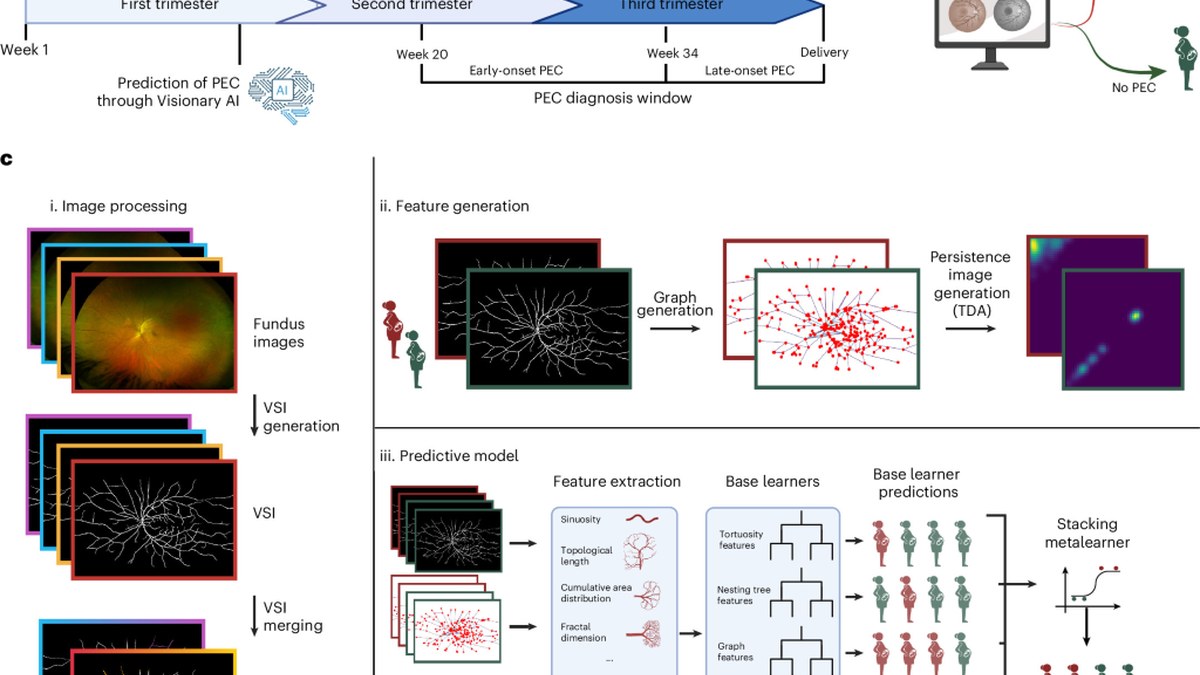
2026年10月6日发表于Nature Biotechnology的研究提出Visionary AI,一个将视网膜成像与图论血管建模结合的可解释平台,用于在临床发病前预测妊娠期高血压疾病。前瞻性开发队列1267例妊娠中,全人群对照设定下预测子痫前期AUC为0.91、平均精度0.81;经稳定性优化的模型未经重训练迁移至独立外部验证队列后,AUC降至0.81、平均精度0.68。
眼底影像进模型:开发队列0.91,外部队列0.81
趋势前瞻 × 医疗数据从业者 | 数据视角 × 药企研发负责人 | 深度研报
2026年10月6日,Nature Biotechnology在线刊出一篇方法学论文,提出名为Visionary AI的可解释平台。该平台把视网膜成像与基于图的血管建模结合在一起,目标是在临床发病之前预测妊娠期高血压疾病。论文的投稿日期为2025年12月8日,接收日期为2026年8月11日。
这轮发布里最该被记住的,是两个相差0.10的AUC:开发队列内的0.91,与外部独立验证队列上的0.81。方法学论文通常先讲机制,但从数据口径看,先看这两个数的落差,更能判断它现在所处的位置。
开场:怀孕六周拍一张眼底照,能算出二十周之后的风险吗
时间线是这项研究最先要讲清楚的事。外部验证限定在早孕期影像,即孕6至13周采集的超广角眼底图片;而结局判定发生在孕20周之后,按临床标准确定是否发生子痫前期。也就是说,一张影像与一个结局之间隔着至少七周,模型要预测的不是当下已存在的病变,而是尚未出现的临床事件。
对医疗数据从业者而言,这条时间线决定了数据集的搭建方式。影像采集窗口被压在早孕期的七周之内,入组节奏必须与产前检查流程对齐;结局字段要在二十周之后回填,随访完整性直接决定标签质量。中途的转院、失访与分娩结局变更,每一环都会打到这条链的可靠性上。
还有一层口径问题在公开材料里没有交待:外部队列的影像由什么设备采集,采用哪种成像协议,是否跨机构多点采集。这些字段如果不固定,模型学到的可能既有血管特征,也有设备与站点的痕迹。要做可复用的数据资产,先把这些元数据字段钉下来,比再多跑一遍模型更优先。
0.91是怎么来的:1267例、留一交叉验证
0.91来自前瞻性开发队列的1267例妊娠。在全人群对照的设定下,同一数据集内预测子痫前期得到AUC 0.91,平均精度AP为0.81。开发阶段采用留一交叉验证,作者给出的理由是最大化稀有结局的训练数据利用。
站在药物与器械研发的视角,AP比AUC更值得盯。子痫前期在开发队列中属于占比较低的结局,阳性样本稀少时AUC容易被大量阴性样本撑高,AP更贴近筛查场景里真实要承担的假阳性负担。0.91与0.81这两个数字并排放出来,本身已经说明阳性样本的识别并不轻松。
口径问题同样要指出:留一交叉验证估计的是同一队列内部的泛化能力,不构成对外部人群的证据。开发队列虽为前瞻性收集,但样本来源单一,研究过程中没有留出独立的外部测试集。1267例放在妊娠结局预测里不算小样本,可一旦按结局阳性切一刀,真正参与学习的阳性例数就相当有限,这正是作者选择留一法的原因,也是这个数字不能被直接当作部署性能的理由。
0.81:换个队列,掉了0.10
迁移是一次没有重训练的硬迁徙。经稳定性优化后的模型未经任何重训练,直接迁移至独立的外部验证队列,也就是NYU队列,得到AUC 0.81、AP 0.68。AUC下降0.10,AP下降0.13。
不重训练是这项研究里少见的严格设定。多数迁移工作会在目标队列上微调或重新标定,一旦允许这一步,性能提升中属于目标域数据贡献的部分就难以拆分。Visionary AI选择直接迁移,等于把模型的跨域适应性单独拎出来受检验,代价是数字不好看。
作者声称该方法在临床基准与深度学习基准之上,但这句定位建立在自己的实验之上,属作者自评。更要紧的是分母的缺失:外部验证队列的精确样本量在摘要中没有给出,第三方流传的数字未在原文页核实,不能引用。没有分母就没有置信区间,0.81这个点的可信范围无从判断。NYU队列限定早孕期超广角眼底影像这一条已经写明,除此之外的人口构成、种族分布与基线风险,公开信息中未见。
三模块流程:可解释性做在哪一层
流程由三段串起来:先由影像生成血管分割图,再从中提取图论特征、几何特征与拓扑特征,最后送入一个堆叠集成元学习器。可解释性落在中间那一层——模型给出的不是黑箱向量,而是可以被度量、被画出来的人类可读血管结构指标。
这个设计对数据链路的要求随之改变。分割是整条链的第一步,分割质量直接决定下游所有图谱特征的含义,而分割结果对设备、光照与图像质量敏感。上下游是强耦合关系:一旦换设备或换采集协议,需要重验的不只是最后的元学习器,还有分割这一层。
对研发负责人来说,中间层的存在给了另一种可能:这批血管图谱特征本身可以作为独立的数据资产,与结局标签解耦,用于其他妊娠并发症或血管相关结局的建模。能不能复用,取决于特征定义与提取代码是否随论文一并公开,这一点公开信息中未见。
冷静观察:外部队列多大没说,这一步离筛查还远
先把不能确定的事列清楚。外部验证队列的精确样本量未给出;卷期页码未获取;敏感度与特异度的切点值未获取。作者关于超越临床基准与深度学习基准的表述是自评,不是独立复核的结论。论文此前还存在一个medRxiv预印本版本,日期为2025年11月27日,与本版并非同一版本,两组数字不可混用。这项工作是可解释AI的方法学研究,不是获批产品,也不应被写成能够用于临床筛查的工具。
接下来要追问的是三类证据。第一类是分母与区间:只要外部队列样本量不披露,0.81就只是一个点估计,无法做稳定性判断。第二类是标定:AUC不反映预测概率的准确性,筛查要看的是不同阈值下的净获益,而什么阈值对应可接受的漏诊水平,论文没有给出。第三类是分层:按孕周、按基线风险、按不同采集设备分层的结果目前缺位,无法确定模型在哪个亚群里真正可用。对准备做前瞻性数据建设的一方来说,下一步要做的不是再复现一遍0.91,而是把外部队列的入组标准、设备清单与随访口径先写成可执行的数据字典。
原文链接:Nature Biotechnology(DOI 10.41587-026-03303-0)
千方医数集编辑部 出品
