Journal of Medical Systems:德国风湿病指南聊天机器人13中心6291问,92.9%好评但指南完全依从仅45.0%
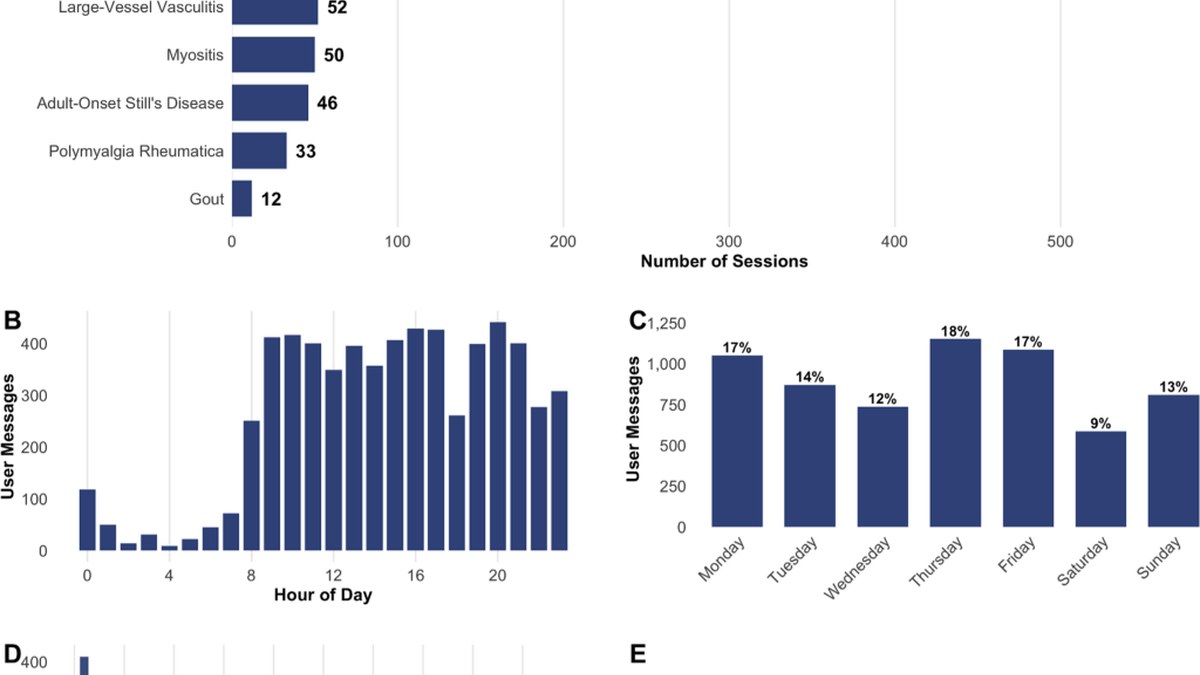
2026年10月5日在线发表于Journal of Medical Systems的研究报告了10个基于德国指南共同开发的疾病专用聊天机器人,经13家风湿病中心与6个患者组织部署。2025年9月至2026年1月共记录6291条提问;2671条用户评分中2481条(92.9%)为正面。以大模型为评审的六维评估中95.3%的回答被评为完全安全、79.1%完全正确,但单独评估的指南依从性中仅45.0%被评为完全依从,与医师评估一致性弱。
六千余次提问留下九成好评,完全依从指南的只有45.0%
影响分析 × 监管与合规专家 | 事实报道 × AI技术供应商/创业者 | 深度研报
2026年10月5日,Journal of Medical Systems在线发表一项真实世界部署研究,文献标识为PMID 42830368、DOI 10.1007/s10916-026-02470-6。研究团队围绕德国风湿病指南共同开发了10个疾病专用聊天机器人,通过13家风湿病中心与6个患者组织部署。原文页面可亲访,摘要已交叉核实。需要说明的是,这里采用的是在线发表口径,与正式卷期页码不是同一回事。
部署规模之外,这批数据最值得注意的是评价侧的落差:用户给出好评的比例为92.9%,被评审判定完全依从指南的比例为45.0%。两个数字来自两条互不相干的评估链路,它们之间的缝隙,正是这类产品进入临床流程前必须先解释清楚的地方。
开场:6291条提问,来自13家中心和6个患者组织
记录周期为2025年9月至2026年1月,共记录6291条提问。部署渠道有两个:13家风湿病中心和6个患者组织。前者对应诊室之外的延伸咨询场景,后者对应患者自助检索,两类渠道的使用者结构并不相同,同一套回答需要同时满足两种期待。
提问内容被归纳为13类,占比最高的是疾病特异问题,为50.2%;其次是用药与监测,为37.3%;诊断相关问题占28.2%。这组百分比合计超过100%,说明分类并非互斥口径,单次提问可能同时落入多个类别,读这组数字时应按各类占比分别理解。
对技术供应方而言,这个分布就是产品需求清单。用药与监测占到三分之一以上,意味着大量提问涉及具体药物名称、剂量调整与随访安排,属于容错空间最小的一类内容,回答一旦偏离指南,后果直接落在患者身上。另有263次交互中机器人明确无法作答,占6291条的4.2%,这部分是拒答链路的实测规模。
92.9%好评:用户满意的是什么
用户自愿给出的评分共2671条,其中2481条为正面评价,占92.9%。需要注意的是评分的自愿属性:2671条只是6291条提问中的一部分,谁愿意留下评分本身就是一个筛选过程,这个比例不能直接代表全部使用者。
另一组数据来自问卷。共回收602份问卷,84.6%认为系统易用,84.1%认为答案易懂,80.2%认为它是对患者教育的有用补充。三项关注的分别是操作、表达与定位,其中第三项最接近产品价值判断,比例也最低。
负面评价的构成给出了改进方向。负面评分共190条,最常见的原因是细节不足,计125条,占65.8%。也就是说,用户的不满主要不在答错,而在答得太粗。这个信号对产品迭代很实用:补充分层信息、给出更具体的限定条件,比单纯调高答案的自信程度更能解决问题。
45.0%完全依从:指南这一关没过去
指南依从性是单独评估的一项,结果是被评为完全依从的回答仅占45.0%。这条数据与前面的好评数据放在一起,构成了这批结果里最硬的一道落差:九成以上的人觉得好用,不到一半的回答被认为完全照着指南说。
监管视角下,这条数字的含义是明确的。患者教育的合规底线不是用户主观感受,而是内容来源与现行指南的一致程度。当一半以上的回答未被判定为完全依从时,产品就不能被描述为指南的执行载体,而只能是一个带辅助性质的信息工具。要素缺漏、表述偏移、版本滞后,哪一种情形占比最高,公开信息中未见。
还有一层缺口要认真对待:论文提到机器人评估结果与医师评估的一致性为弱,但没有给出具体统计量,无论是kappa还是AC1都未披露。弱一致性通常意味着评审口径本身存在分歧,而这种分歧有多大、集中在哪些类型的问题上,目前无法量化。在医师作为责任主体的场景里,这一点决定了人工复核该设在多深的环节。
95.3%安全、79.1%正确:谁在打分
这两条数字来自以大模型为评审的六维评估,即所谓LLM-as-a-judge:95.3%的回答被评为完全安全,79.1%被评为完全正确。安全性高于正确性,符合这类评审的一般形态——回避明显有害内容的难度,低于给出完全准确内容的难度。
打分者是谁,是这个数字的前提条件。评估由大模型完成,评审方与被评审方同属一类技术,存在自评偏倚。同一族模型更容易认可彼此的表述习惯与信息组织方式,而不一定会识别同类模型共同存在的知识缺口。这条偏倚的方向通常是高估,因此95.3%与79.1%更适合被理解为上界。
同样重要的是分母没有交待。95.3%与79.1%所基于的评估样本量未说明,是从6291条提问中抽样,还是另有一批标准化问答,公开信息中未见。样本抽取方式决定了这两条数字能否推广到全部提问。此外,6291条提问对应的独立用户数未获取,基座大模型的名称与版本也未获取——后者直接影响版本更新后的可复现性。
冷静观察:满意度和可靠性是两件事,中间隔着一致性
三组分数的口径互不相同:用户评分来自自愿填写的使用者,问卷来自602名作答者,质量与安全分数来自大模型评审。它们之间不能直接相减,也不能互为佐证。把它们并列时,必须先说明各自的分母与评价主体,否则92.9%与45.0%的落差会被误读成结论矛盾。
现在还不能确定的部分要逐条列出。与医师评估一致性的具体统计量未给出;95.3%与79.1%的评估样本量未说明;6291条提问对应的独立用户数、基座大模型名称与版本均未获取;未被判定完全依从的那部分回答,偏离类型与分布未见披露。这四项决定了这批数据能否支撑任何对外宣称。
往前走需要补的证据有三类。其一,用人类评审替换或并行大模型评审,并给出一致性统计量,让45.0%这个数有一个可复核的判定标准。其二,建设单位、13家中心与6个患者组织之间的版本同步与更新机制写明指南版本迭代时的应答口径,这是指南类产品的合规要件。其三,把未作答的4.2%单独做成一条监控指标,拒答率上升或下降本身就能反映知识库覆盖范围的变化。在这三项补齐之前,更稳妥的定位是:一个受患者欢迎的信息补充渠道,还不是可以独立承担医学建议的工具。
原文链接:Journal of Medical Systems(DOI 10.1007/s10916-026-02470-6)
千方医数集编辑部 出品
