HDOCK-Multimer反超AlphaFold3:对接加组合装配拿下大型蛋白复合物
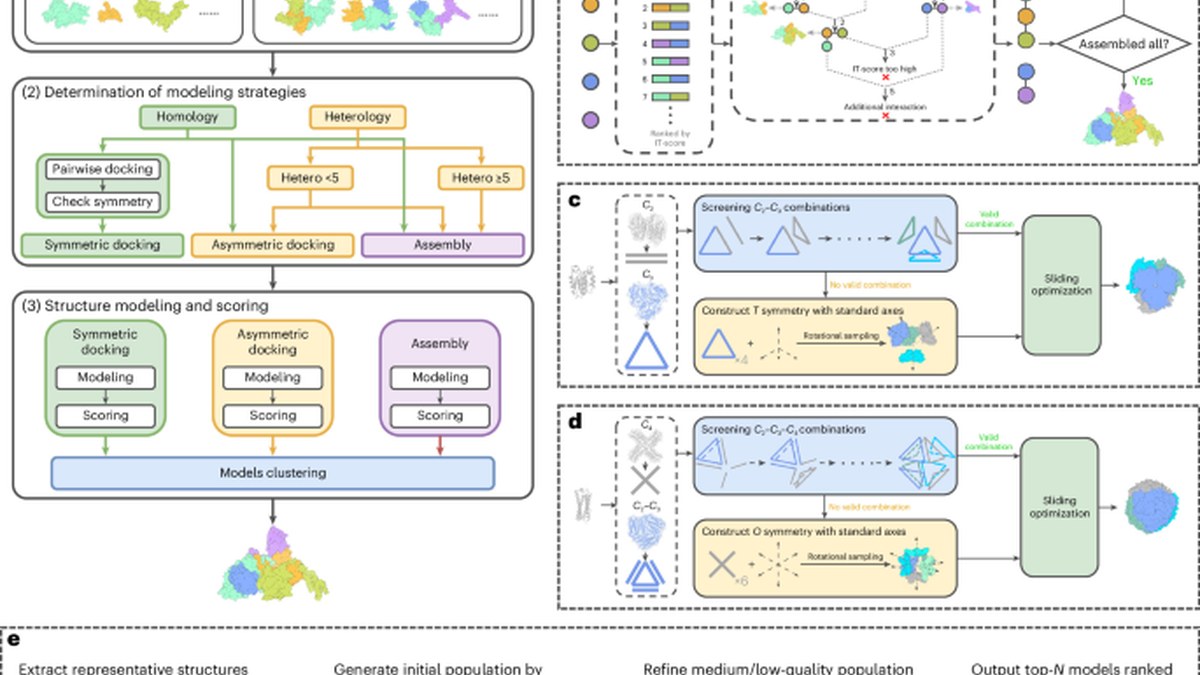
《Nature Computational Science》于2026年10月14日上线一项研究,提出名为HDOCK-Multimer(HDM)的大型蛋白质复合物结构预测框架。端到端方法在处理大体量、多链复杂相互作用时仍吃力:对接方法能处理大蛋白却受困于多链组合的巨大结合空间,装配方法则严重依赖子组件的预测质量。HDM把两条路结合,通过对接降低对子组件质量的依赖,同时通过装配利用子组件间的成对相互作用。评测覆盖三个基准集:35个大型异源多聚体复合物、172个大型蛋白质复合物与7个CASP15目标。结果显示HDM大幅超越当前最优方法,包括CombFold、MoLPC、AlphaFold-Multimer与AlphaFold3。此外HDM还展示出预测化学计量的能力。
HDOCK-Multimer问世:对接加组合装配拿下大型蛋白复合物,基准集超越AlphaFold3
事实报道 × AI技术供应商/创业者 | 数据视角 × 药企研发负责人 | 产品发布
开场:大型蛋白复合物是端到端预测方法最难啃的一块
蛋白质在体内很少单打独斗。它们通常以复合物 (Complex) 的形式参与物质运输、信号转导与基因调控,组装体的结构表征因此成为理解分子机制、推进相关药物发现的共同前提。问题在于,大型蛋白质复合物恰恰是端到端预测方法最难啃的一块。
难在两个方向上。一是体量,链的数目和残基总数一旦上去,计算成本迅速超过可用上限,端到端模型要把整条序列作为一个整体求解,内存占用随之上升;二是复杂度,多条链之间的相互作用彼此牵制,界面配对的可能性随链数叠加,错误一旦形成就缺少修正入口。这两点叠加的结果是,端到端方法在小型复合物上的经验难以直接外推到大型组装体。
也正因为如此,大体量、多链复杂相互作用成为检验任何结构预测方法时绕不开的一组条件。论文背景给出的工程约束很直观:AlphaFold-Multimer v2在显存为40GB的A100上仅能处理约3300个残基 (Residue),AlphaFold3服务器端输入上限为5000个残基,本地执行约为5120个残基。对这些尺度之上的目标,端到端路线往往连跑起来都困难。
2026年10月14日,《Nature Computational Science》上线一项研究,提出名为HDOCK-Multimer(简称HDM)的大型蛋白质复合物结构预测框架,试图给这条老问题提供一条组合式的解法。
两条路各有短板:对接算不动多链组合,装配依赖子组件质量
在HDM之前,研究者面对大型蛋白质复合物,基本沿着两条并行推进、互不替代的路径走。
第一条是分子对接 (Molecular Docking) 路线。它的长处是能处理大蛋白,在探索界面相对取向时有较大的自由度,不必把整条链的构象一次性求解出来,对大体量目标的适应性反而优于端到端模型。代价是要面对多链组合带来的巨大结合空间:参与组装的链越多,可能的配对方式越多,搜索规模迅速膨胀,采样不足会漏掉正确解,采样过量则难以收敛,精度和速度难以兼顾。
第二条是组合装配 (Combinatorial Assembly) 路线。它换了个思路,先给出子组件,再把子组件以组合算法拼装成完整结构,绕开了全局搜索的开销。但这把可靠性押在了上游:装配方法严重依赖子组件的预测质量,某个单体或亚复合物的结构如果出现偏差,误差会沿着装配链条向上传导,且缺少一个能在后期把偏差拉回来的环节。
两条路的短板彼此错位,也就构成了组合优化的空间。
HDM怎么解:用对接降低依赖,用装配利用成对相互作用
HDM的定位很明确:一个整合对接与组合装配的大型蛋白质复合物结构预测框架,而不是在其中一条路上继续加码。它把两条成熟路线各自的可用部分保留下来,把彼此的短板交由对方覆盖。
框架的一侧用对接来降低对子组件质量的依赖。引入对接环节之后,子组件之间的相对关系可以在装配过程中被重新审视和调整,上游结构不够准确时,后续环节仍有机会给出更合理的取向安排,误差传导不再是单向的死结。
另一侧用装配来利用子组件间的成对相互作用 (Pairwise Interaction)。装配在这里不只是把已求解的部件摆放到位,而是把成对相互作用作为约束信号使用,让组合过程能在巨大的结合空间中有依据地收敛,而不必盲搜所有可能。
合起来看,分工是清楚的:对接负责摊薄对上游质量的依赖,装配负责把多链之间的相互作用用足。前者对应组合装配路线的痼疾,后者对应分子对接路线的瓶颈。
除结构本身,HDM还展示出预测化学计量 (Stoichiometry) 的能力,并且能够在不输入化学计量的情况下建模复合物。对组装状态尚未理清的目标,这一点省去了一个前置假设环节。
三个基准集:大幅超越CombFold、MoLPC、AlphaFold-Multimer与AlphaFold3
评测在三个基准集上完成,规模与目标类型各有侧重。
第一个基准集为35个大型异源多聚体复合物 (Heteromeric Complex),考验的是不同种类链之间的识别与配对。第二个基准集为172个大型蛋白质复合物,覆盖更大的尺度范围。第三个基准集为7个CASP15目标,属于社区公认的盲测场景,能够检验方法在没有先行参考时的表现。三者叠加,比单一数据集的说服力更完整。
在这三个基准集上,HDM大幅超越当前最优方法,包括CombFold、MoLPC、AlphaFold-Multimer与AlphaFold3。需要注意的是,论文公开的结果集中在「大幅超越」这一相对关系,并未给出统一的提升幅度口径,跨榜单排名也只能在同一评测条件下理解。
冷静观察:基准集上的超越不等于药物发现管线里的实测收益
把结论放回边界内看:上述超越成立于三个基准集的评测条件之内,基准集上的超越不等于药物发现管线里的实测收益。
落到药企研发负责人的视角,真正需要核算的是另一组问题。目标类型是否覆盖自家关心的复合物家族,子组件从哪来、质量如何保证,一次完整预测的时间与算力开销是否可接受,输出的结构能否直接接进下游的分子对接与先导化合物优化环节。这些变量都在论文评测的范围之外,也没有出现在公开材料里。
同样要留意的还有化学计量预测的可用性边界。具备预测能力,与在具体靶点上给出可复核的结果,是两个不同的层级,前者成立不能直接推出后者。
因此,把HDM放进视野的稳妥方式,是把它视作一个值得验证的工具候选,而不是一份已经兑现的产能承诺。它在三个基准集上的表现足以说明路线可行,至于能否转化为工作流里的实际收益,仍要等到在真实项目中跑完一轮才有答案。
原文链接:Nature Computational Science
千方医数集编辑部 出品
