Communications Medicine:AEGIS用合成CT扩样本预测免疫化疗病理缓解,外验AUC从0.642升至0.784
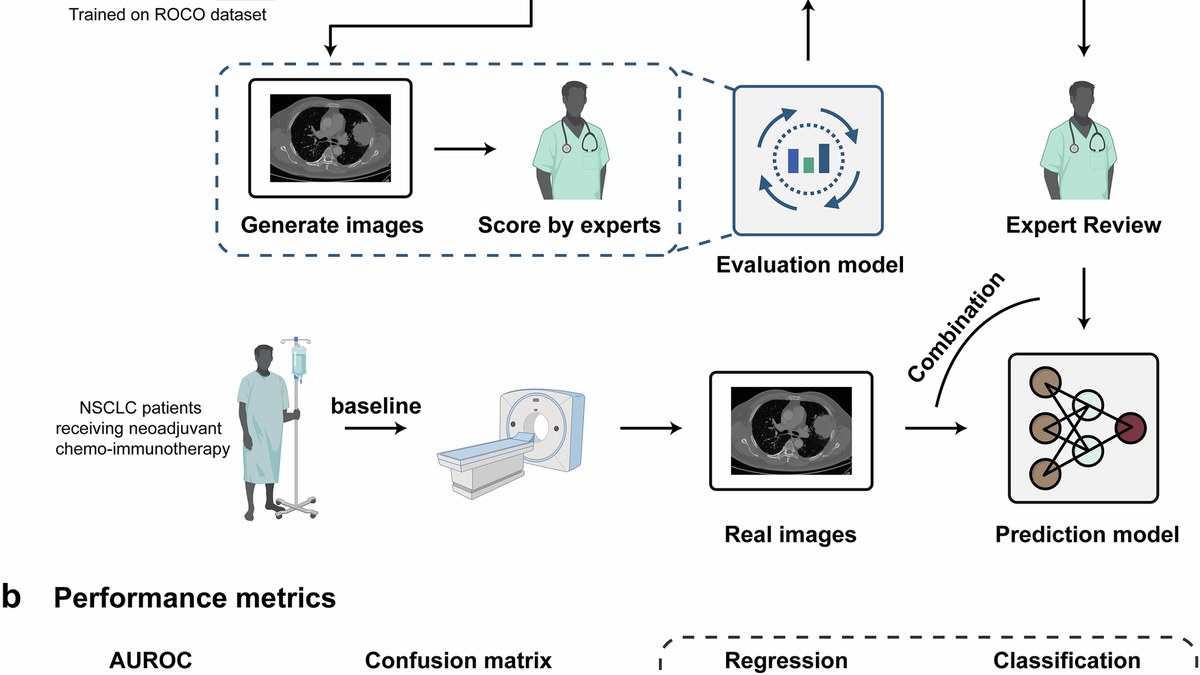
Communications Medicine于2026年10月5日在线发表AEGIS:一个面向非小细胞肺癌新辅助免疫化疗病理缓解预测的AI与专家协作生成式整合系统,用基线CT做预测。这项回顾性研究纳入两个中心320例患者,框架整合稳定扩散模型、LoRA微调、质量评估与强化学习;在外部验证队列中,二分类模型AUC由0.642提升至0.784。
合成CT把AUC推到0.784:补上的是数据量,不是证据等级
趋势前瞻 × 药企研发负责人 | 数据视角 × AI技术供应商/创业者 | 深度研报
2026年10月5日,Communications Medicine在线发表一项概念验证研究:团队提出AEGIS,即AI与专家协作的生成式整合系统,用生成式模型产出合成CT图像并与真实图像混合训练,目标是用新辅助治疗前的基线CT预测非小细胞肺癌新辅助免疫化疗的病理缓解。回顾性研究纳入两个中心的320例患者,外部验证上二分类AUC由0.642提升至0.784,三分类准确率由62.56%提升至78.97%,回归R2由0.327提升至0.525。
对药企研发负责人而言,这篇论文的分量不在三个数字的涨幅,而在它给出了一条绕开队列积累的建模路径;对技术供应方而言,真正要算清的是0.784这个数是在什么数据配比与外部队列规模上取得的,这决定了它能进入验证计划还是只能停在论文里。
开场:新疗法来了,可用来建模的病例还没攒够
新辅助免疫化疗进入非小细胞肺癌的临床实践,带来了新的疗效预判需求:治疗前的影像能不能提前看出病理缓解。这是典型的影像建模命题,但它撞上了一个更前置的约束——作为新疗法,可用于模型开发的临床队列还不够。
这个约束的具体形态是:病例数不足、中心数有限、终点标签的采集窗口刚打开。回顾性两个中心320例患者、使用新辅助治疗前采集的CT,就是这项研究拿到的全部真实数据。对做过医学影像模型的人来说,这个量级配上多分类终点,训练出的模型在外部队列上表现不稳,是可以预期的。
论文的处理思路不是等队列,而是用合成数据补量。这个转向把问题从等待数据重新定义为制造数据,而制造数据带来的收益与风险,正是下文要拆的两条线索。
一套四环节框架:生成、微调、筛图、再强化
AEGIS的框架由四个环节组成:稳定扩散模型、LoRA微调、质量评估、强化学习。四个环节各司其职,合起来是一条从生成到筛选再到反馈的闭环。
稳定扩散模型负责产出合成CT图像,这是量的来源。LoRA微调解决的是域适配:通用生成模型的输出分布与医学CT差别很大,用少量真实数据做低秩适配,是把生成结果拉进目标域的常见做法。
第三个环节质量评估是这条链路里最容易被跳过、也最关键的一环。生成模型会产出解剖结构不合理、纹理分布偏离真实CT的样本,若不加筛选直接混入训练集,模型学到的就可能是生成器自身的伪影而非疾病信号。质量评估的作用是把这类样本挡在训练之外。
强化学习作为最后一环,把质量评估的信号回传给生成过程,让后续生成的样本更可能通过筛选。需要说清的是,质量评估标准如何量化、由谁判定,摘要未给出;专家介入具体发生在哪个环节,摘要同样未给出。这两点决定了这条闭环能否被第三方复现。
0.642到0.784:500%混合训练到底加了什么
二分类把终点分为PR与Non-PR两类,外部验证AUC由0.642提升至0.784。这个提升的前提条件必须一起读:论文写明它是通过500%混合训练取得的。
500%这个写法最容易被误读,需要先把口径钉死。它是合成数据相对真实数据的混合比例,按字面理解为合成图像量约为真实图像量的5倍;它既不是AUC提升了500%,也不是患者数增加到原来的5倍,更不是模型准确率的百分比。换句话说,0.784对应的是一个特定的高合成占比配置,不是一个脱离配比而存在的固定能力值。
这里有三处信息缺口。其一,该比例的定义方式未给出,是按图像张数、按训练批次还是按患者折算,不清楚。其二,摘要未给出不同混合比例下的性能曲线,因此无法判断0.784是否处在最优区间,也无法判断继续提高比例是继续上涨还是转为下降。其三,基线0.642与0.784之间除混合比例外是否还有其他配置差异,摘要未说明。
对技术供应方来说,这一节的结论是:先确认能接受多大的合成占比,再谈这个AUC。
三档指标齐涨:准确率与回归表现怎么读
三档指标一起上涨,是这篇论文最直观的结果,也是最容易读过头的地方。
三分类把终点分为CPR、MPR与Non-PR,外部验证准确率由62.56%提升至78.97%。准确率的读法要先看类别分布:三分类且类别不均衡时,准确率会被多数类抬高,摘要未给出各类别构成与外部验证上的混淆矩阵,因此78.97%无法换算成对少数类的识别能力。
回归分析把缓解当作连续量处理,外部验证R2由0.327提升至0.525。R2从0.327起步说明基线模型对连续缓解程度的解释力有限,0.525仍属中等水平,意味着仍有相当部分的变异未被模型解释。
论文还给出一条对照:外部队列中回归分析表现优于二分类分析,数值为0.752对0.642。这条对照的口径需要留意,摘要未说明0.752对应的具体指标,也未说明它与0.784是否处于同一训练配置,二分类一侧的0.642是基线还是混合训练后的数值同样未说明。因此不宜把0.752与前面的0.784直接并列比较,更不能据此推出回归路线一定更优。
冷静观察:合成样本补的是数据量,补不了证据等级
先把没有的部分列出来。外部验证队列的样本量摘要未给出,这是评估0.784置信区间的关键缺口;未见置信区间与统计检验,未见前瞻性验证或多中心前瞻设计,未见与病理医师判读的一致性对照,未见不同CT设备与重建参数下的稳健性测试,也未见任何器械注册路径。论文自述为概念验证研究,这个定位与上述缺席是一致的。
还有一层属于生成式方法特有的风险:合成图像补的是数据量,补不了分布真实性。质量评估环节能挡掉明显的伪影,但挡不掉生成器对真实病例分布的系统性偏移,外部验证上的提升是否部分来自这类偏移,是该方法共同的未解问题。
因此正确的表述是:AEGIS提供了一条在队列不足时用合成CT扩充训练数据的可行路线,并在外部队列上取得了三项指标的改善;不能写成它是可用的临床工具,不能写成它可以指导围术期用药选择,也不能把0.784读成部署后能达到的水平。
接下来该追问的是四件事。其一,外部验证队列的样本量与人群构成何时披露,这决定了三个涨幅的可信区间。其二,500%混合比例的定义与不同比例下的性能曲线,没有曲线就无法判断最优配比。其三,合成图像的质量评估标准与专家介入方式,这决定该方法能否被第三方复现。其四,在更大、更多中心的真实队列上,同样的框架还能否复现这一涨幅,还是说提升主要来自小样本下的方差。这四件事没有答案之前,它最合适的身份是研究路线,不是产品原型。
原文链接:Communications Medicine论文
千方医数集编辑部 出品
