Communications Medicine:多智能体系统维护肝病指南,137场景一致率77.4%,冲突化解率95.8%
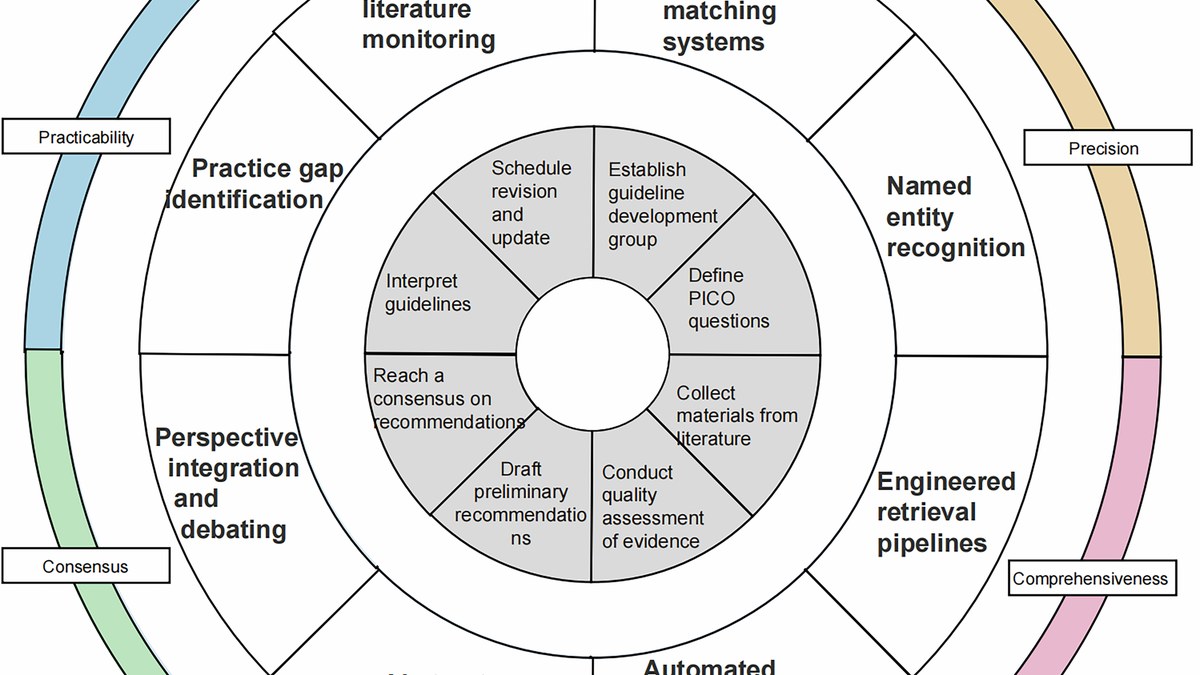
Communications Medicine于2026年10月7日在线发表MARG:一个面向临床指南制定与维护的多智能体检索增强生成系统。研究以七部2025年肝病指南中的137个临床场景为对照,整体一致率为77.4%;随共识强度上升,一致率从弱共识的45.8%升至完全共识的87.8%。通过四轮结构化辩论,系统化解了95.8%的推荐冲突,并在74.5%的最终输出中达成强共识。
别把77.4%读成正确率:多智能体维护临床指南走到哪一步
影响分析 × AI技术供应商/创业者 | 事实报道 × 医院信息化/临床医生 | 行业观察
2026年10月7日,Communications Medicine在线发表MARG:一套面向临床指南制定与维护的多智能体检索增强生成系统(Multi-Agent Retrieval-Augmented Generation)。研究以七部2025年肝病指南、共137个临床场景作为对照,报告整体与指南的一致率为77.4%;在一项小规模模拟中,不同年资医师借助该系统后,纠正了40%至60%与指南不一致的决策。
两个数字的分量并不相同。77.4%衡量的是输出与指南文本的吻合程度,不是临床决策的正确与否;40%至60%来自仅60个场景、数名医师参与的模拟,样本极小,也不挂钩患者结局。把它们读成系统已经能写指南,是对口径的误用。
开场:指南更新的速度追不上证据增长的速度
临床指南有一个长期未解的矛盾:证据在持续累积,而制定与修订是人力密集、周期漫长的流程。一次正式更新要经历证据检索、分级、推荐形成与共识投票,往往跨数年,期间新增的试验结果只能等待下一轮。维护类任务因此在近年被单独提出:它要处理的不只是写一遍,而是判断旧推荐是否还站得住。
MARG正是朝这个口子切入的。论文把它定义为面向两类任务的系统:临床指南的制定,与临床指南的维护。前者的产出是一段完整推荐,后者要回答的是既有推荐是否已经过时。对医院信息化与临床科室而言,后者工作量更大、更琐碎,也更少被自动化工具触及。
137个场景:拿什么当标准答案来比对
顺便说清口径:比对对象是这些指南已经写成的推荐文本,产出与之相合即记为一致。摘要未给出七部指南的名称与发布机构,也未提供137个场景的抽样方式,这限制了读者对覆盖面与代表性的判断。
据此得到整体一致率77.4%。最需要纠偏的正是这个定义:它是与指南文本的一致率,不是临床决策正确率,不涉及患者结局,也不构成与医生的对比。系统贴近指南,说明它学会了指南的表达与推理习惯;至于指南本身在这些场景上是否最优,这个比对框架并不回答。
分领域的落差提供了更有信息量的切面:诊断65.5%、预防75.0%、治疗81.0%。诊断类最低并不意外,诊断路径依赖检查结果、时序与鉴别,可变量多;治疗推荐在指南中通常写得最明确,约束条件成文程度高。也就是说,一致率高低在一定程度上反映的是指南文本自身的确定性高低。
另一组对照落在证据整合环节。论文称MARG时效性为6.3%,对照人工检索0.9%;可重复性25.5%对7.5%;达到Level I证据质量的比例24.2%对8.0%。摘要未定义三项指标的计算方式与统计检验,因此只能读作检索环节的相对改善,不宜换算成最终推荐质量的提升幅度。
45.8%到87.8%:让智能体先吵四轮会发生什么
更有解释力的是另一组数字:随共识强度上升,一致率从弱共识场景的45.8%升至完全共识场景的87.8%。
这条梯度比77.4%的均值更接近系统的真实画像。指南中的推荐本就有强弱之分,强共识条目证据厚、表述硬、边界清楚,检索加生成的方法更容易贴近;弱共识条目多因证据不足或存在分歧,写的往往是留有弹性的措辞。因此这段跨度提示:MARG目前的长项是复述已经凝结好的共识,而不是在尚无共识处做出判断。
而临床上真正需要辅助的,恰好多是弱共识区。若增益集中在医生本就能给出一致答案的场景,它节省的是检索与撰写的时间,而非提升决策质量。这依然有价值,但不是同一种价值。
论文给出的对策是多智能体之间的结构化辩论。四轮辩论后,95.8%的推荐冲突被化解,74.5%的最终输出达成超过85%的强共识。这里要分清两层:冲突被化解不等于被正确化解,智能体之间达成强共识也不等于与外部指南一致。前者是收敛过程的指标,后者才是结果正确的指标。四轮辩论的时延与调用成本,摘要未给出。
纠正40%至60%:这轮小规模模拟能说明什么
最后一组数字最容易被传播,也最需要谨慎。小规模模拟设置60个场景,由具5年、15年、30年资历的医师评估,借助系统后纠正了40%至60%与指南不一致的决策,净增益在低年资组最明显,约50%。
先看口径。这里的纠正指原本偏离指南的判断被改到与指南一致,前提是场景存在可参照的条目;它衡量的是行为改变,既不是诊断准确率,也不是患者结局改善。再看基数:摘要未给出评估者人数、是否盲法、是否交叉评阅,也无置信区间与统计检验结果。在这个规模上,40%至60%只能作为信号,任何向真实临床效果的换算都是越界推论。
低年资组获益最大这一条还有另一种解释:低年资医师的基线不一致率本就更高,向上空间更大;高年资组基数低,天花板效应限制了可见增益。若这一解释成立,系统更现实的定位是压缩不同年资之间的输出差异,而不是让资深医生变得更强。哪一种说法站得住,取决于分组的基线数据与绝对差值,摘要未给出。
冷静观察:概念验证到指南机构采纳之间,隔着整条流程
先把没有的部分列清楚。未见前瞻部署,也未见任何指南机构正式采纳;七部肝病指南的名称与发布机构未披露,领域外的适用性无证据;137个场景的抽样方法未说明;模拟环节的评估者人数、盲法与评阅方式均未给出;纠正率区间未附置信区间;证据整合三项指标的计算口径未定义;四轮辩论的时延与成本未披露;是否存在独立第三方的复现,摘要未给出。
因此正确的表述是:MARG在概念验证层面展示了多智能体结构用于指南制定与维护的可行方向,论文自述为proof-of-concept。它不能被表述为已经可以产出或修订临床指南,也不能被表述为能纠正四成至六成的临床决策。
对技术方与创业者,可迁移的部分有三处:把检索与证据分级作为独立环节单独度量,而不是只评测最终文本;用多智能体辩论做冲突收敛时,必须把内部共识指标与结果正确指标分开报告,两者混淆会让评测虚高;较现实的切口是同质化不同年资的输出差异,而非替代专家判断。
接下来该追问的是四件事。其一,137个场景与七部指南的选取标准能否公开,第三方能否按同一口径复现77.4%。其二,弱共识区的45.8%如何抬升,是否存在针对低确定性推荐的专门机制。其三,60场景模拟能否扩展为前瞻、多中心的真实工作流对照,并补上置信区间与结局类指标。其四,若这类系统进入指南制定流程,责任边界由谁承担,指南机构以什么形式验收。四件事没有答案之前,MARG应被视为一份指向明确的概念验证,而非一条已经铺好的指南自动化产线。
原文链接:Communications Medicine论文
千方医数集编辑部 出品
