AI病人给医学生打分:湘雅登顶刊的研究,发现了一个"认知阈值"
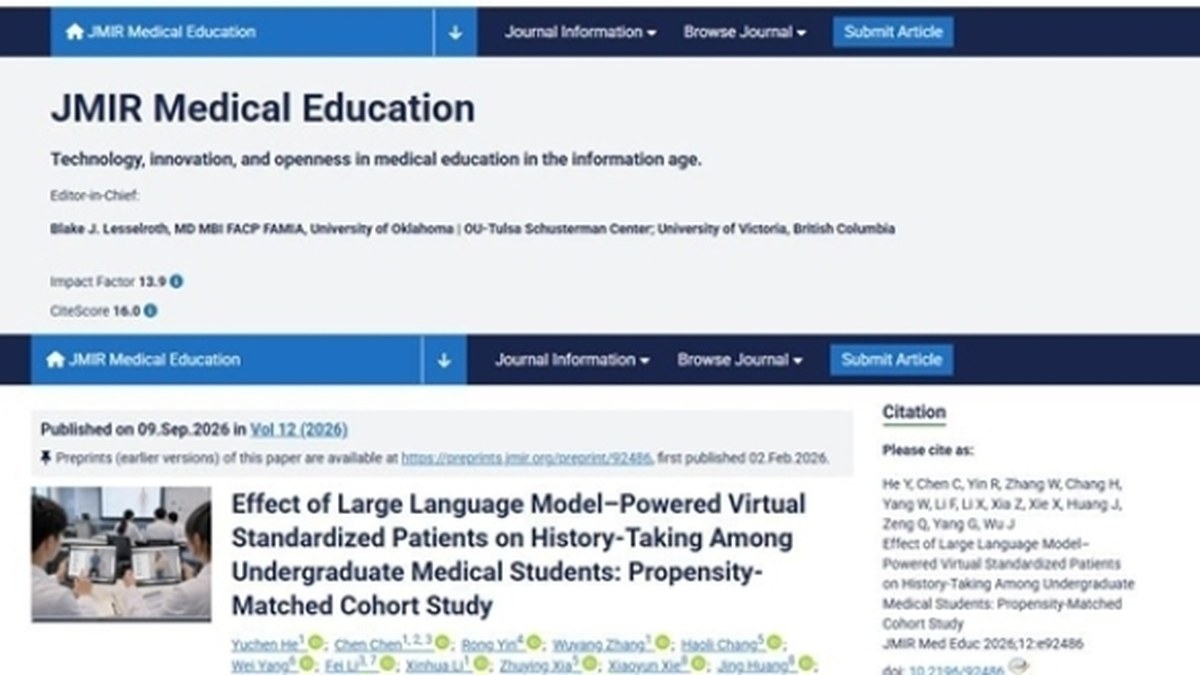
9月10日中南大学湘雅医院临床技能培训中心官宣:吴静教授团队论文《大语言模型驱动的虚拟标准化病人对医学生病史采集能力的影响:倾向性匹配队列研究》发表于国际医学教育领域影响因子最高的期刊《JMIR Medical Education》(IF 13.9),证实AI虚拟病人作为课外自主练习工具可显著提升医学生病史采集能力,并首次提出AI辅助自主学习中的'认知阈值'现象。
医学生练习问诊,传统做法是雇"标准化病人"——经过培训的真人演员模拟病种。这个模式成本高、供给紧、剧本难以标准化。大语言模型带来了新解法:让AI扮演病人,随时陪练。但"AI陪练到底有没有用"这个问题,此前大多停留在体验式结论。9月10日,中南大学湘雅医院官宣:吴静教授团队的研究登上国际医学教育领域影响因子最高的期刊《JMIR Medical Education》(IF 13.9),用倾向性匹配队列设计给出了硬证据,还首次提出了一个新现象——"认知阈值"。
IF 13.9顶刊上的中国答案
先看研究本身。据湖南日报9月10日报道,湘雅医院临床技能培训中心吴静教授团队的论文《大语言模型驱动的虚拟标准化病人对医学生病史采集能力的影响:倾向性匹配队列研究》发表于《JMIR Medical Education》——该刊不仅是国际医学教育领域影响因子最高的期刊(IF 13.9),在"教育、科学学科"类别中排名第1位。
研究聚焦的是医学生最核心的临床技能之一:病史采集,俗称"问诊"。别小看这项基本功——医生能否通过问诊抓住关键病情,直接决定诊断方向和治疗质量。而这项能力的训练长期受困于传统标准化病人教学的三大痛点:资源紧张、成本高昂、难以标准化。湘雅团队联合相关企业自主研发了基于大语言模型的虚拟标准化病人系统:AI扮演"模拟病人",为学生提供安全、可重复的课后自主练习平台,练习后即时生成AI评分与个性化反馈。
倾向性匹配:让"AI练习有效"这句话第一次有了硬证据
教育研究最难的是什么?是证明因果。让一批学生用AI练习、另一批不用,两组的成绩差异可能来自练习工具,也可能来自分组本身的偏倚——自愿使用AI的学生或许本来就更勤奋。
这项研究的方法学价值正在于此:采用前瞻性队列设计,用倾向性评分匹配来校正选择偏倚,让"用AI练习"和"不用AI练习"的学生在基线特征上可比,再检验病史采集能力的差异。结论是明确的:将AI虚拟病人作为课外自主练习工具,可显著提升医学生的病史采集能力。
"显著提升"四个字背后,是AI虚拟病人相对真人标准化病人的三重结构性优势:可重复(学生可以凌晨两点反复练同一个病例,病人不会累)、可标定(每个病例的难度、考点、评分点完全一致,教学效果可归因)、可反馈(每一次练习即时生成评分与个性化建议,而不是等老师批改)。这三点恰好打在医学教育规模化供给的软肋上——中国医学生基数大、临床师资稀缺,"课后自主练习"的需求长期没有被很好地满足。
"认知阈值":为什么AI不是练得越多越好
这项研究更耐人寻味的部分,是它首次提出了AI辅助自主学习中的"认知阈值"现象——不同基础水平的学生,从AI练习中获得的收益并不相同,存在一个阈值效应。研究由此给出的教学建议是:针对学生不同基础水平实施分层教学。
这个发现的分量,需要放在"AI教育产品"的语境里掂量。过去几年,教育科技行业的默认叙事是"AI让个性化学习普惠化"——每个学生都能获得无限练习和即时反馈。但"认知阈值"提示了一个更复杂的现实:对于基础薄弱的学生,AI的高密度反馈可能超出其加工能力,练习收益递减甚至产生挫败;而对于基础扎实的学生,AI陪练的边际价值则能持续释放。
换句话说,AI练习工具不是"练习量"的无限放大器,而是有一个与学习者认知水平相关的最优区间。这对产品设计的含义是直接的:有效的AI医学教育产品,需要内置对学习者水平的诊断能力,动态调节病例难度和反馈密度,而不是把题库和评分器简单堆上去。湘雅团队提出的"分层教学",本质上是把教育学里古老的因材施教原则,重新锚定在了AI时代的技术坐标上。
医学教育的下一步:从标准化病人到分层化AI
把镜头拉远,这项研究还标记了一个领域的成熟度拐点。
此前的AI虚拟病人研究,多为单中心、小样本、前后测的探索性设计,证据等级有限;JMIR系统上近期涌现的综述也指出,该领域普遍存在样本小、指标不一、缺乏对照的问题。湘雅这项研究用倾向性匹配队列设计补上了方法学短板,为"AI虚拟病人进入主流医学教育课程"提供了第一块有分量的垫脚石。
对产业侧的启示同样清晰:医学教育AI产品的竞争,正在从"能不能对话"转向"证据够不够硬"。湘雅中心参与建设的"中国医学教育虚拟仿真案例库",以及其联合人卫医学科技在全国医学模拟人大赛获一等奖的AI驱动诊断学智慧教学系统,都指向同一个方向——教学场景、内容资产与临床验证的深度绑定。
AI病人给医学生打分的时代已经开始。下一个值得追问的问题是:当AI病人足够真实,它会不会反过来重塑"问诊"这项技能本身的评价标准?湘雅的研究给出了起点,答案要留给接下来的队列。
原文链接:湖南日报(腾讯新闻转载)
千方医数集编辑部 出品
