AI说对了医生却没采纳:125人随机交叉实验里,被放过的正确建议比盲信更贵
一项10月23日在线发表于《柳叶刀·数字健康》的混合方法随机交叉实验,把医生用错AI拆成两类分别计价。125位来自10个国家的参与者(50位放射科专家、平均从业7.85年,75位非放射科医生与医学生构成的新手)每人读50张头颅CT,其中25张确有颅内出血,标准答案由三位资深放射科医生各自判断后开会达成共识。三种条件交叉呈现、两轮间隔至少14天:不给提示、只给AI结论、结论之外把可疑位置圈出来。AI建议由研究者人工编写、固定80%正确20%错误,以保证所有人遇到的对错比例一致。结果是过度相信率27%—58%看着更高,但不采纳率11%—21%乘上四倍的分母后,被放过的正确建议反而耽误更多病例。加标注能压低这类错:确有出血时不采纳率专家从8.3%降到6.7%、新手从10.3%降到5.1%,代价是无出血时误判率小幅上升。
影响分析 × 医院信息化/临床医生 | 数据视角 × 投资人与产业分析师 | 深度研报
2026 年 10 月 23 日,一篇混合方法随机交叉实验在线发表于 The Lancet Digital Health(DOI 10.1016/j.landig.2026.101050,PMID 42919730),作者团队来自 UCL Global Business School for Health、LMU Munich、MIT、St Michael’s Hospital 与多伦多大学等机构。它没有再追问医生会不会盲信 AI,而是把医生用错 AI 的两种方式拆开分别计价:跟着错建议走,和放过了对建议。结论是反直觉的——比例更低的那种错,代价反而更大。
开场:关于人要不要听AI,终于有人把两种错分开算了
过去几年讨论影像 AI 落地,行业里反复担心的是同一件事:自动化偏误,医生看见 AI 的结论就懒得自己判断,AI 错他也跟着错。这个担心有实证基础,本研究里过度相信(AI 给错建议时医生跟着错)的比例在 27%–58% 之间,确实不低。
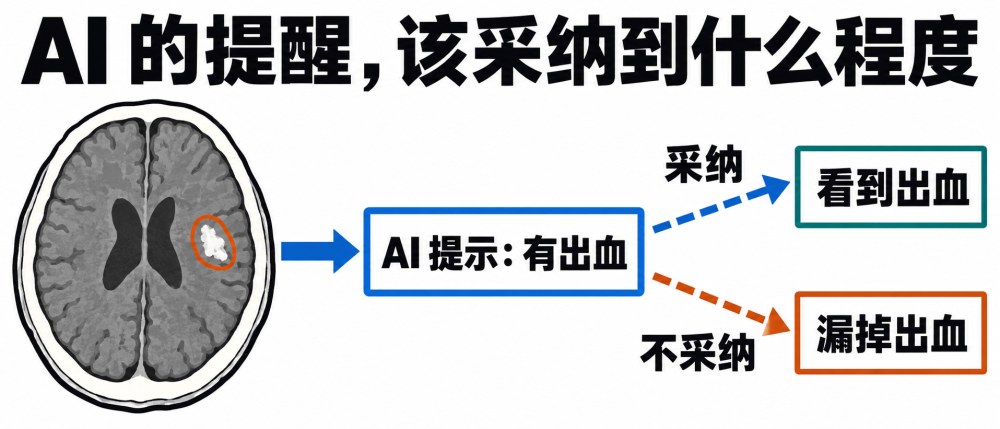
但这项实验把镜头转向了另一边:不采纳,即 AI 给对建议时医生没有采纳,比例是 11%–21%。单看百分比,盲信更吓人;可放进真实工作流的算术里,结论翻了过来——不采纳才是更贵的那种错。这笔账怎么算出来的,是本文的核心。
实验怎么做的:125人、50张头颅CT、三种条件、间隔14天
实验招募了 10 个国家的 125 位参与者,分两类:
- 50 位放射科专家:含普通放射科医生、神经放射科医生与第二年以上的住院医师,平均从业 7.85 年;
- 75 位新手:非放射科医生、实习医生和医学生。
每人读同样的 50 张头颅 CT,其中 25 张确有颅内出血、25 张没有。出血与否由三位资深放射科医生各自判断后开会达成一致,并对照病历,相当于钉死的标准答案。难度做了分层:有出血与无出血两组,各 5 张容易、10 张中等、10 张难。
设计上的关键是交叉:同一个人读三遍,每遍换一种条件,两遍之间至少隔 14 天。三种条件分别是:
- 不给任何提示,纯靠自己读;
- 只给 AI 结论,比如「有出血」;
- 结论之外,再把可疑位置在图上圈出来,即业内说的可解释 AI。
数据采集于 2023 年 2 月至 8 月。另有 42 位新手边读边出声思维,13 位专家戴上眼动仪,记录视线到底停在哪里——这为后文解释不采纳的机制提供了直接证据。
关键设计:AI建议是人工编的,固定80%正确20%错误
这是全篇最容易被误读、也最值得行业记住的一点:实验里的 AI 建议并非某个真实模型的输出,而是研究者人工编写的,正确率固定在 80%、错误率 20%。
为什么要这么做?因为只有把对错比例钉死,才能保证每个人、每个条件下遇到的建议质量完全一致,组间才有可比性。80% 这个数取的是临床上影像 AI 准确率的下限,研究者刻意选了偏保守的水平。换句话说,这不是在评测某个产品,而是在可控环境里测量人对固定质量建议的采纳行为。对采购和评估环节的人来说,这个定位很重要:它回答的是工作流问题,不是产品问题。
反直觉的结论:不采纳率更低,但因为分母差四倍,代价反而更大
现在做那笔算术。过度相信率 27%–58%,不采纳率 11%–21%,前者明显更高。但别忘了建议本身的构成:80% 正确、20% 错误,两类错误所乘的分母差了整整四倍。
用 1000 条建议来摊开:其中 800 条是正确的,按 15% 的不采纳率放过,就是 120 个病例的正确提醒被白白浪费;200 条是错误的,按 40% 的过度相信率跟随,是 80 个病例被带偏。低比率乘以大分母,损失反而更大。
研究者按净效应核算了四种组合(专家/新手 × 只给结论/给标注):若把不采纳全部消除能提升的正确率,减去把过度相信全部消除能提升的正确率,四种里有三种为正——放过正确提醒造成的损失,大于跟着错误提醒走的损失。
对放射科工作流来说,这个结论直接改写了采纳规则的设计取向。如果部门只盯着防止盲信——比如把 AI 结论藏到医生先独立判断之后才显示——那恰恰会把代价更大的那类错放大。更合理的目标是让正确建议可核实、可被快速采纳:医生不是不该怀疑 AI,而是怀疑的成本要低到「看一眼就能核」。研究还指出,不采纳集中在确有出血的片子和被评为难的片子上,这两类本来最需要帮手。
冷静观察:可解释AI圈出位置压下不采纳,代价是误判小幅上升
机制层面的证据支持「核实」这条路径。把可疑位置圈出来之后,在片子确有出血时该采纳而没采纳的比例:专家从 8.3% 降到 6.7%,新手从 10.3% 降到 5.1%,新手降幅接近一半。正确率上,不给任何提示时专家平均 82.9%、新手 62.7%;拿到正确标注后新手升到 86.6%、专家升到 88.8%,新手提升尤其明显。
代价也存在但很小:片子无出血时被带着误判的比例,专家从 1.5% 升到 1.9%,新手从 5.2% 升到 5.8%。眼动数据解释了为什么——圈出位置后,漏掉出血的病例里视线全程未落在出血区的比例大幅下降:医生的任务从「自己找」变成「去核」,核实成本下来了。
但边界必须说清楚:
- AI 建议由研究者人工编写、正确率钉死在 80%,不是真实模型输出;真实模型出错有自己的分布规律,行为未必可外推;
- 界面只要求回答「有」或「没有」,不用写报告、不担诊断责任,与真实临床环境有明显距离;
- 数据采集于 2023 年 2 月至 8 月,反映的是当时的任务设定与参与者状态;
- 难的与有出血的片子被刻意多放,文中比例不能直接当作门诊发生率;实验室结论不能直接外推到真实放射科工作流。
对医院信息化负责人而言,可操作的启示是:上线影像 AI 时,默认形态应优先考虑带定位标注的可解释输出,并把采纳规则设计成「先核后采」而非「先独立再看 AI」;对投资人与产业分析师而言,这项研究提示可解释性不是加分项而是采纳率的基础设施,但它的临床结局收益仍需前瞻性研究证明。
原文链接:https://doi.org/10.1016/j.landig.2026.101050
千方医数集编辑部 出品
