40万对CT与报告喂出的Percival:视觉语言预训练抓到了纯视觉模型拿不到的临床信息
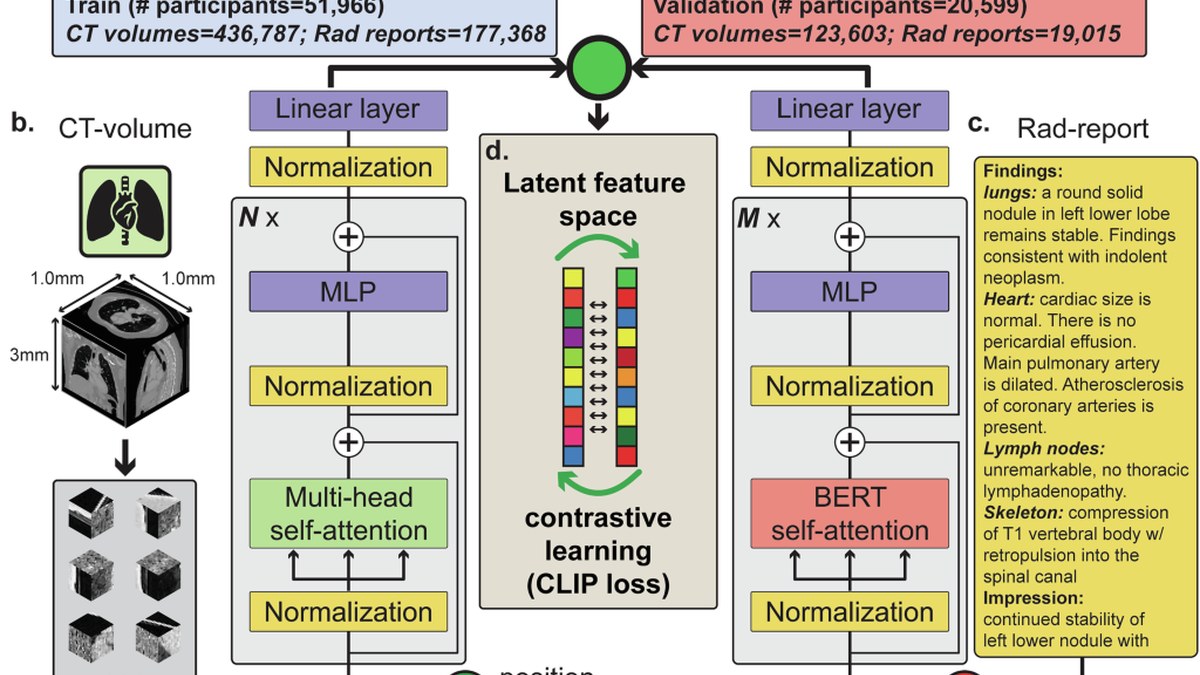
9月29日,《npj Digital Medicine》在线发表Percival模型研究。研究团队用Penn Medicine BioBank超过40万对CT影像与放射报告的配对数据,以双编码器对称对比学习训练CT视觉语言基础模型,并在超过2万名留出受试者上验证。结果显示模型潜空间与人口学、生理及化验指标变异对齐,可直接支撑电子病历全表型关联分析(PheWAS)。在与纯视觉对比学习、多器官分割两条范式对照中,视觉语言预训练捕获了纯视觉路线拿不到的临床信息,覆盖疾病分类与纵向风险建模两类任务。
数据视角 × 医疗数据从业者 | 趋势前瞻 × 药企研发负责人 | 深度研报
9月29日,《npj Digital Medicine》在线发表了CT视觉语言基础模型Percival。研究团队用Penn Medicine BioBank超过40万对CT影像与放射报告的配对数据做双编码器对称对比预训练,并在超过2万名留出受试者上验证。它要回答的不是模型能不能读片,而是一个更前置的问题:模型学到的那个潜空间里,到底有没有真实的临床结构。
开场:放射科医生写的那句话,本身就是一份标注
医学影像AI最大的成本从来不是算力,而是标注。要训练一个能预测某种疾病的模型,通常得先把成千上万张片子按疾病标签分好类,这一步既贵又慢,还天然偏向少数几种被标注过的疾病。放射科报告提供了一个便宜得多的替代品:每一次CT检查都会配一份由医生写下的文字描述,它记录的是这位医生在当时的临床语境里认为值得写下来的东西。
换个角度说,报告不是影像的注释,而是影像在临床上的投影。它同时携带解剖所见、医生的不确定性表述、与既往检查的比较,以及隐含的下一步建议。把这段文字当作监督信号,等于把「哪些影像差异在临床上算数」这件事交给放射科医生的日常判断来定义,而不是交给外部标注员。Percival的出发点正在这里。这项研究值得在此时单独拿出来说,是因为影像基础模型的竞赛已经进入第二阶段:第一阶段比的是谁的数据多、谁的编码器大,第二阶段比的是谁能证明自己学到的表示与真实患者群体的生理差异相关。前者靠算力,后者靠验证设计。
40万对数据怎么来的:影像与报告天然成对
数据规模是这项研究的第一层门槛:超过40万对CT影像与放射报告,全部来自Penn Medicine BioBank。这类配对数据的关键特性是「天然成对」——不需要人工对齐,不需要额外标注流程,影像与报告在临床工作流里本来就是一起产生的。对数据从业者而言,这几乎是最理想的一种语料形态:规模足够大,获取成本已经由日常诊疗支付过一次。
模型结构走的是双编码器对称对比学习,影像编码器与文本编码器各自把输入压到同一个表示空间,靠配对关系拉近、靠非配对关系推远。这条路线的成熟得益于自然图像领域的CLIP式训练,但直接搬到CT上有明显不同:医学报告的句式高度模板化,同一份正常报告会在数据里出现成千上万次,阳性发现则长尾分布。也正因如此,光有数据量不够,验证方式才是决定这项研究成色的一环——团队用超过2万名留出受试者做验证,把评价对象从「模型认不认识这张片子」换成了「模型学到的表示能不能解释这一群人」。留出受试者这个说法本身也值得强调:划分单位是受试者而不是单次检查,同一人的多次扫描不会同时落在训练与验证两侧,这避免了一种极常见的数据泄漏,也让验证结果更接近真实部署时面对新病人的情形。
潜空间里有什么:人口学、生理、化验都被对齐进去了
研究的核心发现是:Percival的潜空间与人口学、生理以及实验室检查指标的变异相对齐。这句话的分量在于,这些变量在训练时从未作为标签出现过——模型只看过影像和报告,却学出了一个能映射到年龄、生理状态与化验值波动方向的空间。这意味着它抓到的不是某几种疾病的判别边界,而是一套更连续的、与人体状态相关的结构。
对齐的意义要落到可检验的地方才有价值。团队把这套表示接到电子病历上做全表型关联分析(PheWAS):把影像派生的表示当作自变量,在病历里扫描与之显著关联的表型。这条链路一旦跑通,影像就不再只是一个诊断输入,而成了一种可批量产出的流行病学变量。研究也强调这种结构覆盖的是整个疾病患病率谱系,而不只是常见病——稀有病一端能不能站住,是判断潜空间质量的一个关键。从数据视角看,这一点尤其重要:多数影像数据集的标签分布严重头重脚轻,模型很容易靠记住头部疾病的表型就拿到漂亮分数,而在患病率谱系的长尾端保持结构一致性,才是表示是否真正泛化的试金石。
对照两条老路:纯视觉和多器官分割各自缺什么
研究没有只报自己的分数,而是设了两条对照范式。第一条是纯视觉对比学习:同一批影像、同样的对比目标,只是不配文本。第二条是多器官分割:先用解剖结构把影像切成器官,再在解剖先验上做表示。这两条路线在医学影像基础模型里各有一批拥趸,前者主张让模型自己从像素里发现结构,后者主张先把解剖知识注入进去。
结论是视觉语言预训练捕获了纯视觉路线拿不到的临床信息,且这个优势在疾病分类与纵向风险建模两类任务上都成立。这个对照设计的信息量比分数本身更大:它说明优势来源于「语言这一路监督」,而不仅仅是数据更多或模型更大。对做影像AI的人来说,这是一条很实用的判据——在同等数据预算下,把报告文本纳入训练,比单纯堆影像数量更可能换来临床相关的新信息。多器官分割这条对照同样有解读空间:解剖先验能保证结构一致性,却把表示的上限锁死在已被定义好的器官边界内,而报告里那些不落在器官上的描述,恰恰是它拿不到的部分。
冷静观察:PheWAS能跑起来,才说明这个潜空间真的有临床含义
医学影像基础模型这两年最常见的论证方式是刷下游任务榜单,但榜单分数高并不能证明表示里有临床含义,它可能只证明模型记住了标注习惯。PheWAS这条验证路径的价值恰在于此:它要求模型在没有被教过的前提下,自发地与病历里数百种表型产生合理的关联结构,这是一种对表示本身的压力测试,而不只是对某个分类头的测试。跑得起来,说明这个潜空间里确实有东西;跑不起来,再高的AUROC也很难说服人。
边界同样要讲清楚。这是单中心数据,Penn Medicine BioBank的人群构成、扫描协议与报告书写习惯都会写进模型里,泛化到别的机构仍需独立验证;40万对听着庞大,分摊到具体病种后长尾依然稀薄。对药企研发而言,更值得留意的是它的用途方向:如果影像表示能稳定对应到生理与化验层面的连续变异,它在队列分层、入组筛选与纵向风险建模上的想象空间,比做一个读片助手要大得多。当然,从「潜空间有临床含义」到「能用于试验决策」,中间还隔着前瞻性验证与监管认可,这一步目前还没有人走完。
原文链接:npj Digital Medicine(DOI: 10.1038/s41746-026-03257-2)
千方医数集编辑部 出品
