30 家 NICU、20 个国家地区零数据共享:持续学习把成人胸片模型交给新生儿用
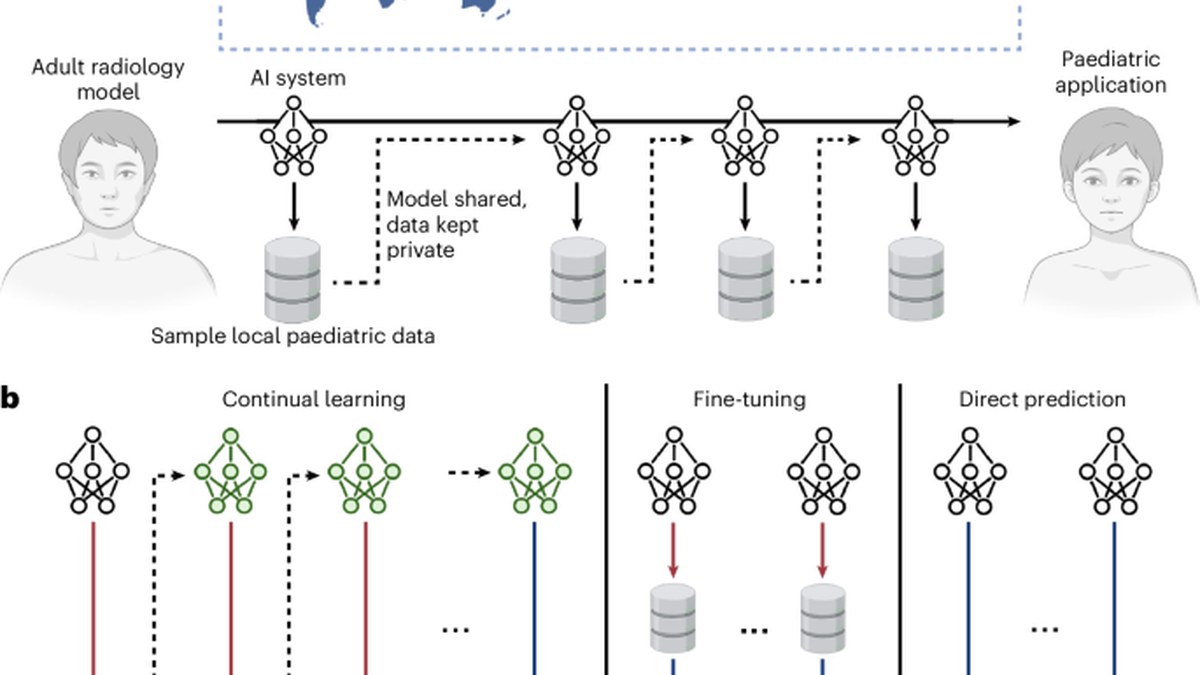
《Nature Biomedical Engineering》于 2026 年 10 月 13 日刊出一项国际多中心研究,用持续学习把原本用于成人胸片的人工智能模型改用于新生儿,全程不共享任何患者数据。研究覆盖 20 个国家和地区的 30 个新生儿重症监护病房,共 2965 张胸片、2960 名患儿,中位年龄 2 天,平均胎龄 32.9 周,平均出生体重 2195 克。基线模型 CarinaNet 先在 1890 张成人 ICU 胸片上适配,任务为定位气管插管尖端与隆突。模型按医院顺序传递,每家医院只用本地 50 张胸片在自己的环境中再训练,随后只把权重传给下一家。结果显示,联合标志点平均定位误差从成人模型的 4.30 厘米、单中心微调的 1.29 厘米降到持续学习的 0.67 厘米,30 家站点中 29 家有改善。
哈佛团队在 30 家 NICU 验证:零数据共享的持续学习,把成人胸片模型读数压到 0.67 厘米
影响分析 × 医疗数据从业者 | 数据视角 × 医院信息化/临床医生 | 深度研报
《Nature Biomedical Engineering》于 2026 年 10 月 13 日在线发表一项国际多中心研究,由哈佛医学院 Pranav Rajpurkar 领衔的团队用持续学习,把原本用于成人胸片的气管插管评估模型改用到新生儿。研究覆盖 20 个国家和地区的 30 个新生儿重症监护病房,纳入 2965 张胸片、2960 名患儿,联合标志点平均定位误差从成人模型的 4.30 厘米降到 0.67 厘米,30 家站点中 29 家出现改善,全程未共享任何患者数据。
开场:儿科 AI 的缺口在数据也在审批,现有办法各有短板
放射科人工智能的落地在成人侧已经铺开,儿科侧的落差却长期存在。论文给出的背景数字相当直白:只有 17% 的商用人工智能模型获得美国食品药品监督管理局的儿科使用许可,而儿童在公开医学影像数据集中的占比不足 1%。两个数字指向两条不同的堵点,前者是审批通道的滞后,后者是训练语料的先天稀疏。气管插管评估恰好是这一落差的典型场景,成人胸片上已有多个工具拿到许可,新生儿人群却没有任何商用方案。补齐缺口的路并不好走,整理和标注儿科临床数据本身耗时费力,跨机构的数据共享又受隐私法规约束,结果是多数儿科模型只能依赖单中心数据,做过外部验证的寥寥无几,许多模型在跨机构环境下出现明显的性能衰减。从数据治理的视角判断,真正卡住儿科人工智能的并不是算法能力,而是可用样本的稀缺与合规流通成本之间的距离,任何不必集中建库、又不触碰数据外流的适配路径都值得被认真审视。已有的替代方案同样各有限制:联邦学习虽然不必搬动原始数据,却需要一台中心服务器在多轮通信里反复收集并平均各站点的参数更新,对小机构而言仍是不轻的工程负担。
实验设计:模型挨家走,每家只用本地 50 张胸片微调,只交权重不交数据
这项由哈佛医学院 Pranav Rajpurkar 领衔、第一作者为 Vishwanatha M. Rao 的研究,把上述问题拆成一次可执行的国际回顾性实验。数据侧覆盖 20 个国家和地区的 30 个新生儿重症监护病房,共纳入 2965 张胸片、2960 名患儿,患儿中位年龄为 2 天,平均胎龄 32.9 周,平均出生体重 2195 克。起点是一个并不陌生的基线模型 CarinaNet,其结构为 RetinaNet 加 ResNet-50 加特征金字塔网络,先在 1890 张成人重症监护病房胸片上完成适配。临床任务被明确为定位两个解剖标志点,即气管插管尖端与隆突,用于判断插管位置是否异常。真正的变量在于协作方式:模型按医院顺序传递,每家医院只在自己的信息技术环境里,用本地 50 张胸片对模型做一次再训练,随后把更新后的权重交给下一家。全程没有任何机构交出患者影像,跨站点流动的只有模型权重,也不需要站点去整理大规模数据集或部署复杂的分布式训练工具。这种安排把协作门槛压到了各院现有信息化能力能够承接的水平。
读数摊开:插管尖端从 2.35 厘米走到 0.40 厘米,联合误差 0.67 厘米
结果被摆在三组对照之下,差距足够清晰。气管插管尖端定位的中位误差,直接套用成人模型为 2.35 厘米,单中心微调降到 0.94 厘米,持续学习进一步走到 0.40 厘米。隆突定位呈现同样的走势,成人模型 1.62 厘米,单中心微调 0.27 厘米,持续学习 0.20 厘米。把两个标志点放在一起计算联合平均误差,持续学习为 0.67 厘米,明显优于单中心微调的 1.29 厘米与纯成人模型的 4.30 厘米,且在 30 家站点中,29 家的数值出现改善。更有分量的是极端误差的收敛:超过 5 厘米的偏差约等于许多新生儿气管的全长,这类偏差在成人模型上占到 37.4%,单中心微调降至 8.2%,持续学习降到 2.6%。对容错空间以毫米计的新生儿场景而言,尾部的压缩比均值改善更能说明问题。下游任务同步受益,30 家站点中有 27 家在深插管检测上的表现也一并变好,这意味着纸面上的定位精度并没有停留在几何读数层面。
为什么有效:相比聚合式的联邦学习,串联权重传递不用中心服务器,且要保住在每一家旧站点上的收益
两条技术路线的差别是理解这组读数的关键。联邦学习是聚合式方法,由中心服务器在各站点之间反复收集并平均参数更新,依赖多轮通信收敛;本研究所依据的则是单遍串联权重传递,也被称作「旅行模型」范式,模型依次经过各站点,每家在本地数据上微调后把权重交由下一家,其变体还包括让模型多次循环通过站点的循环式传递。对跨 20 个国家和地区的协作而言,前者的通信回合与服务器部署成本都不低,后者只需要一条单向传递链,参与方不必为协作新建基础设施。差异还不止于此:作者把这种方法明确框定为持续学习而非单纯的传递,评估口径除整体精度之外,还包括最终模型在每一个已见过站点上是否保持或提升了表现,也就是把知识的积累与保留写进了验收标准。作者认为该框架具备可推广性,可用于其他成人模型与代表性不足人群。站在医院信息化负责人的立场,这类方案的吸引力或许不只在精度数字,而在于整套流程能在既有计算环境内跑通,无需为数据流动单独开一条通道。
冷静观察:权重传递不等于隐私风险归零,灾难性遗忘要靠各站点自己的复测兜底
需要冷静看待的第一点是,权重传递解决了原始数据不出院,却不自动等于隐私风险归零。流动的权重本身由其训练数据塑造,累积式的单向传递也让责任边界变得模糊,事后很难追溯到具体站点;这类方案在落地时仍要按既有的数据治理规则逐案评估,不能因为「没有共享数据」而整体豁免。第二点是灾难性遗忘的风险并未消失。串联传递意味着后续站点的本地分布会持续改写先前学到的东西,本研究之所以能给出保住收益的结论,靠的是对每一个已见过站点的复测,把是否滑落交给各站点自己的复测来兜底;这一机制若在实施中被省略,收益是否均匀分布就失去了凭据。第三点是证据边界:这是一项回顾性研究,文中没有报告前瞻性部署结果,因此插管尖端误差从 2.35 厘米降到 0.40 厘米、极端误差从 37.4% 降到 2.6%,都不能直接解读为插管并发症减少。目前可以确认的只有一件事:在零数据共享的前提下,30 家站点里有 29 家拿到了更好的模型,而这套模型要进入日常工作流,还需要一次面向真实流程的前瞻性检验。
原文链接:Nature Biomedical Engineering
千方医数集编辑部 出品
