22,445次前列腺MRI验证:SCARLET-1中AI外部AUC 0.86/0.89/0.84,与标准诊断一致率83.0%–87.9%,25家中心28%的AUC低于0.80
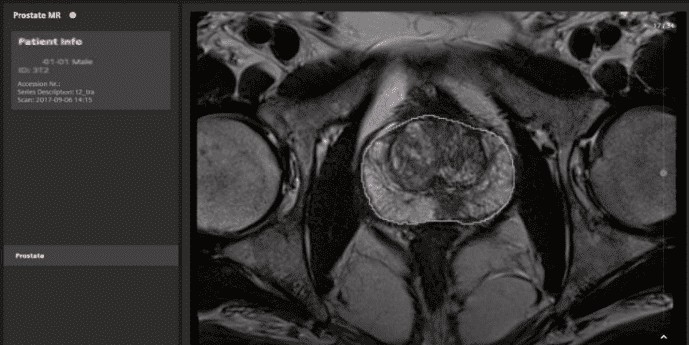
Radiology于2026年10月13日发表SCARLET-1研究:22,445次前列腺MRI、21,252名男性(中位年龄66岁),数据来自2012年1月至2024年10月、22国46城。外部测试AUC为PRIME 0.86(95%CI 0.83–0.90)、STHLM3-MRI 0.89(0.86–0.92)、IP1-PROSTAGRAM 0.84(0.70–0.95);AI与标准诊断对Gleason≥2级癌的一致率为83.0%、87.9%、87.7%,三套数据均达预设互换性标准。25家中心中28%的AUC低于0.80、32%不低于0.90。
事实报道 × 医疗数据从业者 | 趋势前瞻 × 监管与合规专家 | 深度研报
22445次前列腺MRI、21252名男性、22国46城,《Radiology》2026年10月13日刊出的SCARLET-1给出了影像AI迄今最国际化的一份外部验证。三套外部测试集上,AI判别Gleason 2级及以上癌的AUC为0.86、0.89、0.84,与标准诊疗的一致率为83.0%、87.9%、87.7%,均达预设门槛。但25家中心中28%的AUC低于0.80,达标之下藏着中心间落差。
开场:22,445次前列腺MRI、21,252名男性,AI与标准诊断互换性迎来国际确证
影像AI此前并不缺少好数字,缺的是在真实人群、真实设备、真实阅片链条上仍然成立的数字。多数前列腺MRI模型的验证集中在单一联盟或单一国别数据上,跨队列迁移后性能下滑是常态。SCARLET-1的设计目标因此不是再加一个内部测试集,而是回答一个更接近监管口径的问题:AI的判定能否与标准诊疗的诊断结果互换。研究于2012年1月至2024年10月间回溯收集疑似前列腺癌男性的MRI检查,最终纳入22,445次检查、21,252名男性患者,中位年龄66岁,四分位间距60至71岁。样本横跨22个国家46座城市,既覆盖诊断场景,也覆盖有组织的人群筛查场景,这是它与此前一批模型最重要的差别。论文发表于《Radiology》第321卷第1期,DOI为10.1148/radiol.262081,以CC BY 4.0许可发布。
事实底座:22国46城回顾性队列,训练集18,471次,三套外部测试集共1974例
这批数据的切分方式值得数据从业者逐层看清。总样本为回顾性收集并由46家中心去标识化处理,入组条件为直肠指检异常、PSA不低于3 ng/mL或Stockholm3评分不低于0.11,且既往无Gleason 2级及以上前列腺癌。数据被切分为六部分:训练集18,471次;两套内部测试集,分别为PI-CAI的1,000例与来自22座城市13个国家的异构集1,000例;三套外部测试集,分别为诊断场景的PRIME(476例,患病率30%,11个国家)、人群筛查场景的STHLM3-MRI(1,108例,患病率17%,瑞典)与IP1-PROSTAGRAM(390例,患病率4%,英国),三套合计1,974例。训练与内部测试集由参与中心的连续采样与方便样本混合构成,而外部测试集的受试者来自各自试验的前瞻招募,这一区别决定了外部测试数字的相对分量。研究在治理层面同样做了交代:统计分析计划事先预注册,各参与中心的机构或区域伦理委员会审批通过,由国际科学顾问委员会监督,因回顾性使用去标识化健康数据而豁免知情同意,美国参与站点按HIPAA合规处理。
主终点数字:一致率83.0%、87.9%、87.7%,外部AUC 0.86/0.89/0.84全部达标
主要终点是AI判读与标准诊疗对Gleason 2级及以上癌判断的一致率,互换性定义为相对于平均水平放射科医生的估计一致率、容差0.05。三套外部数据上的结果分别为83.0%(395比476,校正95%CI为78.8%至87.0%)、87.9%(974比1108,85.6%至90.3%)与87.7%(342比390,83.6%至91.5%),全部通过预设门槛。判别性能方面,外部AUC在PRIME为0.86(95%CI 0.83至0.90)、STHLM3-MRI为0.89(0.86至0.92)、IP1-PROSTAGRAM为0.84(0.70至0.95)。亚组表现相当稳健,跨年龄、风险分层、肿瘤位置与族裔的平均ΔAUC仅0.02,这一项对监管审评尤其关键,因为它直接回应了模型在不同人群亚组上是否公平这一常被打问的问题。
数据从业者视角:25家中心28%的AUC低于0.80,图像质量分层AUC 0.78至0.88
把注意力从总体转向分布,结论就不再一律乐观。25家临床中心之间差异显著,28%的中心AUC低于0.80,同时32%的中心不低于0.90,两端差距远大于亚组间的0.02。按图像质量分层,AUC在0.78至0.88之间浮动。对数据从业者而言,这组数字的含义很具体:模型性能的方差主要不由人口学特征解释,而由数据来源与成像过程解释,设备型号、扫描协议与质控水平才是部署前必须盘查的变量。因此在本地上线前,用本地数据重新校准并逐台设备验证阅片链路,其必要性高于按人群亚组做公平性再采样。此外,在固定高特异度88%至90%、敏感度73%至76%的工作点上,两个筛查队列的活检净收益方向并不一致,STHLM3-MRI多检出约26%的高级别癌但不必要的活检翻倍以上,IP1-PROSTAGRAM则减少逾19%的不必要活检,工作点选择本身就是一项需本地决策的临床权衡。
冷静观察:回顾性外部验证非前瞻流程,平均放射科医生基准可能偏乐观
三点局限需要同步写进判读。其一,这是回顾性外部验证,用的是已经完成的试验数据,并非把AI放入门诊流程的前瞻性试验,AI在真实工作流中如何影响活检决策与患者结局仍未在此得到回答。其二,作为对照基准的平均放射科医生不是本地重读结果,而是依据PI-CAI观察研究(62名放射科医生、45家中心、20个国家、阅读400例)按各队列患病率校正后的统计估计,作者承认这一基准可能偏乐观,互换性结论的强度因此受制于基准本身的可靠性。其三,IP1-PROSTAGRAM队列患病率仅4%,AUC置信区间宽至0.70至0.95,该队列的单个数字不宜被单独引用。方法学上则有加分项:统计分析方法事先预注册于arXiv编号2508.03762v2,报告遵循STARD-AI与TRIPOD+AI,且无任何产业资助,这套组合可作为后续影像AI注册申报的方法学参照。
原文链接:Radiology(北美放射学会)
千方医数集编辑部 出品
