1亿条去标识化病历连成纵向数据网:BioStack获950万美元种子轮,给医疗AI供训练数据
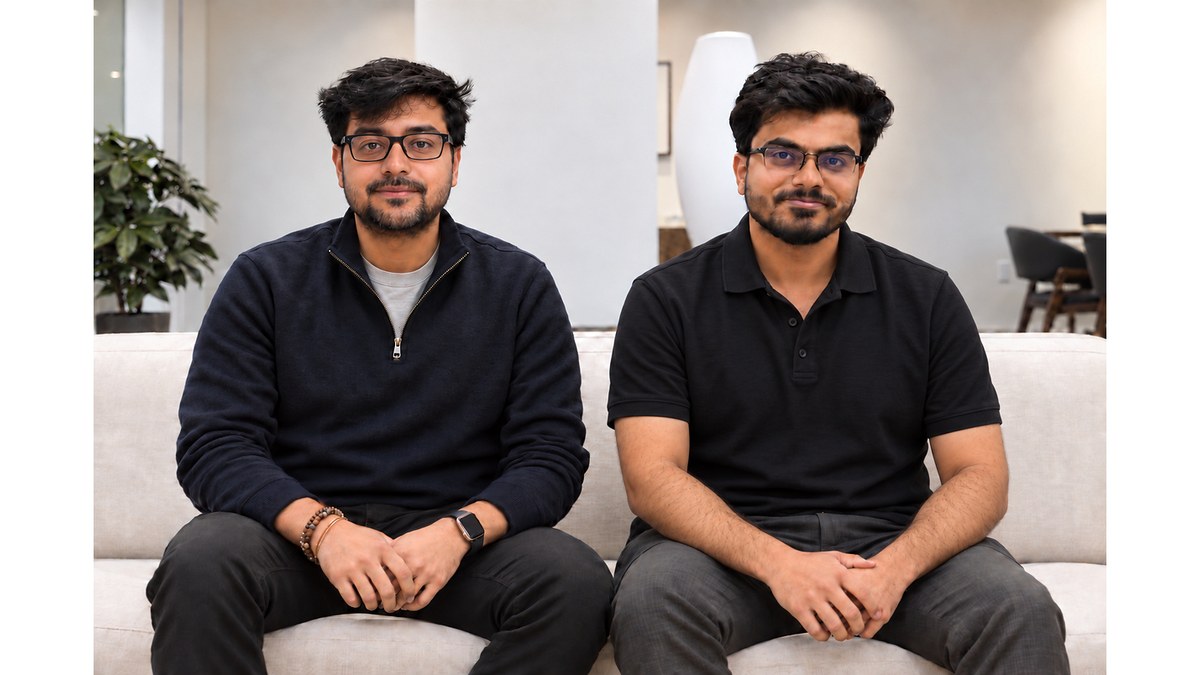
BioStack宣布完成950万美元种子轮融资,Peak XV领投,Afore Capital、DCVC、Y Combinator等8家机构参投。公司搭建覆盖美国、印度、巴西、阿根廷四国的医院数据网络,聚合超过1亿条去标识化患者记录,将数十万张医学影像与病理、临床记录合并为多模态训练数据集,供给医疗AI模型训练。公司披露已有17家客户与潜在客户。这一模式瞄准医疗AI的核心瓶颈:高质量、纵向、多模态的真实世界训练数据稀缺。
数据视角 × 医疗数据从业者 | 事实报道 × 投资人与产业分析师 | 行业观察
超过1亿条去标识化患者记录、数十万张医学影像,分布在四个国家的医院网络里——这是一家种子轮公司手里的数据底牌。10月22日,Y Combinator孵化的BioStack宣布完成950万美元种子轮融资,并正式对外亮出其数据基础设施网络:把分散在美国、印度、巴西、阿根廷医院里的碎片病历,拼接成可供医疗AI训练与评测的多模态纵向数据集。公司披露目前已有17家客户与潜在客户。
开场:医疗AI不缺模型,缺的是能训练模型的病历
过去几年,医疗AI的叙事重心一直在模型侧:更大的参数、更强的推理、更高的基准分。但一个越来越清晰的事实是,模型能力正在被数据供给卡住。病历分散在不同医院、不同信息系统、不同国家的格式里,患者一次完整的诊疗旅程被切成互不相连的片段——笔记在一家机构的文档系统里,检验在LIS里,影像在PACS里,用药与结局又散落在别处。
BioStack切入的就是这一层。它要做的事不是发明新模型,而是把碎片化的临床信息连接起来,覆盖笔记、检验、影像、用药、治疗与结局,形成纵向的患者视图。联合创始人兼CEO Sanat Mishra在公告中说,收集与每位患者关联的每一个事件,才能看清患者旅程的每个阶段发生了什么,公司搭建的是让临床信息对今天的医生和未来的AI开发者都可用的基础设施。
950万美元与8家机构:种子轮的阵容
本轮950万美元种子轮由Peak XV领投,参投方名单拉得很长:Afore Capital、DCVC、Emerson Collective、SV Angel、Verdict Capital、Streamlined Ventures与Y Combinator,合计8家机构。
资金用途有三个方向:
- 继续在美国及国际市场扩张医院数据网络
- 开发数据连接与去标识化的技术平台
- 扩充工程与研究团队
领投方的表态值得记录。Peak XV副总裁Pushpak Kedia称,医疗AI的下一个前沿不只取决于更好的模型,更取决于能否获得反映患者长期治疗过程的高质量纵向数据,BioStack有机会成为下一代医疗AI的重要数据层。这句话基本概括了本轮融资的投资逻辑:押注的是数据层,不是应用层。
四国1亿条记录:美国、印度、巴西、阿根廷
数据规模是这篇公告里最硬的一组数字:BioStack目前与美国、印度、巴西、阿根廷的医院合作,网络聚合的去标识化患者记录超过1亿条。
四国组合并非随机选择。它给公司提供了差异极大的患者人群与医疗环境——支付体系、病种结构、诊疗路径各不相同。对训练数据而言,这种多样性本身就是资产:只在美国单一医疗体系里训练的模型,换一套病谱和用药习惯就可能失效。公告还披露了一个具体应用:在印度,BioStack正协助把癌症患者与一项在研癌症疫苗项目对接,患者的临床数据支持生物技术公司的开发工作,符合条件的患者也可能因此获得高度个性化的在研治疗。
从数据视角看,这一模式的关键动作有两步:先按各医疗机构的协议建立保护隐私的定制化工作流,再对从各机构收集的数据做去标识化,形成专有数据集,服务于医学研究、药物开发以及医疗AI模型的训练与评测。公司给自己的定位是在临床照护与医学创新之间建立反馈回路——纵向数据越多,研究者对疾病进展与治疗反应的理解越深,反过来又惠及医疗机构。
把笔记、检验、影像、用药、治疗和结局连成一条线,BioStack提供的不是某个数据点的规模,而是患者层面的完整视图。
多模态纵向数据:影像合并病理与临床记录
在1亿条记录的底盘之上,BioStack披露了一项更具体的数据工程成果:已把数十万张碎片化的X光、MRI与CT影像,与病理和临床记录合并到一起。公告将产出物描述为训练AI智能体的资源,用来帮助临床医生评估治疗方案与可能的患者结局,同时也被定位为供医疗AI智能体使用的强化学习环境。
这个组合的技术含义值得拆开看。单模态数据集在市场上并不稀缺,影像有影像的库、病案有病案的库;真正的瓶颈在于同一患者身上的多模态对齐——影像时间戳能否对上病理报告、检验曲线与治疗记录。这正是「纵向」二字的含金量:研究者能看到患者发生了什么,以及不同干预随时间推移如何改变了健康结局。
平台规划支持的应用方向包括:
- 医疗AI模型的开发与评测
- 临床研究与疾病建模
- 生物标志物发现
- 患者分层与治疗反应分析
对照商业进展,公司披露的客户与潜在客户数为17家。对于一家刚出种子轮的公司,这个数字说明需求端确实存在,但付费转化与单客户价值尚未披露。
冷静观察:去标识化数据合规与数据质量的执行难点
先把边界说清楚。950万美元是种子轮,不是对数据网络估值的确认;1亿条记录是「可接入」的网络口径,不等于已完成清洗、标注与多模态对齐的可用数据集;17家是「客户与潜在客户」的合并口径,两者比例未披露。公告中也没有任何营收、合同金额或交付节奏的数字。
执行层面的难点集中在两处。其一是跨国合规:四国涉及HIPAA、印度DPDP、巴西LGPD等不同隐私框架,去标识化标准与数据跨境规则各异,任何一国的执法收紧都会直接影响网络的可扩张性。其二是数据质量:把「碎片」变成「纵向数据集」需要实体匹配、术语归一与时间轴对齐,这些环节的质量控制流程在公告中完全未被描述,数十万张影像与病理记录的配对准确率无从验证。
横向对比更能定位这家公司:Tempus能以每条100美元的价格向Pathos出售50万条去标识化记录,靠的是多年积累的结构化深度与药企信任。BioStack的差异化赌注在于地理多样性与多模态纵向结构,但与先发者在结构化深度和商业化成熟度上的差距同样明显。种子轮只是入场券,它能否把「接入了多少记录」转化为「交付了多少可用数据集」,才是下一个观察点。
原文链接:PR Newswire
千方医数集编辑部 出品
