让诊室录音自己打不良反应分级,VOICE-AE的99.2%里有多少是真本事
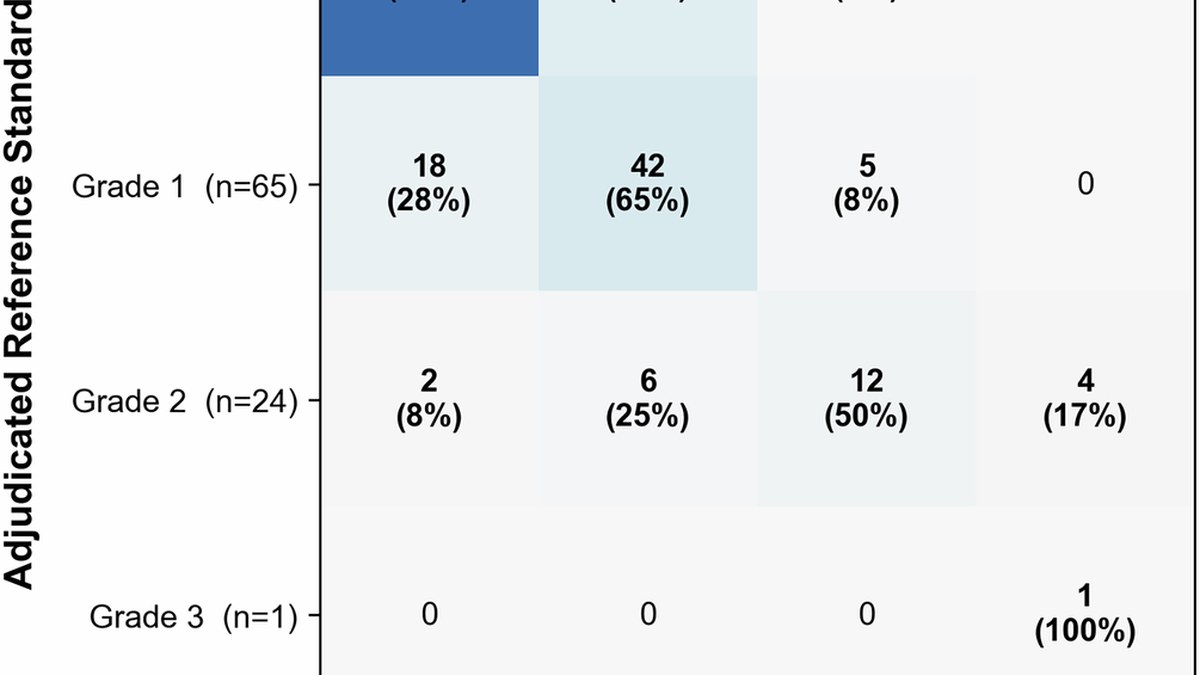
npj Digital Medicine于2026年10月10日在线发表VOICE-AE:一套整合自动语音识别、说话人分离与大语言模型的多阶段流水线,用于从临床医生与患者的诊室录音中自动提取并按常见不良事件评价标准(CTCAE)分级。研究纳入31名接受放疗的前列腺癌患者共39次就诊,产生390次就诊-毒性评估,其中300次(76.9%)参考分级为0。六名盲态评分员的评分员间Krippendorff alpha为0.677。VOICE-AE相对共识标准的平均加权kappa为0.717,Krippendorff alpha为0.669,CTCAE分级完全一致率为82.6%,容差一级准确率为99.2%。
影响分析 × AI技术供应商/创业者 | 事实报道 × 医院信息化/临床医生 | 行业观察
开场:99.2%这个数字要先减去76.9%的平凡基线
治疗相关不良事件文档化是公认的人力密集型工作,而且不同观察者之间本身就存在变异。npj Digital Medicine 发表的 VOICE-AE 给出了另一条路:直接从临床医生与患者的诊室录音中,自动提取并按常见不良事件评价标准分级,把文档化从人工填写变成机器起草。
论文给出的两个数字很容易被拿去传播:与共识参考标准相比,CTCAE 分级完全一致率 82.6%,容差一级准确率 99.2%。但同一篇论文紧接着做了一次诚实的对照——由于参考分级中 300 次(76.9%)本身是 0 级,一个始终预测 0 级的平凡分类器就能拿到 76.9% 与 93.6%。
先把基线减掉再看增量
这道减法是产业侧最该先做的一步。99.2% 里绝大部分由类别分布贡献,去掉平凡基线之后,模型真正创造的空间远比标题数字看起来小。对供应商而言,这决定了产品叙事是省人力还是凑指标;对医院信息科而言,这决定了采购时该问的第一个问题不是准确率多少,而是基线多少。指标口径一旦选错,内部立项与对外宣传都会顺着错误的方向走很远,等到本地验证阶段才发现无可挽回。
数字之外的产品定位
从落地形态看,VOICE-AE 处理的是诊后文档化,而不是诊中实时提示。这一点对工程与合规都友好:系统不必抢在对话进行中给出结论,也就绕开了延迟、打断医生注意力、即时纠错等一系列难题,允许以批处理方式运行,并留出人工确认的时间窗口。
流水线怎么搭的:语音识别、说话人分离与大语言模型三段
VOICE-AE 不是单个模型,而是一条多阶段流水线:自动语音识别把录音转成文本,说话人分离区分医生与患者的发言归属,大语言模型在转写结果上完成毒性提取与 CTCAE 分级。研究记录并处理的,是接受放疗的前列腺癌患者的真实就诊,评估对象为泌尿生殖与胃肠道两类共 10 项毒性。
串联结构的工程含义
三段串联意味着误差会沿链路累积。识别环节的错词、说话人归属的错位,都会在不知不觉中变成分级环节的输入噪声,而最终评估只会看到末端结果。这类系统的工程难点因此不在大模型那一端,而在前面两段的稳定性,以及每一段能否被单独替换、单独评测。
环境录音是比病历文本更脏的输入
诊室录音属于典型的环境采集场景,重叠说话、口音、设备差异都会进入数据。相比结构化病历,这条链路更贴近真实工作流,也更依赖前处理质量。谁能在前两段做出可复用的稳健性,谁才谈得上把后端的模型能力变现。
拿什么当标尺:六名盲态评分员与专家聚类的共识标准
这项研究在标尺上花了力气:六名盲态评分员基于同一份转写,独立对 10 项泌尿生殖与胃肠道毒性分级;层级聚类从中识别出专家评分员子集,用以建立共识参考标准。
人工一致性本身就是天花板
六名评分员在有序分级上的 Krippendorff alpha 为 0.677。这个数字提醒我们,所谓金标准并非无噪声。VOICE-AE 相对共识标准的平均加权 kappa 为 0.717、Krippendorff alpha 为 0.669,与这一人工基准处在同一量级。
同类比较更有说服力
在限定到三位专家聚类评分员的同类比较中,VOICE-AE 与这些专家的加权 kappa 为 0.666,略低于专家彼此之间的 0.681。差距很小,方向仍然是低。对供应商来说,这条结果既是可用的论据,也指出了评估基建的必要性:没有自有、多标注、带一致性度量的测试集,产品就无法向医院证明自己在同类比较中站得住。
真正该看的地方:驱动处置的1级与2级毒性上表现如何
整体一致率会掩盖关键分层的表现,而研究恰恰把这个短板摊在了台面上:在驱动临床处置的分级上,模型表现更弱。1 级毒性的 F1 为 0.58,2 级毒性的 F1 为 0.57。二分类检测层面,敏感性 77.8%、特异性 89.0%、精确率 68.0%。
换成工作流语言
- 敏感性 77.8% 意味着真有毒性时约有两成会被漏掉,这类漏检无法靠事后抽查兜住。
- 精确率 68.0% 意味着机器标出的事件里约三成需要人工推翻,全量自动化并不成立。
- 0.58 与 0.57 的 F1 说明,恰恰在需要触发随访、剂量调整或干预的那几档,系统最不可靠。
可行的定位是起草与预筛
把结论翻译成部署方案:这套系统当前更合理的定位是自动生成分级草稿,由临床人员确认或修正,从而压缩书写时间,而不是独立签发分级结论。文档化工作的劳动量集中在录入与整理,草稿化本身已经具备落地价值,前提是复核成本被算进产品账。真正会被医院认真计算的,是复核一遍所耗的时间与直接填写之间的差额,差额为负的产品在临床上推不动,无论整体一致率写得多好看。
冷静观察:自动化文档化的门槛不在整体一致率,在 actionable 分级
先说边界。研究纳入 31 名患者、39 次就诊,产生 390 次就诊与毒性的配对评估,且集中在单一癌种与单一治疗方式。任何把它包装成通用能力的说法都越过了证据边界,跨癌种、跨治疗方式的推广需要各自重测。
门槛的具体位置
决定这套系统能不能进院的,不是 82.6% 或 99.2%,而是分级与二分类检测上的那组数字。采购与验收口径应当改为按分级报告的 F1、敏感性与精确率,并附上本地数据的复核结果;宣传口径里的整体一致率,必须与平凡基线并列呈现,否则就是误导。
还要跨过的三道坎
其一是录音采集与说话人分离的现场稳定性,其二是在本地患者群体上的重新验证,其三是由谁为自动生成的分级负责、留痕如何设计。三者都不难,但都绕不过去。研究给出的结论是谨慎的——VOICE-AE 的表现落在专家间一致性的区间内,支持自动化、诊后不良事件文档化的可行性;可行不等于可替代,82.6% 更不能等同于可以撤掉人工分级这一环节。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
