脓毒症患者会不会在ICU长期住下去,17项SOFA特征在入院24小时内给出答案
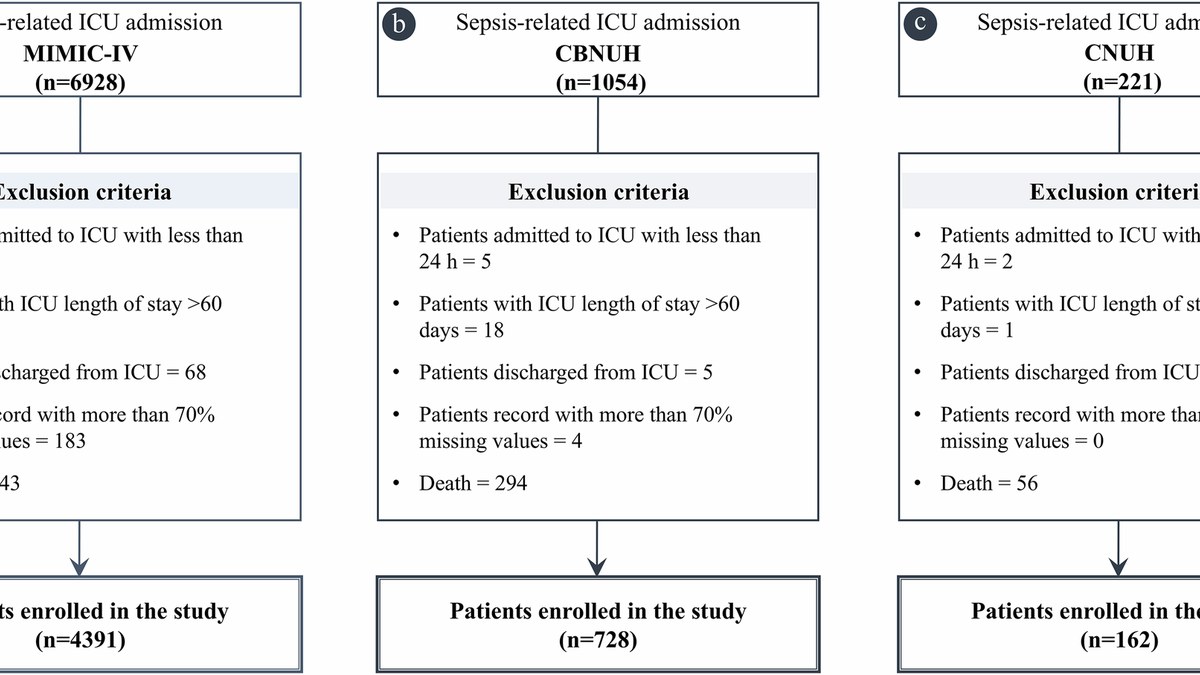
npj Digital Medicine于2026年10月9日在线发表一项研究:团队用混合深度学习模型FT-TabNet配合自适应门控融合框架,基于入住ICU后24小时内可常规采集的17项SOFA相关特征,预测脓毒症患者是否会发生超过4天的长期ICU滞留。模型在MIMIC-IV数据集上完成开发与内部验证,内部验证AUROC为0.848;随后在韩国忠北大学医院与忠南大学医院两个单中心队列做外部验证,AUROC分别为0.823与0.781。研究用SHAP提供患者级的关键贡献因素解释。
事实报道 × 医院信息化/临床医生 | 影响分析 × 监管与合规专家 | 深度研报
开场:把预测时点压到入院后24小时,用的是17项本来就有的数据
npj Digital Medicine 在线刊出的一项研究,把脓毒症患者长期 ICU 滞留的预测窗口压缩到入住 ICU 后的最初 24 小时,所用变量只有 17 项,且全部是基于序贯器官衰竭评估,也就是 SOFA,衍生出来的常规采集特征。
研究的现实起点是重症资源的负荷问题。脓毒症是 ICU 收治的主要原因之一,常与延长的 ICU 停留相伴,而长时间停留又会推升发病率、医疗资源利用,并加重重症救治资源的紧张。论文指出,尽管现有临床严重程度评分已被广泛使用,但它们对脓毒症患者个体层面的长期 ICU 滞留风险捕捉不足。这构成了一个新的建模切口:不追加新的检查项目,而是在既有数据上重做风险判别。
从资源压力到个体判别
对 ICU 管理者而言,床位周转与人力排班的决策往往在入院早期就要做出;而对临床医生而言,需要提前知道的是具体某一名患者会不会拖成长住。该研究正是把预测目标从疾病的严重度评分,转向了以时间为刻度的资源占用结局。
来源是常规数据,不是新增检查
这一选择有两层含义。其一,模型的可用性不依赖任何额外的检验项目或专科评估,数据采集成本已经由日常的器官功能评分承担;其二,24 小时的截取窗口把预测锁定在入院首日,要求原始数据在当天完成结构化归集,而不是等到出院时回填。对已经上线重症信息系统的科室来说,复现门槛更多落在数据管道,而非算法本身。
结局怎么定的:超过4天的ICU停留才算长期滞留
模型的预测终点是 prolonged ICU stay,即长期 ICU 滞留,定义为 ICU 停留时间超过 4 天。这是一个以床位占用为核心的结局变量,而非死亡或器官衰竭等生理终点。
为何看重这一定义
- 超过 4 天的停留直接对应可被计划的资源:床位、护理配比、后续转出安排。
- 该定义在数据来源上易于统一计算,便于跨队列复核。
- 结局与预测特征之间存在明确的时间先后,24 小时内的特征先于第 4 天的结局成立。
需要说明的是,素材给出的是这一阈值设计本身,研究并未在本文披露更换阈值后的敏感性结果,因此不宜外推到其他截断值下的表现。
一条单向的关联链条
论文阐述的逻辑是单向的:长期 ICU 停留与发病率上升、医疗资源利用增加、重症救治资源承压相伴出现。但研究并未报告干预之后资源指标改善的任何数据。换言之,把高危患者识别出来只是链条的第一环,是否据此调整后续安排、调整之后效果如何,均属于本研究之外的问题。
模型是什么:FT-TabNet加上自适应门控融合
研究团队开发的是混合深度学习模型 FT-TabNet,并为其配置了自适应门控融合框架(adaptive gated fusion)。输入侧的 17 项特征全部来自 SOFA 体系。
结构与数据流
入住 ICU 后 24 小时内可得的 17 项 SOFA 相关特征,进入 FT-TabNet 主干进行表征学习,融合环节由自适应门控机制按样本调节各路输入的贡献权重,最终输出患者发生超过 4 天 ICU 滞留的概率。
为什么不只用传统评分
传统严重程度评分采用的是固定权重的加和逻辑;而混合深度学习结构是让模型在数据中自行学习特征间的非线性关系,门控融合则进一步允许模型按样本动态地分配关注度。研究将其定位于辅助临床决策与 ICU 资源分配,而非取代临床判断。
难度落在哪一端
17 项特征的规模并不算大,建模的挑战主要来自患者间的异质性与特征交互,而非高维输入本身。混合结构配合门控机制,指向的正是让模型自行判断在具体某一例患者身上更倚重哪部分信息。素材未披露训练样本规模、超参数设置与对照基线,因此无法对其相对增益做量化判断。
0.848与0.781之间:外部验证的落差说明了什么
模型的开发与内部验证使用 MIMIC-IV 数据集,内部验证 AUROC 为 0.848。外部验证在韩国忠北大学医院(CBNUH)与忠南大学医院(CNUH)两个单中心队列完成,AUROC 分别为 0.823 与 0.781。作者将这一表现描述为具有一致性、仅存在轻微波动。
三点证据链上的读数
- 由 0.848 到 0.823,落差约 0.025,仍在同一量级区间,提示跨数据集迁移没有出现崩塌。
- 由 0.823 到 0.781,同属韩国医疗体系内的两家医院之间仍有约 0.042 的差距,说明中心间差异本身不容忽视。
- 外部验证仅覆盖韩国两家单中心队列,地域、人种结构与医疗体系均高度同质,不足以支撑跨洲或跨医疗体系的能力宣称。
把三个数字连起来读,可以得到一个相对稳妥的判断:同一模型在同源数据内部的 0.848,与迁移到外部数据源后的 0.823、0.781,构成一条由内向外的衰减曲线,而这种衰减在两家同处韩国的医院之间依然存在,意味着至少有一部分性能与特定中心的数据生成方式绑定。素材未提供校准曲线、决策曲线或亚组分析的结果,因此关于概率校准质量与净获益的讨论无法在此展开。
需要克制的一点是:AUROC 的下降衡量的是判别排序能力的迁移损失,不能据此断言模型不可用;同样,素材中也没有任何临床落地、院内部署或前瞻性使用的记录,不得宣称其已进入临床流程。
冷静观察:SHAP给的是患者级解释,不等于临床决策依据
研究引入了基于 SHAP 的可解释性方法,使得模型能够输出患者层面的关键贡献因素解读,即针对每一个被评估的患者,说明哪些特征把风险往上或往下推。
解释力的边界
- SHAP 给出的贡献排序建立在模型自身的输入之上,解释的是模型为何如此输出,不等同于因果推断。
- 17 项特征之外的变量并未纳入模型,任何未被采集的因素都不会体现在解释结果里。
- 单患者的解释结果需要结合临床语境读取,若脱离病历背景,容易被误读为行动指令。
从合规视角看,一个辅助预后的工具要走向使用,至少还要跨越外部验证的广度、人群的代表性、以及解释结果的责任归属三道关口。该研究目前的贡献更接近于把问题界定清楚,并给出了一条在常规数据上可复现的技术路径:用入院 24 小时内的既有数据,提前甄别可能长期占用 ICU 的脓毒症患者。
把视线放到更长的落地链条上,这项工作所处的位置更接近方法学验证,而非产品化验证。素材没有涉及该模型是否满足临床决策支持类软件的合规要求、由谁对模型输出负责、以及在何种情形下应当推翻模型的建议。就此而言,它可以被读作风向,尚不能被读作结论。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
