脑 MRI 基础模型表征的隐私账:仅凭公开嵌入即达最高 99% 的 rank-1 患者重识别,记录性别推断平衡准确率 95.5%
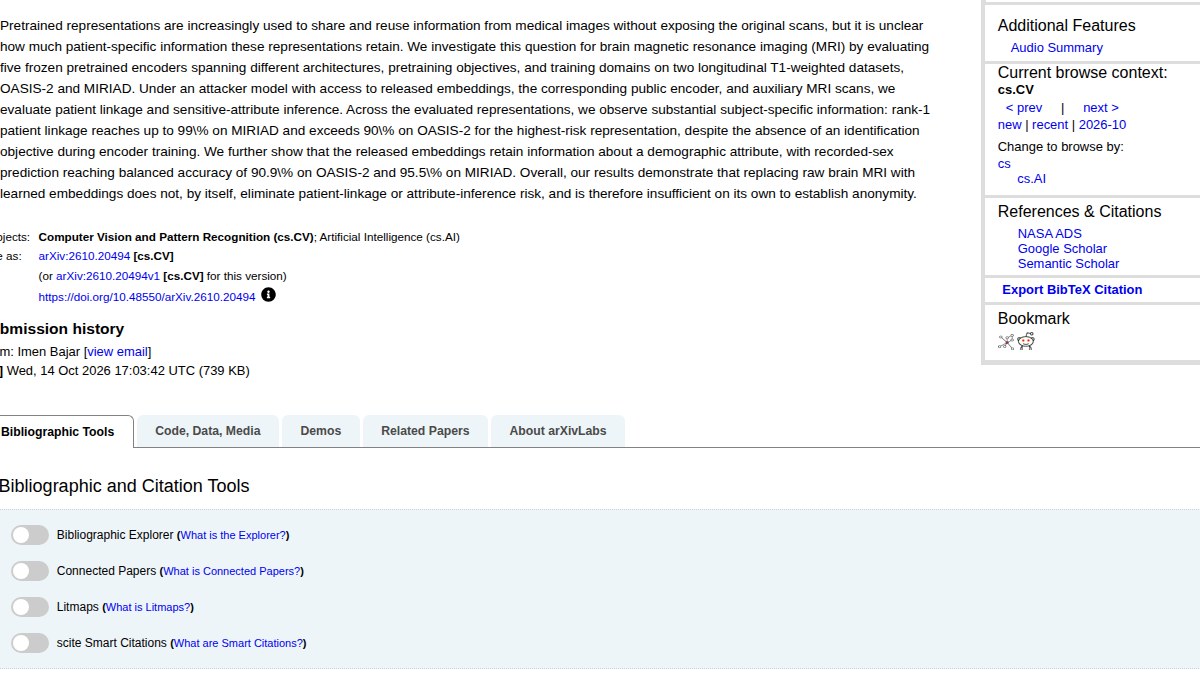
arXiv 于 2026 年 10 月 14 日挂出预印本,量化脑部 MRI 基础模型表征的隐私风险。团队在 OASIS-2 与 MIRIAD 两个纵向 T1 加权数据集上评估五个冻结的预训练编码器,覆盖不同架构、预训练目标与训练域;攻击者模型假设可访问已发布的嵌入、对应的公开编码器以及辅助 MRI 扫描,据此评估患者链接与敏感属性推断两类风险。结果显示各表征保留了大量受试者特异信息:风险最高的表征在 MIRIAD 上 rank-1 患者链接高达 99%、在 OASIS-2 上超过 90%,尽管编码器训练时并不存在任何识别目标;记录性别预测在 OASIS-2 上平衡准确率为 90.9%、在 MIRIAD 上为 95.5%。结论是用学习到的嵌入替代原始脑 MRI,本身不足以确立匿名性。
arXiv 预印本量化脑 MRI 基础模型表征隐私风险:五冻结编码器测评,最高风险表征 rank-1 重识别达 99%,记录性别推断 95.5%
数据视角 × 医疗数据从业者 | 影响分析 × 监管与合规专家 | 深度研报
一篇 2026 年 10 月 14 日挂上 arXiv 的预印本,给脑部 MRI 基础模型表征算了一笔隐私账。研究者围绕五个冻结的预训练编码器,在 OASIS-2 与 MIRIAD 两个纵向 T1 加权数据集上模拟攻击者:只凭已发布的嵌入、公开编码器与辅助 MRI 扫描。结果显示,风险最高的表征在 MIRIAD 上 rank-1 患者链接高达 99%,在 OASIS-2 上超过 90%;记录性别预测在 MIRIAD 上平衡准确率 95.5%、在 OASIS-2 上 90.9%。
开场:把原始扫描换成嵌入再共享,是不是就等于匿名
预训练表征正被越来越多地用于共享与复用医学影像信息,其卖点很直接:不交出原始扫描,只交出模型算出来的向量。机构之间既想互通有无,又不愿触碰数据出境与患者授权的复杂流程。支撑这种做法的隐含假设是,经过模型压缩之后,与个体身份相关的细节已被稀释,留下的只是可供下游任务复用的语义信息;论文要检验的正是这些表征到底保留了多少患者特异信息。编号为 arXiv:2610.20494、学科标注为 cs.CV 与 cs.AI 的预印本,标题为 Quantifying privacy risks in foundation model representations of brain MRI,于 2026 年 10 月 14 日提交,正是冲着这个问题而来。研究者把提问方式收紧为可测量的形式:攻击者拿到已发布的嵌入后,能在多大程度上把向量对应到具体患者,又能读出多少本不该外泄的属性。对医疗数据从业者而言,这一提问方向本身就值得警惕:嵌入不是脱敏证明,它只是一份尚未被审计的新形态数据资产。
实验怎么设:五个冻结编码器、两个纵向 T1 数据集、三类攻击者资源
实验设计的关键在于覆盖面与假设的克制。评估对象为五个冻结的预训练编码器,覆盖不同架构、不同的预训练目标与不同的训练域,研究过程中不对编码器做任何微调,以贴近真实场景中嵌入被直接发布、模型权重与训练方式一并公开的情形,即嵌入是在没有任何下游适配之下生成的。把五个编码器并排比较,还能回答一个更实际的问题:风险是来自某一类特定设计,还是广泛存在于不同做法之中。测试数据来自 OASIS-2 与 MIRIAD 两个纵向 T1 加权数据集,纵向采集意味着同一受试者在不同时间点有多个扫描,天然提供了跨时间匹配的可能,也正因如此,患者链接风险才有了可度量的落点。攻击者模型被限定为三类资源:已发布的嵌入、与这些嵌入对应的公开编码器,以及一批辅助 MRI 扫描。这一假设既不夸大也不弱化,攻击者无法侵入训练系统,也无法获取医院的私有标签,只是利用了公开可得的材料。在此框架下,研究评估两类风险,一是患者链接,即判断两段嵌入是否来自同一名受试者,二是敏感属性推断,即从嵌入中恢复受试者的个人属性。
患者链接那一条:MIRIAD 上 99%、OASIS-2 上超过 90% 的 rank-1
患者链接的结果构成了整篇论文最有冲击力的部分。被评估的各表征都保留了大量受试者特异信息,风险最高的那一个表现尤为突出:在 MIRIAD 数据集上,rank-1 患者链接准确率高达 99%,意味着给定一段待查嵌入,攻击者排在第一位的匹配对象往往就是正确的受试者;在 OASIS-2 数据集上,同一表征的 rank-1 指标同样超过 90%。rank-1 的口径是只取相似度最高的那一个候选答案,在如此严格的判定条件下仍有这样的表现,说明嵌入保留了足够显著的个体差异,足以支撑直接匹配。更值得注意的是取得这一结果的前提:编码器在训练时并不存在任何识别目标,重识别能力完全是预训练过程中信息压缩的副产品,而非任务的直接产物。换言之,即便模型开发者从未打算让模型记住谁是谁,模型依然记住了。从监管与合规的角度看,这条证据链的意义在于切断了一种常见免责逻辑:以没有显式身份标签或没有身份识别目标为由主张嵌入已匿名,在数据层面站不住脚。
属性推断那一条:记录性别平衡准确率 90.9% 与 95.5%
第二类风险指向嵌入中残留的人口学信息。研究者指出,已发布的嵌入仍保留人口学属性信息,其中记录性别可以被相当稳定地恢复:在 OASIS-2 数据集上,记录性别预测的平衡准确率达到 90.9%;在 MIRIAD 数据集上,这一数字进一步升至 95.5%。选择平衡准确率这一指标也说明研究者注意到了类别分布不均衡的问题,所报告的并非靠多数类堆砌出来的虚高数字,而是在两类上取平均后的表现。与患者链接不同,属性推断并不要求把嵌入对应到某个具体的人,它衡量的是嵌入整体暴露了多少可描述信息,因此两类风险彼此独立,需要分别评估。这一结果对隐私评估的边界提出了直接挑战:在不少数据治理框架中,性别、年龄一类字段被单独列为受保护属性,其泄露本身就构成需要申报的风险事件,而与能否定位到具体个人无关。把两类风险放在一起看,论文的总体结论也就清晰了:用学习到的嵌入替代原始脑 MRI,本身不能消除患者链接风险或属性推断风险,因此不足以单独确立匿名性。
冷静观察:预印本未经同行评审,99% 是最高风险表征的上限,不等于所有嵌入都如此
在把结论搬进制度文本或技术方案之前,需要先划出适用范围。首先,这是一篇预印本,未经同行评审,其中的结论与数字均未经过期刊层面的核实,方法细节、数据集划分方式与指标计算口径都可能在正式审稿后调整,引用时应当保留这层不确定性。其次,被广泛传播的 99% 并不是一条普遍规律:它是特定数据集与特定攻击者假设下、针对风险最高的那一个表征测得的数值,描述的是上限风险;被评估的其他表征并未达到同一水平,论文也从未主张任何脑 MRI 嵌入共享都会被重识别。此外,攻击者需要同时掌握公开编码器与辅助 MRI 扫描,这一条件在现实中的成立与否取决于具体的发布方式,并非所有共享场景都能满足。合理的读法是把它当作一次压力测试的结果,看清楚在最不利的组合下会发生什么,以及在把嵌入当作可公开资产释放之前,需要先补上哪些量化的泄露评估。对监管与合规专家而言,这份预印本提供的不是一份处罚清单,而是一个提醒:匿名性必须作为可验证的技术指标来主张,而不是作为共享数据的默认前提。
千方医数集编辑部 出品
