数据稀缺下的药物合成预测,主动学习配几何图神经网络跑通了闭环
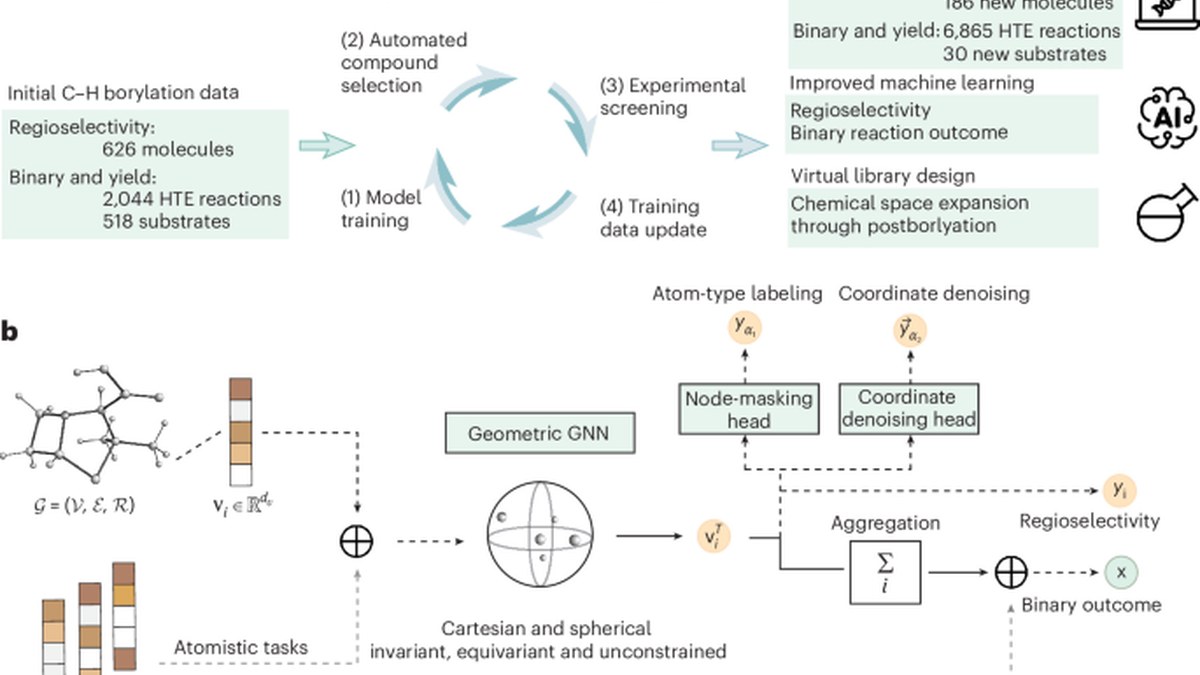
Nature Computational Science于2026年10月9日在线发表一项研究:团队提出一套整合闭环工作流,将高效反应数据采集与高精度深度学习结合,用于解决数据稀缺场景下的化学反应预测。研究开发了由树模型集成驱动的主动学习策略,用于指导获取信息量最大的实验室实验;该实验战役产出一个面向C-H硼酸化反应的多样化基准数据集。在此基础上,团队训练并评估了几何图神经网络,证明为这类具备对称感知能力的模型增加自监督辅助任务,可持续提升反应结果预测与区域选择性预测两方面的表现。
趋势前瞻 × 药企研发负责人 | 数据视角 × AI技术供应商/创业者 | 深度研报
开场:生成式分子设计造得出来,不代表合成得出来
在线发表于Nature Computational Science的这项研究,把开篇判断写得很直接:生成式分子设计的成功,取决于它所创造分子的合成可得性。这句话把注意力从生成能力本身,移到了生成结果能否落地。
生成与合成之间的落差
生成模型优化的是结构层面的目标,例如活性、选择性、理化性质;合成可得性则是另一套约束,涉及路线是否存在、步骤是否可行、收率是否可接受。两类目标并不天然对齐,一个在打分函数上表现优异的分子,完全可能在路线设计阶段被卡住。这种错位不会被生成阶段的指标反映出来,只会在推进到湿实验时才暴露。
为什么这道落差值得单独处理
对研发负责人而言,错位发生的时点决定了成本。越晚发现不可行,前面已经投入的筛选与评估资源越难回收。把合成可得性的判断前移,与其说是方法学偏好,不如说是流程成本控制的必要动作。
本研究的落点
团队没有继续扩大生成模型的规模,而是转向预测侧:若能在设计阶段较为准确地判断一个反应能否发生、发生在哪个位点,生成结果的可用性就会整体上移。这两问恰好对应后续两项任务——反应结果预测与区域选择性预测,前者管能不能成,后者管成在哪个位置。这一选择也决定了后续路线:先解决数据从哪来,再解决模型怎么建。
瓶颈在哪:参考数据不足,区域选择性尤其难预测
摘要对当前计算模型的判断是效果受限,限制来自两处。
第一重限制:参考数据的缺口
计算模型可以帮助预测化学反应,但参考数据的缺乏直接压制了它的有效性。反应数据的产生依赖实际实验,可得记录在覆盖面与一致性上难以支撑高精度建模。
第二重限制:区域选择性
第二重限制更难处理:准确预测反应的区域选择性。它要回答的不是反应能否发生,而是发生在分子的哪个具体位点。同一底物上往往存在多个化学性质相近的候选位点,模型需要在彼此之间做出区分,这对表征精细度的要求远高于一个二分类判断。
两重限制的叠加
两重限制互相放大。数据本就稀疏,区域选择性又要求细粒度区分,可用样本被进一步摊薄。更重要的是,这两重限制都无法靠调参绕过:模型结构的改进需要一个足够密的样本网格来支撑学习,而网格本身就缺。这也解释了本研究为何没有直接从模型结构入手,而是先处理数据来源。从数据侧动手,等于先承认约束的性质是供给侧而非算法侧。
闭环怎么搭:树模型集成驱动的主动学习去挑最该做的实验
主动学习的角色
方案是一套整合式闭环工作流,把高效的反应数据采集与高精度深度学习结合起来。闭环的关键在于采集不再独立于建模:由模型状态决定下一批做什么实验,实验结果再回流到模型。
树模型集成作为驱动
驱动这一决策的,是一套由树模型集成支持的主动学习策略,其目标是识别出信息量最大的实验室实验。对技术供应商而言,这里的取舍值得记取:树模型集成并非最终预测模型,它充当的是采集决策器,承担不确定性评估与样本筛选。把决策器与预测器拆开,是这套工作流在结构上最值得借鉴的一点。
一次实验战役换来一份基准数据
在这一策略指导下开展的实验战役,产出了一个面向C–H硼酸化的多样化基准数据集。摘要用多样化来描述它,意味着采集过程并未收敛到狭窄的化学空间,而是保持了底物覆盖的广度。这一点对后续建模是实质性的:主动学习若只追求信息量而不加约束,样本会向模型当前最不确定的区域聚集,反而牺牲覆盖;多样化这一描述说明约束是有效的。这份定制数据集随后被用于训练与评估几何图神经网络,采集与建模由此形成了一条可复用的链路。
几何图神经网络加自监督:两项任务同时受益
为什么是几何图神经网络
模型侧选择的是几何图神经网络,摘要强调其对称感知特性。分子结构的对称性天然约束着等价位点的判断,对区域选择性任务而言,这种归纳偏置与问题结构是直接对应的。
自监督辅助任务的作用
核心方法学结论是:为这类对称感知模型增加自监督辅助任务,能够持续提升表现。自监督的价值在于让模型从大量未标注结构中学习表征,这部分学习不消耗稀缺的反应标注。在数据稀缺场景中,这是把标注预算用在关键处的做法。
两项任务同时受益
提升并不局限于单一任务。摘要指出,改善同时出现在反应结果预测与区域选择性预测两项任务上。对工作流而言这一点很关键:结果预测与位点判断通常是串联的两个环节,只在其中一个环节取得进展,整体可用性仍会被另一环节限制住。
冷静观察:未见底物全部命中才是真检验
前瞻性测试的含金量
真正的检验来自前瞻性测试。团队在未见底物上检验了这套工作流,底物中包含具挑战性的N-杂芳基结构,结果显示全部案例都正确定位了硼酸化位置。前瞻性与未见是两个不可省略的限定词:它不是留出集上的回顾性打分,而是对真实未知底物的推断。
边界仍需守住
边界同样清楚。摘要把这套工作流的实用价值定位在高效的药物优化,而非通用反应预测方案;全部命中的结论建立在C–H硼酸化这一反应类型及其配套数据集之上,不能据此推断其他反应类型的区域选择性也能被同等处理。一个反应上的闭环跑通,证明的是这条路径可行,不是所有路径都已打通。
接下来要看什么
从趋势看,更值得关注的是这套结构的迁移成本:主动学习负责压低数据获取成本,自监督负责压低标注消耗,几何图神经网络负责把结构先验带进表征。三者都是可替换的模块,真正的变量在于换一个反应类型时,实验战役需要多大体量才能重新建起可用基准。在此之前,把它读成一条已被验证的数据策略,比读成一个通用的反应预测产品更稳妥。
原文链接:Nature Computational Science
千方医数集编辑部 出品
