把社会决定因素并入急诊需求预测,逐小时误差压到2到3名患者
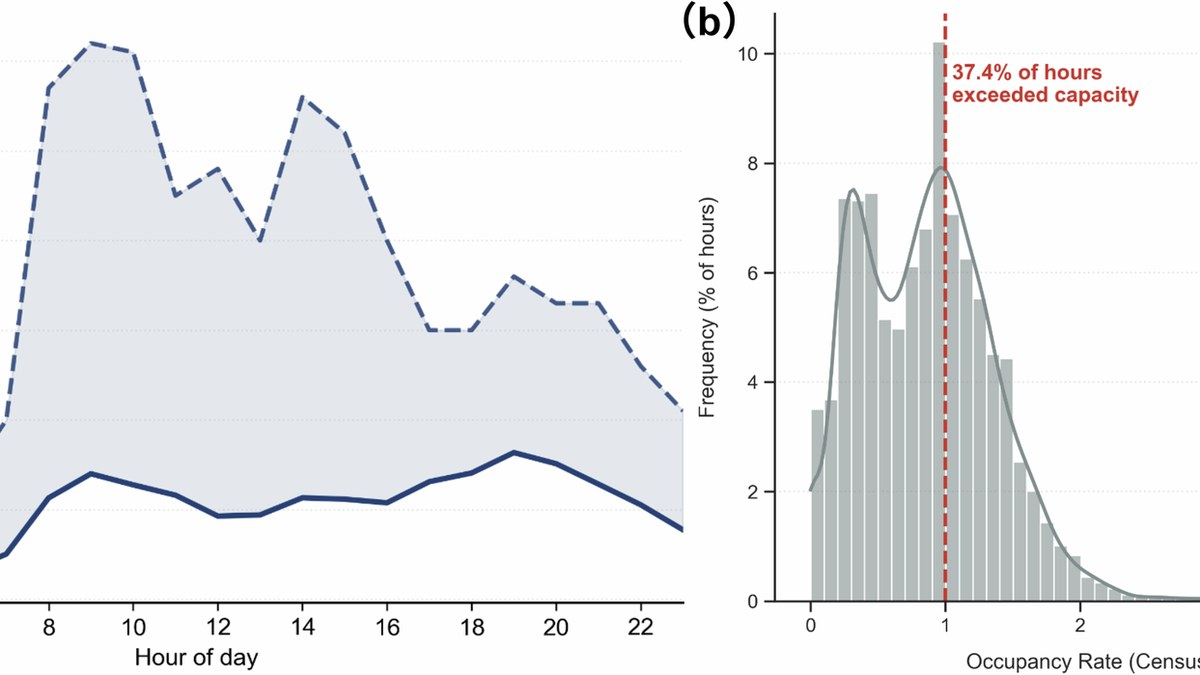
npj Digital Medicine于2026年10月12日在线发表一项研究,提出整合健康社会决定因素的急诊科需求逐小时预测方法。研究背景为急诊拥挤与治疗延迟及死亡率上升相关,主动排班需要提前的需求预测作为依据。数据来自武汉一家三甲教学医院,共213138次就诊被聚合为22883个小时观测。研究构建的复合模型在均方根误差指标上表现最佳,平均绝对误差约为每小时2到3名患者。研究把社会决定因素变量纳入预测框架,使逐小时需求估计不仅依赖历史就诊量,也纳入人群层面的结构性信息。
数据视角 × 医疗数据从业者 | 趋势前瞻 × 医院信息化/临床医生 | 深度研报
开场:急诊拥挤的代价是延迟与死亡率,主动排班需要提前量
急诊科(Emergency Department, ED)拥挤长期被当作一道运维难题,但它最终会落到临床结局上:已有证据把急诊拥挤与治疗延迟、死亡率上升联系在一起。对一线管理者而言,真正的难点在于拥挤往往是既成事实之后才被看见的,等分诊台前排起长队、留观床位全部占满,可调配的人手与时间窗口都已经收窄。
这正是主动排班的意义所在。所谓主动排班,是指在需求真正到达之前就调整医护班次与开放床位,而它的前提是要有提前量,即可依赖的短期需求预测(demand forecast)。没有提前量,排班只能被动跟随实时到达量;有了提前量,才有可能在高峰到来之前完成人员与空间的调度。
问题在于,现有多数运营模型的输入相对单薄,主要依赖时间规律或天气模式。论文作者指出,这类模型可能不足以捕捉背后的人群脆弱性(population vulnerability),也就是一个社区在怎样的结构条件下更容易产生就诊需求。这正是本次研究试图补上的一环。该论文在线发表于 npj Digital Medicine,页面 datePublished 为 2026 年 10 月 12 日,研究目标被明确设定为急诊科需求的逐小时预测。
数据怎么来的:21万余次就诊压成2万余个小时观测
数据来自中国武汉的一家三甲教学医院,研究共纳入 213138 次就诊记录。这些记录并非以单次就诊为单位直接进入模型,而是被聚合为 22883 个小时观测,也就是把连续的就诊流压缩成一条以小时为刻度的时间序列,用于逐小时预测任务。
在建模之外,作者还做了一层描述性观察:不同社区在年龄结构与诊断谱(diagnostic profiles)上差异明显,说明这家医院所覆盖的服务区域内,医疗需求本身是高度异质的。这一步为后续引入社区层面变量提供了直接依据,如果各社区的需求结构本就趋同,额外变量能带来的边际信息会非常有限。
把粒度定在小时,本身是一次取舍。以天为单位的预测太粗,无法指导班次切换;以分钟为单位则噪声过大,且运营上难以响应。小时刻度既贴合排班的调整节奏,也让就诊量在时间轴上具备可建模的规律。21万余次就诊被压成2万余个小时观测,意味着平均每个小时观测背后是接近十次的就诊,这为逐小时建模提供了足够的样本密度。
需要提醒的是,这是一项回顾性研究。数据反映的是这家医院在特定时间段内的历史就诊情况,因此模型学到的是这一场景下到达量的规律,而非某种普适的物理定律。
加了什么:社会决定因素变量进入模型
本次研究的核心变量增量是健康社会决定因素(Social Determinants of Health, SDoH)。与常见的个体层面风险因子不同,SDoH 在研究中被处理为社区层面的结构性信息,用于刻画人群所处的社会条件,并作为动态特征(dynamic features)进入模型。研究采用 XGBoost 构建预测框架,并同时给出可解释模型,以支撑后续的资源分配决策。
在对比设计上,作者把纳入动态 SDoH 特征的模型与仅使用天气变量的模型放在一起比较,结果是前者持续优于后者。整体表现最好的复合模型在均方根误差(Root Mean Square Error, RMSE)指标上表现最佳,其数值为每小时 3.48 次就诊;对应的平均绝对误差(Mean Absolute Error, MAE)为每小时 2.62 次就诊,决定系数 R² 为 0.68。
论文的结论表述相当克制:在预测短期急诊需求这件事上,社区层面的社会脆弱性可能比天气条件提供了更具信息量的信号。对数据从业者来说,这句话的分量在于它提示了一类新的可用特征来源,即把人群结构信息接入运营预测。
误差意味着什么:每小时2到3名患者对排班够不够用
真正应该带走的指标不是 R²,而是误差的量纲。研究给出的平均绝对预测误差在各类情景下约为每小时 2 到 3 名患者,这个口径可以直接换算成排班所需的人力余量:如果系统对下一小时需求量的估计偏差稳定落在两三人以内,管理者就能据此设定弹性班次与备用人力,而不必按照最坏情形超额配置。
换算背后的逻辑并不复杂。逐小时预测的误差如果以十人计,排班表只能留出大量冗余,人力成本难以承受;如果以两三人计,排班的缓冲量就可以被精确设定,既避免过度配置,也避免配置不足。对科室管理者而言,这种可量化的余量比一个抽象的准确率数字更有操作意义,因为它能直接写进排班规则。
研究也因此把自身定位为支持主动排班的需求预测工具,其价值链条被描述为预测、排班与容量规划三段:把融合 SDoH 的预测接入医院运营,或许能让班次调整发生得更早,从而有助于缓解与拥挤相关的风险。
冷静观察:预测准不等于能调配,资源约束才是下一道关
研究的边界需要被明确标注。数据来自单一医院、单一地区,且为回顾性数据,因此该模型不能被推广为跨区域通用的需求预测模型。不同城市、不同层级医院在服务人群结构与就诊行为上的差异,都可能在模型迁移时放大误差。
同样重要的是,预测精度的提升不能被解读为拥挤状况已经缓解,也不能被解读为患者结局已经改善。误差变小只说明估计值更接近实际到达量,它并不会自动带来更多医生、更多床位或更短的等待时间,中间仍隔着资源配置这道实体环节。
从预测到调配之间,横着资源约束这一关。当模型提示下一小时将多来三名患者,而科室既没有可调配的护士、也没有可开放的留观床位时,再准的预测也只能停留在看板上。对医院信息化团队与临床团队而言,下一步真正值得验证的,是把逐小时预测接入排班与床位调度流程之后,等待时间、滞留时间与拥挤指标是否随之发生变化。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
