学员水平比模型选择重要5倍:AI标准化病人首项随机对照试验的冷结论
发表于npj Digital Medicine的研究报告了AI标准化病人(SP)的首项多模型评估与随机对照试验。Phase 1用五个前沿大语言模型生成350次模拟问诊;Phase 1b对155次真实学生问诊做自动分析以定位课程缺口;Phase 2为三臂试点随机试验(n=58,大连医科大学92名学生参与研究体系)。方差分析显示,学员技能水平对沟通表现的解释力(η²=0.31)约为模型选择(η²=0.06)的5倍——决定教学效果的是学生差异而非换用哪个大模型。
数据视角 × AI技术供应商/创业者 | 趋势前瞻 × 医院信息化/临床医生 | 深度研报
医学院要买一套AI标准化病人系统,第一件事通常是问:底层接哪个大模型?10月23日发表于npj Digital Medicine的一篇论文,用首项多模型评估加随机对照试验给这个问题泼了冷水。研究团队来自大连医科大学第一附属医院麻醉科,他们构建的AI标准化病人(AI-SP)用同一套三层信息架构驱动五个前沿大语言模型,生成350次模拟问诊并接受盲法专家评估。方差分析的结论是:学员技能水平对沟通表现的解释力为η²=0.31,模型选择只有η²=0.06——前者约是后者的5倍。决定教学效果的是学生之间的差异,而不是换用哪个大模型。
开场:医学院该挑哪个大模型?试验说这个问题可能问错了
标准化病人是临床沟通训练的中枢环节,但长期被成本高、难以规模化、依赖训练有素的演员三件事卡着。大语言模型出现后,市场迅速冒出一批AI标准化病人产品,而采购讨论几乎无一例外地滑向同一个问题:用哪家模型。
这篇论文把这个商业话术问题改造成了可测量的统计学问题。研究团队没有直接把模型接上对话界面,而是先设计三层信息架构:表层信息主动给出,中层信息在被直接追问时披露,深层信息——例如会改变临床决策的用药史——只有学员展现共情式探询时才释放。披露节奏由架构控制,模型只是执行者。
换句话说,作者把「病人像不像」从营销问题挪回了教学设计问题。对医学教育AI供应商,这个实验设计本身就是信号:壁垒不在模型选型,而在病例信息的结构化设计。
在共同架构之下,决定模拟问诊质量差异的主因不是模型,而是学员自身水平——这个结论直接挑战了「换更强的模型就能提升教学效果」的默认假设。
350次模拟问诊:五个前沿模型的横向对比
Phase 1的设计相当工整。研究团队构建五个标准化病人剧本,覆盖不同病种与递增的隐藏复杂度,用统一提示词模板(每个场景约78行,涵盖患者身份、三层信息条目、披露条件与情绪模型)驱动五个前沿大语言模型——GPT-4o、Claude、Gemini、Qwen、Deepseek,共生成350次模拟问诊,交由7名医学教育者盲法评估。
评估有两层目的:表层是横向比较同一架构下五个模型扮演的病人孰优孰劣;深层是方差分解——把表现差异拆开,看多少来自模型选择,多少来自学员水平。
对正在选型的创业者,这个设计值得抄作业:它把模型对比从主观演示变成带效应量的实验,是任何想自证产品效果的厂商都可复用的最小可信实验单元。
η²=0.31对0.06:学员差异的解释力是模型差异的5倍
核心数字来了。盲法评估的方差分析显示:共同架构之下,学员技能水平解释31%的表现变异(η²=0.31),模型选择只解释6%(η²=0.06),相差约5倍。
翻译成采购语言:在同一套信息披露架构上,换模型能买到的差异,远小于不同水平学员之间的天然差异。低年资学员身上表现平平的系统,换到高年资学员身上可能立刻「变好」——不是模型变了,是探询能力触发了更深层的披露。任何只用单一水平测试者演示效果的厂商演示,说服力都值得打折。
作者也留下诚实的限定:试验没有设置「无架构」对照组,无法确定效应究竟来自架构本身;但「架构优先、模型可迁移」作为工作假设,已获初步支持。
对模型供应商这不是坏消息:五个前沿模型在统一架构下都能胜任,说明通用能力已越过教学可用性门槛;对做上层应用的创业者,提示很明确——护城河在结构化病例资产与披露逻辑,而非绑定某一家模型。
从模拟到教学:155次真实问诊分析与三臂随机试点
研究没有停在模拟层。三个阶段环环相扣:
| 阶段 | 设计 | 规模 | 核心发现 |
|---|---|---|---|
| Phase 1 | 五模型生成模拟问诊,盲法专家评估 | 350次对话 | 学员技能η²=0.31 ≫ 模型选择η²=0.06 |
| Phase 1b | 真实学生问诊的自动化分析 | 155次问诊 | 系统性漏问安全关键信息,可自动定位课程缺口 |
| Phase 2 | 三臂试点随机试验(AI-SP对真人SP对对照) | n=58 | OSCE提升与真人SP无显著差异(p=0.483) |
Phase 1b做了一件教学管理者梦寐以求的事:自动分析155次真实学生问诊,发现学员系统性地漏问安全关键的隐藏信息——例如会改变决策的用药史。这类「课程缺口诊断」过去依赖专家现场旁听,成本高且覆盖有限,现在可以批量完成。
Phase 2是三臂试点随机试验:61名学生入组,按性别分层区组随机分入AI-SP组(n=21,文本对话、不限时使用)、真人SP组(n=18,预约语音通话)和对照组(n=19,仅常规课程),3人退出后58人进入意向性分析。结果:AI-SP组的OSCE成绩提升与真人SP组无显著差异;自我效能感提升在数值上以AI-SP组最大(p=0.034,效应量d=0.62),但这一探索性差异在多重比较校正后不再成立。
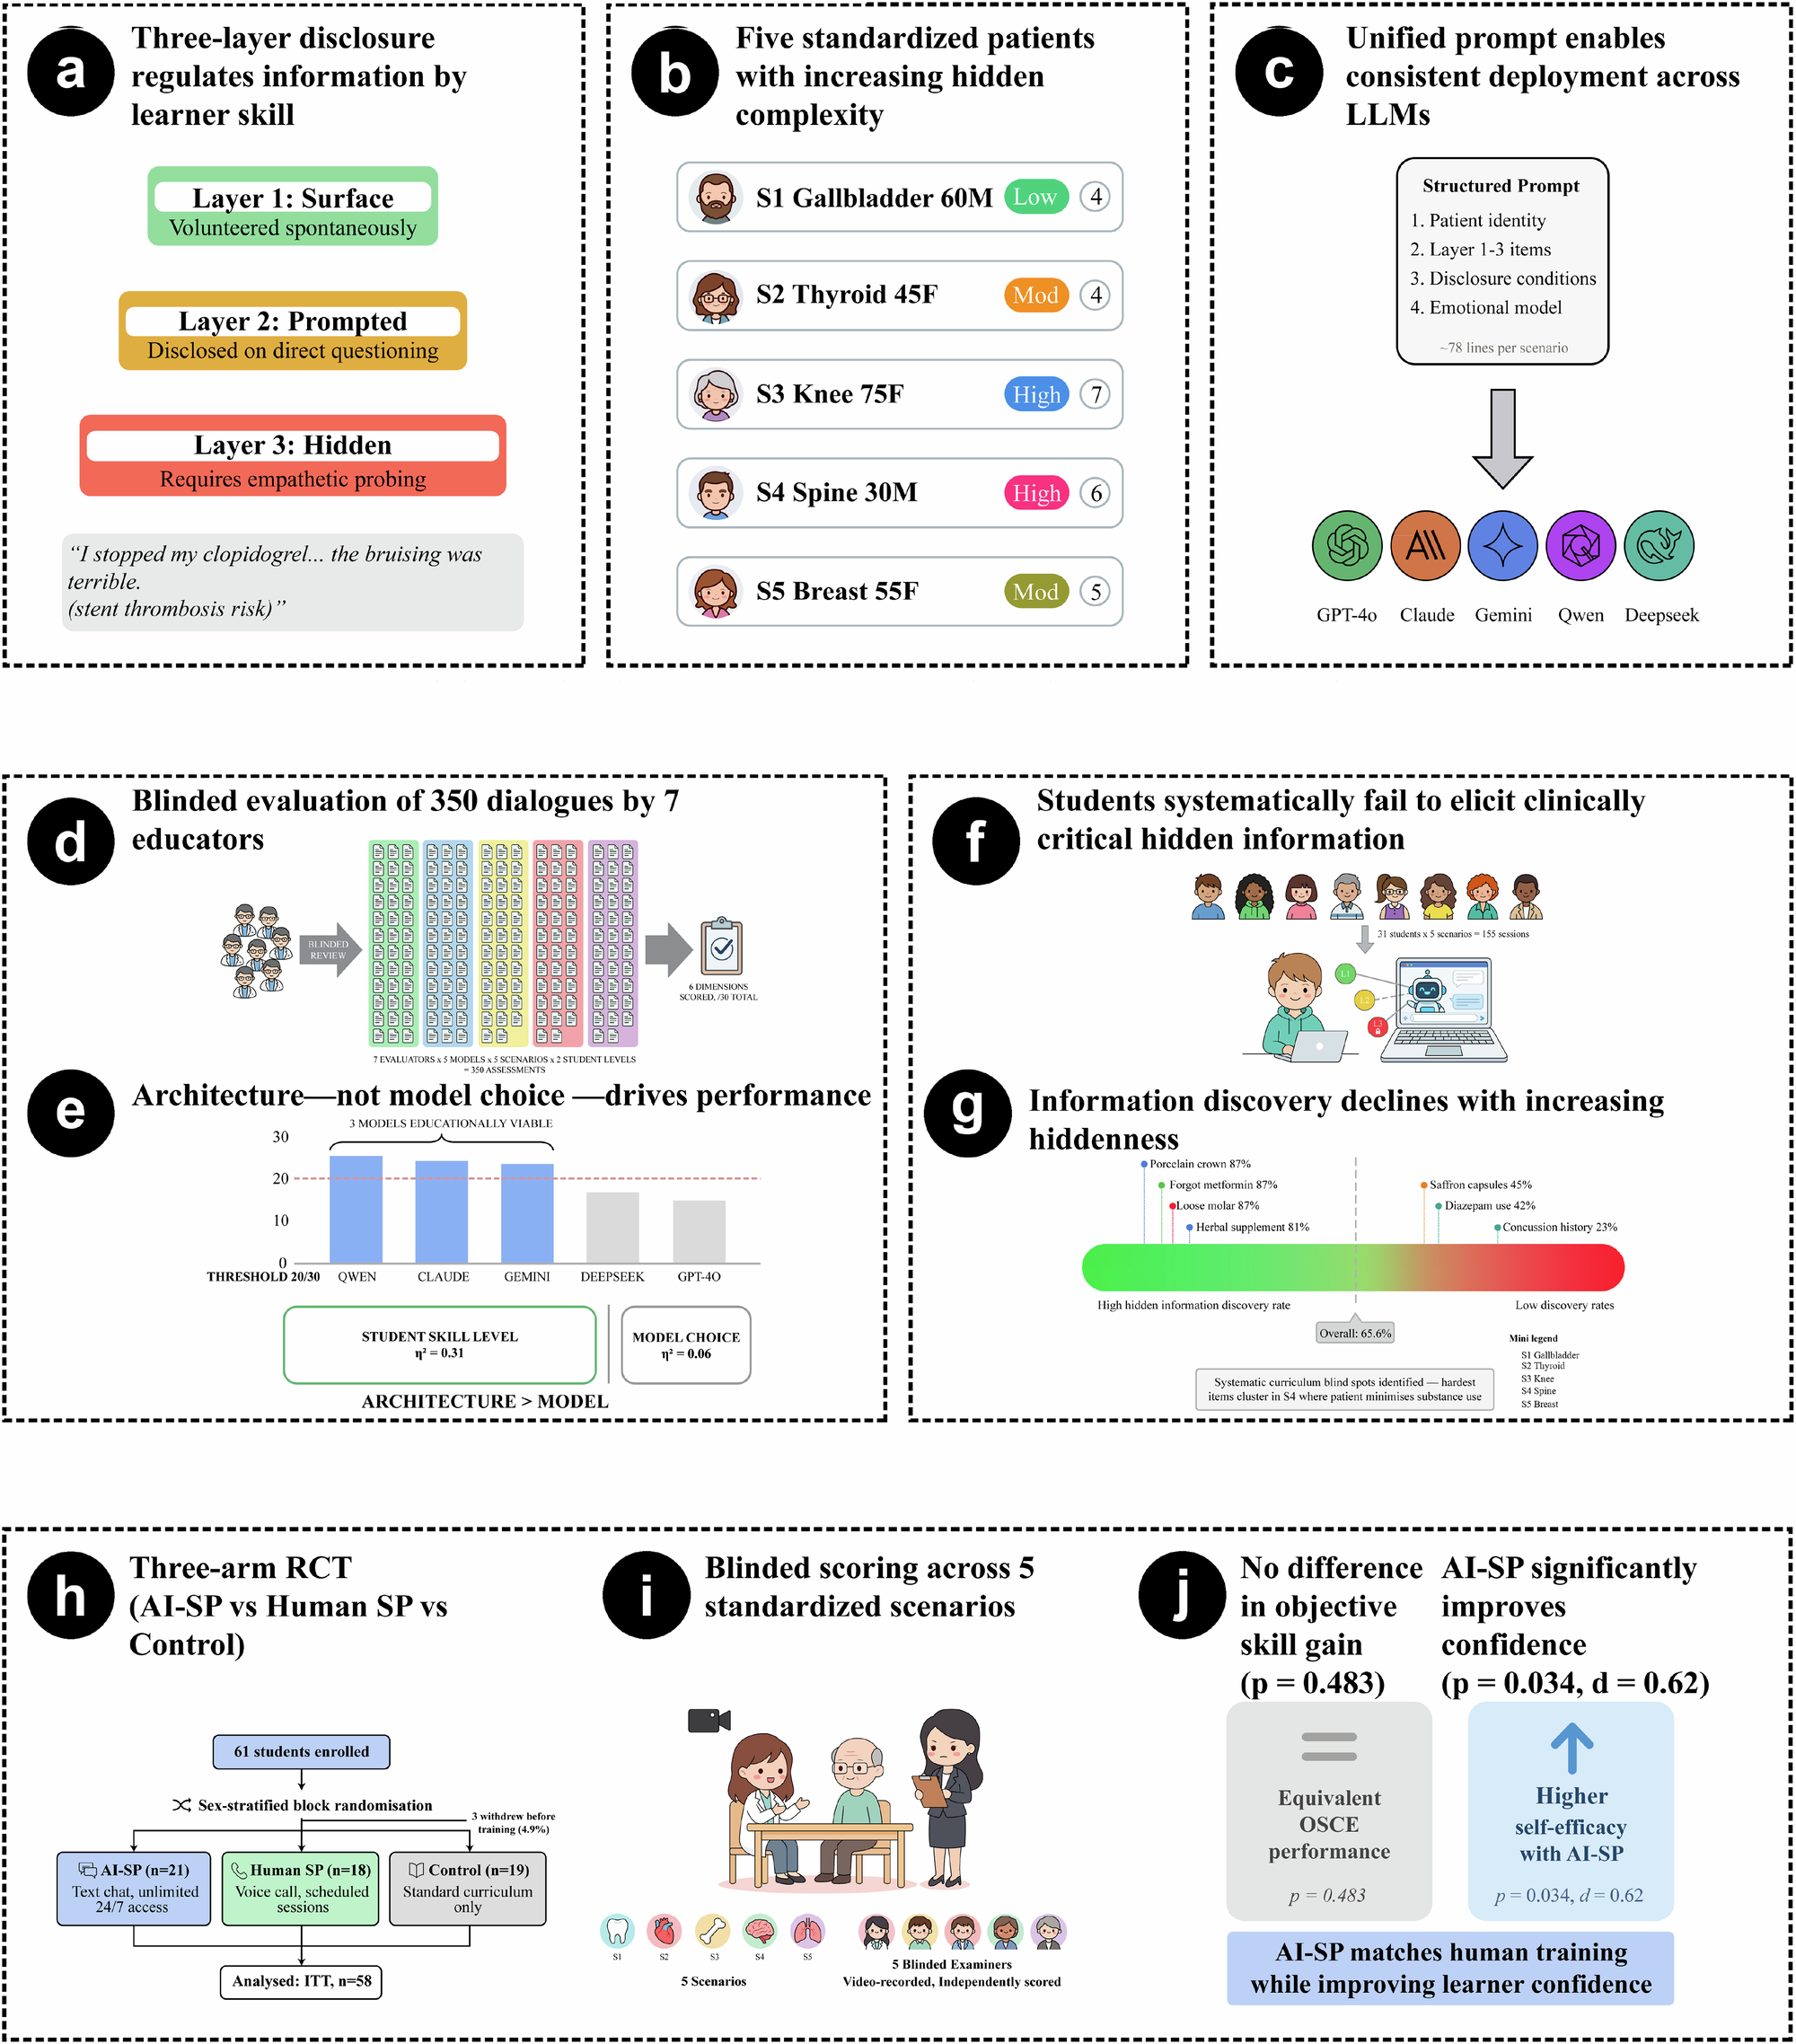
整个研究体系共覆盖大连医科大学92名医学生。作者强调,试点的定位是为未来确证性研究估计效应量,而非证明等效——这个自我定位值得所有引用者记住。
冷静观察:n=58的试点样本与单一医学院的外推边界
先把边界一条条摆出来:
- Phase 2是n=58的试点随机试验,且明确设计为效应量估计,不能作为「AI-SP等效于真人SP」的证据
- 全部学生来自单一院校(大连医科大学),不同课程体系与生源下的可复制性未知
- 自我效能感的优势是探索性结果,未通过多重比较校正,不能作为产品宣传点
- 长期学习结局——这些训练是否转化为真实临床沟通能力——没有测量
- η²=0.31对0.06的对比基于共同架构,架构本身的贡献未经独立验证
- 论文目前为提前上线的接收版本,正式版本仍可能有修改
对供应商和创业者,正确读法有两层。减法:别再拿「接了最新最强的模型」当核心卖点,模型选择只解释6%的表现变异。加法:三层信息披露架构、自动化课程缺口诊断、按学员水平自适应调节,才是被实验验证过的差异化方向。Phase 1b展示的「从问诊语料自动诊断课程缺口」,几乎是直接可产品化的数据服务形态:学校缺的从来不是一个会聊天的病人,而是知道学生哪里不会问。
医学教育是一个采购决策慢、证据要求高的市场。首项多模型评估加随机对照试验的出现,意味着这个品类开始从演示驱动进入证据驱动阶段——先适应这一点的厂商,会在下一轮招投标里占先。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
