口腔白斑的癌变风险随时间变化,OCRiskNet给出个体化的时间分辨估计
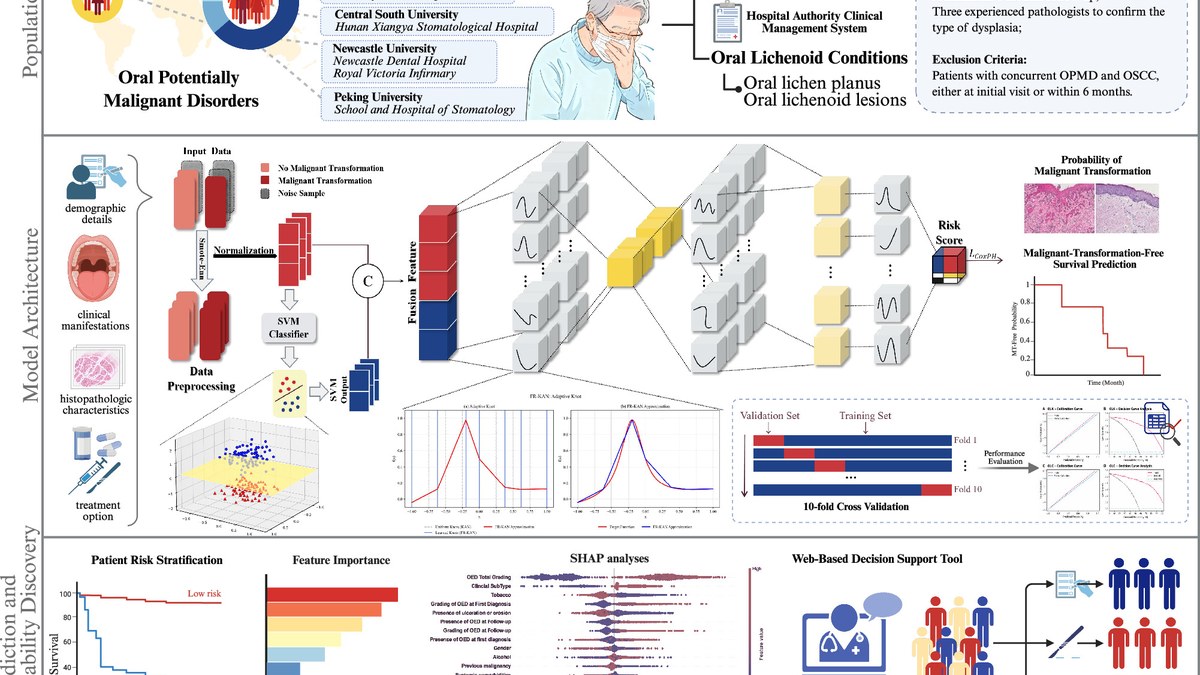
Communications Medicine于2026年10月8日在线发表OCRiskNet:面向口腔潜在恶性病变的时间分辨风险预测模型。研究为回顾性多中心设计,纳入经临床病理确诊的口腔白斑或口腔苔藓样病变患者;香港2003年至2024年队列用于模型开发与内部测试,英国与中国内地独立队列用于外部验证。模型整合人口学、暴露、临床、治疗与组织病理数据,采用固定深度生存流水线,结合概率特征富化与内在可解释的自由节点Kolmogorov-Arnold网络。内部区分度的一致性指数分别为0.9209(口腔白斑)与0.9207(口腔苔藓样病变)。
事实报道 × 药企研发负责人 | 趋势前瞻 × 投资人与产业分析师 | 深度研报
开场:癌变风险不是一次性的结论,而是随时间变化的曲线
Communications Medicine 在线刊出的一项研究,把口腔潜在恶性病变(OPMD)的癌变风险评估重新定义为一个随时间演进的问题。素材给出的判断依据是:这类患者在确诊之后需要反复接受风险评估,原因在于恶性转化的风险既在不同病灶之间存在差别,也会随时间推移而发生变化。
这一表述改变了风险评估的性质。它不再是一份在确诊时出具、此后长期有效的静态结论,而是一条需要按时间点读取的曲线。对临床侧而言,这意味着随访频率、复查时点与干预时机都要随曲线形态调整;对建模侧而言,这意味着输出不能是单一概率值,而必须带上时间维度。
现有工具的缺口被拆成三个词
素材对现有工具的评价是:很少能提供个体化、可解释、且带时间分辨率的估计,用以指导随访监测。三个限定词各有明确指向。
- 个体化:面向具体某一位患者给出估计,而非人群平均风险。
- 可解释:输出能够被临床医生读懂并追溯到具体因素,而非黑箱打分。
- 时间分辨:给出不同时间点的风险取值,而非一个不区分时刻的总概率。
OCRiskNet 的设计目标正是对这三个缺口同时作答。研究将其定位为在纵向管理中提供个体化的风险估计,而非替代活检或临床随访决策。
数据从哪来:香港21年队列开发,英国与中国内地独立验证
研究采用的是回顾性多中心设计,纳入的病例均经临床病理确诊,病种限定为口腔白斑或口腔苔藓样病变两类。
开发集与外部验证集的划分
队列的地理分布与用途划分如下:
- 香港队列,覆盖 2003 年至 2024 年,用于模型开发与内部测试。
- 英国队列与中国内地队列,作为独立数据用于外部验证。
这样的划分把时间跨度留在了开发侧,把空间跨度交给了验证侧。21 年的香港数据为模型提供了足够的随访长度,这一点与「时间分辨」的建模目标直接相关:若要估计风险随时间的形态,随访记录的时长本身就是硬约束。
外部验证覆盖的是地理差异
英国与中国内地的两组独立队列,验证的是模型在地理上不同的队列间的可迁移性。素材所述的结论是外部验证支持了模型在地理上不同队列间的泛化能力。需要注意边界:地理差异只是外部异质性的一个维度,素材未披露这两个外部队列的样本量、入组标准细节、病理判读一致性或随访完整度,因此不宜把「地理上不同」进一步扩展为「人种、医疗体系、诊疗路径全面不同」的泛化宣称。
模型怎么搭:概率特征富化遇上自由节点KAN
OCRiskNet 整合了五类输入数据:人口学、暴露、临床、治疗与组织病理。五类数据的并列,说明建模并未只依赖影像或只依赖病理,而是把从人群特征到组织学结论的整条信息链都纳入了输入。
一条固定深度的生存流水线
模型的骨架被描述为固定深度的生存分析流水线,并在此基础上组合了两个关键组件:概率特征富化,以及内在可解释的自由节点 Kolmogorov-Arnold 网络,即 KAN。
- 概率特征富化:在特征进入网络之前做一层概率化的增强处理。
- 自由节点 KAN:网络结构本身具备内在可解释性,节点位置不固定。
可解释性靠两条路径实现
研究对可解释性的处理不是事后补救,而是结构内置的。评估阶段采用了两种手段:符号函数提取与特征归因。前者指向从网络中还原出可被书写、可被检视的函数形式,后者指向给具体特征分配风险贡献。素材给出的结论是,解释性分析识别出了具有临床意义的风险贡献因素。
从研发视角看,这种设计选择的意义在于取舍:用结构上的约束换取可读的函数形态,而不是先追求拟合能力再另配一套解释模块。但素材未披露网络的节点规模、训练样本量、超参数配置与对照基线,因此无法对其相对增益做出量化判断。
0.9209与0.9207:一致性指数高不代表临床可用
内部区分度的结果有两个数字:口腔白斑的一致性指数为 0.9209,口腔苔藓样病变为 0.9207。两个数字几乎持平,说明模型在两类病变上的区分能力没有出现明显偏斜。
这个数字到底衡量什么
一致性指数衡量的是模型对风险排序与真实事件顺序之间的一致程度,也就是区分谁先发生、谁后发生的能力。它不衡量预测概率与实际发生率之间的吻合程度,因此不能解读为癌变预测的准确率。把 0.9209 说成「92% 的预测是对的」,属于对指标的误读。
内部与外部之间仍需分段解读
本次的一致性指数是内部区分度结果,产生于香港队列的开发与内部测试环节。外部验证部分,素材只给出了定性结论,即支持模型在地理上不同队列间的泛化能力,并未给出对应的外部一致性指数数值。因此,0.9209 与 0.9207 只能被读作内部测试环境下的读数,不能直接外推到英国或中国内地队列上的表现。
冷静观察:一致性指数之外,真正决定能不能用的是校准与决策曲线
素材列出的评估指标共有五项:一致性指数、AUC、Brier 分数、校准与决策曲线分析。前两项主要回答排得准不准,后三项才更贴近用不用得上。
三项更贴近落地的指标
- 校准:预测概率与实际发生率是否吻合,决定医生能否把输出的数值当作概率来读。
- Brier 分数:同时刻画区分度与校准的综合误差指标。
- 决策曲线分析:衡量在不同阈值下采取干预所带来的净获益,直接关联临床效用。
素材给出的结论是,OCRiskNet 表现出良好的校准与临床效用,并且能够在时间维度上清晰地区分风险组。风险组随时间的清晰分层,与开场所提的时间分辨目标形成了闭环:模型不只是给出了一个排序,还把患者按时间维度分成了可操作的层级。
从界面到产品之间还隔着什么
研究配套实现了基于 Web 的界面,用于支持个体化风险估计在纵向管理中的实际使用。这一动作把模型从论文推进到了可被操作的形态,但其性质仍是研究配套实现,素材没有涉及部署环境、访问权限、与院内系统的对接方式,也没有涉及作为临床决策支持软件所需的合规路径。
从产业视角看,这类工作的价值在于把问题形态界定清楚:口腔潜在恶性病变的随访管理需要时间分辨、个体化、可解释的风险估计,而现有的常规工具尚未覆盖。真正的门槛在后面——多中心前瞻性验证、跨人群的稳定性、以及输出责任归属的界定。就此而言,它可以被读作风向,尚不能被读作结论。
千方医数集编辑部 出品
