医生只拦住AI错误的一部分:41组队列的系统综述,真实世界心电场景26.6%错误被放过
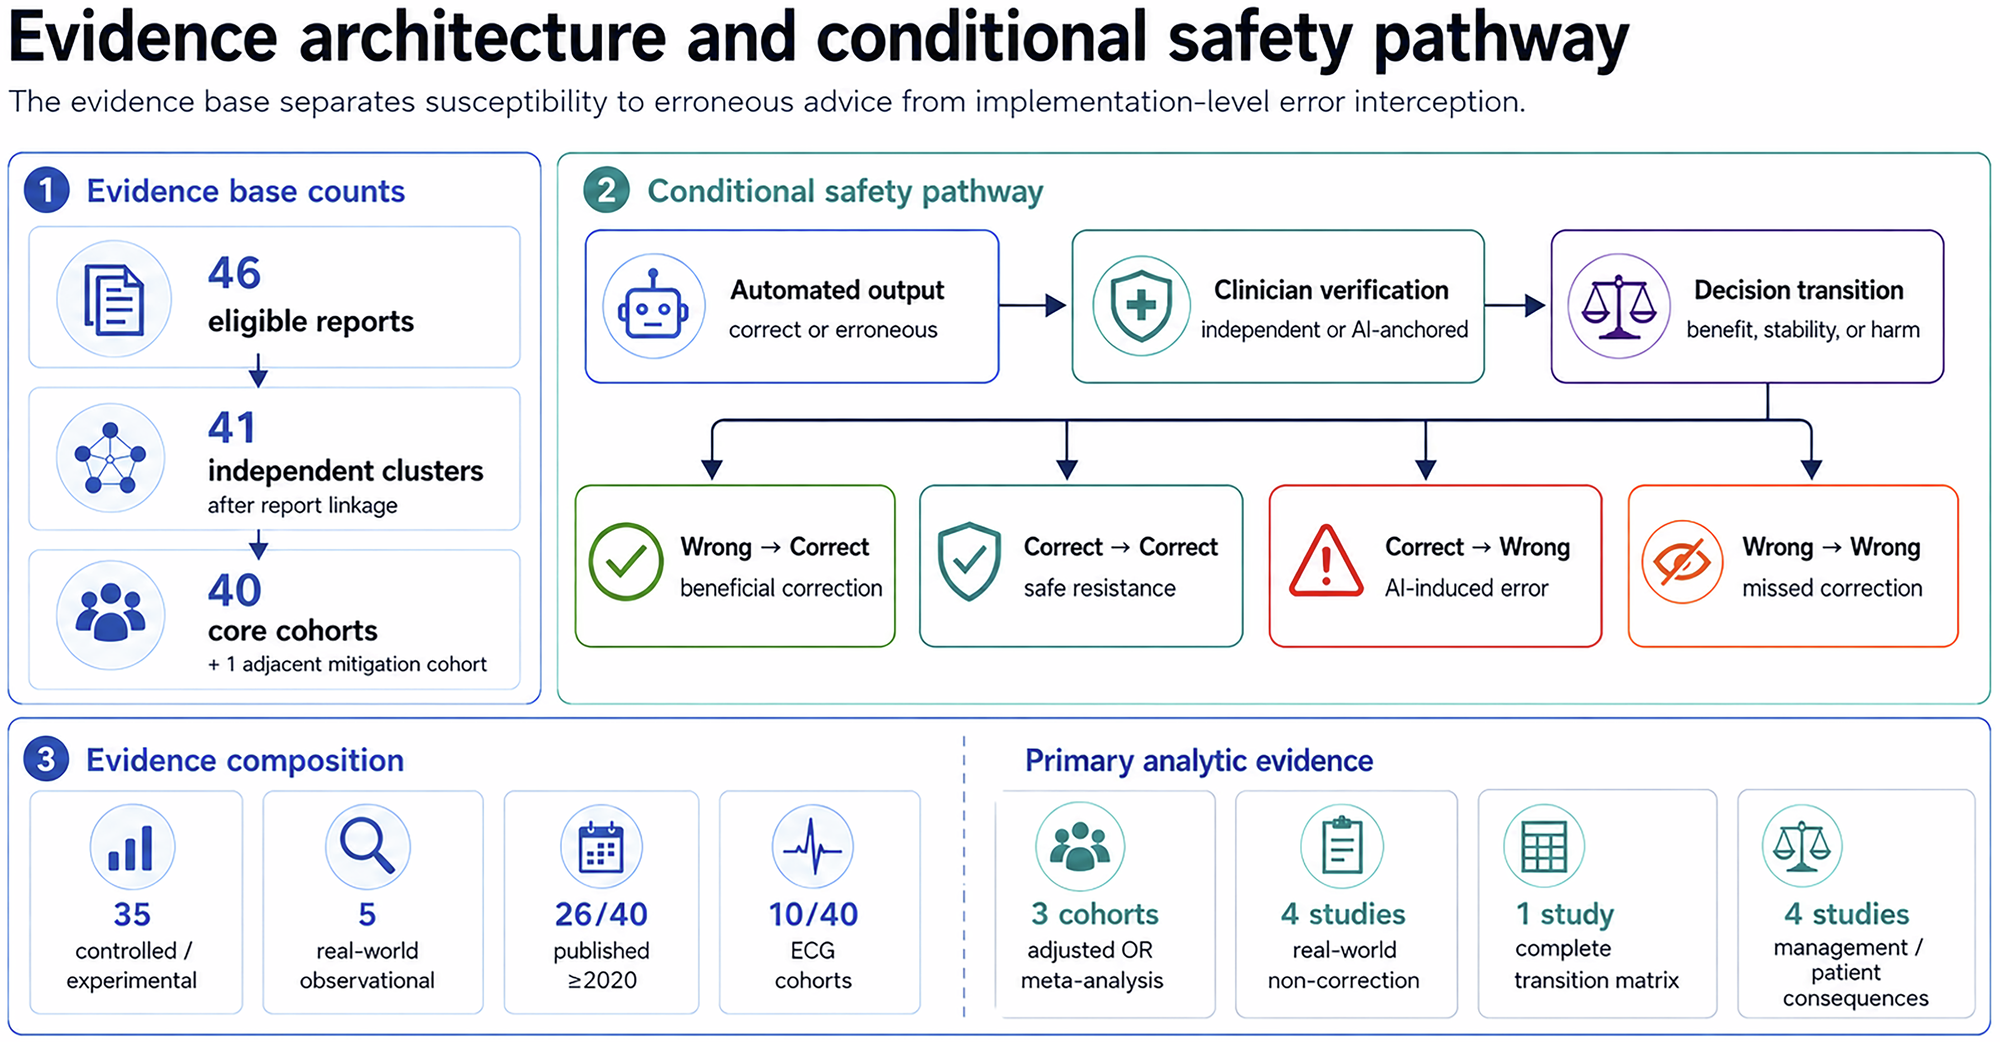
发表于npj Digital Medicine的系统综述与荟萃分析考察了临床医生面对错误AI建议时的纠错能力。46篇报告构成41个独立队列簇(40个核心队列)。在三个校正队列中,医生面对正确建议时的正确率显著高于面对错误建议时(合并OR=10.19,95%CI 7.43-13.98,I²=0%);四项真实世界计算机心电解读研究中,26.6%的错误解读未被纠正或识别(95%CI 6.4-65.6%,I²=95.8%)。当代AI与大语言模型研究同样记录到有害依赖,但异质性过高无法合并。作者结论:人类监督应被视为一种需要评估的「错误拦截能力」,而不是默认存在的安全保障。
影响分析 × 医院信息化/临床医生 | 趋势前瞻 × 医疗数据从业者 | 深度研报
当临床AI给出错误建议时,医生能拦住多少?10月23日发表于npj Digital Medicine的一篇系统综述与荟萃分析给出了一个不太乐观的答案。这项由四川大学华西医院甲状腺外科曾迪、雷建勇、李志辉完成的研究,汇总了46篇报告、41个独立队列簇,其中40个核心队列。结论很直接:人类监督只有在医生能识别并抵制错误输出时才具有保护作用,而它应当被当作一种需要评估的「错误拦截能力」,而不是默认存在的安全网。
开场:人类监督是AI安全的最后一道墙,但这道墙漏多少
过去几年,医疗AI的部署逻辑里有一个心照不宣的前提:算法会出错,但医生会把关。从影像辅助诊断到决策支持系统,「医生在环」被写进了无数产品说明和监管论证里,仿佛只要保留人类签字权,安全就有了兜底。
这篇系统综述做的事,就是把这个前提放到证据天平上称一称。研究团队系统检索了受控实验与真实世界两类研究中,临床医生面对错误的自动化建议时的实际反应——不是态度调查,而是行为记录:错误建议摆在那里,医生是纠正了,还是跟着错了。
对临床读者来说,这个问题并不抽象。每一次在心电图报告上签字、每一次采纳或忽略决策支持的提示,都是一次拦截能力的实测。而这篇综述要回答的正是:这类实测的合格率,到底是多少。
人类监督的保护作用是有条件的——它只在医生识别并抵制错误输出时成立。这个条件句,正是整篇综述的靶心。
OR=10.19:建议对错决定医生对错
先看受控研究的合并结果。在三个经过校正的队列中,医生面对正确自动化建议时的判断正确率,显著高于面对错误建议时,合并比值比OR=10.19,95%置信区间7.43-13.98,且异质性I²=0%。
OR=10.19意味着什么:医生的正确与否,与建议本身的对错高度绑定。建议对,医生对;建议错,医生大概率跟着错。所谓监督,在这个数据里更像是建议的放大器,而非纠偏器。I²=0%则说明三个队列的结果高度一致,这不是某个特殊场景下的偶然现象。
作者还做了一项限定在2020年及以后研究的敏感性分析,方向相同但精度不足:OR=9.22,95%置信区间2.06-41.13。置信区间跨度大,提示近年研究的估计仍不稳定,但至少没有证据表明,随着AI工具变得更先进,医生的拦截表现有实质性改观。
这个10.19值得每一位使用决策支持的医生停下来想一想:当你觉得「我只是参考一下系统建议」时,参考与服从之间的边界,可能比想象中模糊得多。
26.6%:真实世界心电场景里被放过的错误
受控研究之外,更有临床分量的是真实世界数据。综述纳入了四项真实世界计算机心电解读研究,合并结果显示:26.6%的错误AI解读未被医生纠正或识别,95%置信区间6.4-65.6%,异质性I²=95.8%。
这组数字需要拆着读:
- 点估计26.6%:大约每四个错误的计算机心电解读里,就有一个原样通过了医生这一关
- 置信区间6.4%到65.6%:不同场景、不同医生群体之间的拦截率差异巨大
- I²=95.8%:极高的异质性,意味着不存在一个可以套用的「平均拦截率」,场景决定一切
心电是医院里最成熟的自动化解读场景之一,计算机辅助心电诊断在临床运转了几十年。如果连这个最成熟场景里,医生平均都会放过四分之一的错误,那么对于更新、更不透明的AI工具——深度学习影像、风险预测模型、大语言模型生成的病历摘要——监督的实际成色只会更不确定。
为什么拦不住:自动化偏差的机制与LLM时代的新形态
医生不是不认真,而是人机协作里存在系统性的认知陷阱——自动化偏差。当机器持续给出大多数时候正确的输出,人类对输出的审查强度会自然衰减;而当任务节奏快、认知负荷高时,采纳建议又是最省力的路径。综述的数据恰恰印证了这一点:正确建议被高比例采纳,错误建议同样被高比例采纳,区分二者的能力在真实工作流中被稀释。
综述还考察了当代AI与大语言模型研究,结论是:这些研究同样记录到了有害依赖——医生被错误的LLM输出带偏的现象真实存在——但研究之间的异质性过高,无法做定量合并。换言之,LLM时代的依赖风险已被反复观察到,却还没有一个能摆上荟萃分析台面的效应量。
对医院信息化和数据从业者而言,这里有一个直接的工程含义:拦截能力不是医生个人的属性,而是系统设计的产物。建议的呈现方式、置信度的标定、工作流中的摩擦设计,都会影响那26.6%往上走还是往下走。监督质量可以被测量,也就应该被纳入AI系统的部署评估指标。
冷静观察:监督应被当作一种需要考核的拦截能力
必须先说清楚这篇综述的边界:
- 核心荟萃分析只基于三个校正队列,样本基础并不宽
- 真实世界心电研究仅四项,且I²高达95.8%,合并值的方向比数值本身更可靠
- LLM相关研究因异质性无法合并,定量结论仍是空白
- 患者层面的不良事件,仅有一个回顾性队列报告——拦截失败与临床伤害之间的链条,证据还断着
也就是说,这项研究画出了问题的轮廓,但没有给出完整的剂量-反应关系。它证明的是「监督会漏」,而不是「漏了必然伤人」——后者目前只有回顾性证据支撑。
即便如此,作者的核心主张值得整个产业认真对待:把人类监督重新定义为一种需要评估、需要考核的错误拦截能力。这句话如果被采纳,会改变很多事情——AI产品的临床验证不该只测算法本身的准确率,还要测人机组合体的拦截率;监管审评里「医生在环」不该是免责条款,而应是待验证的假设;医院上线AI后,定期抽测医生对错误输出的识别率,应当像质控一样成为常规动作。
对临床医生个人,最务实的 takeaway 只有一条:下一次在AI建议上签字之前,默认它可能是错的。那道最后一道墙,就是你自己,而它需要刻意维护。
原文链接:npj Digital Medicine
千方医数集编辑部 出品
