住院7至21天的长病历,LLM写的出院小结在95%病例中被医生判为优于人写版本
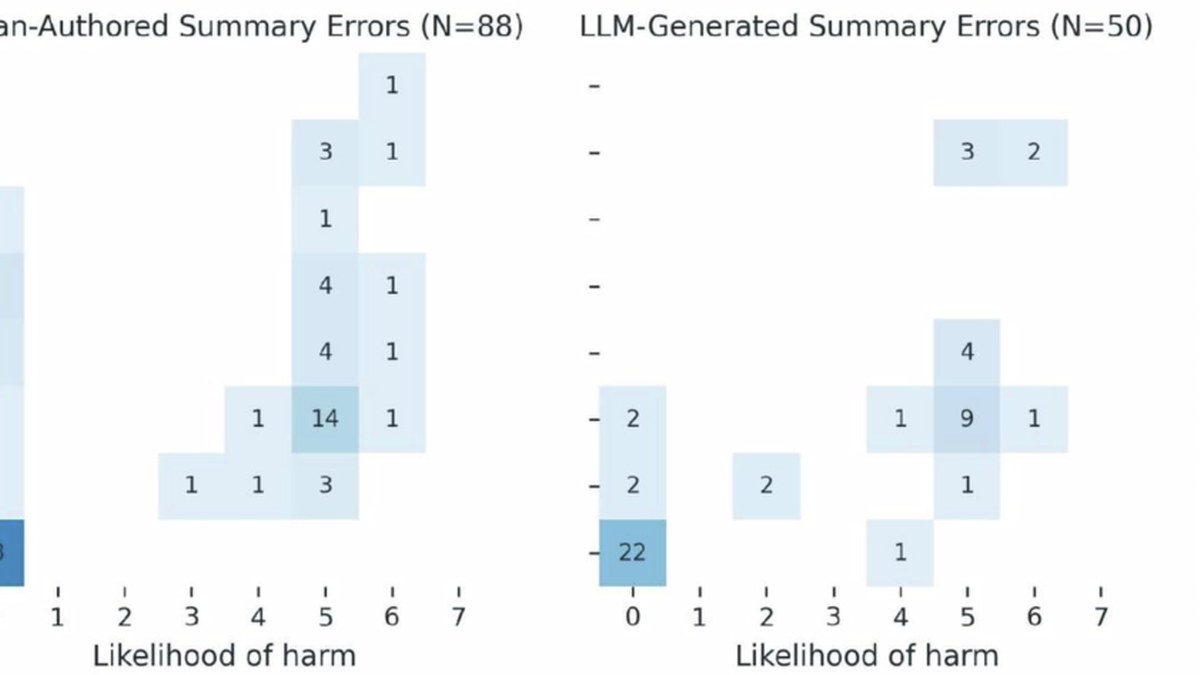
10月2日,《npj Digital Medicine》在线发表一项以临床医生为中心的出院小结评测研究。研究纳入60例内科住院病例且住院时长为7至21天——既往同类研究几乎只覆盖短住院。住院医师与全科医生配对盲评结果显示,95%的会诊医生更偏好大语言模型生成的版本,其在质量、可读性、事实性与完整性上均优于人写版本,优势主要来自临床相关遗漏更少。研究同时报告,两组在预估伤害潜能与发生概率上无显著差异;模型识别出的31项影像偶发发现中,93.5%被判定为事实正确。
影响分析 × 医院信息化/临床医生 | 数据视角 × 投资人与产业分析师 | 深度研报
10月2日,《npj Digital Medicine》在线发表了一项以临床医生为中心的出院小结评测研究。它不再拿三五天的短住院做实验,而是把住院时长拉到7至21天,这是既往同类研究几乎未曾覆盖的区间。在这个信息密度高得多的场景里,大语言模型生成的版本拿到了会诊医生95%的偏好票。数字亮眼,但真正有意思的是这个数字是怎么来的,以及它没有覆盖到什么。
开场:短住院的出院小结好写,长住院的才见真章
出院小结大概是医疗文书里最容易被当作体力活的一种:入院原因、主要诊疗经过、用药调整、出院带药与随访安排,格式固定、套路清楚。住院三五天的病例,信息来源通常只有一次急诊记录、几组化验和一次影像,把要点抄全就接近满分,对人如此,对模型也如此。既往评测之所以普遍得出乐观结论,很大程度上是因为题目本身太容易。
真正的难点是长住院。住院医师轮转换手、会诊意见层层叠加、用药反复调整、前后检查结果互相打架,一份十几天的病历要压成两三千字且不丢关键项,靠的是记忆力与细心,而这两样恰恰是人在夜班之后最容易失守的东西。既往研究很少碰长住院,不是不想,而是长住院缺少可靠的参考答案,人工评测的成本极高。把场景推进到7至21天,等于把模型从好写的题直接拉到难写的题上。
这也解释了为什么这项研究值得在这个时点单独看一眼。临床文档类AI已经过了演示阶段,医院真正关心的问题早就不是能不能生成一段通顺的文字,而是能不能在信息最混乱的那批病人身上不掉链子。前者决定采购意愿,后者决定能不能进工作流。
这次怎么比:60例、7到21天、住院医师配全科医生盲评
研究纳入60例内科住院病例,住院时长限定在7至21天,采用回顾性设计。生成端是LLM版本与原始人写版本的直接对照;评价端不是自动打分模型,而是真人:同一份病例的两版小结,由住院医师与全科医生配对、在盲态下分别评阅。
配对结构本身就是设计上的增量。以往多数研究只找一组医生评整体质量,这一次把院内视角与接收方视角拆开:住院医师关心诊疗经过记得准不准,全科医生关心拿到这份小结后能不能向患者解释清楚、能不能照着安排随访,两者的判定标准并不一致。研究正是靠这个拆分,把「写得更好」拆成了若干可分辨的维度,而不是停留在笼统的好评率。对医院信息化来说,这种评测结构本身就有移植价值——它把主观印象变成了可对照的成对判断,也顺带暴露出一个常被忽略的事实:一份出院小结的质量,从来不由写它的人定义,而由读它的人定义,而读它的人往往不止一个。
95%偏好率的来源:赢在少漏,不是赢在文笔
结果是会诊医生在95%的病例中更偏好LLM版本,并在质量、可读性、事实性、完整性四个维度上给出更高评分。更值得细看的是偏好率的成因:评阅者在LLM版本上标注的事实错误与临床相关遗漏都更少,而差距主要来自少遗漏,不是来自文笔。
这个区分很关键。如果LLM只是写得顺、排版整齐,那它替代的是打字员;只有当它减少的是临床相关遗漏时,它替代的才是一部分病历质控,两者的成本结构与风险敞口完全不同。研究还给出两项附加结果。其一是接收方视角的补强:全科医生认为LLM版本更有助于向患者解释住院经过与安排随访;模型主动识别出的31项影像偶发发现中,93.5%被判定为事实正确,87.1%被认为适合写入报告,适合报告的比例低于事实正确的比例,说明评阅者对「该不该写进去」的尺度比模型更紧。后一项尤其敏感——偶发发现的追踪随访是出院后最容易断链的一环,一个模型能自己把这些发现挑出来,价值已经超出文书本身。
安全边界:伤害潜能没有显著差异,但样本只有60例
研究同时报告了一条负结果:在预估伤害潜能与发生概率上,LLM版本与人写版本之间没有显著差异。这句话要两面读。正面看,LLM版本没有引入可测量的额外安全风险,这是对「用模型写病历等于冒险」这一直觉的直接反驳;反面看,漏得更少并没有转化成伤害更小,至少在这60例里没有测出来,说明遗漏与结局之间并不存在简单的线性关系。
样本量只有60例,是这项研究最硬的天花板:它足以支撑方向性判断,不足以支撑发生率级别的判断,更不足以分层到科室、病种或模型版本。此外,95%是一个条件性很强的数字——它绑定在这一批内科病例、这一个模型版本、这一组评阅者身上,换个科室或换代模型,偏好率未必还站得住。把它当成一条普适结论去引用,是对这项研究最常见的误读。另一处值得注意的分歧是,全科医生标注的遗漏数量多于住院医师,给出的伤害可能性评分也更高。同一份文书,院内医生觉得够用、接收方觉得不够,这本身就是出院小结长期失真的结构性证据,也说明「好不好」从来不取决于作者,而取决于读者。
冷静观察:从「写得更好」到「可以签发出院」,中间还隔着责任与流程
把结论放回真实科室,95%说明的其实是一件事:医生愿意读LLM写的版本,还不等于愿意为它署名。这两者之间隔着一整套责任结构与流程改造——谁对小结内容负法律责任、签名环节要不要保留人工确认、模型漏掉的东西由谁兜底、出现争议时以哪一版作为病历原件。这些问题没有一项能被一篇60例的回顾性评测回答。
回顾性设计还有一个天然局限:评阅医生看到的是已经完整发生的住院过程,而真实场景里小结要在出院当下生成,模型只能在信息尚未闭环时工作,那时的遗漏率还会不会这么低,本研究没有涉及。对医院信息化而言,更现实的落点或许不是自动生成出院小结,而是把这套配对盲评做成上线前的评测模板:由住院医师与全科医生同时盲评,用遗漏数与事实错误数、而不是文采分做准入门槛。这套模板的价值可能比95%这个数字本身更持久——它把一个主观好评率,换成了一个可复用的验收标准,而这正是临床文档类AI从演示走向部署时最缺的东西。从投资视角看,这也划出了一条更清晰的估值边界:能被评测、能被验收、能进工作流的文档生成能力,与一段通用大模型API调用之间,差的不只是准确率,而是一整套可被医院采购流程接受的证据链。
原文链接:npj Digital Medicine(DOI: 10.1038/s41746-026-03320-y)
千方医数集编辑部 出品
