中国医药大学附设医院57项AI落地:护理交班摘要单月143244笔,智能客服回复率83.9%升至100%
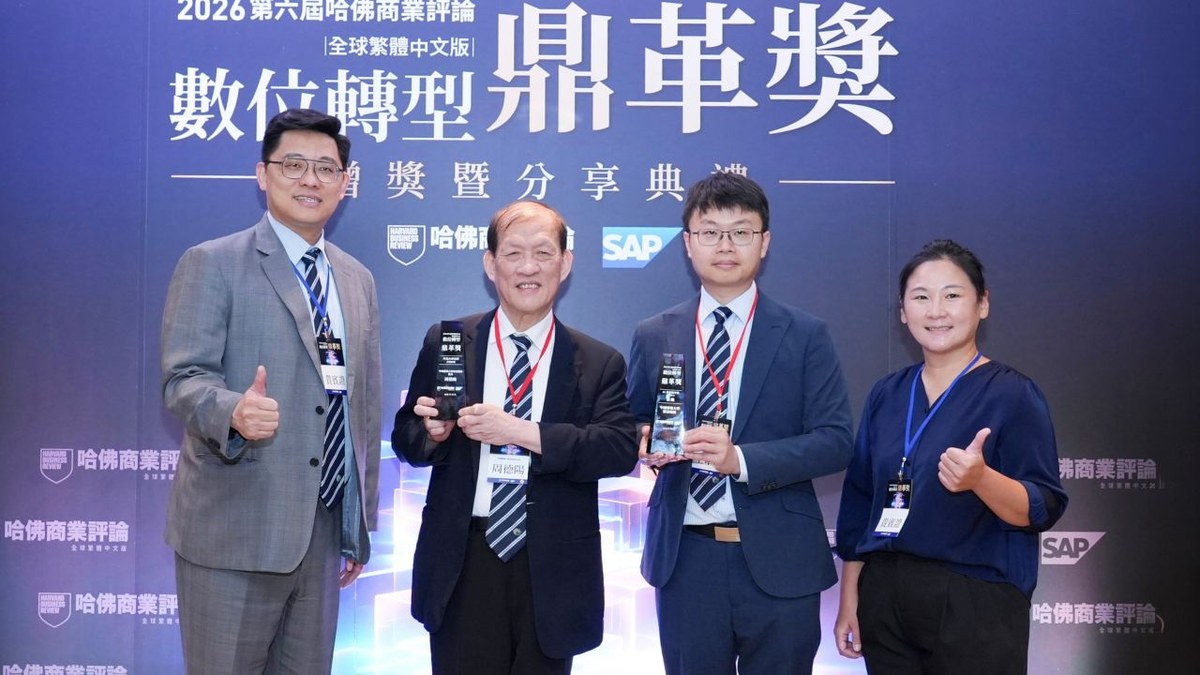
2026年10月1日,中国医药大学附设医院宣布获第六届数位转型鼎革奖年度AI领袖奖与AI创新应用奖医学中心首奖。其获奖平台整合大语言模型、语音辨识与检索增强生成技术。MIRA住院病历语音写作月均使用3940次、医师满意度达90%,智汇护理交班摘要单月使用达143244笔,智能客服导入生成式AI后民众咨询回复率由83.9%提升至100%、超过14日才回复的案件减少60%。
57个项目里,真正被天天用的是交班摘要
影响分析 × 药企研发负责人 | 事实报道 × 投资人与产业分析师 | 产品发布
2026年10月1日,中国医药大学附设医院宣布获第六届数位转型鼎革奖年度AI领袖奖,同时获AI创新应用奖医学中心首奖。获奖平台为基于多代理协作之全方位医疗智慧赋能平台,整合大语言模型、语音辨识与检索增强生成技术。
院方称已推动57项AI落地专案,累计取得7件TFDA医疗器材许可及15件AI相关专利。以下数据均为院方自述,无第三方核验,引用时须保留这一前提。
开场:57个项目,两个奖,先看用得最多的那个
两个奖项是这条消息的由头,但信息量有限。年度AI领袖奖与AI创新应用奖医学中心首奖,主办单位与评审方法均未写明,因此无法判断评选标准落在技术创新、部署规模还是管理成效上,也不能把获奖等同于临床价值的证明。
真正可量化的是使用量。57项AI落地专案是一个项目计数,它能说明推进的广度,但不能说明深度。项目数量与实际使用强度之间没有必然关系,要看深度,得看调用频次。
三个有数字的场景正好构成一组对照,量级差了两个数量级,说明57个项目内部的使用分布并不均衡。
| 场景 | 口径 | 数值 |
|---|---|---|
| 智汇护理交班摘要 | 单月使用笔数 | 143244 |
| MIRA住院病历语音写作 | 月均使用次数 | 3940,医师满意度90% |
| 智能客服 | 民众咨询回复率 | 83.9%提升至100% |
表格里三行的分母互不相同,横向比较只能看量级,不能看效率。真正能跨场景比较的指标,报告里一个都没有给出。
143244笔交班摘要:高频场景才是真需求
143244笔是单月使用量,落在护理交班这一个环节上。交班摘要的特点是每天发生、每次都要做、内容高度结构化——病史要点、生命体征变化、待办事项。它符合AI介入的三个条件:高频、耗时、格式固定。
从研发视角看,这个场景的技术难度并不高,难的是与护理流程的贴合。交班摘要要能被护士直接采用,意味着输出必须准确、可追溯、且格式与既有文书一致。检索增强生成在这里的作用是从院内系统中取数,减少模型自行编造的可能。
对投资人而言,这个数字的价值在于它验证了需求刚性。高频使用不是靠推广推出来的,是靠场景本身的使用频率。但也要看到,143244笔是使用笔数,不等于节省了多少护理工时——院方未披露节省的工时,因此无法换算成人力成本或效率收益。
90%满意度的语音写作:医生为什么会用
MIRA住院病历语音写作每月平均使用3940次,医师满意度达90%。这个量级与交班摘要差了约36倍,但性质不同:它面向的是医生个体的写作环节,而不是护理班次的集体流程。
医生为什么会用,答案在任务结构里。住院病历书写是重复劳动,语音输入加自动生成能省下的主要是打字时间。语音辨识负责转写,大语言模型负责整理成文书,检索增强生成负责从既有记录中补齐全信息,三者分工清楚。
90%满意度是主观评分,不是客观指标。它没有说明评分样本量、评分时点与评分维度,也没有对照组。对研发负责人来说,这类数字适合作为产品迭代的方向信号,不适合作为效果证据。更值得追问的是另外一面:不使用语音写作的医生卡在哪里,是口音识别、文书格式,还是与既有工作流的冲突。3940次是月均使用次数,若按全院医师人数摊开,人均强度其实不高,说明覆盖还没有做满。
还有一个边界需要说清。住院病历属于医疗文书,语音转写与自动生成之后的核对责任仍在医师一侧。系统把初稿写出来了,医生仍要逐份确认,节省的是录入时间而非审阅时间。这一点决定了效率收益的天花板。
83.9%到100%:客服这条线改的是响应速度
智能客服导入生成式AI后,民众咨询回复率由83.9%提升至100%,超过14日才回复的案件减少60%。这两个指标讲的都是响应,不是答复质量。
回复率到100%意味着所有咨询都得到了回应。这是一个操作指标,实现难度主要在流程与人力配置,不完全取决于模型能力。超过14日才回复的案件减少60%,指向的是积压清理,说明此前存在大量长期未处理的咨询。
从产业分析的角度,这条线的商业含义与其他两条不同。客服是院外场景,直接面向民众,部署阻力小、见效快,但可复制性也高,不构成技术壁垒;交班摘要与语音写作嵌在院内工作流里,替换成本高,一旦跑通更难被替换。
三项技术基础相同,都是大语言模型加语音辨识加检索增强生成,差别在嵌入深度。院方称平台基于多代理协作,但各代理之间的任务分配与结果如何仲裁,公开信息中未见。
冷静观察:院方自述的数字之外,还缺一块分母
先说口径。143244笔是护理交班摘要单月使用量,3940次是MIRA月均使用次数,两者口径不同,不能相加也不能直接比较强度。83.9%到100%是回复率,60%是超期案件降幅,二者也不是同一分母。
缺的分母很关键。医院床位规模、年门诊与住院服务量、护理班次总数、医师人数,这些都没有披露。没有分母,143244笔无法折算成每位护士每天的使用次数,3940次也无法折算成每位医师的月均使用次数,规模大小无从判断。
还有几项现在不能确定。奖项的主办单位与评审方法未写明,奖项含金量无法评估;节省的医师与护理工时未披露,效率收益无法测算;数据为院方自述、无第三方核验,测量方法未说明;报告中没有临床结局指标,误诊率、不良事件等一概未涉及,不能从使用量引申出临床质量的改善。
7件TFDA医疗器材许可与15件AI相关专利是另一类信息。许可说明有产品走了医疗器材路径,但许可对应的具体产品、适应症与风险等级未列出;专利数量说明研发投入,与产品是否好用没有对应关系。
对打算跟进的机构,可复制的是场景选择方法:先找高频、结构化、耗时明确且不需要新硬件的环节。不可复制的是57项这个数量本身——它反映的是投入规模,不是方法论。
原文链接:環球生技月刊(GBI Monthly)
千方医数集编辑部 出品
