开发自然语言处理(NLP)模型以从电子健康记录中自动提取临床数据:来自意大利综合卒中中心的结果
意大利综合卒中中心研究的原始数据集,包含患者基线特征和关注结局,用于NLP模型从电子健康记录中自动提取临床数据。
基本信息
资源简介
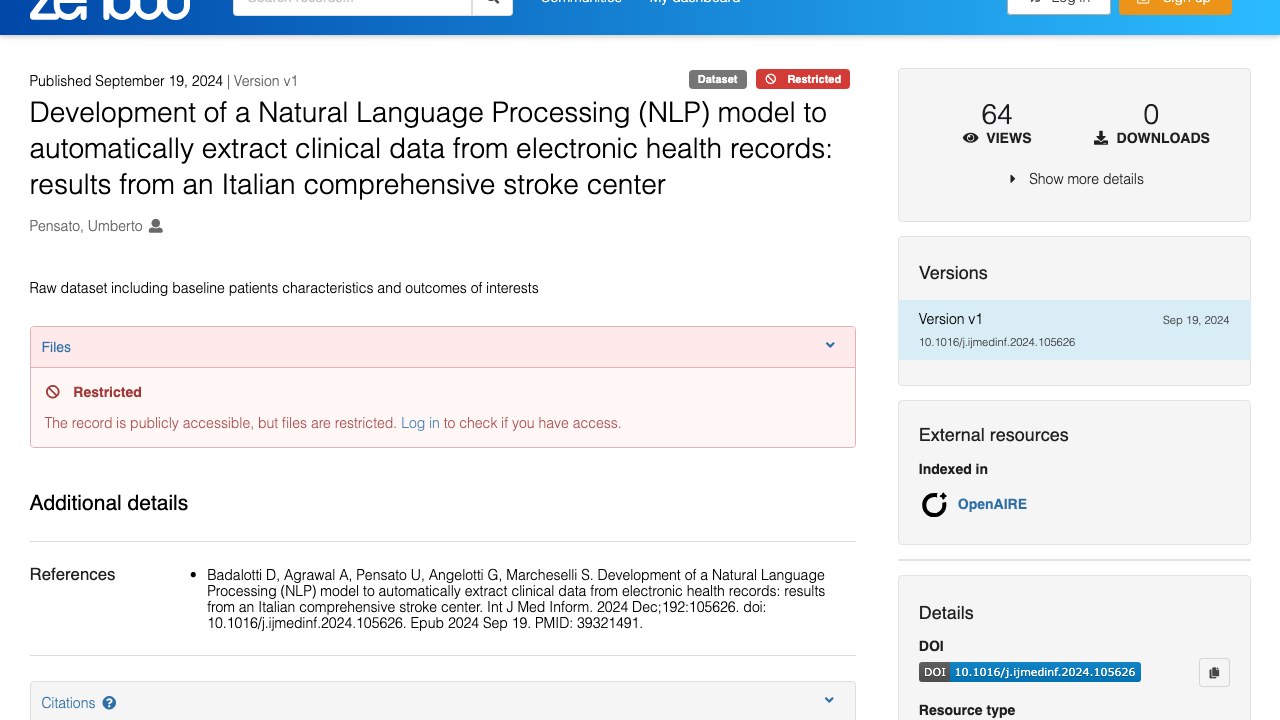
开发自然语言处理(NLP)模型以从电子健康记录中自动提取临床数据:来自意大利综合卒中中心的结果
【数据集背景】
本数据集源站标题为《Development of a Natural Language Processing (NLP) model to automatically extract clinical data from electronic health records: results from an Italian comprehensive stroke center》。源站首次发布:2024-09-19。
【数据内容】
源站原始描述:Raw dataset including baseline patients characteristics and outcomes of interests
中文译文(机器翻译,仅供快速理解,请以原文为准):原始数据集,包括基线患者特征和感兴趣的结果
【数据结构与技术规格】
数据集 DOI:10.1016/j.ijmedinf.2024.105626。
【适用方向】
结构化表格数据可直接用于统计建模、特征工程与队列分析。
【获取与许可】
源站页面:https://zenodo.org/records/14938817
使用许可:cc-by-4.0。
【使用注意】
· 源站最后修改于 2025-02-27,引用时请注意版本时效。
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。