IMPACT:通过远程医疗改善产后护理可及性
该数据集来自clinicaltrials.gov,主题为产后并发症,属于一项大型多中心随机对照试验。研究采用混合1型设计分两阶段开展:第一阶段收集基线数据并纳入患者意见,第二阶段对产妇进行随机分组,比较两种多组分产后护理模式——基于电子健康记录门户推送通知的强化面对面教育加虚拟教育,以及采用系列会诊
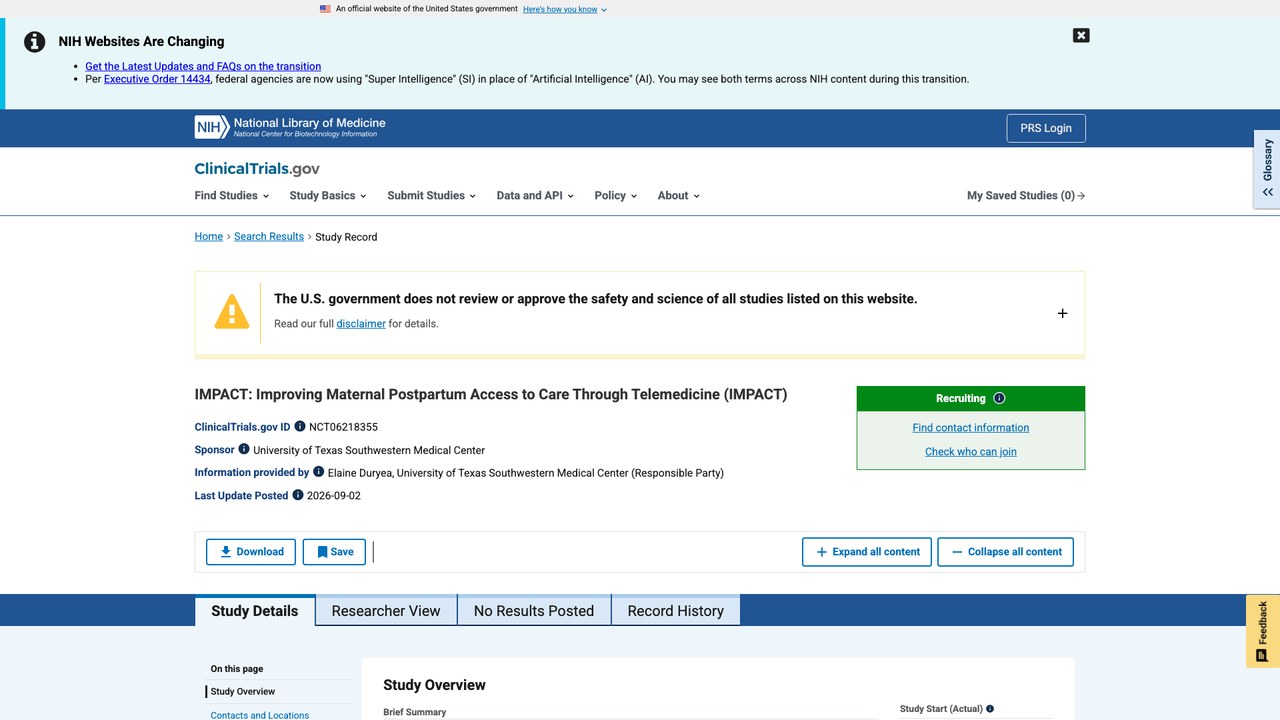
基本信息
资源简介
IMPACT:通过远程医疗改善产后护理可及性
该数据集来自clinicaltrials.gov,主题为产后并发症,属于一项大型多中心随机对照试验。研究采用混合1型设计分两阶段开展:第一阶段收集基线数据并纳入患者意见,第二阶段对产妇进行随机分组,比较两种多组分产后护理模式——基于电子健康记录门户推送通知的强化面对面教育加虚拟教育,以及采用系列会诊的远程医疗模式,两者均包含家庭访视项目。研究人群来自两家城市内城卫生系统。数据可用于产后护理模式比较与效果评估(来源 clinicaltrials.gov)。
【数据内容】
源站描述(机器翻译,仅供参考):条件:产后并发症。这项大型、多中心随机对照试验将通过混合1型设计分两个阶段进行,比较两种多组分产后护理模式。初始阶段(第一阶段)将收集基线数据并确保患者意见纳入最终研究。在第二阶段,女性将被随机分组。对照为循证方法:(1)强化面对面教育,并通过使用电子健康记录网络门户的推送通知进行虚拟教育;(2)采用系列会诊的远程医疗模式。使用通知的“推送”方法与使用远程医疗就诊的“拉取”方法形成直接对比。两种模式均包括家庭访视项目。研究人群包括在两家城市内城卫生系统分娩的患者:Parkland(德克萨斯州达拉斯),由Duryea和Nelson博士指导(UT Southwestern PI),以及Grady Memori
【主题与分类】
主题标签:Postpartum Complication。本站分类:消化系统疾病。
【获取与许可】
源站页面:https://clinicaltrials.gov/study/NCT06218355
下载信息
注册下载
需要注册 Kaggle 账号并登录后下载,适合需要跟踪下载记录和使用 API 的用户。
暂未开放公开下载
无需注册即可直接获取公开样本或文档,适合快速预览和评估数据集质量。
免登录当前数据集主要来源为 Kaggle 公开托管,完整影像包建议通过原始链接或 Kaggle API 获取。
使用方式
数据集获取
源站:https://clinicaltrials.gov/study/NCT06218355
标准获取流程:
- 访问源站链接,注册/登录账号;
- 进入数据集详情页,按页面指引申请权限或直接下载;
- 部分平台提供 SDK,例如:
- OpenDataLab:
pip install openxlab后openxlab.dataset.get(...) - ModelScope:
pip install modelscope后modelscope download - 天池: 登录后页面提供直链下载
以源站「数据下载/使用文档」页面为准。
- OpenDataLab:
数据说明
条件:产后并发症。这项大型、多中心随机对照试验将通过混合1型设计,分两个阶段比较两种多组分产后护理模式。初始阶段(第1阶段)将收集基线数据,并确保患者意见纳入最终研究。在第2阶段,女性将被随机分组。对照方案为循证方法:(1)强化面对面教育,并通过电子健康记录网络门户以推送通知形式提供虚拟教育;(2)采用系列会面的远程医疗模式。使用通知的“推送”方式与使用远程医疗就诊的“拉取”方式形成直接对比。两种模式均包括家访计划。研究人群包括在两个城市内城卫生系统中分娩的患者:Parkland(德克萨斯州达拉斯),由Duryea和Nelson博士指导(UT Southwestern PI);以及Grady Memorial(佐治亚州亚特兰大),由Newton-Levinson博士指导(Emory PI)。主要结局是从出院到首次6周内复合并发症诊断和治疗的时间。
基于试点数据,2349名女性将展示出40%的减少(从9天降至5.4天),具有80%的效能和双侧α值0.05。将招募3500名女性(第一阶段1000名;第二阶段2500名),预计6周时流失率低于5%。纳入标准为分娩活产婴儿的女性。次要结局包括精神健康障碍、急诊就诊、住院、患者知识、生活质量和满意度、医疗服务提供者满意度以及健康的社会决定因素。女性将在产后一年内接受随访。
数据加载示例(图像类)
from PIL import Image
import glob, os

files = (glob.glob(os.path.join(path, "**", "*.png"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.jpg"), recursive=True)
       + glob.glob(os.path.join(path, "**", "*.tif"), recursive=True))
print("图像文件数:", len(files))
img = Image.open(files[0]); print("尺寸/模式:", img.size, img.mode)

# torchvision Dataset 方式:
# from torchvision import datasets
# ds = datasets.ImageFolder(path)  # 要求 子目录=类别
目录组织与标注格式以源站说明和下载后实际文件为准。
需要用于商业化训练或医疗器械注册(NMPA/FDA)?
公开数据往往缺乏完整的病理回证与专家标注。千方医数集依托陕川双基地与超十家三甲医院直连,提供完全合规、去标识化、支持注册级质控的专病数据集交易服务。