信息速览
一张胸片摆在生成式多模态模型面前,问它「有没有气胸」,它回答「没有」。这个回答可能来自真正看懂了影像,也可能跟影像毫无关系——只要模型学会了「气胸在多数胸片里都不存在,回答『没有』的期望收益最高」,它就能在不看一眼像素的情况下拿到一个不难看的准确率。闭合式问题尤其容易被这种策略吃穿:二分类的先验只要偏一点,盲猜就能过半。所以问题的关键不是模型答对了几道,而是先有一批由真正读片的人写下的标准答案,再拿模型的输出逐条去比对,让「不看也能蒙对」这条路走不通。
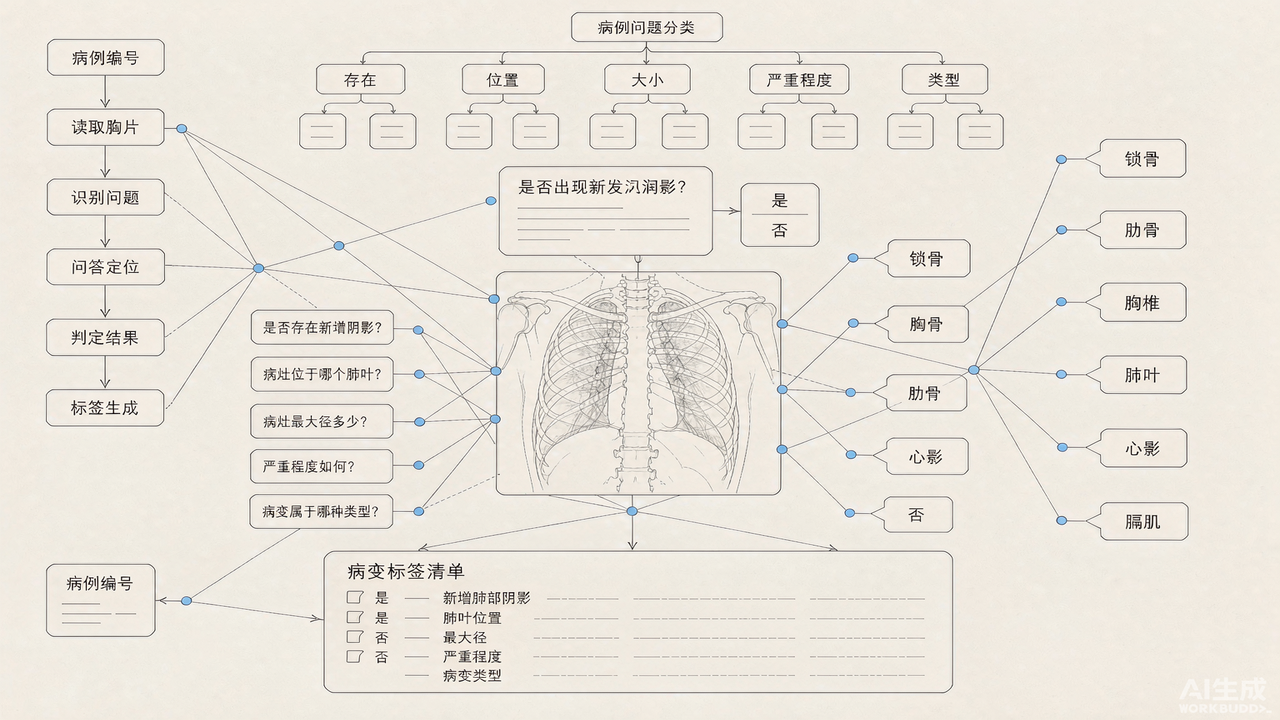
这正是 MIMIC CXR 视觉问答评测集(Visual Question Answering evaluation dataset for MIMIC CXR)要补的缺口。它由 Google 与 MIT 的研究者在 2025 年 1 月 28 日放到 PhysioNet 上,从 MIMIC-CXR 官方测试集与验证集里挑出 71 例胸片,配了 337 组问题与答案,其中参考答案由一位具有十七年 post-residency 经验的持证放射科医师依据影像本身与原始放射科报告撰写。它的体量小得不像一个「数据集」——交付物只有一个 TSV 文件,连图像都不在里面;但它的每一条答案都带着专业读片的成本,这是自动流水线难以复制的部分。它的代价同样明确:规模不足以训练,口径受上游标签约束,图像本体必须回源到另一个库才能用。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 全名 | Visual Question Answering evaluation dataset for MIMIC CXR |
| 发布方 | PhysioNet;贡献者为 Google 团队与 MIT 计算生理实验室成员 |
| 托管与维护 | MIT Laboratory for Computational Physiology(PhysioNet) |
| 首次发布 | 2025 年 1 月 28 日,版本 1.0.0,此后未见其他版本 |
| DOI | 10.13026/cvsk-ny21(版本 1.0.0);最新版本 DOI 10.13026/tz5h-1w39 |
| 病例数 | 71 例(48 例来自官方测试集,23 例来自验证集) |
| 问答组数 | 337 组(测试集 226 组、验证集 111 组,按官方 Methods 段口径) |
| 图像与研究的对应 | 每个病例对应唯一 study_id 与唯一 dicom_id,一例一图 |
| 问题类型 | 存在性、位置、大小、严重程度、类型五类,另有一类与病变无关的通问 |
| 闭合式占比 | 官方称多数(68%)为闭合式,即可用「是」或「否」回答 |
| 参考答案来源 | 持证放射科医师,17 年 post-residency 经验,依据影像与原始报告撰写 |
| 交付文件 | mimic_cxr_vqa.tsv,单一文件 |
| 文件格式与列数 | 制表符分隔文本,六列:study_id、dicom_id、split_vqa、question_id、question、expected_answer |
| 图像本体 | 不随本数据集分发,需凭 study_id 与 dicom_id 回源 MIMIC-CXR 或 MIMIC-CXR-JPG |
| 访问方式 | 受限访问:注册用户签署指定数据使用协议后方可下载 |
| 许可 | PhysioNet Restricted Health Data License 1.5.0;配套 PhysioNet Restricted Health Data Use Agreement 1.5.0 |
| 典型用途 | 多模态医学模型的视觉问答能力评测、闭合式判读的准确率对照、模型输出与专家表述的逐条人工复核 |
§1 它要解决的具体麻烦
1.1 准确率这个指标在医学问答上会骗人
视觉问答任务在通用图像领域已经跑了近十年,但它带过来的一套评价指标,放到医学影像上会出现系统性的失真。最典型的是闭合式问题的先验偏置:在胸部 X 线上,「肺不张是否存在」「气胸是否存在」这类问题的阳性比例天然偏低,一个恒定输出「否」的模型可以拿到相当高的准确率,而它对临床毫无用处。这个问题在通用 VQA 里也存在,但在医学场景里更严重,因为阴性与阳性在临床上的代价完全不对称——漏掉一个气胸和误报一个气胸不是同一种错误。
第二个失真是表述自由度。开放性问题比如「积液在什么位置」,标准答案写「右侧肋膈角」,模型写「右侧胸腔下部」,语义相同而字符串不同。用精确匹配打分,模型被判错;用人工评判打分,成本又高到无法批量。这就是为什么一批参考答案必须由人来写:不是为了让答案更"准",而是为了让"什么算对"这件事有一个可参照的锚。
第三个失真是图像与文本的耦合。多模态模型有可能从问题本身的措辞里推断出答案倾向,而不去看图。要检测这件事,需要一组「换一张图、同一个问题」的对照,而这要求评测集里图像与问题的配对关系是显式给出的——这正是本数据集用 study_id 与 dicom_id 两列明确锁定的东西。
把这三种失真叠起来看,会得到一个不太舒服的结论:一个在自动指标上表现良好的模型,可能既没有看懂影像,也没有给出可用的表述,只是恰好押对了先验。要拆穿它,评测集必须同时满足三个条件——答案由读过片的人写、问题既有闭合也有开放、图像与问题的配对可追溯。本数据集的设计正是照着这三条来的。
1.2 为什么这个评测集必须小而贵
参考答案由持证医师逐条撰写,这个约束直接决定了规模上限。三百余组问答,意味着一位医师要在影像与报告之间来回切换三百余次,还要为开放性问题组织表述。这类工作的边际成本不会随工具进步而线性下降:自动标注可以并行,专家判断不行。因此它不是"还没做大的数据集",而是"规模与质量已被固定在这个点上"的数据集。
理解这一点很重要,因为它决定了用法。想用它训练模型的人会立刻发现样本不够;想用它给模型打分的,会发现三百余条正好够做一次可信的对照,也正好少到可以让人工复核每一条模型输出。这是设计取向,不是缺陷。
1.3 三条常见的错误期待
第一条,以为它自带图像。交付物是单一 TSV,里面只有标识与文本。图像要去 MIMIC-CXR(DICOM)或 MIMIC-CXR-JPG(JPG)取,而那两个库本身也是受限访问,需要各自完成申请。把本数据集当成"开箱即用的多模态训练包",第一步就会卡住。
第二条,以为它的问题是从放射科报告里自动生成的。官方写得很清楚:问题的选配用的是一套基于 MIMIC-CXR-JPG 标签的启发式规则,参考答案才是人工写的。换句话说,"问什么"是规则驱动的,"答什么"是专家驱动的。这两层质量来源不同,不能混为一谈。
第三条,以为 337 这个数字可以直接和别的 VQA 数据集比大小。别的库可能上万组问答,本库三百余组,但它每一组都带专家答案;规模差两个数量级,可比的是"每组的标注成本"而不是"组数"。
1.4 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 给多模态模型打一个可信的胸片问答分 | 337 组专家参考答案,闭合与开放混合 | 够,且开放性问题能暴露闭合式指标的失真 |
| 检查模型是不是"不看图也能答对" | 同一问题可配不同图像,标识显式 | 够,但需要自己构造对照组 |
| 训练一个胸片问答模型 | 337 组样本 | 不够,量级差两三个数量级 |
| 拿到图像本身 | 只有 study_id 与 dicom_id | 不够,必须回源 MIMIC-CXR 或 MIMIC-CXR-JPG |
| 研究"模型表述与医师表述的差距" | 开放性问题带自然语言参考答案 | 够,这是它少见的可用之处 |
| 做病变分类任务的训练 | 只覆盖抽样条件涉及的病变 | 不够,抽样本身是按条件配额做的 |
| 做纵向对比(同一患者多次检查) | 官方未纳入连续检查 | 不够,官方明确说这一点是 Medical-Diff-VQA 才有 |
| 直接跑自动指标出数 | 有参考答案,无官方评分脚本 | 需自行实现匹配规则 |
1.5 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 你训好了一个胸片多模态模型,想对外报告能力 | 提供一个带专家答案的小规模对照集 | 先按 split_vqa 只用 test 子集出数,别把 validate 混进去 |
| 你怀疑自己的模型在闭合式问题上靠先验得分 | 68% 的闭合式问题可按是与否拆分统计 | 分别统计阳性与阴性问题的命中情况,再看开放性问题的表述质量 |
| 你要写模型评测方法章节,缺一个可引用的外部基准 | 官方给出了完整的构造方法与医师资历 | 引用版本 1.0.0 与 DOI,写清你用的是 test 还是 validate |
| 你在做医学 VQA 数据集的横向调研 | 它是"专家撰写答案"这一路线的样本 | 与规则生成答案的数据集对照,说明两条路线的差异 |
| 你想复现已发表模型(如 ELIXR、Med-Gemini 2D)的评测 | 官方明确说本数据集被用于这两者的评测 | 核对论文里的题数与本文口径是否一致 |
| 你想做中文医学 VQA | 问题与答案均为英文 | 需自行翻译并说明,注意翻译会改变匹配口径 |
1.6 一句话判断
它不是训练粮仓,是一把带刻度的尺子:尺子短,但刻度是专业读片的人一格一格刻上去的。
1.7 不适合谁:四条边界
不适合拿来做训练。 337 组问答、71 例胸片,任何一个有容量的模型几步就能记住全部。把它当训练集用,得到的只是记忆能力。
不适合拿来代表胸片的真实分布。 病例是按条件配额抽的:测试集六个条件各取 8 例,也就是说气胸、胸腔积液、肺水肿这些条件在样本里的比例远高于临床实际。用它估计"模型在真实门诊流里的表现",会得到偏乐观或偏悲观的数,取决于被抽中的条件恰好是模型的强项还是弱项。
不适合做纵向影像研究。 官方明确提到另一套数据才包含同一患者的连续检查,本数据集没有这一维度。想研究"病灶随时间变化"的问题,它不是合适的对象。
不适合在未获授权的环境里使用。 受限访问加受限许可,意味着下载、保存、再分发都有约束。把 TSV 传进公开代码仓库或第三方在线工具,会直接违反使用协议。
§2 数据构成与规格
2.1 交付物只有一个文件
官方 Data Description 段给出的文件清单只有一个:mimic_cxr_vqa.tsv。没有图像目录、没有标签文件、没有 README 式的说明文档,也没有配套代码。这一点值得单独强调,因为在 PhysioNet 上绝大多数影像类资源都是"目录树 + 若干文件"的形态,本资源反其道而行,把全部内容压进一张表。
这带来两个直接后果。第一,本数据集的文件体积几乎可以忽略,下载是秒级的,瓶颈全在访问权限而非带宽。第二,它无法独立使用:study_id 与 dicom_id 是指向外部库的指针,没有那两个库,这张表只是一堆问题与答案的文本,无法构成"视觉"问答。
从工程视角看,这种设计是有意为之:它把"评测题目"与"被评测的图像"解耦,使得同一套题目可以在 MIMIC-CXR 的 DICOM 版本与 MIMIC-CXR-JPG 的 JPG 版本之间自由切换,也避免了重复分发受保护的影像数据。
2.2 字段字典
下表把 TSV 的每一列逐条列出,包含官方给出的英文描述与中文解释。
| 列名 | 官方英文描述 | 含义 | 取值形态 | 使用注意 |
|---|---|---|---|---|
| study_id | Study ID of case | 病例所属影像研究的标识 | 与 MIMIC-CXR 一致的研究号 | 回源时先对齐到 MIMIC-CXR-JPG 的 study 级目录 |
| dicom_id | DICOM ID of the specific CXR image | 具体那张胸片的图像标识 | 与 MIMIC-CXR 一致的 DICOM 号 | 一个 study 下可能有多张图,取图必须用 dicom_id |
| split_vqa | Indicates which VQA split the question/image/answer belongs to | 该条问答属于哪个划分 | test 或 validate |
出评测数时只取 test,validate 用于调提示词与阈值 |
| question_id | Unique of the question/image/answer triplet | 问题、图像、答案三元组的唯一编号 | 唯一标识 | 三元组的唯一性靠它保证,不是问题模板的编号 |
| question | Question | 问题文本 | 英文自然语言 | 同一模板在不同病例上措辞可能不同 |
| expected_answer | Expert-curated reference answer | 专家撰写的参考答案 | 英文自然语言,含「是/否」与描述性表述 | 与模型输出比对时不能直接精确匹配 |
需要提醒的是,官方 Data Description 段列出的列是六列,而官方摘要段在描述规模时说的是"每个问题与病例我们还提供一条参考答案",两者在表述上一致。任何超出这六列的信息——比如问题的类型标签、对应的是哪个病变、答案是由哪位医师写的——在官方页面上都找不到,本文不代为推断。
2.3 一条记录的完整结构
一行就是一组问答三元组:某一张胸片、关于它的一个问题、以及这个问题的专家答案。三者的绑定关系由 question_id 保证,study_id 与 dicom_id 则把这一行拴回具体的影像。
结构上可以这样理解它的层次:study_id 在最上层,标识一次影像检查;dicom_id 在中间层,标识这次检查里的某一张具体图像;question_id 在最下层,标识这张图像上的某一个问题。官方说测试集有 48 个病例与 48 个唯一的 study ID 和 DICOM ID,验证集有 23 个病例与同样数量的唯一标识,也就是说在这个数据集里,一例恰好一图,中间层与最上层是一一对应的。
读取这一行结构的标准写法:
import pandas as pd

#-- 官方交付的是制表符分隔文本,不是逗号分隔
df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t')

print(df.shape)
print(list(df.columns))
#-- 期望输出列:study_id, dicom_id, split_vqa, question_id, question, expected_answer

#-- 只取官方测试集子集用于出评测数
test = df[df['split_vqa'] == 'test']
val = df[df['split_vqa'] == 'validate']
print(len(test), len(val))

#-- 核对"一例一图"的对应关系是否成立
print(test.groupby('study_id')['dicom_id'].nunique().max())
上面最后一行是对官方"每个病例对应唯一 study ID 与 DICOM ID"这一说法的自查方式,返回 1 即成立。这种写法不产出任何新的统计量,只是验证结构约束。
2.4 主键与回源映射
study_id 与 dicom_id 是指针,不是内容。要把本数据集变成真正的多模态输入,需要两步映射:先用 study_id 定位到 MIMIC-CXR-JPG 里对应的 study 目录,再用 dicom_id 定位到该目录下的具体 JPG 文件。若使用 DICOM 版本的 MIMIC-CXR,同样的两个标识也能定位到对应的 DICOM 文件。
上游两个库的规模决定了映射的成本:MIMIC-CXR 含 377,110 张图像、对应 227,835 次影像研究;MIMIC-CXR-JPG 含同样数量的 JPG 图像,对应 227,827 份报告。在这个量级里定位 71 张图,靠的是索引文件而不是目录遍历。
回源时要注意一件事:本数据集的病例来自 MIMIC-CXR 的官方测试集与验证集,而不是训练集。如果你此前用上游库的训练集训过模型,那么用本数据集评测是合规的外部测试;如果你用的是上游库的官方测试集训过模型,那么这 48 例就可能是训练时见过的图像,出数前必须先核对重叠。
2.5 split_vqa 的两个取值怎么用
split_vqa 只有 test 与 validate 两个取值,且这两个取值直接继承自上游 MIMIC-CXR 的官方划分,不是本数据集自己重新切的。这一点有实际影响:上游的官方划分是按患者做的,因此本数据集的两个子集之间在患者层面理论上不重叠,但官方并未就此给出明确声明。
使用上的建议很直接:把 test 当作最终出数的集合,把 validate 当作调提示词、调判定阈值、调匹配规则的集合。如果只用 validate 出数,会因为样本只有 111 组而让置信区间变得很宽;如果把两者混在一起出数,则需要在论文里写清口径,因为官方是分开描述两个子集的。
2.6 与同类问答数据集的字段差异
| 对比项 | 本数据集 | Medical-Diff-VQA(官方点名的同类) | VQA-RAD |
|---|---|---|---|
| 图像来源 | MIMIC-CXR 官方测试集与验证集 | MIMIC-CXR,并纳入同一患者的连续检查 | 放射科图像,非 MIMIC 来源 |
| 是否含连续检查 | 否 | 是 | 否 |
| 答案来源 | 持证放射科医师依据影像与报告撰写 | 官方描述为依据报告与标签流程生成 | 由标注者依据图像与报告整理 |
| 交付形态 | 单一 TSV,含图像标识 | 多文件结构 | 问答对文件 |
| 问题类型 | 存在性、位置、大小、严重程度、类型 | 以"差异"类问题为主 | 以开放性描述为主 |
| 规模口径 | 337 组问答 / 71 例 | 官方页面另述规模 | 官方页面另述规模 |
这张表的意义不在排名,而在说明"同样是胸片问答数据,字段能差到什么程度"。把两个数据集的 TSV 拼在一起做联合评测之前,先确认图像标识体系是否同源,否则 study_id 这类字段会在不同库之间撞名而不撞义。
§3 它是谁的数据
3.1 贡献者
| 作者 | 官方列出的机构 |
|---|---|
| Timo Kohlberger | |
| Charles Lau | Google via Vituity,Emeryville,CA,USA |
| Tom Pollard | Massachusetts Institute of Technology,USA |
| Andrew Sellergren | |
| Atilla Kiraly | |
| Fayaz Jamil |
六位作者里五位来自 Google 体系,一位来自 MIT。这个构成解释了数据集的两个特征:一方面它带有明确的工业界模型评测取向(官方说它被用于 Google 自家模型的评测);另一方面它挂靠在 PhysioNet 上,遵循了平台的受限数据发布流程与引用规范。
官方致谢段还提到三点:感谢 Jonathan Krause、Yun Liu 与 Dale Webster 对文稿的反馈;感谢放射科医师 Chuck Lau 整理参考答案;全部工作由 Google LLC 资助。需要注意的是,作者列表中也有一位 Charles Lau,官方在 Methods 段称参考答案撰写者为"具有 17 年 post-residency 经验的持证放射科医师",两者是否为同一人,官方页面未明确说明,本文不做推断。
3.2 时间线
| 时间 | 事件 |
|---|---|
| 2019 年 | 上游 MIMIC-CXR 数据库发表,提供 DICOM 影像与自由文本报告 |
| 2023 年 | Medical-Diff-VQA 发布,成为同类胸片问答资源 |
| 2023 年 | ELIXR 预印本发布,官方称本数据集被用于其评测 |
| 2024 年 | Med-Gemini 2D 相关预印本发布,官方称本数据集被用于其评测 |
| 2025 年 1 月 28 日 | 本数据集版本 1.0.0 在 PhysioNet 发布 |
| 2026 年 10 月 | 官方页面显示项目浏览量为 232(当前版本与全部版本同数) |
时间线里有一个值得注意的顺序:官方 Usage Notes 明确说,在本数据集完成到提交 PhysioNet 之间,Medical-Diff-VQA 先一步发表了。也就是说它不是"第一个 MIMIC-CXR 问答数据集",而是"后发的、走专家撰写路线"的那一个。理解这个先后顺序,就能理解它为什么把重心放在答案质量而不是规模上。
3.3 采集场景与来源层次
数据的来源可以分成三层。最底层是 Beth Israel Deaconess Medical Center 的胸部 X 线检查,这是 MIMIC-CXR 的原始来源;中间层是 MIMIC-CXR-JPG 提供的结构化标签,由 CheXpert 与 NegBio 算法从自由文本报告里抽取;最上层是本数据集基于这些标签做的病例抽样、问题选配与答案撰写。
这三层各自带进自己的特性。底层决定了影像的采集条件与人群特征——急诊与住院场景下的床旁片占比不低,图像质量与体位规范性不如筛查场景。中间层决定了"哪些病算是存在"这个判断的口径——CheXpert 与 NegBio 的输出本身就有不确定与阴性的区分,本数据集抽样时用的是标签等于 1.0 的条件,也就是只取明确阳性的那一类。最上层决定了问题问什么——它只能问中间层标签覆盖到的那些病变。
3.4 资助与利益冲突
官方声明全部工作由 Google LLC 资助,并明确列出利益冲突:作者均为 Google LLC 员工并持有 Alphabet 股票。这条声明在评测类资源里尤其值得留意,因为本数据集被官方指明用于 Google 自家模型的评测。这不影响数据集本身的可信度——病例来自公开的 MIMIC-CXR,抽样规则写在页面上,参考答案由具名资历的医师撰写——但它意味着使用者在引用"某模型在本数据集上的表现"时,要留意该分数最初由谁发布。
§4 它最独特的东西
4.1 稀缺性:专家写下的是答案而不是标签
医学影像数据集里,专家标注并不罕见——勾画病灶、判读良恶、分级严重度,都靠专家。但"专家为每一道开放性问题写一段自然语言参考答案"这件事,在公开资源里少得多。多数 VQA 数据集的答案是规则从报告里抽出来的短语,或是由标注者在给定选项里选一个。本数据集的开放性问题涉及位置、大小、严重程度、类型,这些都不是报告里必然有一一对应原句的内容,需要读片者综合影像与报告给出表述。
这一点带来的直接价值是:它可以用来衡量"模型说的和医师说的有多远",而不只是"模型选的对不对"。前者是生成式医学模型真正的瓶颈,后者用便宜得多的标签也能测。
第二个稀缺之处是答案与信息的对应关系被明确交代了。官方直说,撰写者以影像与自身判断为主,并且承认有些问题的作答信息并不在报告里。这句话看着平常,实际上划清了一条重要的界线:本数据集考的是"看影像作答",不是"从报告里找句子"。如果一道题的答案在报告中根本不存在,那么任何基于报告的文本模型都必然失分,而这个失分是有意义的——它说明这道题真的需要看图。
4.2 与同类资源的差异化证据
| 维度 | 本数据集的做法 | 这样做好在哪 | 代价 |
|---|---|---|---|
| 病例抽样 | 按条件配额抽样,测试集六个条件各 8 例 | 保证每个被关注的病变都有足够病例 | 不反映临床真实分布 |
| 问题选配 | 启发式规则,按条件配问题类型 | 可复现,且保证每例至少两条条件相关问题加一条通问 | 问题措辞的多样性受模板限制 |
| 阴性对照 | 对无其他条件的病例,随机挑一个非阳性病变只配存在性问题 | 避免模型靠"一律答有"得分 | 阴性问题的构成由随机决定 |
| 答案撰写 | 持证医师依据影像与报告撰写,以影像与自身判断为主 | 答案不依赖报告原句,覆盖面更广 | 成本高,规模做不大 |
| 划分继承 | 直接用上游官方 test 与 validate | 与上游生态对齐,可比性强 | 子集规模不均衡 |
4.3 一例胸片能被问出什么
官方给出了问题类型的完整集合,但没有逐条列出问题原文。可以按官方描述的规则还原一例的问法结构:假设某例是因为胸腔积液标签为 1.0 而被抽中的,那么它会拿到一条关于积液是否存在的问题,还可能拿到关于积液位置、大小或严重程度的问题;如果这一例同时存在肺水肿,规则会随机挑一个额外的阳性条件并配上相应问题;如果这一例没有其他阳性条件,规则会随机挑一个非阳性病变,只配一条存在性问题;最后,每一例都会再配一条与具体病变无关的通问。
| 环节 | 官方规则 | 结果 |
|---|---|---|
| 条件相关问题 | 按被抽中的条件,为 Table 1 里列出的每种问题类型各配一题 | 至少两条 |
| 额外阳性条件 | 若该例还有其他标签为 1.0 的条件,随机挑一个并配相应问题 | 可能增加 |
| 无其他阳性条件时 | 随机挑一个非阳性病变,只配存在性问题 | 增加一条 |
| 通问 | 随机挑一条与条件无关的问题 | 增加一条 |
| 每例合计 | 至少两条条件相关问题加一条通问 | 下限三条 |
需要说明:官方提到问题模板汇总在一张 Table 1 里,但该表的内容并未在 PhysioNet 页面上以文本形式呈现,因此具体措辞无法通过公开页面核实,本文只还原规则结构。
4.4 闭合式与开放式两类问题的分工
| 类型 | 官方描述 | 数量口径 | 打分方式 | 主要风险 |
|---|---|---|---|---|
| 闭合式 | 可用「是」或「否」回答,聚焦十五种胸部病变之一、支持装置、或笼统的异常 | 官方称占多数,68% | 可自动化匹配 | 先验偏置,不看图也能得高分 |
| 开放式 | 询问病灶或装置的位置、大小、严重程度或类型 | 其余部分 | 需人工或语义匹配 | 表述自由度导致精确匹配失真 |
两类问题在数据集里是混在一起的,TSV 里没有任何一列标明某条属于哪一类。要用这个区分做分析,得自己从 expected_answer 的形态推断:答案为「是」或「否」的属于闭合式。这个推断本身是可靠的,因为官方对闭合式的定义就是"可用是否作答",但它是由使用者做的,不是官方给出的标签。
4.5 边界条件
三条边界值得在使用前确认。第一,问题覆盖的病变范围是十五种胸部病变、支持装置、以及笼统的异常,超出这个范围的问题不在其中;而上游 MIMIC-CXR-JPG 提供的是十二种胸部病变标签加支持装置与整体正常/异常状态,两个口径并不完全相同,官方在摘要里同时出现了这两个数字。
第二,参考答案以影像与医师自身判断为主,官方明确说某些病例与问题的答案信息并不包含在报告里。这意味着拿报告文本做纯文本基线的对照时,某些题目的正确答案在报告中根本不存在,基线的失分不反映模型能力。
第三,数据集没有给出患者层面的信息,无法按年龄、性别、体位或采集设备做分层分析。
§5 怎么拿到
5.1 访问门槛:四步
| 步骤 | 要做什么 | 说明 |
|---|---|---|
| 1 | 注册 PhysioNet 账号 | 页面上标注为 Restricted Access |
| 2 | 完成身份认证(credentialing) | 受限健康数据的通用要求 |
| 3 | 签署 PhysioNet Restricted Health Data Use Agreement 1.5.0 | 官方页面明确列出该协议 |
| 4 | 下载 mimic_cxr_vqa.tsv | 单一文件,无目录树 |
此外,若要把问题与图像真正对上,还需要对 MIMIC-CXR 或 MIMIC-CXR-JPG 分别完成访问申请。两个库的访问政策与许可版本可能不同,申请前各自核对。
需要注意地域限制:官方页面在某些地区会显示数据不可用,这是法律或政策层面的限制,不是账号问题。遇到这种情况,换网络出口并不能绕过合规要求。
5.2 文件清单与目录结构
| 文件 | 说明 | 是否随库分发 |
|---|---|---|
| mimic_cxr_vqa.tsv | 唯一交付文件,六列,337 行问答(按官方 Methods 段口径) | 是 |
| 图像文件 | 由 study_id 与 dicom_id 指向,本体在 MIMIC-CXR 或 MIMIC-CXR-JPG | 否 |
| 原始放射科报告 | 上游 MIMIC-CXR 的自由文本报告 | 否 |
| 结构化标签 | 上游 MIMIC-CXR-JPG 的标签,由 CheXpert 与 NegBio 生成 | 否 |
| 问题模板表(Table 1) | 官方在 Methods 段引用,页面未以文本形式给出 | 否 |
| 评分脚本 | 官方未提供 | 否 |
没有评分脚本这一点值得单独说。官方给了参考答案,但没有给判定规则,因此"什么算答对"由使用者自己定义。不同论文用不同匹配规则得到的分数并不可比,这一点在横向比较时要写清。
5.3 下载与读取
#-- 方式一:登录后用浏览器在项目页的 Files 区直接下载
#-- 方式二:用 PhysioNet 官方提供的下载脚本(需先完成 credentialing)
wget -r -N -c -np --user <USERNAME> --ask-password \
     https://physionet.org/files/vqa-evaluation-mimic-cxr/1.0.0/
import pandas as pd

#-- 官方交付的文件是制表符分隔,务必显式指定 sep
df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- 六个字段全部按字符串读入,避免 study_id 被当成整数丢掉前导零
print(df.dtypes)
print(df.head(3).to_string())
用 dtype=str 读入是个小但重要的选择:study_id 这类标识如果被推断成整数,前导零可能丢失,回源时就对不上上游目录名。
5.4 转成评测用的配对表
import pandas as pd

df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- 构造"图像 + 问题 + 参考答案"的三元组清单
items = []
for row in df.itertuples(index=False):
    items.append({
        'qid': row.question_id,
        'study_id': row.study_id,
        'dicom_id': row.dicom_id,
        'split': row.split_vqa,
        'question': row.question,
        'reference': row.expected_answer,
    })

#-- 按划分拆开,test 用来出最终数,validate 用来调判定规则
test_items = [x for x in items if x['split'] == 'test']
val_items = [x for x in items if x['split'] == 'validate']
print(len(test_items), len(val_items))
5.5 回源到图像
import os
import pandas as pd

df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- MIMIC-CXR-JPG 的目录层级为 p<patient>/p<patient>/s<study>/<dicom_id>.jpg
#-- study_id 与 dicom_id 已在 TSV 中给出,patient 段需由上游的元数据表查出
JPG_ROOT = '/path/to/mimic-cxr-jpg/2.0.0/files'

def jpg_path(study_id, dicom_id, meta):
    #-- meta 为上游 metadata.csv,含 dicom_id 到 patient/study 目录的映射
    hit = meta[meta['dicom_id'] == dicom_id]
    if hit.empty:
        return None
    r = hit.iloc[0]
    return os.path.join(JPG_ROOT, f"p{r['subject_id']}", f"p{r['subject_id']}",
                        f"s{study_id}", f"{dicom_id}.jpg")

#-- 逐条解析路径,解析失败的单独记录以便核查
resolved, failed = [], []
for row in df.itertuples(index=False):
    p = jpg_path(row.study_id, row.dicom_id, meta)
    (resolved if p and os.path.exists(p) else failed).append(row.dicom_id)

print('resolved=', len(resolved), 'failed=', len(failed))
上游文件的目录层级以官方文件清单为准,不同版本可能不同;解析失败的一批要在评测前查清原因,否则会因为图像缺失而少算题目。
5.6 五个坑
| 坑 | 现象 | 怎么避开 |
|---|---|---|
| 把 TSV 当逗号分隔读 | 所有列挤在第一列,分隔符被吞 | 显式 sep='\t' |
| 标识被推断成整数 | study_id 前导零丢失,回源对不上 | dtype=str 全列按字符串读入 |
| 把 validate 一起算进最终分数 | 出数口径与官方描述不一致 | 只用 test 出最终数 |
| 用上游官方测试集训过模型 | 48 例可能是训练时见过的图像 | 出数前先核对与训练集的图像重叠 |
| 以为有官方评分脚本 | 各家分数不可比 | 自己定义匹配规则并在论文里写清 |
§6 与库内其他资源的关系
6.1 关系图谱
| 资源 | 关系 | 怎么配合 |
|---|---|---|
| MIMIC-CXR | 影像与报告的来源,提供 DICOM 与自由文本 | 用 study_id 与 dicom_id 回源取图 |
| MIMIC-CXR-JPG | 提供结构化标签,本数据集的病例抽样依据 | 用同一组标识取 JPG,用标签核对抽样条件 |
| Medical-Diff-VQA | 同类胸片问答资源,官方点名对比 | 若需连续检查的纵向问题,改用后者 |
| MS-CXR-T | 带病灶级别定位标注的胸片子集团 | 若需空间定位真值,与它配合 |
| Chest ImaGenome | 胸片的解剖结构与关系标注 | 若需结构化场景图,与它配合 |
| CheXpert | 标签抽取算法的出处 | 理解标签口径的由来 |
| LLaVA-Rad MIMIC-CXR 标注 | 另一条基于 MIMIC-CXR 的标注路线 | 对比自动标注与专家撰写答案的差异 |
| MIMIC-CXR 图像嵌入 | 上游图像的向量化版本 | 若无原图访问权限,可作为替代输入核对流程 |
6.2 检索路径
在库内检索时,用"胸部 X 线 + 问答"这组关键词可以找到本数据集与 Medical-Diff-VQA、VQA-RAD 等相邻资源;用"MIMIC-CXR"可以找到上游的影像库、标签库与各类衍生标注。两条路径的交集就是本数据集的位置:它既是问答类资源,也是 MIMIC-CXR 生态里的一个衍生品。
判断检索是否走对的简单方法:看候选资源有没有显式给出图像标识。只给问答文本而不给 study_id 与 dicom_id 的,无法回源到具体影像,也就无法做真正的视觉评测。
6.3 分工判据
| 你的任务 | 该用哪个 | 理由 |
|---|---|---|
| 给模型出一个可信的胸片问答分 | 本数据集 | 参考答案由医师撰写,闭合与开放混合 |
| 研究同一患者多次检查的差异 | Medical-Diff-VQA | 官方说它纳入连续检查 |
| 做病灶的空间定位评测 | MS-CXR-T 一类带定位标注的资源 | 本数据集无定位真值 |
| 训练大规模胸片问答模型 | 上游 MIMIC-CXR 配合自动生成的问答 | 本数据集规模不足以训练 |
| 研究影像报告的结构化抽取 | MIMIC-CXR 与 MIMIC-CXR-JPG | 本数据集不含报告原文 |
§7 质量评估与局限性
7.0 前置校正:官方自己的两处数字不一致
| 项目 | 摘要段的口径 | Methods 段的口径 |
|---|---|---|
| 测试集问题数 | 224 | 226 |
| 测试集闭合式数 | 未单列 | 154 |
| 验证集问题数 | 111 | 111 |
| 验证集闭合式数 | 未单列 | 73 |
| 合计问题数 | 335 | 337 |
两处相差 2 道,官方未给出解释。本文在涉及"合计"时采用 Methods 段的 337 并标注口径,读者若要与某篇论文对表,应先确认对方用的是哪个数字。这不是本文的推断,而是官方页面内部本身就存在的差异。
验证集的病例构成也有未澄清之处:官方称验证集沿用同一抽样法,只是胸腔积液取 7 例、肺病灶与实变或肺炎与肺水肿各取 4 例,但这些数字与总数 23 之间无法在官方文本内唯一地对齐。本文只引用官方给出的 23 例总数与上述抽样描述,不做配平计算。
7.1 五维评分
| 维度 | 评价 | 依据 |
|---|---|---|
| 答案质量 | 高 | 持证放射科医师撰写,17 年 post-residency 经验,以影像与自身判断为主 |
| 问题设计 | 中 | 规则驱动,可复现,但措辞多样性受模板限制,模板表未公开 |
| 规模 | 低 | 337 组问答、71 例胸片,不足以训练,只够评测 |
| 可用性 | 中 | 单一 TSV、无需图像处理,但图像本体需另行申请 |
| 文档完整性 | 低 | 无 README、无评分脚本、问题模板表未在页面呈现 |
7.2 标注的两层
第一层是病例与问题的配对,来源是 MIMIC-CXR-JPG 标签驱动的启发式规则。这一层的准确性取决于上游标签:CheXpert 与 NegBio 从自由文本报告抽取标签,本身存在不确定与阴性的处理差异,本数据集抽样时取的是标签等于 1.0 的条件,也就是明确阳性。
第二层是参考答案,来源是人。官方明确说撰写者主要依据胸片影像与自身专业判断,对某些病例与问题,报告里并不包含作答所需的信息。这一层不依赖上游标签,也正因为如此,它才能衡量模型"看图"的能力而不是"读报告"的能力。
两层之间的张力值得留意:问题问的是标签覆盖到的病变,答案却可能超出标签给出的信息。如果某个标签本身是错的,问题就会问错,而医师的答案是对的——这种情况下模型答对了反而会被判错。这类冲突在数据集里没有标记。
7.3 可枚举的偏差
| 偏差 | 机制 | 影响 |
|---|---|---|
| 条件配额偏差 | 测试集六个条件各取 8 例 | 样本构成不等于临床分布,外部效度受限 |
| 上游标签偏差 | 病例筛选依赖 CheXpert 与 NegBio 输出 | 标签错误会传导到问题与病例选择 |
| 单一中心偏差 | 全部影像来自同一家医疗中心 | 设备与人群特征单一,泛化结论要谨慎 |
| 抽样随机偏差 | 额外条件与阴性对照由随机挑选决定 | 同类复现需固定随机种子,官方未说明种子 |
| 答案表述偏差 | 参考答案为单一医师的表述 | 语义等价的其他表述会被严格匹配判错 |
| 语言偏差 | 问题与答案均为英文 | 非英文模型的评测需翻译,引入额外变量 |
7.4 外部验证
官方 Usage Notes 明确说,本数据集已被用于 ELIXR 模型与 Med-Gemini 2D 模型的评测。这是它能拿到的最直接的外部验证:至少有两组公开工作把它当作评测基准使用。
但这类验证的性质要看清。这两项工作与数据集作者有重叠,属于"作者用自己的评测集评自己的模型"。这不构成负面判断——评测集是公开的、构造方法是写明的、图像来自第三方公开库,任何人都能复核——但它意味着"在本数据集上报告的高分"应被视为需要独立复现的结果,而不是既成事实。
7.5 为什么它仍然值得用
三个理由。第一,它把"专家撰写的参考答案"这个稀缺要素落在了公开平台上,任何人完成申请就能拿到,不需要自己组织医师团队。第二,它的构造过程写得足够细——抽样条件、配额、问题选配规则、答案撰写者的资历——使得批评它的人可以精确指出问题在哪,这比黑盒评测集有用得多。第三,它小,小到可以人工复核每一条模型输出,而这一点在大型基准上做不到。
§8 生态位与历史
8.1 沿革
| 阶段 | 时间 | 特征 |
|---|---|---|
| 上游建立 | 2019 年 | MIMIC-CXR 提供大规模胸片影像与自由文本报告 |
| 标签化 | MIMIC-CXR-JPG 版本 | CheXpert 与 NegBio 生成结构化标签,使按条件抽样成为可能 |
| 问答化(先发路线) | 2023 年 | Medical-Diff-VQA 走"差异问答 + 连续检查"路线 |
| 问答化(后发路线) | 2025 年 | 本数据集走"专家撰写答案 + 单图多问"路线 |
8.2 与挑战赛的关系
本数据集不是任何挑战赛的官方数据,也不附带排行榜。它的定位更接近"论文里的评测附录"——为某一类模型的某一类能力提供一个可复现的测量工具。这与挑战赛数据的区别在于:挑战赛通常提供训练、验证、测试三段与统一评分脚本,本数据集只提供测试与验证两段且无评分脚本。
8.3 生态位
在"胸片 + 问答"这个小生态里,它占据的是一个偏重质量而非规模、偏重评测而非训练、偏重单图而非纵向的位置。相邻位置各有主:规模与自动生成由上游库加规则流水线占据,纵向对比由 Medical-Diff-VQA 一类占据,空间定位由带定位标注的资源占据。本数据集不与它们竞争,它填补的是"专家答案"这一格。
8.4 谁在用
官方点名的使用者是 ELIXR 与 Med-Gemini 2D 两项工作。除此之外,任何需要给胸片问答能力出数、且愿意完成 PhysioNet 受限访问申请的研究团队都可以使用它。官方页面显示的浏览量(232)说明它的传播规模还很小,这也意味着围绕它形成的评测惯例尚未定型——谁来用它,谁就在定义怎么用。
§9 使用指引
9.1 三种角色的最短路径
| 角色 | 路径 | 注意事项 |
|---|---|---|
| 模型评测者 | 申请访问 → 下载 TSV → 回源图像 → 只取 test → 自定义匹配规则 → 出数 | 出数前核对与训练集的图像重叠 |
| 数据集设计者 | 读官方 Methods 段的抽样与选配规则 → 对照自己的构造流程 | 问题模板表未公开,规则可学但措辞不可抄 |
| 临床研究者 | 关注答案撰写者的资历与依据 → 判断结论能推到什么范围 | 单中心、配额抽样,不做临床推断 |
9.2 最短流程
- 注册并完成 PhysioNet 的 credentialing,签署受限健康数据使用协议 1.5.0。
- 对 MIMIC-CXR-JPG(或 MIMIC-CXR)另行完成访问申请。
- 下载 mimic_cxr_vqa.tsv,用
sep='\t'与dtype=str读入。 - 用 study_id 与 dicom_id 在上游库里定位 71 张图像。
- 按 split_vqa 拆开,test 出最终数,validate 调规则。
- 自己定义匹配规则,把闭合式与开放式分开统计。
- 引用时写明版本号、DOI 与所用子集。
9.3 引用方式
| 场景 | 写法 |
|---|---|
| 正式引用 | Kohlberger, T., Lau, C., Pollard, T., Sellergren, A., Kiraly, A., & Jamil, F. (2025). Visual Question Answering evaluation dataset for MIMIC CXR (version 1.0.0). PhysioNet. https://doi.org/10.13026/cvsk-ny21 |
| 平台引用 | PhysioNet 平台综述论文,按官方页面 Cite 按钮生成 |
| 上游引用 | MIMIC-CXR(Johnson 等,2019)与 MIMIC-CXR-JPG(版本 2.0.0)需分别引用 |
| 版本标注 | 必须写明 1.0.0,并说明用的是 test、validate 还是两者 |
§10 AI 使用声明
| 项目 | 声明 |
|---|---|
| 文本生成 | 本文由 AI 辅助撰写,编辑把关结构与事实 |
| 数字来源 | 规模、结构、边界三类数字来自 PhysioNet 官方项目页 |
| 文件核验 | 官方文件目录因地域限制返回 403,未直接下载 TSV;字段与列名以官方 Data Description 段为准 |
| 不一致说明 | 官方摘要段与 Methods 段的问题总数分别为 224 与 226,已在 §7.0 列出,本文采用 226 并标注 |
| 论文信息 | 仅参考官方页面列出的参考文献条目,未读全文 |
| 未核验内容 | 问题模板表(Table 1)的具体措辞、验证集各条件的最终例数、每张图像的采集参数、参考答案的具体表述 |
| 图像 | 无配图;封面为生成式提示词,不含真实胸片 |
| 免责 | 本文不构成临床建议;数据使用须遵守 PhysioNet 受限健康数据许可与使用协议 |
常见误读(避坑清单)
| 说法 | 实际 | 证据 |
|---|---|---|
| 「它自带胸片图像」 | 只有 study_id 与 dicom_id,图像在上游库 | 官方 Data Description 只列出一个 TSV |
| 「它有 337 道问题,官方只有一个数字」 | 摘要段写 224,Methods 段写 226,合计分别为 335 与 337 | 官方页面两段原文 |
| 「它可以直接训练模型」 | 337 组问答,量级上只够评测 | 官方规模描述 |
| 「答案是自动生成的」 | 参考答案由持证放射科医师撰写 | 官方摘要与 Methods 段 |
| 「问题是从报告里自动生成的」 | 问题选配是启发式规则,答案才是人工的 | 官方 Methods 段 |
| 「它有官方评分脚本」 | 官方未提供,匹配规则由使用者定义 | 官方文件清单只有一个 TSV |
| 「它包含同一患者的连续检查」 | 不包含,官方明确说这是 Medical-Diff-VQA 的特点 | 官方 Usage Notes |
| 「它用的是上游的十五种病变标签」 | 上游 MIMIC-CXR-JPG 是十二种病变加支持装置与正常/异常状态,问题覆盖十五种病变 | 官方摘要段两处表述 |
| 「validate 子集可以和 test 合并出数」 | 官方分开描述两个子集,合并需自报口径 | 官方 split_vqa 字段说明 |
| 「它不受访问限制」 | 受限访问,需注册并签署使用协议 | 官方 Access 与 License 段 |
FAQ
Q1:它到底有多少组问答?官方为什么给了两个数字?
官方页面的摘要段说测试集 224 组、验证集 111 组;而 Methods 段说测试集 226 组(其中 154 组闭合)、验证集 111 组(其中 73 组闭合)。两者相差 2 组,官方未解释。合计因此有两种口径:335 或 337。本文在需要给合计数时采用 Methods 段的 337 并注明口径,与他人对表前先确认对方用的是哪个。
Q2:没有图像,我怎么用它做视觉问答评测?
凭 study_id 与 dicom_id 回源。这两个标识与 MIMIC-CXR 及 MIMIC-CXR-JPG 完全一致,在上游库里按 study 与 dicom 两级定位即可取到对应的 DICOM 或 JPG 文件。注意上游两个库也需要各自完成访问申请,本数据集的访问授权不覆盖它们。
Q3:参考答案是怎么来的?可信吗?
由一位持证放射科医师依据胸片影像与原始放射科报告撰写,官方给出的资历是十七年 post-residency 经验,并明确说撰写时以影像与自身专业判断为主。官方致谢段提到整理参考答案的是放射科医师 Chuck Lau。可信度方面,它是公开资源里少见的"专家撰写自然语言答案",但也要看到它是单一医师的表述,语义等价的其他说法会被严格匹配判错。
Q4:闭合式和开放式各有多少?
官方说多数(68%)是闭合式,即可用「是」或「否」回答,聚焦十五种胸部病变之一、支持装置、或笼统的异常;其余开放式询问位置、大小、严重程度或类型。Methods 段给出了 154 与 73 两个闭合式计数。TSV 里没有标明类别的列,需要使用者按参考答案的形态自行区分。
Q5:我可以拿它训练模型吗?
不建议。337 组问答、71 例胸片,任何有容量的模型几步就能记住。它的设计取向是评测:规模小到可以让人工复核每一条输出,而这一点正是大型基准做不到的。
Q6:它和 Medical-Diff-VQA 有什么区别?
官方自己点了这个对比:Medical-Diff-VQA 纳入同一患者的连续检查,可以做纵向的"差异"问答;本数据集是单图多问,不做纵向。此外本数据集的参考答案由医师撰写,走的是答案质量优先的路线。两者发布时间上 Medical-Diff-VQA 更早,本数据集是后发的。
Q7:病例是怎么挑出来的?会不会偏?
会偏,而且是设计上的偏。官方说测试集从官方测试集中按条件各随机挑 8 例:气胸、胸腔积液、肺水肿、实变或肺炎、肺病灶,再加上 8 例"无发现"标签为 1.0 的病例,合计 48 例。这意味着被关注病变在样本中的比例远高于临床实际。用它估计模型在真实门诊流里的表现是不合适的。
Q8:许可允许我怎么用?
按 PhysioNet 受限健康数据许可 1.5.0 与配套使用协议。核心约束是注册、签署协议、不越权再分发。把 TSV 放进公开代码仓库或上传到第三方在线工具,都会违反协议。商业使用方面的条款以官方许可全文为准。
术语表
| 术语 | 解释 |
|---|---|
| 视觉问答(VQA) | 给定一张图像与一个自然语言问题,输出自然语言答案的任务 |
| 闭合式问题 | 可用「是」或「否」回答的问题 |
| 开放式问题 | 需要描述性回答的问题,如问位置、大小、严重程度、类型 |
| 参考答案 | 由专家撰写、用于与模型输出比对的标准答案 |
| 先验偏置 | 模型靠答案的先验概率得分,而非依赖输入内容 |
| MIMIC-CXR | 大规模去标识胸部 X 线数据库,含 DICOM 影像与自由文本报告 |
| MIMIC-CXR-JPG | MIMIC-CXR 的衍生版本,提供 JPG 图像与结构化标签 |
| CheXpert | 从放射科报告抽取病变标签的算法 |
| NegBio | 用于识别报告中否定与不确定表述的算法 |
| study_id | 一次影像研究的标识 |
| dicom_id | 一次研究中某一张具体图像的标识 |
| 支持装置 | 影像中可见的管路、导管、起搏导线等医疗器械 |
| 无发现(No Finding) | 上游标签之一,表示未发现异常 |
| 配额抽样 | 按预设条件各取固定数量样本的抽样方式 |
| 受限访问 | 需注册并完成认证才能下载的数据访问级别 |
| 数据使用协议(DUA) | 规定数据可如何使用、可否再分发的法律文件 |
| 跨源回源 | 凭标识到另一个数据库取回原始数据的过程 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 层级 |
|---|---|---|---|
| 版本 | 1.0.0 | 官方页面标题与版本区 | 官方页面 |
| 发布日期 | 2025-01-28 | 官方页面 | 官方页面 |
| 测试集病例数 | 48 | 官方摘要段与 Methods 段 | 官方页面 |
| 验证集病例数 | 23 | 官方摘要段与 Methods 段 | 官方页面 |
| 病例合计 | 71 | 由上述两个官方数字相加 | 官方页面(相加) |
| 测试集问题数 | 226(Methods 段)/ 224(摘要段) | 官方页面两段 | 官方页面(存在内部差异) |
| 验证集问题数 | 111 | 官方页面两段一致 | 官方页面 |
| 测试集闭合式 | 154 | 官方 Methods 段 | 官方页面 |
| 验证集闭合式 | 73 | 官方 Methods 段 | 官方页面 |
| 闭合式占比 | 68% | 官方摘要段 | 官方页面 |
| 抽样条件数(测试集) | 6 类,每类 8 例 | 官方 Methods 段 | 官方页面 |
| 问题类型数 | 5 类(存在性、位置、大小、严重程度、类型) | 官方摘要段 | 官方页面 |
| 问题覆盖病变数 | 15 种,另含支持装置与笼统异常 | 官方摘要段 | 官方页面 |
| 上游病变标签数 | 12 种,另含支持装置与整体正常/异常 | 官方摘要段 | 官方页面 |
| 交付文件数 | 1(mimic_cxr_vqa.tsv) | 官方 Data Description 段 | 官方页面 |
| 列数 | 6 | 官方 Data Description 段 | 官方页面 |
| 答案撰写者资历 | 持证放射科医师,17 年 post-residency 经验 | 官方摘要段 | 官方页面 |
| 版本 DOI | 10.13026/cvsk-ny21 | 官方 Discovery 区 | 官方页面 |
| 许可 | PhysioNet Restricted Health Data License 1.5.0 | 官方 License 区 | 官方页面 |
| 上游图像数 | 377,110 | MIMIC-CXR 官方页面 | 官方页面(上游) |
| 上游研究数 | 227,835 | MIMIC-CXR 官方页面 | 官方页面(上游) |
附录 B:数字的来源分层
第一层:官方页面直接给出。 版本、发布日期、DOI、许可、列名、病例数与问题数、闭合式计数与占比、抽样条件与配额、答案撰写者资历。这些来自项目主页的摘要、Methods、Data Description 与 Discovery 各段。
第二层:跨库核对。 上游 MIMIC-CXR 的图像数与研究数,来自该库自身的官方页面,用于说明回源规模。
第三层:未核实。 问题模板表的具体措辞、验证集各条件的最终例数、图像采集参数、参考答案的具体表述、以及每个病例实际配到了几条问题。这些需要下载 TSV 后逐条统计,而官方文件目录在当前环境下返回 403,本文未做,正文中凡涉及处只做定性表述。
附录 C:完整参考文献
| 编号 | 文献 | 链接 | 用途 |
|---|---|---|---|
| 1 | Visual Question Answering evaluation dataset for MIMIC CXR v1.0.0 | https://physionet.org/content/vqa-evaluation-mimic-cxr/1.0.0/ | 全部规模、结构、边界数字 |
| 2 | MIMIC-CXR v2.0.0 | https://physionet.org/content/mimic-cxr/ | 上游影像与报告规模、回源目标 |
| 3 | MIMIC-CXR-JPG v2.0.0 | https://physionet.org/content/mimic-cxr-jpg/ | 结构化标签来源、回源目标 |
| 4 | Medical-Diff-VQA v1.0.0 | https://doi.org/10.13026/5jes-bx23 | §4.2 与 §8.1 的同类对比 |
| 5 | ELIXR(arXiv:2308.01317) | https://arxiv.org/abs/2308.01317 | §7.4 外部验证 |
| 6 | Advancing Multimodal Medical Capabilities of Gemini(arXiv:2405.03162) | https://arxiv.org/abs/2405.03162 | §7.4 外部验证 |
| 7 | MIMIC-CXR 原始论文(Scientific Data, 2019) | https://doi.org/10.1038/s41597-019-0322-0 | 上游数据库描述 |
| 8 | PhysioNet 平台综述(2026,Nature Health) | https://doi.org/10.1038/s44360-026-00096-z | 托管模式与引用规范 |
附录 D:任务代码
任务一:按划分拆开并核对一例一图
import pandas as pd

df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- 按官方划分拆分
test = df[df['split_vqa'] == 'test']
val = df[df['split_vqa'] == 'validate']

#-- 核对每个 study_id 是否只对应一个 dicom_id
for name, sub in (('test', test), ('validate', val)):
    n_case = sub['study_id'].nunique()
    n_img = sub['dicom_id'].nunique()
    max_per_study = sub.groupby('study_id')['dicom_id'].nunique().max()
    print(name, 'cases=', n_case, 'images=', n_img, 'max_per_study=', max_per_study)
任务二:闭合式与开放式分开统计
import pandas as pd

df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- 官方对闭合式的定义是"可用是否作答",据此从参考答案形态推断类别
def is_closed(ans):
    return str(ans).strip().strip('.').lower() in ('yes', 'no', 'true', 'false')

df['closed'] = df['expected_answer'].map(is_closed)

#-- 分划分统计,注意这是使用者自行做的分类,不是官方标签
for name, sub in df.groupby('split_vqa'):
    print(name, 'total=', len(sub), 'closed=', int(sub['closed'].sum()))
任务三:构造"不看图"的对照基线
import pandas as pd

df = pd.read_csv('mimic_cxr_vqa.tsv', sep='\t', dtype=str)

#-- 恒定输出"no"的基线,用于暴露闭合式问题的先验偏置
closed = df[df['expected_answer'].str.strip().str.lower().isin(['yes', 'no'])]
always_no = (closed['expected_answer'].str.strip().str.lower() == 'no').sum()
print('closed=', len(closed), 'always_no_hits=', int(always_no))
第三段代码给出的不是一个模型分数,而是一把标尺:如果某个模型在这组闭合式问题上只比"恒定答否"高一点,那么它的高分多半来自先验而不是影像理解。
附录 E:如果只记五件事
| 序号 | 记住什么 | 为什么 |
|---|---|---|
| 1 | 71 例胸片、337 组问答(另有一口径为 335) | 这四个数字定义了它的全部用法与限制 |
| 2 | 图像不随库分发,靠 study_id 与 dicom_id 回源 | 不做回源,它只是一张文本表 |
| 3 | 参考答案由十七年经验的持证放射科医师撰写 | 这是它最不可替代的部分 |
| 4 | 病例按条件配额抽样,六个条件各 8 例 | 样本不等于临床分布,不做临床推断 |
| 5 | 无官方评分脚本,匹配规则自己定 | 各家分数不可比,写论文要写清规则 |
编辑说明
本文的核验时间为 2026 年 10 月 28 日。核对方式为直接访问 PhysioNet 项目页,逐段比对摘要、Background、Methods、Data Description、Usage Notes、Ethics、Acknowledgements、Conflicts of Interest 与 Discovery 各段的原文;上游规模数字通过访问 MIMIC-CXR 与 MIMIC-CXR-JPG 的官方页面核对。官方文件目录 https://physionet.org/files/vqa-evaluation-mimic-cxr/1.0.0/ 在当前网络环境下返回 403,因此 TSV 的实际内容未经下载核验,字段与列名以官方 Data Description 段为准,这一点已写入 §10。未覆盖的内容包括:问题模板表的具体措辞、验证集各条件的最终例数、每张图像的采集参数、参考答案的具体表述、以及每个病例实际配到的问题条数。这些需要获得授权下载后统计,本文按要求只写规模、结构、边界三类数字。官方摘要段与 Methods 段在测试集问题数上的 224 与 226 之差,已在 §7.0、附录 A 与 FAQ 第一问分别说明,本文不代为裁决。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本页共享多个主题标签的相关数据集,按相关度降序排列:
- mimic-cxr,共享标签:医学影像 / 胸部X线 / 多模态评测
- mimic-cxr-jpg,共享标签:医学影像 / 胸部X线 / 结构化标签
- medical-cxr-vqa-dataset,共享标签:医学影像 / 胸部X线 / 视觉问答
- vqa-rad,共享标签:医学影像 / 视觉问答 / 多模态评测
- pmc-vqa,共享标签:医学影像 / 视觉问答 / 多模态评测
- ms-cxr-t,共享标签:医学影像 / 胸部X线 / 病灶定位
- llava-rad-mimic-cxr-annotation,共享标签:医学影像 / 胸部X线 / 报告标注
- chexpert,共享标签:医学影像 / 胸部X线 / 标签抽取
- chest-imagenome,共享标签:医学影像 / 胸部X线 / 场景图标注
- image-embeddings-mimic-cxr,共享标签:医学影像 / 胸部X线 / 图像表征
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
