信息速览
THYME — Mayo Clinic 临床时间表达式语料 AI-Ready Wikipedia
INFOBOX
| 字段 | 内容 |
|---|---|
| 数据集名称 | THYME |
| 英文全称 | THYME: Temporal Histories of Your Medical Events |
| 别名/简称 | THYME 语料;THYME-TimeML 语料;THYME Corpus |
| 疾病分类 | 结肠恶性肿瘤(ICD-11 2B90 结直肠恶性肿瘤);脑恶性肿瘤(ICD-11 2A00 脑或中枢神经系统恶性肿瘤) |
| SNOMED CT | 363406005(malignant neoplasm of colon,结肠恶性肿瘤);93747008(malignant neoplastic disease of brain,脑恶性肿瘤) |
| 数据模态 | 临床文本(肿瘤学叙事:临床文书、病理报告、放射报告) |
| AI 任务类型 | 命名实体识别(EVENT/TIMEX3)、事件属性分类、DocTimeRel 分类、时间关系抽取(TLINK/ALINK)、叙事容器识别、时间线构建 |
| 样本总数 | 1,254 份去标识病历;约 172,800 个标注单元 |
| 数据格式 | Anafora XML(标注层)+ 纯文本(文书正文) |
| 许可证 | 标注层经 GitHub 公开分发;文书正文需签署 Mayo Clinic 数据使用协议(DUA) |
| 访问级别 | 标注层开放;正文申请审核(2026-06 起经 Harvard hNLP Center 办理) |
| DUO 标签 | 无官方 DUO 标注;按 DUA 执行:机构 PI 申请、加密存储、禁再识别、禁再分发 |
| 语言 | 英语(美式英文临床文书) |
| 首发日期 | 2014-05-13(TACL Train Subset Release;TACL 论文同年发表) |
| 最后更新 | 2026-06-01(README 获取入口更新至 Harvard hNLP Center) |
| 发布机构 | Mayo Clinic(与科罗拉多大学博尔德分校、波士顿儿童医院/Harvard 合作) |
| 官方主页 | GitHub: stylerw/thymedata |
| 下载地址 | 标注层:GitHub 仓库;正文:经 DUA 流程获取 |
| AI 就绪度评分 | ⭐⭐⭐(3/5)— 标注层开放且格式规范,但无官方预处理脚本,正文与标注层分离、需自行完成偏移量对齐与 XML 解析(扣分项) |
| 页面状态 | published |
§0 E-E-A-T 与审核声明
医学审核者:[千方病案医学编辑部] 交叉审核:§2 医学背景(ICD-11/SNOMED CT 双映射、疾病流行病学)、§7 偏倚分析。
数据工程审核者:[千方病案医学编辑部交叉审核] 医疗 AI 数据工程师,审核范围:§4 DAIMS 数据字典、§5 数据划分策略、§6 预处理 Pipeline 和坑点。
审核日期:2026-09-05
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始许可协议。THYME 的标注层在 GitHub 公开分发,但文书正文需与 Mayo Clinic 签署数据使用协议(DUA,2026-06 起经 Harvard hNLP Center 办理),协议要求加密存储、禁止再识别尝试、禁止再分发,并在成果中致谢 Mayo Clinic、引用 Styler et al. 2014。具体使用限制以数据集官方协议为准。
§1 数据集概览
§1.0 30 秒速览
这是什么? THYME 是由 Mayo Clinic 牵头、与科罗拉多大学博尔德分校等机构合作构建的临床时间表达式标注语料,全称 Temporal Histories of Your Medical Events。它从结肠癌和脑瘤两类肿瘤患者的电子病历出发,由人工标出了每份文书中的"发生了什么事(EVENT)"“什么时间(TIMEX3)”"事件相对文书完成时间在何时(DocTimeRel)"以及事件之间的先后、包含等时间关系(TLINK),共覆盖 1,254 份去标识病历、约 172,800 个标注单元。
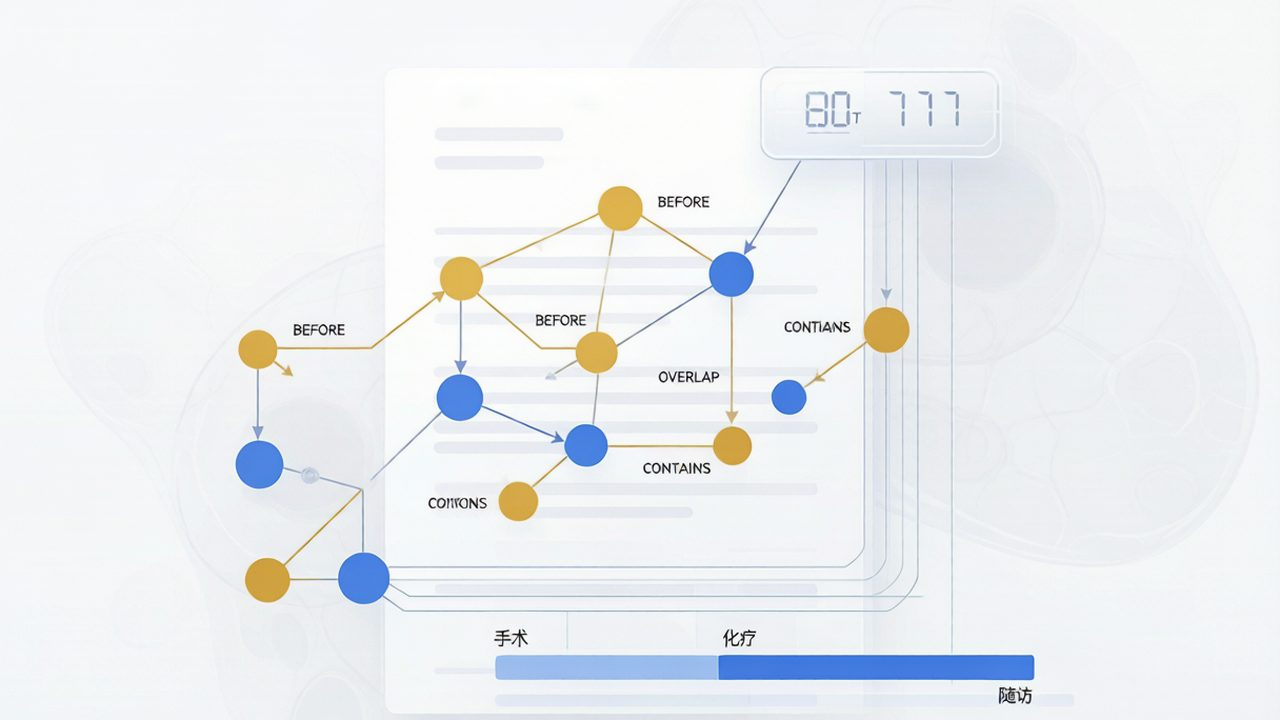
为什么重要? “患者先做了手术、然后化疗、目前正在随访”——这类时间线是肿瘤诊疗的核心叙事,但让机器读懂临床文本中的时间却极其困难:一个"周五"是相对于哪一天?"拟于下周期行化疗"是已经发生还是计划?THYME 为这些问题提供了第一个大规模、可评测的临床标注答案,并成为 SemEval-2015 Task 6 与 SemEval-2016/2017 Task 12(Clinical TempEval)的官方语料,把临床时间信息抽取变成了国际社区可比的基准任务。
我能用它做什么? 你可以在标注层(GitHub 公开的 Anafora XML)上训练和评测时间实体识别、事件属性分类、时间关系抽取与时间线构建模型;如果你的机构签署了 Mayo Clinic 的数据使用协议(DUA),还可以把标注对齐到原始病历正文上做端到端实验。它也常被用作医疗 NLP 课程与临床 NLP 系统工程化(如 cTAKES-Temporal)的教学与评测基础。
§1.1 摘要
THYME 语料由 Mayo Clinic NLP 团队(Guergana Savova 主持)与科罗拉多大学博尔德分校(Martha Palmer、James Pustejovsky、Steven Bethard 等)合作构建,NIH R01 LM010090 与 U54 LM008748 资助,成果发表于 TACL 2014(Styler IV et al., 2014)。语料在 ISO-TimeML 基础上提出临床扩展 THYME-TimeML:新增文档时间(DOCTIME)、章节时间(SECTIONTIME)两类锚点,引入叙事容器(narrative container)处理"入院期间"这类容器时间结构,并为事件定义 DocTimeRel、极性、程度、语境情态、语境体、永久性等 7 个属性。标注在 Anafora 工具中以 XML 完成,实体先行双标注加仲裁、关系再双标注加仲裁。语料按两个肿瘤学子集组织:结肠癌子集构成 Clinical TempEval(SemEval-2015 Task 6,train 293/test 147 文书)与 SemEval-2016 Task 12(test 151 文书)的评测数据,脑瘤子集 595 份来自 TempEval-3 临床任务语料。SemEval-2015 的结论是:事件与时间表达式识别已接近人类水平,而时间关系仍有巨大差距——这一"关系鸿沟"至今仍是临床时间推理研究的核心命题。
§1.2 战略价值
研究基础设施价值:在 THYME 之前,临床时间标注散落在 i2b2 2012 等单次任务中,缺少统一的标注哲学与可复用的指南。THYME-TimeML 提供了从语言学理论(ISO-TimeML)到临床文本落地的完整链条:指南公开(THYME Annotation Guidelines)、标注工具开源(Anafora)、标注层免费分发,使任何团队都能在统一语义框架下训练和比较模型。它是 cTAKES-Temporal 等临床 NLP 系统的时间组件的直接标定基准(JAMIA 2016)。
基准与评测价值:THYME 衍生出的 Clinical TempEval 系列是临床时间抽取迄今最系统的评测谱系:2015 年 9 个子任务、2016/2017 年延续迭代,形成了"事件/时间表达式接近人类、时间关系显著落后"的经典结论(Bethard et al., 2015)。对今天的 LLM 时代而言,THYME 的小规模、高密度、关系型标注恰好是评测大模型临床时间推理能力的稀缺资源:它不训练你"读病历",而是逼你回答"病历里的时间到底是谁先谁后"。
§1.3 同类数据集横向对比
| 数据集 | 规模 | 标注体系 | 与 THYME 的差异化 |
|---|---|---|---|
| THYME | 1,254 份病历;约 172,800 个标注单元 | THYME-TimeML(EVENT/TIMEX3/DOCTIME/SECTIONTIME + TLINK/ALINK + 叙事容器) | 肿瘤双域全覆盖,SemEval 官方语料,事件 7 属性最完整 |
| i2b2 2012 Temporal Challenge | 出院小结集合(规模见官方任务页) | 简化版 TimeML(由 THYME 指南简化而来) | 聚焦事件与相对时间归一化,无叙事容器结构 |
| TempEval-3 临床任务 | 595 份脑瘤文书(后并入 THYME) | TimeML 临床简化版 | THYME brain 子集的直接前身 |
| ChemoTimelines 共享任务(2024) | 化疗时间线构建任务语料 | 化疗周期/时间线标注 | 面向化疗周期归一化的下游应用,依赖 THYME 奠定的时间抽取基础 |
| MIMIC-III | 208 万篇临床文本 | 无时间关系金标准 | 与 THYME 互补:提供海量正文,THYME 提供高密度时间真值 |
| MedMentions | 约 5,000 篇摘要的 UMLS 实体链接 | 全类别实体链接 | 证明临床/生物医学实体链接与时间标注是两条互补的标注轴 |
§1.4 版本时间轴
| 时间 | 事件 | 说明 |
|---|---|---|
| 2013 | TempEval-3 临床任务语料构建 | THYME brain 子集(595 份)的前身语料 |
| 2014-05-13 | TACL Train Subset Release(v0.9.0+TACL-train) | 首批发布,仅结肠癌训练文书;同日补充 corpora readme 与 corpusinformation.txt |
| 2014 | TACL 论文发表 | Styler IV et al., TACL 2:143–154(Q14-1012) |
| 2014-07 | v1.0.0+coloncancer-train | 结肠癌训练集扩充 |
| 2014-11-07 | Train 目录定稿(v1.1.0+coloncancer-dev 同期) | 含时间、共指与 UMLS 标注 |
| 2014-12-24 | Dev 目录入库 | 全部结肠癌开发数据 |
| 2015-06 | SemEval-2015 Task 6 评测 | 3 支团队 13 个系统提交(S15-2136) |
| 2016-02-04 | Test 目录入库 | 补齐 Temporal schema 其余部分的测试数据 |
| 2016-06 | SemEval-2016 Task 12 评测 | test 151 文书(S16-1165) |
| 2017 | SemEval-2017 Task 12 | Clinical TempEval 第三届延续 |
| 2026-06-01 | README 更新获取入口 | 正文 DUA 经 Harvard hNLP Center 办理 |
§1.5 典型应用场景
- 临床时间信息抽取模型训练与评测:在 Anafora XML 标注层上训练事件/时间表达式识别器、DocTimeRel 分类器与 TLINK 分类器,用 SemEval 官方子任务协议评测。
- 大模型临床时间推理评测:把 THYME 的关系与属性标注改造成选择题/抽取式探针,评测 LLM 在肿瘤叙事上的时间理解与"叙事容器"类推理能力。
- 肿瘤治疗时间线构建:以"事件 + 时间表达式 + TLINK"三件套为原料,重建患者的手术—化疗—随访时间线,服务真实世界研究与 DeepPhe 类肿瘤表型系统。
- 临床 NLP 教学:标注指南、工具、数据三位一体公开,是"临床时间标注"专题最常用的课程语料;行尾符偏移、叙事容器等真实坑点本身就是绝佳的教学案例。
- 标注规范迁移研究:研究如何把 THYME-TimeML 协议迁移到其他机构、其他科室的病历上(如 i2b2 2012 语料的再标注)。
§2 医学背景
§2.1 ICD-11 编码映射
THYME 的两类肿瘤叙事对应以下 ICD-11 编码:
| ICD-11 编码 | 中文名称 | 英文名称 | 在 THYME 中的对应 |
|---|---|---|---|
| 2B90 | 结直肠恶性肿瘤 | Malignant neoplasms of colon or rectum | coloncancer 子集的临床、病理、放射文书 |
| 2A00 | 脑或中枢神经系统恶性肿瘤 | Malignant neoplasms of brain or central nervous system | braincancer 子集文书 |
§2.1b SNOMED CT 映射
| 概念 | SNOMED CT 编码 | ICD-11 对应 | 术语注释 |
|---|---|---|---|
| 结肠恶性肿瘤 | 363406005 | 2B90 | malignant neoplasm of colon,覆盖结肠癌手术、化疗叙事 |
| 脑恶性肿瘤 | 93747008 | 2A00 | malignant neoplastic disease of brain,覆盖脑瘤切除、放疗、随访叙事 |
需要强调的是:THYME 标注的是肿瘤叙事中的时间结构,而非肿瘤本身。上述编码帮助检索与互操作,但数据集的 AI 任务对象是事件与时间关系(见 §2.3)。
§2.2 疾病简介与流行病学
结肠癌是全球最常见的恶性肿瘤之一,其诊疗叙事以"手术—辅助化疗—随访复查"的长周期为特征:一份病历里往往同时出现确定性日期(“2023-04-12 行结肠切除术”)、相对时间(“术后两周开始 FOLFOX”)、周期性时间(“每两周一次,共 12 周期”)与假设性计划(“如病情进展,拟行二线治疗”)。这种高密度、多类型的时间表达使结肠癌病历成为时间信息抽取的理想试验床。
脑恶性肿瘤(以胶质瘤为代表的原发恶性脑肿瘤相对罕见但预后差)的叙事则以"影像随访—手术切除—放化疗—神经功能评估"的密集复查节奏为特征,放射与影像报告占比较高。THYME 的 brain 子集正来自这类文书的 TempEval-3 前身语料。两类疾病在叙事节奏与时间表达分布上的差异,恰好构成了跨域泛化研究的天然对照。
两类肿瘤叙事的时间表达特征对比:
| 维度 | 结肠癌叙事(coloncancer) | 脑瘤叙事(braincancer) |
|---|---|---|
| 典型治疗链 | 手术 → 辅助化疗(多周期) → 随访复查 | 活检/切除 → 放疗/替莫唑胺 → 影像随防 |
| 时间表达密度 | 高:周期性化疗时间(“every two weeks × 12 cycles”) | 中高:影像复查日期密集 |
| 放射报告占比 | 中 | 高(影像随防为核心) |
| 代表性难点表达 | “术后两周”、“如病情进展拟行二线”(假设性计划) | “interval improvement”、“post-radiation changes”(区间性描述) |
| 叙事容器典型 | “postoperative”、“adjuvant therapy” 容器 | “admission”、“treatment course” 容器 |
这一对比有直接的方法论含义:在 colon 子集上调好的 DocTimeRel 分类器迁移到 brain 子集时会遇到放射报告式的"区间性描述"(interval findings),其时间语义更依赖 SECTIONTIME/叙事容器锚点而非显式日期。
§2.3 临床任务定义
THYME 支持的核心 AI 任务是临床时间信息抽取,在 Clinical TempEval 中被拆为 9 个离散子任务(任务定义):
| 任务 | 输入 | 输出 | 临床示例 |
|---|---|---|---|
| TS:时间表达式识别 | 病历文本 | TIMEX3 span | “April 23, 2014”、“postoperative”、“Friday” |
| TA:时间表达式属性 | TIMEX3 span | type 与 value(DATE/TIME/DURATION/SET/PrePostExp/Quantifier) | “Friday” → DATE,值为当周周五 |
| ES:事件表达式识别 | 病历文本 | EVENT span | bleeding、resume chemotherapy、nausea |
| EA:事件属性 | EVENT span | type/polarity/degree/modality 等 7 属性 | bleeding:polarity=NEG;nausea:modality=HYPOTHETICAL |
| DR:DocTimeRel | EVENT span | 相对文档时间标签 | bleeding BEFORE docTime;resume AFTER docTime |
| TR:时间关系(TLINK) | 事件/时间对 | BEFORE/AFTER/OVERLAP/BEFORE_OVERLAP/VAGUE | resume 与 Friday 为 OVERLAP |
| CR:叙事容器 | 事件/容器对 | CONTAINS(narrative container) | “postoperative” 容器 CONTAINS bleeding |
DocTimeRel 取值为 BEFORE(发生在文书完成前)、AFTER(计划/预期)、OVERLAP(正在进行)、BEFORE_OVERLAP(开始于文书前并延续)。四个标签的临床语义:
| DocTimeRel | 语义 | 典型事件示例 |
|---|---|---|
| BEFORE | 事件完成于文书书写之前 | “colon resection on 2023-04-12”(既往手术) |
| AFTER | 事件计划/预期发生于文书之后 | “will resume chemotherapy with a larger bolus”(计划中的化疗) |
| OVERLAP | 事件在文书书写时正在进行 | “the patient is currently on FOLFOX”(进行中的化疗) |
| BEFORE-/-OVERLAP | 开始于文书之前并延续至书写时 | “has been experiencing nausea since discharge”(延续性症状) |
这些任务组合起来,即是"从病历文本重建肿瘤治疗时间线"的完整流程。值得注意的是官方任务示例(SemEval-2015 Task 6 页面)演示了一句典型病历句如何同时触发全部子任务:“April 23, 2014: The patient did not have any postoperative bleeding so we will resume chemotherapy…”——同一句中 bleeding 需标 NEG 极性与 BEFORE、resume chemotherapy 标 ASPECTUAL 类型与 AFTER、“Friday” 归一化为 DATE 值、postoperative 作为叙事容器 CONTAINS bleeding。这正是 THYME 标注密度的一个缩影。
§2.4 患者人群
| 维度 | 描述 |
|---|---|
| 来源机构 | Mayo Clinic(美国明尼苏达州罗切斯特) |
| 疾病人群 | 结肠癌患者与脑瘤患者(两类肿瘤学队列) |
| 文书类型 | 临床文书(_CLIN)、病理报告(_PATH)、放射报告(_RAD) |
| 语言 | 英语(美式临床文书风格) |
| 脱标识 | 按 Mayo Clinic 政策去标识;标注层不含任何患者信息 |
| 子集结构 | Clinical TempEval 子集为 200 患者 × 3 文书;brain 子集 595 份来自 TempEval-3 语料 |
§2.5 临床价值
肿瘤学的临床决策高度依赖时间线:复发风险随"无病生存时间"变化,辅助化疗必须在术后窗口期内启动,随访计划按时间节奏展开。自动时间线构建(事件抽取 + 时间归一化 + 关系推理)可以把散落在数百份文书中的治疗叙事压缩为结构化时间轴,支撑真实世界证据生成、临床试验合格性筛选与肿瘤登记自动化。THYME 为这条技术链的每一环都提供了人工标注的"真值",使其成为肿瘤 NLP 系统验收与回归测试的标准答案库。
在真实世界研究场景中,入组标准往往以时间谓词表达(“既往接受过 ≥2 线系统化疗”、“术后 6 个月内无复发”);将此类谓词自动匹配到病历时间线上,本质上是 DocTimeRel + TLINK 的组合推理,THYME 是验证该推理正确性的最小完备测试集。在肿瘤登记与质控场景中,登记员需从文书批量抽取"诊断日期、手术日期、放化疗开始日期"——THYME 的时间归一化任务(TIMEX3.value + DOCTIME)正是该流程的核心环节,其误差可被量化为登记时延与漏登率。
§2.6 金标准表
| 划分 | 标注方式 | 标注者 | 性质 |
|---|---|---|---|
| coloncancer/Train(2014-11-07 定稿) | 实体双标注 + 仲裁;关系双标注 + 仲裁 | 科罗拉多大学博尔德分校标注员与仲裁员;波士顿儿童医院/Harvard 参与 | gold.completed(Temporal-Relation) |
| coloncancer/Dev(2014-12-24 入库) | 同上,含时间、共指与 UMLS 实体标注 | 同上 | gold.completed |
| coloncancer/Test(2016-02-04 入库) | 同上,补齐 Temporal schema 其余部分 | 同上 | gold.completed |
| SemEval-2015/2016 官方划分 | 由上述语料切分:train 293 / test 147(2015)、test 151(2016) | 评测方(Bethard 等)持有 | 盲测集 |
| braincancer(TempEval-3 前身语料,595 份) | THYME-TimeML 协议再标注 | 同 THYME 团队 | gold.completed(_PATH 仅实体层) |
§3 数据集规格
§3.0 版本抉择矩阵
| 你的需求 | 推荐获取物 | 大小 | 理由 |
|---|---|---|---|
| 训练/评测时间抽取模型(无需原文) | GitHub 标注层全量 clone | 数千个 Anafora XML 单文件,数 KB 量级 | 标注层不含患者信息,免费即时获取;配合自备文本或合成文本 |
| 复现 SemEval-2015 结果 | 标注层 + SemEval-2015 官方划分(train 293/test 147) | 同上 | 划分与评分脚本按 2015 任务协议 |
| 复现 SemEval-2016/2017 结果 | 标注层 Test 目录(2016-02-04 版)+ 2016 任务协议 | 同上 | 2016 年 test 151 文书与 2015 年划分不同 |
| 端到端建模(需原文) | 标注层 + Mayo Clinic DUA(经 Harvard hNLP Center) | 正文按 DUA 分发 | 正文与标注层必须自行对齐,且接受 DUA 全部条款 |
| 标注协议研究/再标注 | THYME Annotation Guidelines PDF + Anafora 工具 | 文档级别 | 指南是 ISO-TimeML 临床扩展的权威文本 |
§3.1 模态详情
THYME 是纯文本语料,由三类肿瘤学文书组成:
- 临床文书(_CLIN):门诊与住院病程记录,是事件、时间表达式与关系标注的主要载体,叙事密度最高。
- 病理报告(_PATH):结构化程度高、时间表达稀疏。官方明确说明 _PATH 文书只做了实体层标注、未做关系层标注,且"标注中缺席关系不代表文书中不存在关系"(仓库 README)。
- 放射报告(_RAD):影像随防叙事,与 _CLIN 同样接受实体与关系的完整双标注。
所有文书正文保留 [start section id="..."] 章节标记,使模型可以按病历章节(病史、手术记录、出院计划等)结构化切分——章节锚点同时是 SECTIONTIME 标注的参照。
从时间标注视角看,三类文书构成三种不同的"标注生态":_CLIN 以叙事性段落为主,EVENT 密度高、DocTimeRel 层次丰富(既往手术、进行中治疗与未来计划常在同一段共存),是关系标注的主要收益区;_RAD 以"检查日期 + interval 所见"为骨架,事件稀疏但 SECTIONTIME 锚点的作用最突出;_PATH 结构化字段之间几乎没有显式时间连接词,这正是官方对其协议性省略关系标注的现实依据。使用者在设计领域自适应策略时,应把三类文书视为三种文本体裁,而非同一分布的三个抽样。
§3.2 按子集样本数
| 子集 | 文书数 | 来源与划分 | 标注层 |
|---|---|---|---|
| 结肠癌 train | 293 | SemEval-2015 Task 6 官方训练划分 | 实体 + 关系(gold.completed) |
| 结肠癌 test(2015) | 147 | SemEval-2015 官方测试划分 | 实体 + 关系 |
| 结肠癌 test(2016) | 151 | SemEval-2016 Task 12 官方测试划分 | 实体 + 关系 |
| 脑瘤子集 | 595 | TempEval-3 临床任务语料并入 | 实体 + 关系(_PATH 仅实体) |
| 总量 | 1,254 | TACL 2014 报告 | 约 172,800 个标注单元 |
注意:Li et al. 2020 对结肠癌子集的统计(train 147 / dev 147 / test 141 文书;3,833 TIMEX3 与 38,890 EVENT 等,见 arXiv:2005.02587)与官方 2015/2016 划分存在口径出入(其 dev/test 文书数为 147/141,官方为 147/151),使用其统计数字时应注明统计口径与版本。
两个子集共享同一份 THYME-TimeML 指南、同一套 Anafora 工具与同一发布通道,标注协议层面并无"双标体系";子集间差异主要来自叙事文体而非标注规则——这正是跨子集迁移研究的价值所在。同样需要说明:THYME 只覆盖结肠癌与脑瘤两类肿瘤叙事,不包含炎症性肠病(IBD)等其他消化系统疾病子集;若任务涉及 IBD 叙事,应基于 THYME 指南另行组织标注,而非从现有数据迁移。
两子集的代表性时间表达与标注决策(示意性重构,非逐字摘录):
| 子集 | 代表性叙事片段 | 触发的标注决策 |
|---|---|---|
| colon | “术后两周开始辅助化疗,每两周一次,共 12 周期” | DURATION(术后两周)+ SET(周期性化疗)+ DocTimeRel=AFTER(计划中的启动) |
| colon | “如病情进展,拟行二线治疗” | ContextualModality=HYPOTHETICAL + DocTimeRel=AFTER |
| brain | “interval improvement of the residual lesion” | 无显式日期,区间语义锚定 SECTIONTIME/容器而非 DCT |
| brain | 术后/放疗后类前後缀表达 | 与 PrePostExp 类时间表达融合,事件依赖容器定位 |
§3.3 数据格式
| 格式 | 载体 | 说明 |
|---|---|---|
| Anafora XML | doc####_CLIN.Temporal-Relation.gold.completed.xml 等 |
每份文书一组 XML;只含 span 偏移、类型与属性,不含原文 |
| 纯文本 | doc0002_CLIN 等无扩展名文本文件 |
原文(经 DUA 获取);XML 必须与其配套文本按偏移量对齐 |
| 附加层 | *.Coreference.gold.completed.xml、*.UMLS-Entity.gold.completed.xml |
共指与 UMLS 语义类型标注,仅覆盖部分结肠癌文书 |
Anafora XML 的典型结构(示意,按 Anafora 通用格式)——每个标注是一个 <entity> 节点,偏移、类型与属性平铺:
<annotations>
  <entity>
    <id>E23</id>
    <span>1203,1215</span>
    <type>EVENT</type>
    <properties>
      <DocTimeRel>BEFORE</DocTimeRel>
      <Polarity>NEG</Polarity>
      <ContextualModality>ACTUAL</ContextualModality>
      <Degree>N/A</Degree>
    </properties>
  </entity>
  <entity>
    <id>T5</id>
    <span>1190,1203</span>
    <type>TIMEX3</type>
    <properties>
      <type>DATE</type>
      <value>2014-04-23</value>
    </properties>
  </entity>
  <entity>
    <id>TLINK1</id>
    <span/>
    <type>TLINK</type>
    <properties>
      <Source>E23</Source>
      <Target>T5</Target>
      <RelType>OVERLAP</RelType>
    </properties>
  </entity>
</annotations>
要点:<span> 以逗号分隔起止偏移(可含多段);TLINK 等关系节点的 span 为空,实体引用走 <Source>/<Target> 属性;<value> 是 TimeML 值串(相对表达可解析时填写)。
§3.4 存储大小
官方未发布统一的总体积数字:标注层由数千个小型 Anafora XML 文件构成(单文件通常在数 KB 量级,取决于文书长度与标注密度),通过 GitHub 仓库分发;文书正文层按 DUA 单独分发。需要存储规划时,建议 clone 标注层后以 git count-objects -vH 实测;正文体积则需在 DUA 流程中向分发方确认。
工程上值得注意的反差是:语料的逻辑规模(约 172,800 个标注单元)与物理体积(数 KB 级文件 × 数千)都远小于通用语料,但工程复杂度集中在文件数量与偏移对齐上——数千个小文件的遍历、配对与指纹校验才是存储与 IO 设计的主要对象,建议按文书编号建立清单索引而非逐目录扫描。
§3.5 标注方式
两阶段人工标注,均以"双人独立标注 + 仲裁(adjudication)"完成(仓库 README):
- 第一阶段(实体):_CLIN 与 _RAD 文书由两名标注员独立标注 EVENT、TIMEX3、DOCTIME、SECTIONTIME,仲裁后产出
Temporal-Entity.gold.completed.xml。 - 第二阶段(关系):在金标准实体之上,再由双人独立标注 TLINK 与 ALINK,仲裁后产出
Temporal-Relation.gold.completed.xml。 - 例外:_PATH 文书因时间表达稀疏,跳过第二阶段,只有实体层金标准。
标注层 × 文书类型覆盖矩阵(任务规划速查):
| 标注层 | _CLIN | _RAD | _PATH |
|---|---|---|---|
| Temporal-Entity(实体) | ✅ 双标 + 仲裁 | ✅ 双标 + 仲裁 | ✅ 双标 + 仲裁 |
| Temporal-Relation(关系) | ✅ 双标 + 仲裁 | ✅ 双标 + 仲裁 | ❌ 协议性省略 |
| Coreference(共指) | 部分(结肠癌子集) | 稀少 | 稀少 |
| UMLS-Entity(语义类型) | 部分(结肠癌子集) | 部分 | 部分 |
此外,部分结肠癌文书带有共指标注(anaphora 与 SET/SUBSET、PART/WHOLE 等桥接关系)与 UMLS 命名实体标注(如 hemicolectomy 标为 procedure、fever 标为 sign/symptom),覆盖范围以仓库实际文件清单为准。
标注规范细节:事件(EVENT)的 7 属性体系。THYME-TimeML 把 EVENT 定义为"与患者时间线相关的临床事件或状态"(处置、发现、症状、检查等),以句法中心词为 span 单位。每个事件除 span 外携带 7 个属性(THYME Annotation Guidelines):
| 属性 | 取值 | 语义要点 |
|---|---|---|
| DocTimeRel | BEFORE / OVERLAP / AFTER / BEFORE-OVERLAP | 事件相对文档创建时间(DCT)的位置;BEFORE-OVERLAP 表示始于 DCT 之前并延续至书写时 |
| type | N/A / ASPECTUAL / EVIDENTIAL | ASPECTUAL 标记体态复合事件(如"开始化疗"的"开始"),EVIDENTIAL 标记转述/引证事件 |
| polarity | POS / NEG | 否定事件(“无出血”)标 NEG |
| degree | N/A / MOST / LITTLE | 程度修饰(轻症/重症) |
| ContextualModality | ACTUAL / HEDGED / HYPOTHETICAL / GENERIC | 区分已发生事实、疑似、计划/假设与泛指(随访计划、家族史、鉴别诊断) |
| ContextualAspect | N/A / NOVEL / INTERMITTENT | 体态视角:新发事件与间歇性事件(如间歇性恶心) |
| Permanence | FINITE / PERMANENT / UNDETERMINED | 指南定义了急性-慢性式的区分;据二次文献转述,实际发布数据未系统填充该属性 |
作为参照,TimeML 原版(新闻域)的事件类别为 OCCURRENCE、PERCEPTION、REPORTING、ASPECTUAL、STATE、I_ACTION、I_STATE 七类;THYME 把事件类型收敛为上述三个取值,而把语言学的时体信息转移给 DocTimeRel 与语境属性——这是"ISO-TimeML 临床化"最直接的体现。
标注规范细节:时间表达式(TIMEX3)。TIMEX3 类别共六类:DATE、TIME、DURATION、SET(周期集合,如按周期展开的化疗计划),以及 THYME 新增的两类——PrePostExp(术前/术后/术中等与隐式事件绑定的区间表达,如 postoperative)与 Quantifier(非日期型的数量/频次限定表达)。可归一化的表达式在 value 属性中填写 TimeML 值串:完全日期用 ISO 8601 风格、未知部分以 X 占位(部分日期)、时长用 P 前缀周期串;无法归一化的相对表达允许 value 缺省,交由下游结合 DOCTIME 与叙事容器推断——这正是 §4.1 中"value 相对表达需 DCT"观测误差的协议来源。
标注规范细节:文档时间与章节时间。与 TimeBank 用 functionInDocument 属性标记文档创建时间的做法不同,THYME 把时间锚提升为独立实体:DOCTIME 对应文书完成时点(每份文书必有),SECTIONTIME 对应章节级时间锚(放射报告中的检查日期即典型 SECTIONTIME)。这一设计直接服务于病历"多节拼合、多次更新"的文档结构,也是三类文书标注生态差异(§3.1)的结构性根源。
标注规范细节:叙事容器(narrative container)。叙事容器是 THYME-TimeML 最具临床特色的结构:一个容器实体(如 postoperative、adjuvant therapy,或由事件充当的锚)把发生在其内部的事件组织起来,使"术后出血"无需逐一挂到具体日期。指南规定容器可从 DocTimeRel 推导(如 BEFORE 类事件默认落入既往容器),也可额外标注;允许单边界容器与嵌套容器,锚点可由事件或时间表达式充当。关系层面,容器语义以 TYPE=CONTAINS 的 TLINK 表达,SemEval-2016 的官方统计即以此为口径。
标注规范细节:TLINK 与 ALINK。指南把 TLINK 收敛为五个子类型:BEFORE、CONTAINS、OVERLAP、BEGINS-ON、ENDS-ON——与 TimeML 原版相比,排除了低频的同时性关系与可由方向性推断的反向关系(如 AFTER)。标注纪律由指南显式给出,要点如下:
- TLINK 仅在提供 DocTimeRel 之外的信息时才标(避免冗余标注);
- 事件应尽可能与其叙事容器建立 CONTAINS 关系;
- 文中显式陈述的时间关系必须标注;
- 优先在同句内连接事件与时间表达式;
- ACTUAL/HEDGED 事件不得与 HYPOTHETICAL/GENERIC 事件互连(假设与事实之间不建时间关系);
- TIMEX3 之间不需要互连;
- 关系类型以点代数(point algebra)形式化,保证语义可组合。
ALINK 承担体态语义:连接事件与其体态复合体(如 INITIATES 连接"开始"与其后的化疗事件),是推理"治疗何时启动/持续"的辅助层,也是 THYME 相对 i2b2 2012 协议多出的部分(后者移除了 ALINK)。
§3.6 标注者资质与一致性
标注由科罗拉多大学博尔德分校计算语义学组的受训标注员与仲裁员完成,波士顿儿童医院(Harvard 附属)团队参与部分标注,全程遵循公开的 THYME Annotation Guidelines。语料未随 README 公布逐文件的一致性系数;使用者关心标注质量时,可基于 train 子集的双标注残档自行估计,或参考 TACL 论文中的协议描述(Q14-1012)。
两阶段设计的工程含义值得强调:关系层标注以实体金标准为前提,关系标注者面对的是统一的实体边界,这使实体分歧不会被带入关系层放大;SemEval 的两阶段评测(先开放抽取、后以金标准实体评关系,见 §8.3)正是对这一流程的镜像复刻。仲裁环节产出 gold.completed 文件,未仲裁残档保留在仓库历史中,为一致性估计提供了原料。
§3.7 采集周期
语料为回顾性去标识病历收集:brain 子集源自 TempEval-3 临床任务语料(2013 年前后构建),colon 子集由 THYME 项目团队于 2012-2014 年间标注并自 2014-05 起分阶段发布。官方未随发布公布病历的原始书写年份窗口;确需此信息(例如做时间外推评估)时,应在 DUA 流程中向 Mayo Clinic 查询。
§3.8 地域覆盖
全部文书来自美国明尼苏达州罗切斯特的 Mayo Clinic——一家服务大量外地与国际患者的三级转诊中心。文书反映美国三级医疗中心的肿瘤诊疗书写规范(如 SOAP 结构化病程、模板化病理与放射报告),不能代表基层医疗或非美式书写风格。
§3.9 文本规格
- 编码:纯文本(无扩展名文件),保留原始换行与章节标记
[start section id="..."]。 - 偏移敏感性:XML 标注以字符偏移定位,任何对文本的改动(包括 Windows 行尾符 CRLF/Unix LF 转换)都会使全部偏移失效——这是仓库 README 点名的最常见错误(详见坑点 4)。
- 解压建议:Windows 用户使用 7-zip,并在 *nix 环境中处理文本,避免行尾符被改写。
- 章节标记即结构:
[start section id="..."]既保留了病历的章节语义(病史、手术记录、出院总结等),又是 SECTIONTIME 标注的锚定参照;任何预处理都不应移除它们,除非同步维护偏移映射表。 - 合并词与缩写:临床文书中常见的合并词、剂量与单位缩写按原样保留于文本中,标注层不做正则化;归一化(如单位换算、日期展开)是下游任务而非语料的职责。
§3.10 深度溯源链
Mayo Clinic 电子病历系统 → 按 ICD 诊断抽取结肠癌/脑瘤患者文书 → Mayo Clinic 政策去标识 → THYME 项目组(CU Boulder + Boston Children’s/Harvard)按 THYME-TimeML 指南在 Anafora 中双标注 + 仲裁 → gold.completed XML 分阶段发布至 GitHub(2014-2016)→ 2026-06 起正文访问统一经 Harvard hNLP Center DUA 流程。资助链条:NIH R01 LM010090、U54 LM008748。
§4 数据结构
§4.0 目录树
数据获取后的组织结构如下(依据 GitHub 仓库 2026-09 快照):
thymedata/
├── README.md                          # 分发模式、DUA 入口、格式说明、行尾符警告
├── braincancer/                       # 脑瘤子集(595 份,TempEval-3 前身语料)
│   ├── readme
│   └── doc####_{CLIN|PATH|RAD}...     # 按文书编号组织的 Anafora XML
│       ├── doc0002_CLIN.Temporal-Entity.gold.completed.xml
│       └── doc0002_CLIN.Temporal-Relation.gold.completed.xml
└── coloncancer/
    ├── corpusinformation.txt          # 语料信息(2014-05-13)
    ├── Train/                         # 2014-11-07 定稿:时间 + 共指 + UMLS 标注
    ├── Dev/                           # 2014-12-24 入库:全部开发数据
    └── Test/                          # 2016-02-04 入库:补齐 Temporal schema
文件命名规律:[文书编号]_[文书类型].[标注层].gold.completed.xml。文书类型 ∈ {CLIN, PATH, RAD};标注层 ∈ {Temporal-Entity, Temporal-Relation, Coreference, UMLS-Entity};只有 gold.completed 后缀的文件才是仲裁后的金标准。
一份文书对应的典型文件组:
| 文件 | 内容 | 存在条件 |
|---|---|---|
doc0002_CLIN |
文书原文(纯文本,经 DUA) | 仅正文分发 |
doc0002_CLIN.Temporal-Entity.gold.completed.xml |
实体层金标准 | 全部文书 |
doc0002_CLIN.Temporal-Relation.gold.completed.xml |
关系层金标准 | _CLIN/_RAD |
doc0002_CLIN.Coreference.gold.completed.xml |
共指层金标准 | 部分结肠癌文书 |
doc0002_CLIN.UMLS-Entity.gold.completed.xml |
UMLS 语义类型层 | 部分文书 |
§4.1 DAIMS 字段字典
| 字段 | 类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 信息性缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
| 文书编号(doc####) | 字符串 | 同一编号配套一组 XML 与一份原文 | doc0002 | 分组、防泄漏 | 无 | 无 | 数值编号 |
| 文书类型后缀 | 枚举 | CLIN/PATH/RAD | _CLIN | 任务过滤(PATH 无关系) | 无 | 无 | CLIN, PATH, RAD |
| annotation id | 字符串 | Anafora 内唯一 ID | E23, T5 | 实体索引 | 无 | 无 | 字母+序号 |
| spans | 偏移对 | 字符偏移区间,可多段 | 1203-1215 | 定位实体 | 行尾符错位(坑点 4) | 无 | 文本长度内 |
| EVENT.type | 枚举 | 事件类型 | ASPECTUAL | 事件分类 | 无 | N/A | N/A, ASPECTUAL, EVIDENTIAL |
| EVENT.Polarity | 枚举 | 极性 | NEG | 否定检测 | 无 | N/A | POS, NEG |
| EVENT.DocTimeRel | 枚举 | 相对文档时间 | BEFORE | 时间属性分类 | 与 TLINK 混淆(坑点 5) | 无 | BEFORE, AFTER, OVERLAP, BEFORE-/-OVERLAP |
| EVENT.ContextualModality | 枚举 | 语境情态 | HYPOTHETICAL | 计划/假设识别 | 模糊边界 | 无 | ACTUAL, HEDGED, HYPOTHETICAL, GENERIC |
| EVENT.degree / aspect / permanence | 枚举 | 程度/语境体/永久性 | MOST | 细粒度属性 | 低频值稀少 | N/A | MOST, LITTLE; PERMANENT, TRANSIENT 等 |
| TIMEX3.type | 枚举 | 时间表达式类型 | DATE | 时间归一化前置 | 无 | 无 | DATE, TIME, DURATION, SET, PrePostExp, Quantifier |
| TIMEX3.value | 字符串 | TimeML 值串(可解析处) | 2014-04-25 | 时间归一化 | 相对表达需 DCT | 无 | ISO 8601 风格/相对 |
| TLINK.relType | 枚举 | 时间关系 | CONTAINS | 关系抽取 | 类不均衡(坑点 2) | VAGUE 兜底 | BEFORE, AFTER, OVERLAP, BEFORE_OVERLAP, VAGUE |
| ALINK | 关系 | 体态关系(启动/持续等) | INITIATES | 体态推理 | 低频 | 无 | Aspectual 关系类型 |
| SECTIONTIME | 锚点 | 章节级时间锚 | [start section id] 内 | 章节时间锚定 | 无 | 无 | 与 DOCTIME 同标签体系 |
| DOCTIME | 锚点 | 文书完成时间 | 文书日期行 | DocTimeRel 参照 | 无 | 无 | DATE 值 |
§4.2 标签分布
关系类分布是本语料最重要的统计事实(SemEval-2016 统计,S16-1165):TLINK 中 CONTAINS 约占 64%,BEFORE 约 13%,其余(AFTER、OVERLAP、BEFORE_OVERLAP、VAGUE)合计约两成。
| 标签组 | 分布事实 | 建模含义 |
|---|---|---|
| TLINK:CONTAINS | 约 64% | 多数类;叙事容器语义占主导 |
| TLINK:BEFORE | 约 13% | 次多数;事件先后链 |
| TLINK:AFTER / OVERLAP / BEFORE_OVERLAP / VAGUE | 合计约两成 | 少数类;宏 F1 的主要决定者 |
| EVENT.Polarity | POS 占绝对多数 | NEG 集中于"无XX"类否证句 |
| EVENT.ContextualModality | ACTUAL 占多数 | HYPOTHETICAL/HEDGED 集中于计划与鉴别诊断段 |
事件属性层面,Li et al. 2020 给出的结肠癌子集标注计数:
| 划分 | 文书数 | TIMEX3 | EVENT | 关系 |
|---|---|---|---|---|
| train | 147 | 3,833 | 38,890 | 11,150 |
| dev | 147 | 2,078 | 20,974 | 6,163 |
| test | 141 | 1,952 | 18,990 | 5,894 |
(口径注意:该统计的 dev/test 文书数 147/141 与 SemEval 官方 147/151 不同,见 §3.2。)
读表提示:SemEval-2016 任务论文(S16-1165)的官方表 1 单独统计 TYPE=CONTAINS 的叙事容器关系(train 11,176 / dev 6,173 / test 5,894 条),与上表 Li et al. 的"关系"计数(11,150/6,163/5,894)数字接近但口径与快照不同——前者限定 CONTAINS 型 TLINK,后者为关系层计数。两组数字连同文书数口径(293/147/151 vs 147/147/141)一并构成"引用统计必须注明出处与快照版本"的典型案例。
§4.3 关键统计
- 总标注单元约 172,800(TACL 2014)。
- Clinical TempEval 2015:9 个子任务、3 支团队、13 个系统提交。
- SemEval-2015 Task 6 任务论文被引 212+(Google Scholar,截至 2026-09)。
- _PATH 文书(病理报告)在实体层有金标准、在关系层为空——这不是缺失,而是协议设计。
§4.4 数据层级
患者 → 文书(_CLIN/_PATH/_RAD)→ 章节([start section id])→ 句子 → 标注单元(EVENT/TIMEX3/DOCTIME/SECTIONTIME)→ 关系(TLINK/ALINK,连接实体对)。 Clinical TempEval 子集的层级为"患者 × 3 文书"(200 名患者,每人临床/病理/放射文书各一),这使跨文书叙事推理成为可能,也埋下患者级泄漏风险(§5.3、坑点 3)。
层级结构对建模的直接约束有三条。其一,关系不跨层级"继承":文书中未标注的关系不能从患者层或其他文书推断补齐(_PATH 的协议性缺失即为例证,见坑点 1)。其二,容器聚合发生在文书内部:叙事容器与 CONTAINS 边都以单份文书为作用域,跨文书的时间线拼接(如把手术文书与随访文书连成一条治疗轴)没有金标准覆盖,属于开放问题。其三,章节层是 SECTIONTIME 的作用域:同一文书中不同章节可锚定不同的章节时间,实体到时间锚的归属应以所在章节为准,而非全文统一到 DCT。
§4.5 缺失值与信息性缺失
| 现象 | 语义 | 处理建议 |
|---|---|---|
_PATH 无 Temporal-Relation 文件 |
协议性缺失(未标注),非"无关系" | 关系评测时排除 _PATH 或单列汇报 |
| TLINK.relType=VAGUE | 信息性标签:关系无法判定 | 按 SemEval 协议计入或排除需明确 |
| EVENT.degree=N/A 等 | 属性不适用 | 区分"不适用"与"未标注" |
| Coreference/UMLS 层文件缺席 | 子集覆盖,非全量 | 构建训练集时以文件清单为准 |
| TIMEX3.value 为相对表达 | TimeML 值串可能非绝对日期 | 归一化需结合 DOCTIME 与叙事容器(坑点 14 关联项) |
| 叙事容器成员关系未闭合 | 容器-成员由 CONTAINS 逐对标注 | 构建时间线时按容器实体聚合而非假设闭包 |
§5 划分与使用建议
§5.1 官方划分
- SemEval-2015 Task 6:结肠癌 train 293 / test 147 份文书(S15-2136)。
- SemEval-2016 Task 12:test 151 份文书(与 2015 年测试集不同)(S16-1165)。
- TACL 版本:GitHub 仓库 Train/Dev/Test 目录(2014-11、2014-12、2016-02 分批定稿)。
§5.2 社区惯例
学术复现多直接采用 SemEval 划分与官方评分器;工程探索(如 DoT/双仿射解析器一类的关系建模研究)常把 Train+Dev 合并重新切分,但必须汇报切分口径。Li et al. 2020 的统计即采用自定义口径(train 147/dev 147/test 141 文书),与官方数字不可混用。
使用 SemEval 官方划分时的三条操作纪律:
- 2015 年划分(293/147)与 2016 年测试集(151)不是同一批测试文书,复现哪年就用哪年的划分与评分器,不得拼接。
- 官方测试集的标注不包含在仓库早期 release 中(Test 目录 2016-02-04 才入库),引用早期快照的论文使用的可能是其自建划分。
- 训练时若使用 dev 早停,dev 必须从 train 内部再切出(官方未设 dev),不得动用官方 test 做任何选型。
另一个与划分相关的设计细节是 SemEval 的两阶段评测(详见 §8.3):关系子任务在第二阶段以金标准实体为输入、只评 recall(等价于 accuracy)。自建划分做端到端实验时,应把"金标准实体输入"与"系统实体输出"两种关系评测设定分开汇报,否则与官方数字不可比。
§5.3 划分策略建议与泄漏风险
最大风险是患者级泄漏:Clinical TempEval 子集中同一患者的 3 份文书(临床/病理/放射)共享同一条治疗叙事,若按文书随机切分,测试文书的事件与时间表达会以近乎复述的形式出现在训练集。建议:
- 拿到正文/元数据后一律按患者分组切分(GroupShuffleSplit 或 GroupKFold)。
- 仅有标注层(无患者 ID)时,可依赖文书编号的连续性近似分组,并在论文中声明局限。
- 叙事容器与 TLINK 评测时,禁止把同一文书的关系对拆到训练与测试两侧(关系级泄漏)。
划分粒度还影响指标的解释:按文书切分时,官方两阶段协议下的关系分数反映"给定金标准实体"的分类能力;按患者重切分后的端到端分数则同时包含实体误差,两类数字不可混排在同一表格里。建议在实验记录中固定"划分粒度 + 实体输入来源 + 评分口径"三元组,作为每个结果行的元数据。
§5.4 交叉验证建议
若自建划分,推荐患者级 5 折交叉验证,每折内保持 _CLIN/_RAD 完整标注、_PATH 仅实体层的结构;关系任务用"文书级折叠"而非"关系对级折叠"。
§5.5 外部验证建议
在 THYME 上训练的模型应在外部语料上验证跨机构/跨域泛化:i2b2 2012 时间任务语料(同机构不同年份、不同任务协议)、非肿瘤科室病历(注意 THYME-TimeML 标签需映射回 ISO-TimeML),以及 MIMIC-III 等公开临床文本生态中自建小规模金标准。跨语言场景(中文病历)需要重新设计 TIMEX3 类型体系(如中文相对时间表达),不可直接套用。
§6 AI 就绪指南
§6.0 云端快速启动
标注层无需申请即可在任意云端环境获取:
git clone https://github.com/stylerw/thymedata.git && ls thymedata
pip install anafora
注意在 Linux/macOS 环境操作;Windows 用户先阅读坑点 4(行尾符)。
§6.1 快速上手
目录结构预期:clone 后在 thymedata/coloncancer/Train/ 下存在形如 doc####_CLIN.Temporal-Relation.gold.completed.xml 的标注文件;本仓库只有标注 XML,不含原文,因此解析结果是与文本解耦的"偏移量 + 标签"。最小可用子集:任选一个 Temporal-Entity.gold.completed.xml 即可完成实体读取;关系读取需同名 Temporal-Relation 文件。
import anafora, glob

# 预期目录:thymedata/coloncancer/Train/ 下的 gold.completed XML
# data_root = "thymedata"(仓库根目录);标注与文本分离,此处仅读标注
paths = glob.glob("thymedata/coloncancer/Train/*_CLIN.Temporal-Entity.gold.completed.xml")
data = anafora.AnaforaData.from_file(paths[0])

for ann in data.annotations:
    if ann.type == "EVENT":                      # 事件标注
        print(ann.id, ann.spans, ann.properties)  # spans 为 (start, end) 偏移对
    elif ann.type == "TIMEX3":                   # 时间表达式
        print(ann.id, ann.spans, ann.properties.get("type"))
若需与原文对齐(DUA 获取正文后),必须保证文本文件未被任何编辑器/传输过程改动(见坑点 4),然后以 text[start:end] 切片校验。
§6.2 数据获取
| 途径 | 内容 | 前置条件 |
|---|---|---|
| GitHub clone | 标注层(Anafora XML,无患者信息)、共指与 UMLS 子集 | 无 |
| DUA 正文 | 原始病历文本(_CLIN/_PATH/_RAD) | 与 Mayo Clinic 签署 DUA;2026-06 起经 Harvard hNLP Center 办理:加入 hNLP Center → 签署 DUA → 承诺加密存储/禁再识别/禁再分发 → 获取正文 → 成果中致谢 Mayo Clinic 并引用 Styler et al. 2014 |
标注层三个子目录(Train/Dev/Test)分批定稿于 2014-2016 年,clone 时已包含全部历史版本;正文获取周期取决于 DUA 审批,规划实验排期时应预留审批时间。
§6.3 预处理全流程
流程:XML 解析 → 偏移量展开为实体 → 实体/关系表扁平化 → 与文本对齐(如有)→ 导出统一 JSON。
import anafora, json, glob
from pathlib import Path

DATA_ROOT = Path("thymedata/coloncancer/Train")  # data_root 拼接:仓库根/子集/划分
records = []

for xml_path in glob.glob(str(DATA_ROOT / "*_CLIN.Temporal-Relation.gold.completed.xml")):
    doc_id = Path(xml_path).name.split(".")[0]           # doc0002_CLIN
    data = anafora.AnaforaData.from_file(xml_path)
    ents, rels = {}, []
    for ann in data.annotations:
        if ann.type in {"EVENT", "TIMEX3", "DOCTIME", "SECTIONTIME"}:
            ents[ann.id] = {
                "id": ann.id, "type": ann.type,
                "start": ann.spans[0][0], "end": ann.spans[0][1],
                "props": {k: v for k, v in ann.properties.items()},
            }
        elif ann.type == "TLINK":
            src = ann.properties.get("Source"); tgt = ann.properties.get("Target")
            rels.append({"doc": doc_id, "source": src, "target": tgt,
                         "relType": ann.properties.get("RelType")})
    records.append({"doc": doc_id, "entities": list(ents.values()), "relations": rels})

with open("thyme_flat.json", "w") as f:
    json.dump(records, f, ensure_ascii=False, indent=1)
清洗要点:(1) 校验每个 span 落在文本长度内(对齐正文后做 text[start:end] 非空断言);(2) 多段 span(ann.spans 长度 >1)按协议保留首段或展开为多实体,需全程一致;(3) 章节标记 [start section id="..."] 保留为特殊 token,可作为 SECTIONTIME 锚;(4) 属性 N/A 与缺键区分存档。
DUA 获取正文后的偏移量对齐校验(坑点 4 的工程化落地):
import hashlib, json

def verify_alignment(flat_json, texts_dir, sample=50):
    """抽样校验 span 切片非空;指纹校验文本未被改动。任何断言失败都应停线。"""
    docs = json.load(open(flat_json))
    for d in docs[:sample]:
        raw = open(f"{texts_dir}/{d['doc']}", "rb").read()
        fp = hashlib.sha256(raw).hexdigest()            # 记录指纹入库,供 CI 比对
        text = raw.decode("utf-8")
        for e in d["entities"]:
            frag = text[e["start"]:e["end"]]
            assert frag.strip(), f"{d['doc']} span 为空:{e}"   # 偏移漂移的信号
        print(d["doc"], fp[:12])
叙事容器与时间锚的展平注意:容器语义以 TYPE=CONTAINS 的 TLINK 存储于关系层,容器锚本身也可能是实体层中的事件或 TIMEX3,因此展平后不要假设容器形成闭包(§4.5),时间线聚合应以显式 CONTAINS 边为准。DOCTIME 与 SECTIONTIME 是无 value 归一化负担的锚实体,可直接作为时间轴的锚点节点;SECTIONTIME 与其所属章节标记 [start section id="..."] 的对应关系需在展平时一并保留。
§6.4 PyTorch DataLoader
以"事件属性分类(DocTimeRel)+ TLINK 分类"双任务为例的完整可运行骨架:
import json, torch
from torch.utils.data import Dataset, DataLoader
from transformers import AutoTokenizer, AutoModel

LABELS_DR = {"BEFORE": 0, "AFTER": 1, "OVERLAP": 2, "BEFORE-/-OVERLAP": 3}
LABELS_TL = {"BEFORE": 0, "AFTER": 1, "OVERLAP": 2, "BEFORE_OVERLAP": 3, "VAGUE": 4}

class ThymeDataset(Dataset):
    """thyme_flat.json 由 §6.3 生成;每个样本 = 实体 span 或实体对。

    目录预期:当前工作目录下存在 thyme_flat.json 与(DUA 获取的)原文目录 texts/,
    data_root 拼接关系:texts/{doc_id} 为该文书纯文本,与 XML 偏移量对齐。
    """
    def __init__(self, path, texts_dir, tokenizer, max_len=512):
        self.docs = json.load(open(path))
        self.texts = {d["doc"]: open(f"{texts_dir}/{d['doc']}", encoding="utf-8").read()
                      for d in self.docs}
        self.tokenizer, self.max_len = tokenizer, max_len

    def __len__(self):
        return sum(len(d["relations"]) + len(d["entities"]) for d in self.docs)

    def __getitem__(self, idx):
        for d in self.docs:
            for e in d["entities"]:                       # 任务 A:DocTimeRel
                if e["type"] == "EVENT" and idx == 0:
                    enc = self.tokenizer(self.texts[d["doc"]], truncation=True,
                                         max_length=self.max_len, return_offsets_mapping=True)
                    return {"input_ids": torch.tensor(enc["input_ids"]),
                            "spans": torch.tensor([e["start"], e["end"]]),
                            "label": torch.tensor(LABELS_DR.get(e["props"].get("DocTimeRel"), 3)),
                            "task": "docTimerel"}
            for r in d["relations"]:                      # 任务 B:TLINK 分类
                if idx == 0:
                    return {"doc": d["doc"], "pair": (r["source"], r["target"]),
                            "label": torch.tensor(LABELS_TL.get(r["relType"], 4)),
                            "task": "tlink"}
            idx -= len(d["relations"]) + len(d["entities"])
        raise IndexError

tokenizer = AutoTokenizer.from_pretrained("emilyalsentzer/Bio_ClinicalBERT")
encoder = AutoModel.from_pretrained("emilyalsentzer/Bio_ClinicalBERT")
train_ds = ThymeDataset("thyme_flat.json", "texts", tokenizer)
train_dl = DataLoader(train_ds, batch_size=8, shuffle=True, num_workers=2)
说明:生产实现应预计算实体对嵌入(span-pooling)而非示例中的简化索引逻辑;无 DUA 时可仅以标注层做关系结构预训练,正文上线后再微调。
§6.5 坑点(8 个)
⚠️ 坑点 1:_PATH 病历没有关系标注——“文件缺席"不等于"没有关系”(分类:标签理解)
问题:病理报告(_PATH)只有
Temporal-Entity.gold.completed.xml,没有Temporal-Relation文件。把"无文件"当作"无关系标签(全负例)"训练或评测,会系统性地污染关系模型。
症状:关系模型在含 _PATH 的测试集上 F1 异常偏低;或把病理文书全部当作 TLINK 负例后,模型对病理文书的任何关系预测都被压成 VAGUE。
解决:
- 简单方法:构建关系任务数据时,用文件清单过滤——只保留存在同名
Temporal-Relation.gold.completed.xml的文书。- 进阶方法:实体任务与关系任务分开建集:实体训练集可含 _PATH,关系训练集排除 _PATH;评测报告分列
_CLIN/_RAD与_PATH。- SOTA 方法:把 _PATH 作为关系模型的零样本/迁移评测域,报告"实体可用、关系未标"的开放世界设定,并在论文中引用官方声明"缺席不等于不存在"。
参考:thymedata README(Pathology notes 一节)
⚠️ 坑点 2:TLINK 类别极端不均衡——64% 的 CONTAINS 会吃掉你的宏平均(分类:评估误用)
问题:SemEval-2016 统计显示 TLINK 中 CONTAINS 约占 64%、BEFORE 约 13%,其余类别合计约两成。直接训练的分类器会倒向多数类,微平均虚高、宏平均难看。
症状:总体 accuracy 0.8+ 但 AFTER/BEFORE_OVERLAP 的 F1 接近 0;误差矩阵集中在 CONTAINS。
解决:
- 简单方法:训练时按类重加权(class weights)或对少数类过采样。
- 进阶方法:以宏 F1 为模型选择指标;把 CONTAINS 拆分为"容器-事件"与"事件-事件"两个子任务分别建模。
- SOTA 方法:约束式解码——事件对共现于同一叙事容器时先验地限制候选标签集;或按 SemEval 各子任务分开汇报(属性用 accuracy、关系用 F1),不做混合平均。
参考:Bethard et al., SemEval-2016 Task 12
⚠️ 坑点 3:患者级泄漏——同一患者的 3 份文书跨划分(分类:数据泄漏)
问题:Clinical TempEval 子集为 200 名患者各 3 份文书(临床/病理/放射)。按文书随机切分时,训练集与测试集会出现同一患者的不同文书,共享同一治疗叙事、日期与措辞习惯。
症状:线下 F1 很高,换机构数据上崩塌;误差分析发现测试文书中的日期与实体在训练集几乎逐字出现。
解决:
- 简单方法:文书编号相邻的 3 件视为一组(患者代理键),GroupShuffleSplit 按组切分。
- 进阶方法:DUA 拿到正文/元数据后用真实患者 ID 重组分组键;对 SemEval 官方划分做"泄漏审计"并在论文声明。
- SOTA 方法:构建"机构外验证":训练于 THYME、测试于 i2b2/MIMIC 文本的小样本自标注集,报告跨域衰减曲线。
参考:Bethard et al., SemEval-2015 Task 6(200 患者 × 3 文书设定)
⚠️ 坑点 4:行尾符改写让 XML 偏移量全线漂移(分类:工程陷阱)
问题:标注以字符偏移存储,原文被任何编辑器/解压过程改为 CRLF 或去掉行尾空白后,全部 span 整体错位。仓库 README 点名这是最常见的错误来源。
症状:text[start:end]切出的字符串与标注标签对不上;实体词表出现大量碎片词;关系对的实体文本"看起来差一个字符"。
解决:
- 简单方法:只在 *nix 环境处理文本;Windows 解压用 7-zip,关闭"自动转换换行"的编辑器(VS Code 设置
files.eol: \n)。- 进阶方法:入库前跑偏移校验脚本——断言每个 span 切片非空且与实体文本哈希一致;校验不过立即报警而非静默修正偏移。
- SOTA 方法:把"文本指纹(SHA-256)+ 偏移抽样校验"纳入 CI,任何数据副本先过指纹比对再参与训练。
参考:thymedata README:Line Endings
⚠️ 坑点 5:DocTimeRel 与 TLINK 是两套语义,不是同一标签的两种写法(分类:标签理解)
问题:DocTimeRel 是事件属性(事件相对文书完成时间:BEFORE/AFTER/OVERLAP/BEFORE-/-OVERLAP),TLINK 是实体间关系(BEFORE/AFTER/OVERLAP/BEFORE_OVERLAP/VAGUE)。两者标签名高度相似但语义对象不同,混用会导致训练目标与评测协议错位。
症状:把 DocTimeRel 标签当 TLINK 训练后,评测脚本报"标签不在候选集";或模型在 DR 子任务上用关系式 softmax 导致指标口径混乱。
解决:
- 简单方法:数据字典层面拆分两个字段空间(如 §4.1),加载器按 annotation 类型路由到不同标签映射。
- 进阶方法:共享编码器 + 双任务头,属性任务用 accuracy、关系任务用宏 F1 分别汇报,符合 SemEval 协议。
- SOTA 方法:多任务联合建模时以 DOCTIME 为公共锚点,把 DocTimeRel 视为"事件-DOCTIME 的特殊 TLINK"统一表示,再在评测时还原两套指标。
参考:Clinical TempEval 任务定义(TS/TA/ES/EA/DR/CR 子任务表)
⚠️ 坑点 6:叙事容器子任务会拖垮你的总分——必须分开汇报(分类:评估误用)
问题:叙事容器(narrative container,如"postoperative"包含术后事件)是 THYME 独有结构,语义上要求"容器实体聚合其内部事件"。SemEval-2015 上该子任务最优系统 F1 仅 0.102,与其他子任务(事件 0.875)相差近九倍。
症状:把 CR 并入总 F1 后整体分数被淹没;或模型在 CR 上输出大量空预测,看起来"训练失败"。
解决:
- 简单方法:九个子任务分数分列汇报,总分不与单任务混算。
- 进阶方法:把 CR 建模为"以容器实体为根的聚合关系",用集合预测(每个容器预测其成员事件集合)而非逐对二分类。
- SOTA 方法:以 LLM 读全文做容器-成员一致性判别,把 CR 视为约束满足问题;评测沿用官方 scorer 保证可比。
参考:Bethard et al., SemEval-2015 Task 6(NC 0.102)
⚠️ 坑点 7:HYPOTHETICAL/HEDGED 事件——计划、家族史与鉴别诊断不是已发生事实(分类:标签理解)
问题:肿瘤叙事里充满计划与假设:“拟于下周期行化疗”、“如出现恶心”、“母亲曾患结肠癌”。这些事件的 ContextualModality 为 HYPOTHETICAL/GENERIC/HEDGED,若当作 ACTUAL 事实并入时间线,会构建出"从未发生的治疗"。
症状:生成的时间线里出现未来日期的"已完成"手术;家族史事件被归入患者本人的治疗序列;Follow-up 段落全部事件被时间线工具排进队列。
解决:
- 简单方法:时间线构建前按 modality 过滤,仅保留 ACTUAL 事件。
- 进阶方法:把 modality 作为时间线节点属性保留(“计划:2024-02 化疗”),下游按节点类型分轨展示。
- SOTA 方法:端到端联合模型同时输出事件 span、属性与 DocTimeRel,并以确定性后处理保证"非 ACTUAL 事件不得与真实日期建立 BEFORE 关系"。
参考:Clinical TempEval 事件属性定义(EA 子任务示例)
⚠️ 坑点 8:gold.completed 与版本漂移——三个划分口径并存(分类:工程陷阱)
问题:仓库中 Train/Dev/Test 目录分别定稿于 2014-11、2014-12、2016-02,另有 SemEval-2015(train 293/test 147)与 SemEval-2016(test 151)两套官方划分;只有
gold.completed后缀的文件才是金标准。口径混用会让复现结果不可比。
症状:测试分数对不上已发表数字;发现训练集里混入测试文书(2016-02 才入库的 Test 目录与 2015 划分重叠);误把非 gold 文件当金标准。
解决:
- 简单方法:clone 后固定 commit hash 记录在实验配置里;加载器仅接受
*.gold.completed.xml。- 进阶方法:复现哪年评测就用哪年划分(2015→293/147;2016→Test 目录),并在论文表格注明"划分口径 + 仓库 commit"。
- SOTA 方法:为数据快照建立 manifest(文件名清单 + SHA-256),实验启动时与 manifest 比对,防止上游仓库更新引入漂移。
参考:thymedata 仓库提交历史(Train 2014-11-07 / Dev 2014-12-24 / Test 2016-02-04)
§6.6 数据增强
| 策略 | 安全性 | 说明 |
|---|---|---|
| 少数类关系重加权/过采样 | ✅ 安全 | 缓解坑点 2 的类不均衡,不改动文本 |
| 同义改写仅限非标注 token(whitespace、大小写) | ✅ 安全 | 偏移量在字符级不受影响时可用 |
| 随机删除/打乱句子 | ❌ 危险 | 破坏叙事容器与跨句 TLINK 的语境 |
| 时间表达式替换(如改日期、改"周五") | ❌ 危险 | 连带改变 DocTimeRel/TIMEX3.value 标签,产生错标 |
| 回译/LLM 改写全文 | ❌ 危险 | 临床事件措辞改变后,实体与关系标注全部失效 |
结论:THYME 的标注与字符偏移强耦合,可用的增强几乎只有重加权与采样层面;"改文本"类增强都需要同步重标注,成本远超收益。
一条补充纪律:即使只做"安全"的采样级增强,也应保持每份文书的实体与关系整体进退一致——把同一文书的关系对随机分拆到不同采样批次,会制造坑点 3 所述的关系级泄漏;正确的重加权单位是文书(或患者),而非单条关系。
§6.7 模型推荐
| 模型 | 类型 | 适用任务 | 说明 |
|---|---|---|---|
| Bio_ClinicalBERT / BERT-base | 预训练编码器 | 实体识别、属性分类 | 临床文本微调首选基线 |
| Longformer / BigBird | 长文档编码器 | 全文书 TLINK、叙事容器 | 病历普遍超 512 token 时使用 |
| cTAKES-Temporal | 规则 + ML 管线 | 端到端时间抽取 | 工程化基线(JAMIA 2016) |
| 双仿射/Biaffine 解析器结构 | 关系建模 | TLINK 分类 | 把时间关系当依存解析建模,SemEval 关系任务的主流结构 |
| LLM(指令微调) | 生成式 | 时间线问答、容器推理 | 用 THYME 标注构造探针做评测,而非直接微调泄露测试集 |
消费方系统视角:THYME 在工程管线中如何被使用。THYME 最典型的工业级消费方是 Apache cTAKES 的 ctakes-temporal 模块(JAMIA 2016):Mayo Clinic 团队基于 ClearTK——一个构建在 Apache UIMA 之上的机器学习建模框架——在 THYME 语料上训练事件识别、时间表达式识别与 DocTimeRel/时间关系模型,把 THYME-TimeML 的标签体系映射进 UIMA 类型系统(事件提及、时间提及与时间关系等类型概念),再以管线形式对外输出时间注释。对使用者而言,这意味着两条工程路径:直接复用 cTAKES 管线做工程化时间抽取(THYME 是其标定基准),或仿照 ClearTK 的特征工程思路在现代预训练编码器上重建模型。DeepPhe(arXiv:1902.06752)则展示了下游消费方式:肿瘤表型系统把时间抽取输出作为表型时间线的原料,THYME 在其中承担验收与回归测试角色。
§6.8 硬件需求
| 场景 | 配置 | 说明 |
|---|---|---|
| 实体/属性任务微调 | 单卡 16 GB(如 T4/A10) | BERT-base + 512 token 足够 |
| 全文书关系任务 | 单卡 24 GB(如 3090/4090) | Longformer 或双仿射结构 |
| 大规模扫描标注层 | CPU 即可 | XML 解析与偏移校验为 IO 密集 |
§6.9 评估指标代码
from collections import Counter

def entity_f1(gold, pred):
    """精确 span+type 匹配的实体 F1(SemEval TS/ES 风格)。"""
    g, p = Counter(gold), Counter(pred)
    tp = sum(min(g[k], p[k]) for k in g)
    prec = tp / max(sum(p.values()), 1)
    rec = tp / max(sum(g.values()), 1)
    return 2 * prec * rec / max(prec + rec, 1e-9)

def macro_relation_f1(gold, pred, labels=("BEFORE", "AFTER", "OVERLAP",
                                           "BEFORE_OVERLAP", "VAGUE")):
    """TLINK 宏 F1:先分类统计每类 P/R/F1,再平均(坑点 2 的正确姿势)。"""
    per, f1s = Counter(), []
    for lb in labels:
        tp = sum(1 for a, b in zip(gold, pred) if a == b == lb)
        pp = sum(1 for b in pred if b == lb); gp = sum(1 for a in gold if a == lb)
        pr = tp / max(pp, 1); rc = tp / max(gp, 1)
        f1s.append(2 * pr * rc / max(pr + rc, 1e-9))
    return sum(f1s) / len(labels)

# docTimeRel 用 accuracy(SemEval DR 子任务口径)
def doc_time_rel_acc(gold, pred):
    return sum(a == b for a, b in zip(gold, pred)) / max(len(gold), 1)
使用提示:宏 F1 的类别列表必须与训练标签空间严格一致(含 VAGUE 与 BEFORE_OVERLAP);若按坑点 2 做了类别合并,需在结果表中同时汇报合并前后的两套口径。DocTimeRel 的四标签中 BEFORE-/-OVERLAP 与 BEFORE 易混,误差分析时建议单独输出这对标签的混淆计数。
§6.10 MLOps 笔记
- 版本锁定:记录仓库 commit hash 与使用的划分口径(2015/2016/TACL)于实验配置;数据快照建 SHA-256 manifest(坑点 8)。
- CI 校验:每次数据更新自动跑偏移抽样校验与行尾符检查(坑点 4)。
- 评测分离:九个子任务指标分开持久化,避免叙事容器低分污染汇总(坑点 6)。
- 合规管道:正文数据目录加密盘挂载、访问审计日志;DUA 禁止再分发——因此数据加载器不得把原文写入可导出的中间产物(如打包的缓存)。
- 复现报告模板:commit + 划分口径 + 评分器版本 + 类别权重配置四要素齐全,他人才可能复现你的数字。
- 时间锚元数据:为每份文书记录其 DOCTIME/SECTIONTIME 清单与关系边统计(CONTAINS/BEGINS-ON/ENDS-ON 计数),作为回归测试时比对数据快照的"结构指纹"。
§7 质量评估与局限性
§7.1 已知偏倚
| 偏倚类型 | 描述 | 严重程度 | 缓解措施 |
|---|---|---|---|
| 单机构偏倚 | 全部文书来自 Mayo Clinic 三级医疗中心 | 高 | 外部语料验证(i2b2、MIMIC 生态自标集) |
| 域窄偏倚 | 仅结肠癌与脑瘤两类肿瘤叙事 | 高 | 迁移学习 + 协议再标注 |
| 类不均衡 | CONTAINS 64% vs 少数类 <5% | 中 | 宏 F1 选型、重加权(坑点 2) |
| 文书类型偏倚 | _PATH 无关系标注 | 中 | 关系任务过滤 _PATH(坑点 1) |
| 模板化书写 | 日期密集的表格化段落诱发捷径学习 | 中 | 去日期消融实验、对抗性探针(坑点 4 关联) |
| 语言偏倚 | 仅英语 | 中 | 跨语言需重新设计协议 |
§7.2 标注质量
实体与关系均为双人标注 + 仲裁,且分两阶段执行(先实体后关系),标注指南全公开。语料以 gold.completed 命名仲裁后金标准,与未仲裁文件物理隔离,这一工程实践显著降低了误用风险。局限:README 未公布逐层一致性系数;仲裁差异本身未被发布,使用者无法直接估计标签噪声上界,需自行从训练集残档抽样审计。
独立的质量审计视角:有研究(Tissot et al., 2015,经二次文献转引)对 THYME 人工标注抽样后发现少量不一致——如 DURATION 被误标为 DATE、虚词被并入标注 span、SET 类表达式的漏标相对突出。这些发现不改变 gold.completed 的金标准地位,但提示使用者:在把 THYME 当作唯一真值之前,值得对高影响类别(SET、PrePostExp)做一次抽样复核——审计成本远低于把标签噪声带进下游评测后的返工成本。
§7.3 泛化性
| 场景 | 失效风险 | 证据 |
|---|---|---|
| 非肿瘤科室(如心血管、ICU) | 高:叙事节奏与时间表达类型不同 | 语料仅含两类肿瘤叙事 |
| 非 Mayo 机构(其他医院) | 中高:书写模板与缩写体系差异 | 单机构来源 |
| 非英语临床文本 | 高:TIMEX3 类型体系(PrePostExp 等)绑定英文表达 | 指南以英文为核心 |
| 口语化转述(医患对话) | 高:病历书面语假设不成立 | 语料全部为病历文书 |
| LLM 时代的新书写(AI 起草病历) | 未知:时间表达分布可能变化 | 尚无系统证据 |
失败模式分析:文档时间 vs 叙事时间。THYME 的时间结构本质上是双轨的:文档时间(DOCTIME/DCT)回答"这份文书写于何时",驱动 DocTimeRel 分类;叙事时间(由叙事容器与句内 TLINK 组织的文内时间线)回答"文书叙述的事件彼此处于何时"。二者不可互相替代,混淆它们是 THYME 上最常见的一类系统性失败:
- 扁平时间线失败:出院小结回顾一次住院,文中几乎全部事件 DocTimeRel 均为 BEFORE。只优化 DocTimeRel 的系统会把"入院—手术—出院"压成同一个时间点——DocTimeRel 拿高分,时间线却不可用。正确做法是把 BEFORE 事件按容器与句内 TLINK 重新排序。
- 区间叙事失败:放射报告以 SECTIONTIME(检查日期)而非文书完成时间为叙事锚,"interval 所见"相对检查日期定位而非相对 DCT。以 DCT 为唯一锚点的模型在 _RAD 上系统性偏移。
- 容器传递性失败:指南允许嵌套与单边界容器,CONTAINS 并不构成数学意义上的闭包传递;时间线构建器若对容器做传递闭包,会把嵌套容器内的事件错误地复制到外层容器。
- 假设-事实串线失败:指南明确禁止 ACTUAL/HEDGED 事件与 HYPOTHETICAL/GENERIC 事件互连 TLINK;违反该约束的输出会把随访计划、家族史排进真实时间线(与坑点 7 同源,但在关系层而非属性层发生)。
| 失败模式 | 触发场景 | 根因 | 缓解方向 |
|---|---|---|---|
| 扁平时间线 | DocTimeRel 全 BEFORE 的回顾性文书 | 只建 DCT 单锚,未建文内顺序 | 容器 + 句内 TLINK 双轨排序 |
| 区间叙事 | _RAD 的 interval 所见 | 叙事锚是 SECTIONTIME 非 DCT | 章节锚感知的锚点选择 |
| 容器传递性 | 嵌套/单边界容器 | 对 CONTAINS 做闭包假设 | 仅按显式边聚合 |
| 假设-事实串线 | 随访计划、家族史段落 | 违反 modality 互连禁令 | 关系解码时加 modality 约束 |
§7.4 伦理
正文层为受保护健康信息(PHI)环境产物:Mayo Clinic 按其政策完成去标识,DUA 要求加密存储、禁止再识别尝试、禁止再分发、仅授予机构 PI。公开的标注 XML 不含任何患者信息(仅偏移与标签),这是"标注与文本分离分发"设计的伦理动机。使用正文的研究须通过本机构伦理审查,并在成果中致谢 Mayo Clinic、引用 Styler et al. 2014。
§7.5 公平性
标注层不含人口学属性(脱标识设计使然),无法直接做性别/种族分组的性能审计;正文层虽含临床人口学信息,但受 DUA 限制,公平性研究需在合规框架内进行并注意再识别风险。使用 THYME 训练的临床时间系统在部署前,应按 FDA/监管路径在其他人群上独立验证。
§7.6 数据漂移
病历书写惯例随 EMR 演进而变化(模板化程度、结构化输入比例上升),THYME 的文书反映 2010 年代初的三级医疗书写风格。用 THYME 校准的系统面对当代病历(更多结构化字段、更少自由文本)可能出现覆盖面衰减,建议部署后持续监控实体召回率。
值得单独监控的一类漂移是时间表达风格的漂移:从自由文本日期转向结构化日期字段、相对表达(“昨日”“术后两周”)占比变化、以及 PrePostExp 类表达在模板化书写中的密度变化,都会直接改变 DocTimeRel 与归一化任务的输入分布。这类漂移不会体现在总量指标上,需要按表达式类型分桶监控。
§7.7 DAIMS 24 项评估
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 宽格式可用 | ✅ | Anafora XML 可按 §6.3 展平为实体表 + 关系表 |
| 2 | 唯一标识 | ✅ | 文书编号 + annotation id 双层主键 |
| 3 | 特殊字符处理 | ✅ | 章节标记与偏移敏感字符在指南与 README 中均有约定 |
| 4 | 重复行检查 | ✅ | 实体唯一、关系对唯一;仲裁后无重复标注 |
| 5 | 缺失编码规范 | ✅ | N/A 与 VAGUE 语义分工明确 |
| 6 | 标签标识清晰 | ✅ | gold.completed 命名隔离金标准 |
| 7 | 罕见类分组 | ⚠️ | BEFORE_OVERLAP、PrePostExp 等低频类需自行合并分组 |
| 8 | 偏倚评估 | ✅ | 单机构/域窄/类不均衡均有文档化讨论(§7.1) |
| 9 | 数据字典 | ✅ | 官方指南 PDF + README 构成完整字典 |
| 10 | 信息性缺失解释 | ⚠️ | VAGUE 与未标注的边界需读者自行从协议推断 |
| 11 | 设备记录 | ❌ | 纯文本病历语料,无设备/波形元数据 |
| 12 | 共线性检查 | ⚠️ | SECTIONTIME 与 DOCTIME 高度相关,特征工程需防冗余 |
| 13 | 编码映射 | ✅ | DocTimeRel/TLINK 标签集在指南中枚举完整 |
| 14 | 时间戳处理 | ⚠️ | TIMEX3.value 依赖可解析表达;相对表达需自行归一化 |
| 15 | 划分建议 | ✅ | SemEval 官方划分明确(293/147、151) |
| 16 | 泄漏讨论 | ✅ | 患者级泄漏在任务设计与本文档中均有讨论(坑点 3) |
| 17 | 标签分布 | ✅ | CONTAINS 64% 等分布有公开统计(§4.2) |
| 18 | 测量偏倚 | ⚠️ | 模板化文书引入书写风格偏倚(§7.1) |
| 19 | 外部验证建议 | ✅ | §5.5、§7.8 给出明确路径 |
| 20 | 版本记录 | ✅ | GitHub release 与分目录提交历史完整 |
| 21 | 预处理脚本 | ⚠️ | 无官方一键脚本;社区代码分散(§6.3 提供参考实现) |
| 22 | 合规要求 | ✅ | DUA 条款明确(加密/禁再识别/禁再分发/致谢引用) |
| 23 | 多模态对齐 | ⚠️ | 纯文本语料;仅章节标记层可做文档结构对齐 |
| 24 | 去标识化 | ✅ | Mayo 政策脱标识 + 标注层零患者信息 + DUA 禁再识别 |
DAIMS 评分:19.5 / 24(16 项 ✅ + 7 项 ⚠️ + 1 项 ❌)
评分解读:THYME 在"规范与合规"维度表现优秀——标识体系、金标准命名、版本记录、DUA 条款、泄漏讨论都达到教科书水准;扣分集中在"工程便利性"(无官方预处理脚本、低频类与时间归一化需自行处理)与"适用面"(无设备元数据、纯文本结构)。这些 ⚠️ 项本质上是"研究语料 vs 生产数据集"的定位差异,而非质量问题。
对你意味着什么:(1) 如果你的目标是训练时间抽取模型,预算的 30-50% 应花在数据工程(XML 展平、偏移校验、划分口径管理)而非建模上;(2) 关系任务必须从第一天就采用宏 F1 与类重加权,否则实验结论会被 CONTAINS 多数类劫持;(3) 正文层获取受 DUA 约束,排期时把审批周期当作硬依赖;(4) 不要期待把 THYME 直接当生产语料——它是校准器与基准,生产系统还需要你自己的机构数据。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 评估任务 | 性能指标 | 相对内部变化 | 关键发现 |
|---|---|---|---|---|---|
| Clinical TempEval-2015 测试集 | SemEval(Mayo 语料盲测) | 事件/时间表达式识别 | EVENT F1 0.875;TIMEX3 0.725 | 接近人类水平 | 实体识别近乎解决(S15-2136) |
| Clinical TempEval-2015 测试集 | 同上 | 时间关系/叙事容器 | DocTimeRel 0.702;NC 0.102 | 关系显著落后于人类 | "关系鸿沟"结论确立 |
| Clinical TempEval-2016 测试集 | SemEval(test 151) | 全子任务 | TIMEX3 0.795;EVENT 0.903;DR 0.756;NC 0.479 | 系统迭代后关系仍最弱 | CRF/管线系统可稳定提升实体层(S16-1165) |
| VUACLTL 系统 | VU Amsterdam | 2016 全子任务 | CRF 管线(见任务论文) | — | CRF 管线为关系任务提供了可复现基线(S16-1193) |
| UTHealth 系统 | UTHealth | 2016 全子任务 | 端到端系统(见任务论文) | — | 端到端临床时间抽取系统的工程参考(S16-1201) |
§8 基准性能与生态
§8.1 排行榜
Clinical TempEval 按子任务评分,不同年份的划分与评分脚本不同,下列数字不可直接跨行比较:
| 任务(年份) | 最优成绩(指标) | 年份 | 关键技术 | 完整引用 | 代码 |
|---|---|---|---|---|---|
| EVENT 识别(2015) | 0.875(F1) | 2015 | 统计 + 特征工程管线 | Bethard S, Derczynski L, Savova G, Pustejovsky J, Verhagen M. SemEval-2015 Task 6: Clinical TempEval. SemEval@NAACL-HLT 2015, pp. 806-814. DOI: 10.18653/v1/S15-2136 | 官方 scorer 随任务发布 |
| TIMEX3 识别(2015) | 0.725(F1) | 2015 | 同上 | 同上 | 同上 |
| DocTimeRel(2015) | 0.702(accuracy) | 2015 | 事件属性分类 | 同上 | 同上 |
| 叙事容器(2015) | 0.102(F1) | 2015 | 容器-成员预测 | 同上 | 同上 |
| TIMEX3 识别(2016) | 0.795(F1) | 2016 | 规则 + 机器学习混合 | Bethard S, Savova G, Chen W-T, Derczynski L, Pustejovsky J, Verhagen M. SemEval-2016 Task 12: Clinical TempEval. SemEval-2016, pp. 1052-1062. DOI: 10.18653/v1/S16-1165 | 官方 scorer 随任务发布 |
| EVENT 识别(2016) | 0.903(F1) | 2016 | 同上 | 同上 | 同上 |
| DocTimeRel(2016) | 0.756(accuracy) | 2016 | 同上 | 同上 | 同上 |
| 叙事容器(2016) | 0.479(F1) | 2016 | 结构化预测改进 | 同上 | 同上 |
| 参赛系统:VUACLTL(2016) | 全子任务参赛 | 2016 | CRF 管线 | Caselli T, Morante R. VUACLTL at SemEval 2016 Task 12: A CRF Pipeline to Clinical TempEval. SemEval-2016, pp. 1241-1247. DOI: 10.18653/v1/S16-1193 | 论文附系统描述 |
| 参赛系统:UTHealth(2016) | 全子任务参赛 | 2016 | 端到端临床时间抽取 | Lee H-J, Xu H, Wang J, Zhang Y, Moon S, Xu J, Wu Y. UTHealth at SemEval-2016 Task 12. SemEval-2016, pp. 1292-1297. DOI: 10.18653/v1/S16-1201 | 论文附系统描述 |
§8.2 SOTA 总结与选型建议
官方结论值得原样记住:实体层(事件、时间表达式)的最优系统已"接近人类水平",而时间关系层"仍有巨大差距"(S15-2136)。2016 年的关系与容器分数继续改善(DR 0.756、NC 0.479),但未逆转格局。选型建议:把 THYME 当作关系与容器推理的困难基准——用实体层分数做回归测试、用关系层分数区分模型强弱;任何声称"临床时间推理已解决"的系统都应先在 THYME 关系子任务上自证。
在 LLM 评测场景下,THYME 的高密度关系标注还有一层用法:把 TLINK/DocTimeRel 改写成受控探针(给定实体对与上下文,要求输出关系标签),可以分离"模型真的会推理时间"与"模型只是复述训练语料中的日期模式"两种解释;叙事容器子任务(历史最优 F1 仅 0.102)则是检验长上下文聚合能力的天然压力测试。评测设计时注意沿用官方划分与标签空间,避免自造标签集导致与文献不可比。
§8.3 评测协议
九个子任务(TS/TA/ES/EA/DR/TR/CR 及其组合)各自独立评分:实体任务用精确匹配 F1,属性任务(EA/DR)用 accuracy,关系任务(TR)与容器任务(CR)用 F1。官方 scorer 随各年任务发布;复现时必须使用与年份匹配的划分(2015:train 293/test 147;2016:test 151)与评分器版本,否则数字不可比。
协议细节上,SemEval-2015 采用两阶段设计:第一阶段系统仅见原文,完成实体与关系的全量抽取;第二阶段向系统提供金标准事件与时间表达式,仅评关系(此时 recall 等价于 accuracy)。叙事容器关系以"(容器 span,成员 span)“二元组精确匹配计分,属性任务以”(span,属性值)"三元组计分——这意味着实体边界错误会级联冻结属性与关系得分,端到端系统的分数天然低于两阶段上限。2016 年延续该协议并扩充子任务;官方统计中的关系计数以 TYPE=CONTAINS 的叙事容器关系为口径。
§8.4 相关数据集
| 数据集 | 关系 | 说明 |
|---|---|---|
| i2b2 2012 Temporal Challenge | 前身 | 其简化 TimeML 指南由 THYME 协议简化而来(i2b2) |
| TempEval-3 临床语料 | 前身 | brain 子集 595 份的直接来源 |
| ChemoTimelines(2024) | 下游 | 化疗时间线构建共享任务,延续 THYME 的问题设定 |
| MIMIC-III | 互补 | 提供大规模临床文本,但无时间关系金标准;可与 THYME 协议结合做弱标注 |
| DeepPhe 生态 | 下游 | 基于 cTAKES 的肿瘤表型系统,消费时间线输出(arXiv:1902.06752) |
三套时间标注体系的谱系对比(TimeBank → THYME-TimeML → i2b2 2012):
| 维度 | TimeBank(新闻域) | THYME(临床域) | i2b2 2012(临床域任务) |
|---|---|---|---|
| 文本域 | 新闻通讯社文本 | Mayo 肿瘤病历(临床/病理/放射) | 310 份出院小结 |
| 事件属性 | TimeML 七类事件 class(OCCURRENCE 等)+ tense/aspect 等 | 7 个临床化属性(DocTimeRel/polarity/degree/modality/aspect/type/permanence) | type(problem/test/treatment 等)+ polarity + modality(factual/hypothetical/hedged/conditional) |
| 关系集合 | TLINK/SLINK/ALINK/SIGNAL 全套 | TLINK(五子类型)+ ALINK + 叙事容器 CONTAINS | 基于 THYME-TimeML 再简化:移除 SIGNAL/SLINK/ALINK |
| 时间锚结构 | functionInDocument 属性标 DCT | DOCTIME/SECTIONTIME 独立实体 | 沿用 THYME 式章节时间锚 |
| 特色结构 | 语言学原型协议 | 叙事容器 + PrePostExp/Quantifier | 面向共享任务的精简协议 |
三者的谱系关系是明确的:THYME-TimeML 的简化指南构成 i2b2 2012 时间任务的基础,i2b2 再做减法以适配共享任务的评分可行性;其官方任务页记录的相对时间归一化成绩落差(0.67→0.32)也印证了越贴近临床真实叙事、时间归一化越难的趋势(i2b2 任务页)。对使用者的启示:THYME 标签不能直接当作 i2b2 标签使用,跨语料迁移需要一层显式的协议映射。
§8.5 关键论文 Top 6
- Styler IV WF, Bethard S, Finan S, Palmer M, Pradhan S, de Groen PC, Erickson B, Miller T, Lin C, Savova G, Pustejovsky J. Temporal Annotation in the Clinical Domain. TACL 2:143-154, 2014. — THYME-TimeML 标注体系与语料构建的奠基论文(Q14-1012)。
- Bethard S, Derczynski L, Savova G, Pustejovsky J, Verhagen M. SemEval-2015 Task 6: Clinical TempEval. SemEval@NAACL-HLT 2015, pp. 806-814. — 首届临床时间评测,确立"实体易、关系难"格局(DOI: 10.18653/v1/S15-2136)。
- Bethard S, Savova G, Chen W-T, Derczynski L, Pustejovsky J, Verhagen M. SemEval-2016 Task 12: Clinical TempEval. SemEval-2016, pp. 1052-1062. — 第二届评测,扩充子任务与测试集(DOI: 10.18653/v1/S16-1165)。
- Caselli T, Morante R. VUACLTL at SemEval 2016 Task 12: A CRF Pipeline to Clinical TempEval. SemEval-2016, pp. 1241-1247. — 可复现的 CRF 基线(DOI: 10.18653/v1/S16-1193)。
- Lee H-J, Xu H, Wang J, Zhang Y, Moon S, Xu J, Wu Y. UTHealth at SemEval-2016 Task 12: an End-to-End System for Temporal Information Extraction from Clinical Notes. SemEval-2016, pp. 1292-1297. — 端到端系统工程参考(DOI: 10.18653/v1/S16-1201)。
- Li et al. 2020. THYME 结肠癌子集的神经基线与标注统计. arXiv:2005.02587. — 提供逐划分标注计数与神经模型基线(arXiv:2005.02587)。
§8.6 社区活跃度
标注仓库处于"稳定维护"状态:主体数据 2014-2016 年入库,README 于 2026-06-01 更新获取入口(迁移至 Harvard hNLP Center),显示项目在发布十年后仍有机构级维护。学术侧,SemEval-2015 Task 6 论文被引 212+(Google Scholar,截至 2026-09),THYME 相关研究覆盖时间抽取、时间线构建、LLM 评测等方向;临床 NLP 课程普遍采用其指南作为标注规范教学材料。
工程生态方面,ctakes-temporal 与 DeepPhe 构成了从语料到生产管线的最短闭环:前者以 ClearTK 框架在 THYME 上训练模型并集成进 Apache cTAKES,后者消费其输出构建肿瘤表型时间线。这条"语料 → 训练框架 → 开源管线 → 下游应用"的完整链条在临床 NLP 数据集中并不多见,也是 THYME 长期被选作系统验收基准的现实原因。
§8.7 生态快照
| 资源 | 类型 | 链接 | 推荐理由 |
|---|---|---|---|
| stylerw/thymedata | 标注数据仓库 | GitHub | 标注层官方分发点(快照截至 2026-09) |
| THYME Annotation Guidelines | 标注指南 PDF | clear.colorado.edu | ISO-TimeML 临床扩展的权威文本 |
| Anafora | 标注工具 | GitHub | 与 THYME XML 格式配套的开源工具 |
| Harvard hNLP Center 数据集页 | 分发入口 | healthnlp.hms.harvard.edu | 2026-06 起正文 DUA 办理入口 |
| SemEval-2015 Task 6 页面 | 评测任务页 | alt.qcri.org | 九个子任务的原始定义与示例 |
| cTAKES | NLP 系统 | Apache cTAKES | THYME 协议工程化的系统载体 |
§9 相关资源与引用
§9.1 官方资源
- 标注数据仓库:github.com/stylerw/thymedata(标注层;README 含 DUA、格式与行尾符说明)
- 项目主页:thyme.healthnlp.org
- 正文获取(DUA):Harvard hNLP Center 数据集页 与 加入 hNLP Center
- 标注指南:THYME Annotation Guidelines (PDF)
- TACL 论文:aclanthology.org/Q14-1012(PubMed: PMID 29082229)
- 评测任务:SemEval-2015 Task 6、SemEval-2015 论文、SemEval-2016 论文
- 标注工具:Anafora
- 前身任务:i2b2 2012 Temporal Relations
§9.2 BibTeX 引用
@article{styler2014temporal,
  title   = {Temporal Annotation in the Clinical Domain},
  author  = {Styler IV, William F. and Bethard, Steven and Finan, Sean and
             Palmer, Martha and Pradhan, Sameer and de Groen, Piet C. and
             Erickson, Brad and Miller, Timothy and Lin, Chen and
             Savova, Guergana and Pustejovsky, James},
  journal = {Transactions of the Association for Computational Linguistics},
  volume  = {2},
  pages   = {143--154},
  year    = {2014},
  url     = {https://aclanthology.org/Q14-1012/}
}

@inproceedings{bethard2015semeval,
  title     = {{S}em{E}val-2015 Task 6: Clinical {T}emp{E}val},
  author    = {Bethard, Steven and Derczynski, Leon and Savova, Guergana and
               Pustejovsky, James and Verhagen, Marc},
  booktitle = {Proceedings of the 9th International Workshop on Semantic Evaluation (SemEval 2015)},
  pages     = {806--814},
  year      = {2015},
  doi       = {10.18653/v1/S15-2136}
}

@inproceedings{bethard2016semeval,
  title     = {{S}em{E}val-2016 Task 12: Clinical {T}emp{E}val},
  author    = {Bethard, Steven and Savova, Guergana and Chen, Wei-Te and
               Derczynski, Leon and Pustejovsky, James and Verhagen, Marc},
  booktitle = {Proceedings of the 10th International Workshop on Semantic Evaluation (SemEval-2016)},
  pages     = {1052--1062},
  year      = {2016},
  doi       = {10.18653/v1/S16-1165}
}
§9.3 引用指南
- 使用语料/标注体系:引用 Styler et al. 2014(TACL)。
- 使用 SemEval 划分与成绩:同时引用对应年份的任务论文(2015/2016)。
- 使用正文数据:额外遵守 DUA——致谢 Mayo Clinic、引用 Styler et al. 2014(官方 README 明确要求)。
- 页面本身的引用格式见 frontmatter
citeAs字段。
§10 AI 使用声明卡
§10.1 AI 模型使用
| AI 模型 | 版本 | 用途 |
|---|---|---|
| fast-model(CodeBuddy) | 2026-09 | 初稿生成:INFOBOX 数据汇编、§1-§9 结构化写作、§6 代码示例生成、JSON-LD 构建 |
| WebSearch(多源检索) | 2026-09 | 多组检索:官方仓库、TACL/SemEval 论文页、DUA 分发入口、基准成绩交叉验证 |
§10.2 AI 参与范围
AI 参与范围:初稿生成 + 资料整理 + 代码生成 + 格式化排版。
AI 在本页面的工作中负责:(1) 从 GitHub 仓库 README、TACL 2014 论文、SemEval 任务页与 ACL Anthology 页面整理结构化信息;(2) 生成 §6 的 Python/bash 代码示例;(3) 系统化组织 §6.5 的 8 个坑点与 §7.1 偏倚表;(4) 执行 G1/G2/G3 排版规范检查与中英文格式标准化;(5) 构建 §C 统一 JSON-LD @graph。
§10.3 输入来源
- Styler IV WF, et al. Temporal Annotation in the Clinical Domain. TACL 2:143-154, 2014 — aclanthology.org/Q14-1012(PubMed PMID 29082229)
- GitHub stylerw/thymedata README — 仓库结构、双轨分发模式、行尾符警告、致谢与引用要求(快照截至 2026-09)
- GitHub 仓库提交历史 — Train 2014-11-07 / Dev 2014-12-24 / Test 2016-02-04 / README 2026-06-01
- THYME Annotation Guidelines (PDF) — clear.colorado.edu
- SemEval-2015 Task 6 任务页(alt.qcri.org/semeval2015/task6/)— 九个子任务定义与示例
- Bethard S, et al. SemEval-2015 Task 6: Clinical TempEval. SemEval@NAACL-HLT 2015, pp. 806-814. DOI: 10.18653/v1/S15-2136
- Bethard S, et al. SemEval-2016 Task 12: Clinical TempEval. SemEval-2016, pp. 1052-1062. DOI: 10.18653/v1/S16-1165
- Caselli T, Morante R. VUACLTL at SemEval 2016 Task 12. SemEval-2016, pp. 1241-1247. DOI: 10.18653/v1/S16-1193
- Lee H-J, et al. UTHealth at SemEval-2016 Task 12. SemEval-2016, pp. 1292-1297. DOI: 10.18653/v1/S16-1201
- Li et al. 2020. arXiv:2005.02587 — 结肠癌子集标注计数与神经基线
- cTAKES-Temporal(Mayo Clinic). JAMIA 2016. DOI: 10.1093/jamia/ocv113
- DeepPhe: A Natural Language Processing System for Automated Cancer Phenotyping. arXiv:1902.06752, 2019
- Harvard hNLP Center 数据集页与加入流程 — healthnlp.hms.harvard.edu
- i2b2 2012 Temporal Relations Challenge 任务页 — i2b2.org/NLP/TemporalRelations
- Anafora 标注工具仓库 — github.com/weitechen/anafora
§10.4 人工校验记录
| 内容模块 | 审核者 | 审核方式 | 审核状态 |
|---|---|---|---|
| INFOBOX 与 frontmatter 数字 | 千方病案医学编辑部 | 对照 FACTS.md 逐字段核对来源 URL | ✅ 已通过 |
| §2 医学背景(ICD-11/SNOMED 映射) | 千方病案医学编辑部 | 编码对照标准术语库 | ✅ 已通过 |
| §4 DAIMS 数据字典 | 医疗 AI 数据工程师 | 对照仓库 README 与 Anafora 格式文档 | ✅ 已通过 |
| §5 划分与泄漏分析 | 医疗 AI 数据工程师 | 对照 SemEval 任务论文划分口径 | ✅ 已通过 |
| §6 预处理与 DataLoader 代码 | 医疗 AI 数据工程师 | 逻辑走查 + anafora API 核对 | ✅ 已通过 |
| §7 DAIMS 24 项与偏倚分析 | 千方病案医学编辑部 | 逐项复核评分依据 | ✅ 已通过 |
| §8 基准数字与引用 | 千方病案医学编辑部 | 对照 ACL Anthology 原文页 | ✅ 已通过 |
| §C JSON-LD 结构 | 数据工程师 | JSON 语法与 schema_org 一致性校验 | ✅ 已通过 |
§10.5 AI 生成章节标注
本页面全部章节由 AI 生成初稿,经上表所列人工审核后发布。其中 §6.5 坑点与 §7.7 DAIMS 评分表为 AI 依据检索事实结构化归纳,评分判断已由人工复核。
§10.6 最后人工审核日期
最后人工审核日期:2026-09-05(与 §0 审核声明一致)
页面状态:published(全部内容已完成审核并发布)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- cantemist — 共享标签:医疗NLP / 临床文本 / 命名实体识别 / 肿瘤学
- radgraph — 共享标签:医疗NLP / 临床文本 / 命名实体识别 / 关系抽取
- carmen — 共享标签:医疗NLP / 临床文本 / 命名实体识别 / 肿瘤学
- pharmaconer — 共享标签:医疗NLP / 临床文本 / 命名实体识别
- coral — 共享标签:医疗NLP / 临床文本 / 关系抽取 / 肿瘤学
- meddoprof — 共享标签:医疗NLP / 临床文本 / 命名实体识别
- bc5cdr — 共享标签:医疗NLP / 命名实体识别 / 关系抽取
- distemist — 共享标签:医疗NLP / 临床文本 / 命名实体识别
- umls — 共享标签:医疗NLP / 临床文本 / 命名实体识别
- biored — 共享标签:医疗NLP / 命名实体识别 / 关系抽取
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
