信息速览
So3D 是一个把连续切片拼成三维的资源库。它收的不是新测的数据,而是已经发表、以二维切片形式存在的空间转录组数据:72 套数据集、四物种、15 种组织、5 类疾病、882 张切片,合计逾百万个空间位点,另配 28 套单细胞参考数据。2026 年 1 月,它和 JoGo 一起被《核酸研究》数据库专刊选为两篇 Breakthrough 之一。
它的价值不在数据本身新,而在把「一堆各自独立发表的二维切片」整理成结构一致的、能跨切片查询的三维对象,并把五个分析模块打包成免注册的网页工具。对没有计算资源、也不想自己跑配准流程的课题组,这是目前少有的现成入口。
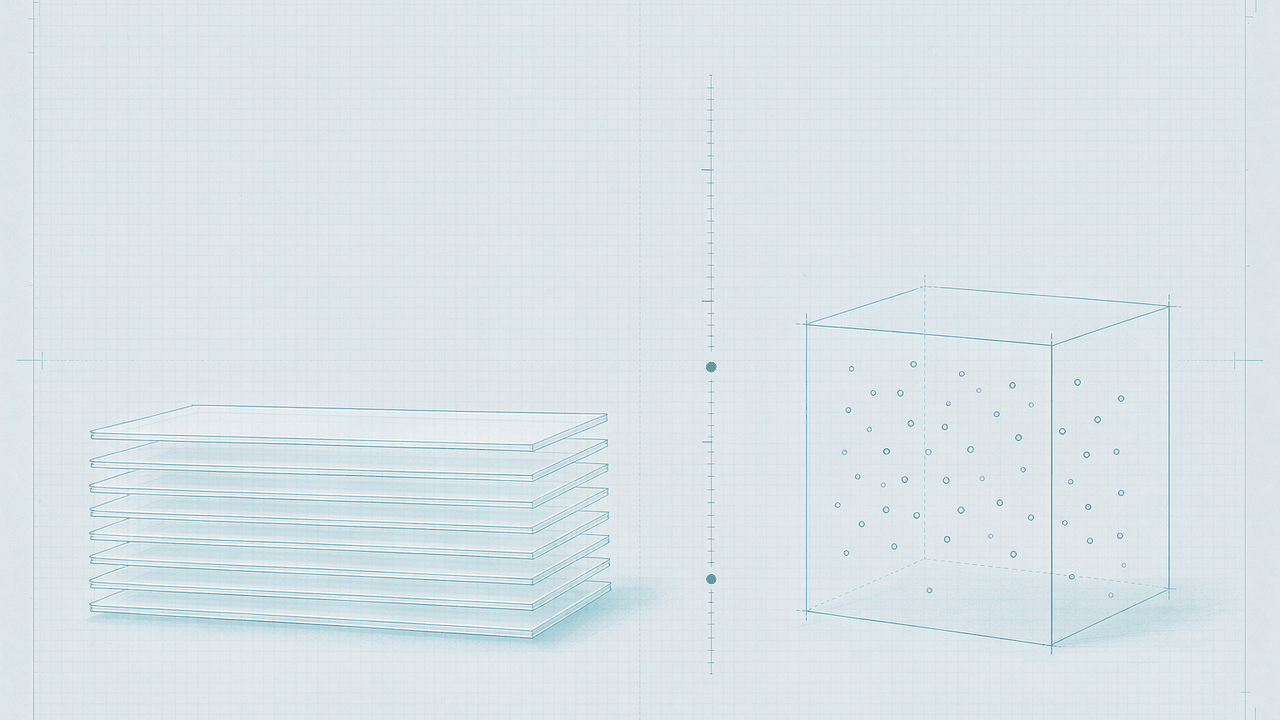
但它的名字里那个「三维」需要先卸掉一层误解。So3D 不是原生三维采集,它是切片堆叠派的代表性工程;z 轴在文件里只是切片序号换算出来的一个数,不是测量轴。本文围绕这一点展开,先定位、再看结构、最后讲边界。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 官方名称 | So3D: a comprehensive three-dimensional spatial omics resource for decoding tissue architecture in physiology and disease |
| 中文常用名 | 三维空间组学资源库 / 三维空间转录组数据库 |
| 开发机构 | 哈尔滨医科大学 生物信息科学与技术学院(王利、宁尚伟团队) |
| 论文出处 | Nucleic Acids Research 2026, 54(D1): D1281–D1290;DOI 10.1093/nar/gkaf998;PMID 41062448 |
| 学术定位 | NAR 2026 数据库专刊两篇 Breakthrough 之一(另一篇为 JoGo) |
| 入口 | http://so3d.bio-database.com/ (旧入口 bio-bigdata.hrbmu.edu.cn/So3D 会自动跳转) |
| 数据集规模 | 72 套(人 30 / 果蝇 33 / 小鼠 5 / 墨西哥钝口螈 4) |
| 组织与疾病 | 15 种组织、5 类疾病(乳腺癌、类风湿关节炎、结直肠癌、胆管癌、胰腺导管腺癌) |
| 位点与切片 | 1,132,902 个位点,882 张切片,单套平均一万五千余位点 / 12 张切片 |
| 单细胞参考 | 28 套、七十余万个细胞、77 种细胞类型 |
| 技术路线 | 连续切片二维空间转录组 → ICP/PASTE 配准 → STitch3D 反卷积 → Louvain 聚类 |
| 文件交付 | 每套三张 CSV:表达矩阵、元数据、三维坐标 |
| 在线模块 | Domain3D、CellType3D、SpatialDEG3D、Function3D、Communication3D |
| 访问与许可 | 免注册;论文 CC BY-NC 4.0;站点未单独声明数据许可 |
| 适合 | 三维空间域研究、跨切片整合方法开发、肿瘤微环境三维叙事、教学演示 |
| 不适合 | 需要真实 z 分辨率的三维重建、单细胞级分辨的注释、原生三维采集方法评测 |
§1 它要解决的具体麻烦
1.1 空间转录组的数据一直是二维的,而组织从来不是
一张 10x Visium 切片给出的信息是:在这个 6.5 毫米见方的组织切面上,几千个直径 55 微米的点阵位置各自测到了多少条转录本。它对这个切面之下的组织一无所知,也对之上的一无所知。生物学问题却几乎都不是切面内的:肿瘤从导管壁向间质浸润是沿着一个方向推进的,胚胎的三胚层是上下叠的,脑皮层的六层是纵向排列的。研究者只能靠做连续切片、把每张单独测、再想办法拼回去。
拼回去这件事本身就是个专门的工程问题。切片在物理上是分开的:切下来、贴到玻片上、染色成像、再做透化与建库。每一步都带来形变,有的拉伸有的压缩,有的位置还有撕裂。相邻两张切片的同一个结构,坐标不会天然对上。所以「把连续切片拼成三维」需要先做配准(registration),也就是求一个变换,让相邻切片的点布局尽量吻合,然后再把整摞切片放进同一个坐标系。
So3D 解决的就是这后一段。它把散落在 GEO、HTAN、CNGB STOmicsDB 等仓库里的、已经发表过的连续切片数据集收集起来,用统一流程(迭代最近点或 PASTE 做配准、STitch3D 做反卷积、Louvain 做聚类)重跑一遍,产出三样东西:统一的坐标、统一的细胞类型标签、统一的空间域标签。这样跨数据集比较才有可能。
1.2 三条常见的错误期待
第一条:以为「三维」意味着 z 轴是测出来的。 这是最容易踩的一条。原生三维采集(比如把组织透明化后用光片显微镜逐层扫描,或者在整块厚组织里直接做原位测序)确实在 z 方向有连续的采样。So3D 不属于这一类:它的每一层都是一张独立的二维切片,z 只是一个把切片排好序的编号。翻开源码里的坐标文件就能看清这一点:一套数据集里 z 只有几个离散取值,个数正好等于切片数。
第二条:以为样本量大就等于分辨率高。 72 套、882 张切片、逾百万位点,这些数字听起来很大。但位点的密度是平台给的:Visium 的位点中心间距在 100 微米左右,每个位点覆盖十几个细胞。So3D 做的反卷积是从单细胞参考里推断每个位点的细胞组成比例,不是说它测到了单细胞。超过一百万个位点,仍然是一百万个「细胞混合物」的测量。
第三条:以为网页上能点出来的分析结果就等于预训练语料。 五个模块是给人做探索的:点一下数据集,看三维空间域的分布,看某个基因的表达在哪里高。这种交互式结果适合形成假设,不适合直接当作监督信号。要训练模型,还是得下 CSV 自己重做标注,而且要知道这些标注是算法产出的、不是人工标注的。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 一批已经配准好的三维空间转录组坐标 | 每套数据集一张 x/y/z 坐标表,跨切片已对齐 | 够,省掉自己跑 PASTE 的工作量 |
| 统一的细胞类型标签 | 每个位点七类细胞的比例与一个主标签 | 部分够,粒度只到上位类,无亚型 |
| 统一的空间域标签 | 每个位点一个 cluster 编号,全套数据集共用 resolution=0.5 | 够,但只此一种参数设定 |
| 与单细胞数据对照 | 每套数据集配一套或多套 scRNA-seq 参考,共 77 种细胞类型 | 够,但配对规则不透明 |
| 原生三维采集、真实 z 分辨率 | 无,全部是切片堆叠 | 不够,这是路线差异不是数据缺口 |
| 单细胞级空间分辨 | 无,位点是多细胞混合物 | 不够,需要 Xenium、MERFISH 一类平台的数据 |
| 统一的训练/验证划分 | 未提供 | 不够,需自建且要按数据集分组避免泄漏 |
| 明确的复用许可 | 站点未声明,需回溯原始仓库 | 不够,法务上要逐个数据集核对 |
| 可直接调用的查询接口 | 站点无文档化的 REST API,数据靠 CSV 直链 | 部分够,可用目录抓取脚本自建索引 |
| 疾病覆盖广的泛癌基准 | 乳腺癌 10 套、类风湿 6 套,其余各 1 到 4 套 | 不够,长尾极重 |
1.4 你的处境与它能帮到的事
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 手上有几套自己做的连续切片,想找个成熟流程对标配准与聚类结果 | 提供了全库统一的处理流程(ICP/PASTE + STitch3D + Louvain 0.5)与每套数据的成品标签 | 先按 §5.4 下载同类组织的两套数据,复算一遍与自己流程的 ARI 差异 |
| 不想写配准代码,只想验证一个「某基因在三维空间里呈层状分布」的假设 | 网页上可以直接看基因表达的三维分布,免注册 | 用 Domain3D 与 SpatialDEG3D 各看一次,再决定是否值得自己重跑 |
| 在做三维空间组学的方法研究,需要一个覆盖面广的评测集 | 72 套跨物种数据,其中 33 套果蝇胚胎发育序列天然带时间轴 | 按物种与组织分层抽样,避免被果蝇胚胎数据主导指标 |
| 课题要写肿瘤微环境的三维故事,缺一张能进论文的三维示意图 | 提供了现成的三维空间域与细胞类型分布可视化 | 自己重画,不要直接截网页图;引用时注明来源于 So3D |
| 需要可以做预训练的三维组学语料 | 提供了统一格式的坐标、表达矩阵与标签 | 先解决各向异性与稠密矩阵两个工程问题,再考虑规模 |
| 需要单细胞级分辨的空间数据 | 它给不了 | 转向 Xenium、MERFISH、CosMx 等平台的数据集或库内 amygdala-spatial-atlas 这类资源 |
| 数据要进商业产品,法务要求链路清楚 | 论文的 CC BY-NC 4.0 与站点未声明许可形成冲突 | 逐个数据集回溯原始仓库许可,宁可放弃无法追溯的几套 |
1.5 一句话判断
So3D 是一份可靠的「切片合成三维」工程样本,也是一份不可靠的「三维分辨率」宣传样本;把它当坐标与标签的批发市场,可以省下几个月;把它当原生三维数据的替代品,会在第一个三维卷积层上翻车。
1.6 不适合谁:四条边界
不适合需要真实 z 向分辨率的形态学研究。 组织学里的分层判断(皮层第几层、肿瘤浸润深度、胚胎三胚层边界)依赖纵向的连续采样。So3D 的纵向采样点等于切片数,切片间距又由实验者决定,且官方没有公开每套的切片厚度。用它画出来的三维形态在 z 向一定是阶梯状的。
不适合需要单细胞级注释的任务。 位点是多细胞混合物,标签来自反卷积后的 argmax。这个标签的性质是「这个位点里占比最高的细胞类型是谁」,不是「这个细胞是什么」。做细胞亚型分辨、稀有细胞检测、细胞状态细分的工作,会在这一层就失去分辨能力。
不适合拿果蝇以外的物种做「跨物种通用性」结论。 72 套里 33 套是果蝇胚胎,哺乳动物合计只有 35 套,人脑仅 4 套。如果用全库混合统计得出「方法在跨物种上稳健」,实际是被果蝇胚胎发育序列的高密度采样主导了。
不适合需要明确商用许可的场景。 论文是 CC BY-NC 4.0,即禁止商业使用;站点本身没有数据许可声明。两者叠加的结果是:你既不能援引站点授权,也不能援引论文许可去为数据商用背书,只能回溯每个原始仓库。
§2 数据构成与规格
2.1 三层结构:数据集、切片、位点
So3D 的组织单位是「数据集」(dataset),命名规则是「疾病或组织,物种,3Ddataset_序号」,例如 BRCA,Human,3Ddataset_1。一个数据集来自同一项研究的同一批连续切片,通常对应一篇论文的一个图或一个补充材料。数据集之下是切片(slice),切片之下是位点(spot)。
这个三层结构决定了后面所有的取数动作:网页上的浏览以数据集为行,下载以数据集为文件单位,分析以位点为原子记录。你需要记住的只有一件事——三张 CSV 的主键同源,都是 spot_id,而 spot_id 的末尾带着切片序号,切片序号又决定了 z 值。
| 层级 | 单位 | 标识方式 | 单套数量范围 | 全库合计 |
|---|---|---|---|---|
| 研究层 | 数据集 | 疾病,物种,3Ddataset_N |
1 套起,按论文图拆分 | 72 套 |
| 采集层 | 切片 | spot_id 末尾 -sliceK |
2 到 74 张 | 882 张 |
| 位点层 | spot | Visium 式条形码 | 数百到六万余 | 逾百万 |
| 参照层 | 单细胞数据集 | 疾病,物种,scRNA_N |
0 到 4 套 | 28 套 |
2.2 字段与记录的完整字典
下载页把四张表的字段分别列出。下面这张表把站点 download.jsp 中可见的列名与三张实体 CSV 的真实表头合在一起,逐项说明含义与可用的取值。
| 表 | 字段名 | 类型 | 含义 | 取值或范围 | 备注 |
|---|---|---|---|---|---|
| 数据集索引 | Dataset | 字符串 | 数据集名称 | BRCA,Human,3Ddataset_1 形式 |
逗号是名称的一部分,URL 里必须转义 |
| 数据集索引 | Species | 字符串 | 物种 | Human / Mouse / Drosophila / Axolotl | 驼峰写法,大小写敏感 |
| 数据集索引 | Disease | 字符串 | 疾病 | 五类缩写加全称,健康组织写作 / |
有一处写作 null 字符串 |
| 数据集索引 | Organ | 字符串 | 器官 | Breast、Bone、Brain、Heart 等 15 类 | 人脑有两条写法并存 |
| 数据集索引 | SliceNumber | 整数 | 切片数 | 2 到 74 | 与坐标里 z 的取值个数相同 |
| 数据集索引 | SpotNumber | 整数 | 位点数 | 数百到六万余 | 与表达矩阵的列数相同 |
| 数据集索引 | Cluster number | 整数 | 三维空间域个数 | 3 到 20 余 | Louvain resolution=0.5 |
| 数据集索引 | Celltype number | 整数 | 注释到的主细胞类型数 | 3 到 11 | 由反卷积 argmax 汇总 |
| 数据集索引 | PMID | 字符串 | 原始论文编号 | 13 个不同值 | 多套数据集可共享一个 PMID |
| 数据集索引 | Accession | URL | 原始数据登记号或仓库页 | GEO、HTAN、CNGB 等 | 存在同一登记号重复挂 15 套的情况 |
| 表达矩阵行 | 基因符号 | 字符串 | 基因标识 | 首格为空,行为基因 | 宽表,基因在行 |
| 表达矩阵列 | spot_id | 字符串 | 位点标识 | CACTCCTCTCGGTCGG-1-slice0 |
与坐标表、元数据表严格一一对应 |
| 元数据列 | 七类细胞比例 | 浮点 | 反卷积得到的细胞组成 | 0 到 1,每行和为 1 | 类别名带下划线,如 T_cell |
| 元数据列 | louvain | 整数 | 潜表示上的聚类编号 | 0 到 20 余 | 与 Cluster 的编号体系不同 |
| 元数据列 | Celltype | 字符串 | 上位细胞类型 | 七个类别之一 | 等于七类比例的最大项 |
| 元数据列 | Cluster | 字符串 | 空间域标签 | cluster4 形式 |
前端配色与三维视图按它分组 |
| 坐标表列 | x | 浮点 | 横轴坐标 | 万级浮点 | 单位未在文件内标注 |
| 坐标表列 | y | 浮点 | 纵轴坐标 | 万级浮点 | 与 x 同一量级 |
| 坐标表列 | z | 浮点 | 纵轴(切片向)坐标 | 同一切片内恒定 | 本质是切片序号乘一个步长 |
2.3 一条记录的完整解剖
取 BRCA,Human,3Ddataset_1,三个文件各抽一行,可以看到同一个位点在三张表里如何互相咬合。下面是三张表的真实表头与首行(数值原样保留,未做四舍五入)。
#-- 文件一:upload/coordinates/BRCA,Human,3Ddataset_1_coordinates.csv
,x,y,z
CACTCCTCTCGGTCGG-1-slice0,12941.0,4692.0,0.0

#-- 文件二:upload/metadata/BRCA,Human,3Ddataset_1_metadata.csv
"","B_cell","Endothelial_cell","Epithelial_cell","Fibroblast","Macrophage","T_cell","Tumor_cell","louvain","Celltype","Cluster"
"CACTCCTCTCGGTCGG-1-slice0",0.00051244034,0.075953126,0.00476492,0.039029215,0.04328522,0.3471659,0.48928913,5,"Tumor_cell","cluster4"

#-- 文件三:upload/expression/BRCA,Human,3Ddataset_1_expression.csv
,CACTCCTCTCGGTCGG-1-slice0,TCACTCGTGCAACGGC-1-slice0,CAGCCTCTCCTCAAGA-1-slice0
注意三个细节。第一,坐标表与元数据表的首列都没有列名,是一个空字符串,读进来会变成一个名为 Unnamed: 0 的列,必须显式重命名。第二,元数据表的列名带了双引号,因为里面有下划线但不含逗号,实际 pandas 会自动去掉引号。第三,表达矩阵是基因在行、位点在列,与单细胞分析里常见的「细胞在行、基因在列」相反,转置是第一步。
这个位点的七类比例加起来等于一,最大项是 Tumor_cell(0.489),所以 Celltype 是 Tumor_cell;louvain 是 5,但 Cluster 是 cluster4——两套编号不是一回事,前者来自 STitch3D 潜表示上的聚类索引,后者是发布时重新编号的空间域标签。作图时用 Cluster。
2.4 规模与构成的分布形态
下面的表只写「够不够规划算力与筛选」这件事需要的量级,不列百分位。
| 统计项 | 数值 | 口径 |
|---|---|---|
| 数据集总数 | 72 | 下载页元数据数组行数 |
| 物种构成 | 果蝇 33、人 30、小鼠 5、墨西哥钝口螈 4 | 同上 |
| 组织构成 | 果蝇胚胎 33、乳腺 10、骨 6、人脑 4、端脑 4、心 3 等 | 同上 |
| 疾病构成 | 健康或未标注 49、乳腺癌 10、类风湿 6、结直肠癌 4、胆管癌 1、胰腺癌 1 | 同上 |
| 切片数区间 | 2 到 74,合计 882 | 论文与方法节一致 |
| 切片数最常见 | 2 张(12 套)、4 张(8 套)、16 张(6 套) | 下载页统计 |
| 位点数区间 | 数百到 63,603 | 论文称果蝇幼虫最多 |
| 单套平均 | 约一万五千位点 / 12 张切片 | 论文统计口径 |
| 单细胞参考 | 28 套、77 种细胞类型 | 论文 |
| 原始文献数 | 13 个不同 PMID | 下载页,存在一文献多套的情况 |
2.5 与同类资源的字段差异
在空间组学这一层,So3D 不是唯一的库,但它对「三维」的处理方式是独特的。下表把四类相邻资源和它的差别摆在一起。
| 资源 | 基本单位 | 是否跨切片 | 三维坐标 | 主要交付 | 与本库的关系 |
|---|---|---|---|---|---|
| So3D | 三维数据集(多切片合成) | 是,做了配准 | 有,x/y/z 三列 | 三张 CSV + 网页分析 | 本页主体 |
| 常规二维空间转录组库 | 单张切片或单次实验 | 否,切片各自独立 | 只有 x/y | 表达矩阵与图像 | 是 So3D 的上游数据源 |
| 单细胞图谱库 | 细胞 | 不适用 | 无空间 | h5ad 稀疏矩阵 | 是 So3D 的注释参照 |
| 原生三维采集数据集 | 厚组织体数据 | 不适用,一次采集成体 | 有,z 连续 | 体素化表达与图像 | 与 So3D 是路线对立面 |
| 病理-空间配对库 | 切片与全切片图像对 | 否 | 只有 x/y | 图像 + 表达 + patch | 可在图像层补 So3D 的缺口 |
§3 它要解决的具体麻烦之外的定位
3.1 它在三维空间组学里的位置:集成层,不是测量层
把空间组学的生态按「谁产生数据」和「谁整理数据」排两列,So3D 明确站在整理这一列,而且是最靠上的一层——它整合的是已经被别人整理过一轮的切片数据集。这一点决定了它的一切特性:它做不到比原始切片更高的分辨率,也不会比原始研究更了解样本的采集条件,但它能做到原始研究做不到的事——把不同实验室、不同物种、不同组织的切片放进同一套坐标系和分析流程里。
NAR 2026 的编者按把这件事讲得很清楚:多数数据库把分析限制在二维切片之内,So3D 把分析推进到切片之间的第三维。这句定位描述的是分析动作的跨度,不是采集动作的跨度。
3.2 原始数据的来源谱系
看下载页的 Accession 列,能看清这批数据从哪来。13 个不同的 PMID 对应 72 套数据集,其中一处登记号(HTAN 的一项乳腺癌研究)下挂了 15 套数据集,一处 CNGB 的果蝇三维图谱页挂了 28 套。这种「一篇论文拆成多套」的做法在整理型数据库里很常见,好处是每套数据集的切片数适中、便于单套分析;坏处是「72 套」这个数字被同一项研究的多个视图抬高了,跨数据集比较时要注意同一研究内部的数据集高度相关。
| 来源类型 | 代表仓库 | 挂载的数据集数(下载页可见) | 说明 |
|---|---|---|---|
| 肿瘤图谱联盟 | HTAN | 15 套乳腺相关 | 同一登记号下多套 |
| 国家基因库三维图谱 | CNGB STOmicsDB | 28 套果蝇 + 4 套钝口螈 | 果蝇胚胎与幼虫为主体 |
| 基因表达总库 | GEO | 若干,按 GSE 号 | 常规单篇研究提交 |
| 单细胞门户 | Broad Single Cell Portal | 6 套类风湿 | 与论文配对提供 |
| 其他 | 各期刊补充材料 | 余数 | 部分仅链到论文页 |
3.3 身份的三个可核验标记
判断一份来源不明的数据是不是 So3D 的产物,看三个标记就够了。第一,数据集名称是否符合「疾病,物种,3Ddataset_N」的逗号格式;第二,spot_id 是否以 -1-sliceK 结尾;第三,坐标表是否恰好三列且第三列在同一切片内恒定。三个条件同时满足,基本可以确定出自这里。
3.4 三组需要区分开的数字
最容易混淆的是三组数字的口径。72 是数据集,不是样本,也不是患者;882 是切片,不是时间点,虽然果蝇胚胎的连续切片在发育研究里常被当作准时间轴使用;逾百万是位点,不是细胞,位点是多细胞混合物。任何向下游写的文字,只要把这三组里的任意两个混用,结论就会偏一到两个数量级。
§4 三维到底有多「真」
4.1 配准是这套数据真正的技术含量
切片之间怎么对齐,决定了三维结构能不能用。So3D 用的是两条路线:迭代最近点(ICP)与 PASTE。前者是经典的刚体配准,按点的空间分布迭代求解旋转平移;后者是专门为空间转录组设计的最优传输方法,能同时考虑表达相似性与空间邻近性。
配准之后还要解决批次效应:不同切片在不同时间测序,深度、效率都有差别。So3D 的做法是把每套数据集的切片与单细胞参考一起喂进 STitch3D,让模型在潜空间里同时消除批次并做反卷积。这一步的产出就是元数据表里的七类比例。
需要强调的是,这套流程的产出不是「测出来的三维」,而是「对齐后的二维序列加上一个被推断出来的潜表示」。它的可靠性完全取决于配准与反卷积的质量,而这两步在官方页面上都只给了参数、没给逐数据集的质控指标。
4.2 案例:BRCA 第一套的两层 z 与七个细胞比例
拿 BRCA,Human,3Ddataset_1 拆一遍,是理解 So3D 的最快路径。这套数据集有 2 张切片、3341 个位点、7 种细胞类型、7 个空间域。
坐标文件里,3341 个位点的 z 只有两个取值:0.0 与 19.84。前一张切片占 2049 个位点,后一张占 1292 个。x 与 y 的跨度都在 1.38 万到 1.40 万的量级(文件内未标单位,按 Visium 常规尺度推测为微米,但这是推测不是核实)。把这两个数放在一起:横向跨度约一万三千米量级的同一数位,纵向跨度 19.84,采样点从数千个降到 2 个。
这就是「各向异性」的具体样子。如果在三维可视化里直接按原值画,会看到一个极扁的薄片——这恰好是对的,因为真实组织切片本来就薄。但如果做三维邻域计算,用欧氏距离找邻居,z 方向的 19.84 会被当成与 x/y 同量级的一步,结果所有「邻近」关系都会被纵向拉成柱状。正确的做法是先把 z 乘以一个缩放因子,把它换算到与 x/y 相同的物理单位,再建邻域图。
元数据那一侧,七个细胞类型的比例在同一套数据集里对每个位点都有值。案例里这个位点是肿瘤细胞主导(0.489),T 细胞次之(0.347)。这套数据集的空间域有 7 个,而论文正文里专门分析的那套乳腺癌数据只有 3 张切片、1729 个位点、5 个空间域,识别出 B 细胞与巨噬细胞富集于免疫区、肿瘤细胞主导肿瘤区,并把 IGHA1 与 DHCR24 标为区域特异基因。两套数据不是同一套,引用时不要混。§4.2 的案例后面还会在 §5、§7 与附录 D 里再被引用一次,用来说明取数与校验的完整链路。
4.3 特色:把分析做进网页,让不会写代码的人也能出结果
Domain3D 看空间域在三维里的分布,CellType3D 看细胞类型的三维富集,SpatialDEG3D 找区域特异基因并回投到二维切片与单细胞数据里验证,Function3D 做 GO、KEGG 与细胞状态集的富集,Communication3D 推断配体受体对。这五个模块对应了空间组学论文里最常出现的五张图,把它们做成一键出图,对教学和快速探索的价值很实在。
这也解释了它为什么能进 Breakthrough:一个领域往往缺的不是一篇新方法论文,而是一个让非方法学家也能用上方法的入口。
4.4 特色:跨物种的对照
72 套里果蝇占接近一半,这在哺乳动物数据昂贵的时期是一种有效的策略:果蝇胚胎的发育序列切片多、时间长、结构规整,是做三维配准算法验证的天然材料。墨西哥钝口螈的端脑数据提供了再生生物学视角的补充。对做发育的人,这批数据的价值高于任何单一组织的人体数据。
4.5 两个软肋
第一个软肋是质控指标不透明。整套流程有大量可调参数,官方只公开了 Louvain 的分辨率(0.5)与 STitch3D 的优化默认值,没有提供逐数据集的配准残差、聚类稳定性或反卷积置信度。这意味着下游无法判断某一套数据的标签有多可信。
第二个软肋是稠密矩阵。表达矩阵以 CSV 宽表发布,基因在行、位点在列,全部数值写满。科学计数法省不了多少字节,中等规模的一套就有数十 MB,全库累计是几个 GB 级到十几个 GB 级。相比同规模的稀疏 h5ad,这是数十倍的存储开销。
§5 怎么把它取到手
5.1 三条取数通道
| 通道 | 入口 | 适用场景 | 限制 |
|---|---|---|---|
| 网页交互 | 五个模块的 jsp 页面 | 探索、出图、教学 | 结果无法程序化导出,需人工截图或抄表 |
| 三张 CSV 直链 | upload/expression/、upload/metadata/、upload/coordinates/ |
全量下载、重跑分析 | 需先从下载页拿到文件名清单 |
| 下载页元数据数组 | download.jsp 内嵌的四个 JS 数组 |
自建索引、批量筛选 | 数组写在页面里,随页面改版失效 |
站点没有文档化的 REST API。所有批量操作都要从 download.jsp 解析出那四个数组,拿到 72 套数据集的名称与文件路径,再拼 URL。这是本页所有脚本的前提。
5.2 把目录拉成一张表
下面的脚本只做一件事:抓下载页、解析内嵌数组、合并成一张 72 行的 DataFrame。注意站点在 http 下稳定可达,https 入口在部分网络下无法握手。
#-- 需求:Python 3.9+,pandas,requests
import re, requests, pandas as pd

BASE = "http://so3d.bio-database.com"
PAGE = BASE + "/download.jsp"
UA = {"User-Agent": "Mozilla/5.0 (compatible; dataset-indexer/1.0)"}

html = requests.get(PAGE, headers=UA, timeout=60).text

def parse_array(name):
    #-- 抓取 var 与 = [ ]; 之间的对象数组
    m = re.search(r"var " + name + r"\s*=\s*\[(.*?)\n\s*\];", html, re.S)
    rows = re.findall(r"\{([^}]*)\}", m.group(1))
    out = []
    for r in rows:
        out.append(dict(re.findall(r'(\w+):\s*"([^"]*)"', r)))
    return pd.DataFrame(out)

idx     = parse_array("datasetRecords")    #-- spotnumber, expression
meta    = parse_array("datasetRecords2")   #-- celltypenumbr, clusternumber, metadata
coord   = parse_array("datasetRecords1")   #-- slicenumber, coordinates
ref     = parse_array("datasetRecords4")   #-- cells, accession

table = (idx[["dataset", "species", "disease", "organ", "spotnumber", "expression"]]
         .merge(meta[["dataset", "celltypenumbr", "clusternumber", "metadata"]], on="dataset")
         .merge(coord[["dataset", "slicenumber", "coordinates"]], on="dataset"))

table["spotnumber"] = table["spotnumber"].astype(int)
table["slicenumber"] = table["slicenumber"].astype(int)
table["cells_per_spot"] = None
table.to_csv("so3d_index.csv", index=False, encoding="utf-8-sig")
print(table.shape, table["spotnumber"].sum(), table["slicenumber"].sum())
print(ref.assign(cells=ref["cells"].astype(int))["cells"].sum())
跑完会打印两组核对数:位点总数与切片总数。它们应当回到官方口径,差一位就说明页面结构改过了。
5.3 下载一套并读进内存
文件名里带逗号,直接拼 URL 会被服务端按路径切分,必须做百分号转义。三张表的主键不同名(首列是空字符串),读进来要统一改名为 spot_id。
#-- 继续上一段,table 已在内存中
import urllib.parse, pandas as pd, requests

UA = {"User-Agent": "Mozilla/5.0 (compatible; dataset-fetcher/1.0)"}
row = table.query("dataset == 'BRCA,Human,3Ddataset_1'").iloc[0]

def fetch(rel_path):
    url = BASE + "/" + urllib.parse.quote(rel_path, safe="/")
    r = requests.get(url, headers=UA, timeout=120)
    r.raise_for_status()
    return url

paths = {
    "expr": fetch(row["expression"]),
    "meta": fetch(row["metadata"]),
    "coord": fetch(row["coordinates"]),
}

expr  = pd.read_csv(paths["expr"], index_col=0)          #-- 行=基因,列=spot
meta  = pd.read_csv(paths["meta"]).rename(columns={"Unnamed: 0": "spot_id"})
coord = pd.read_csv(paths["coord"]).rename(columns={"Unnamed: 0": "spot_id"})

assert set(expr.columns) == set(meta["spot_id"]) == set(coord["spot_id"]), "三表主键不一致"
print(expr.shape, meta.shape, coord.shape)
print(coord.groupby(coord["spot_id"].str.split("-slice").str[-1])["z"].nunique())
最后一行是这套数据最关键的一次自检:按切片分组数一数 z 有几个不同取值。正确答案是每组恰好一个,说明 z 在同一切片内恒定——§4.2 的案例观察到的两层 z 由此得到程序化确认。
5.4 各向异性校正:把 z 换算到物理单位
官方没有公布切片厚度,所以这一步必须由使用者按实验背景指定。Visium 切片常见的厚度是 10 微米,加上贴片压缩后有效间距会更大。下面的函数把 z 按用户给定的厚度缩放,同时把 x/y 归一化到微米(前提是文件里的 x/y 已经是微米,这一点在 §7.3 里作为未核实事项列出)。
#-- 输入:coord 来自 §5.3;slice_um 为该套切片的物理厚度估计
import numpy as np

def isotropize(coord, slice_um=10.0, xy_is_um=True):
    df = coord.copy()
    xy_scale = 1.0 if xy_is_um else coord[["x", "y"]].max().max() / 6500.0
    df["x"] *= xy_scale
    df["y"] *= xy_scale
    #-- z 是切片序号乘步长,先还原成序号再乘真实厚度
    zs = np.sort(df["z"].unique())
    step = (zs[1] - zs[0]) if len(zs) > 1 else 1.0
    df["slice_no"] = np.round((df["z"] - zs[0]) / step).astype(int)
    df["z_um"] = df["slice_no"] * slice_um
    return df

c = isotropize(coord, slice_um=10.0)
print(c[["x", "y", "z_um"]].agg(["min", "max"]).T)
print("x/y 跨度与 z 跨度之比:", (c["x"].max() - c["x"].min()) / max(c["z_um"].max(), 1e-9))
这个比值是判断三维结构能不能「看起来像立体」的唯一凭据。比值在百倍以上时,任何不校正的三维可视化都是误导。
5.5 用 AnnData 承接,避免重复解析 CSV
下游若要用 scanpy 的生态,把稠密 CSV 转成稀疏的 h5ad 是必要的一步:既省内存也省磁盘,还让 .X 与 .obs、.obsm 的对应关系明确。
#-- 需要 anndata、scipy
import anndata as ad
import numpy as np
from scipy import sparse

X = sparse.csr_matrix(expr.T.values)          #-- 转置成 spot × gene
obs = meta.set_index("spot_id").loc[expr.columns]
obsm = {"spatial": coord.set_index("spot_id").loc[expr.columns, ["x", "y", "z"]].values}

adata = ad.AnnData(X=X, obs=obs, var=pd.DataFrame(index=expr.index))
adata.obsm["spatial_xyz"] = obsm["spatial"]
adata.uns["source"] = {"dataset": row["dataset"], "url": paths["expr"]}
adata.write_h5ad("BRCA_Human_3Ddataset_1.h5ad", compression="gzip")
print(adata)
注意 .obs 的重排:loc[expr.columns] 是必须的,三张表虽然主键集合相同,但行序不保证一致,不按同一顺序索引会在沉默中错位。
5.6 批量取数时的三个坑
第一,文件名带逗号,任何用 quote 之外的方式拼 URL 的做法都会 404。第二,站点只有 http 直链,没有断点续传保证,批量下载要加超时与重试。第三,datasetRecords 与 datasetRecords1 的编号不连续,前者是表达矩阵,后者是坐标,写脚本时不要按序号顺推。
§6 与库内条目的关系
6.1 关系图谱
| 库内条目 | 关系 | 具体怎么用 |
|---|---|---|
| hest-1k | 互补 | hest-1k 提供切片级 H&E 图像与表达的配对,So3D 提供跨切片的三维坐标与标签;两者可拼成「图像 + 三维结构」 |
| hubmap | 上游同类 | HuBMAP 采集原始空间数据,So3D 里的部分数据可从 HuBMAP 或 HTAN 系追溯 |
| amygdala-spatial-atlas | 同类不同路线 | 杏仁核图谱走的是单研究、多平台(含 Xenium)路线,细胞级分辨;So3D 走多研究汇总、位点级路线 |
| single-cell-portal | 注释参照源 | So3D 的 scRNA-seq 参考中有若干来自 Broad 门户,可回溯原始细胞注释 |
| human-cell-atlas | 注释参照源 | HCA 体系的细胞类型本体与命名可用于对齐 So3D 的七类上位标签 |
| cellxgene-census | 检索替代 | 需要稀疏、版本化的单细胞与空间语料时,Census 比 So3D 的稠密 CSV 好处理 |
| gtex | 组织表达基线 | 需要正常组织表达背景做对照时,用 GTEx 的组织级基线比用 So3D 的健康切片更稳定 |
| tcga | 疾病背景 | 乳腺癌、结直肠癌、胆管癌、胰腺癌的分子分型与生存信息在 TCGA 有,So3D 只有空间结构 |
6.2 检索路径
想找「三维空间转录组」相关资源时,按三条线索走。第一条按标签:转录组 + 单细胞基因组学 能捞出空间与单细胞两类;第二条按组织:乳腺、脑 这类器官词,库内多数页面在标题与副标题里写明器官;第三条按方法:搜「切片」「配准」「空间域」这类方法词,能定位到方法学相近的页面。So3D 在第二条与第三条线索上都容易被命中,在第一条上会与大量单细胞页面混在一起。
§7 质量评估与已知局限
7.0 阅读本节前的一个前置校正
评分之前要先校正一个误判:本页 §1 到 §5 反复强调「z 轴不是测量轴」,很容易被读成「So3D 的三维是假的、质量差」。这个推论不成立。配准后的跨切片结构是真实存在的组织连续性,只是它的纵向采样密度由切片数决定,而不是由仪器决定。把「各向异性」当成缺陷去扣分,是把技术路线的选择误判成了执行质量问题。
正确的读法是:So3D 在「汇总与统一的整理工作」这一维度上做得相当扎实(统一流程、统一命名、五个模块、免注册),在「纵向分辨率」这一维度上受路线限制无法做到原生采集的水平。前者是它可以被评分的部分,后者是它不该被评分的部分。下面的五维评分只针对前者与围绕它的工程细节。
7.1 DAIMS 五维评分
DAIMS 是数据资产与信息管理的评估框架,这里借它的五个维度给整库打分。分数只针对「作为三维整理层」的职能,不针对任何一套具体数据集,也不针对原始实验的采集质量。
| 维度 | 分数 | 判断依据 | 主要扣分点 |
|---|---|---|---|
| 可发现性 | 4 / 5 | 下载页与浏览页给出数据集、物种、疾病、器官、切片数、位点数六列,可按列排序 | 首页未展示任何规模统计,只给模块入口;检索只能靠列排序,没有关键词搜索 |
| 可访问性 | 3.5 / 5 | 免注册、三张 CSV 直链、http 通道稳定 | 无 REST API;https 入口在部分网络下握手失败;文件名为中文与逗号混用,需转义 |
| 互操作性 | 3 / 5 | 坐标与标签以纯 CSV 发布,语言无关;spot_id 与 Visium 条形码同构 | 无 h5ad 或 Parquet 版本;基因在行、位点在列,与主流单细胞约定相反;无本体映射 |
| 可复用性 | 3 / 5 | 流程参数公开(STitch3D 默认值、Louvain 0.5),标签可直接用于二次分析 | 站点未声明许可;无版本号;同一研究拆成多套,跨数据集复用要先做标签对齐 |
| 治理透明度 | 2.5 / 5 | 论文写清了配准、反卷积、聚类的三步流程与所用工具版本 | 无逐数据集质控指标;无采集日期与供者信息;无更新日志;无数据许可声明 |
五项平均接近 3.2,是一个「流程完整、文档不足」的典型形态。它的高分项都落在「把散的数据整理成能用的一份」这件事上,低分项全部围绕「下游怎么确认这份整理是对的」与「怎么合法复用」。
7.1.1 三个维度上的具体落差
把上面的分数拆到可操作层面,会得到三组需要使用者自己补的缺口。
第一组是文档缺口。可发现性给了 4 分,是因为字段够用,但够用不等于完整:切片数、位点数这些从数据里能数出来的列它都有,需要登记才知道的列(切片厚度、扫描倍率、组织处理方式、采集日期)它一列都没有。前者下游可以重算,后者不能。
第二组是格式缺口。互操作性失分不是因为格式冷门,而是因为格式太朴素:CSV 谁都能读,读进来之后却没有一处结构信息告诉你哪列是坐标、哪列是标签、哪些列构成主键,这些全散在帮助页文字里,需要人工翻译成代码里的假设。
第三组是治理缺口。治理透明度的 2.5 分是三组里最低的。这并不是说这个库有什么隐藏问题,而是说它没有建立让外部核对的通道:没有版本号就无法判断手上这份是不是最新的,没有更新日志就无法知道上一版有什么问题,没有许可声明就无法判断能否复用。
7.2 DAIMS 十二项逐项裁定
上面的五维是框架级的粗分,落到可执行的检查上,需要把框架拆成具体检查项。下面十二项是从 DAIMS 里挑出与三维整理层最相关的部分,逐项给状态与理由。状态用三档:通过表示这件事官方已经做到、使用者可以直接依赖;部分表示官方做了一半、另一半必须自己补;缺项表示官方没有做、且下游无法补。
| 序 | 检查项 | 状态 | 理由 |
|---|---|---|---|
| 1 | 主键唯一性 | 通过 | spot_id 在三张表内唯一,且含切片序号,天然带上层级信息 |
| 2 | 跨表对齐 | 通过 | 三表共用 spot_id,集合完全相同,可做集合比较验证 |
| 3 | 标识符可解析 | 通过 | 数据集名拆成 疾病、物种、序号 三段,切片号从 spot_id 尾部取 |
| 4 | 单位与尺度 | 缺项 | 坐标文件无单位说明,x/y 与 z 的单位一致性无法核实 |
| 5 | 时间戳 | 缺项 | 无采集日期、无切片制作日期、无数据入库日期 |
| 6 | 设备与方法记录 | 部分 | 论文写了配准与整合的方法,但逐数据集未标注测序平台、扫描倍率、切片厚度 |
| 7 | 标签语义 | 部分 | 七个细胞类型名固定且可解释,但只到上位类,无亚型与状态 |
| 8 | 标签来源与置信度 | 缺项 | 全部为算法标注,未提供逐位点置信度或后验分布 |
| 9 | 缺失处理 | 部分 | 健康组织写作 /,另有一处写作字符串 null,两种写法并存 |
| 10 | 版本记录 | 缺项 | 无版本号、无更新日志、无历史快照 |
| 11 | 许可声明 | 缺项 | 站点无 license 字段,仅论文有 CC BY-NC 4.0 |
| 12 | 数据划分建议 | 缺项 | 未提供任何训练测试划分,也未提示同一研究多套的泄漏风险 |
十二项里三档的分布是三项通过、四项部分、五项缺项。这个分布本身就是对库性质的描述:凡是「把数据排整齐」的项它做到了,凡是「告诉下游这份数据可不可信」的项它基本没做。前一类属于工程,后一类属于治理。
7.2.1 三项通过项为什么重要
多数整理型库在第三项上就倒了:数据集名是自由文本,切片号藏在别的文件里,下游必须逐个手工登记才能把三张表拼起来。So3D 的命名规则是一条可以正则解析的字符串,BRCA,Human,3Ddataset_1 用两个逗号分成三段,spot_id 用 -slice 切出切片号。这意味着批量处理可以在完全不打开文件的情况下完成索引构建,§5.2 的脚本只有几十行就是靠这一点。
第一项与第二项的价值在于可验证性。三张表主键同源,意味着你可以用一次集合比较确认这份数据没有在传输中损坏,也可以用一次集合比较发现某套数据的文件未同步更新。这是整理型库最容易忽略、也最能体现工艺水平的地方。
7.2.2 五项缺项的连带后果
第四项(单位)缺失的后果最直接:§5.4 的各向异性校正函数必须依赖一个外部假设,而这个假设无法从数据里核实。使用者只能在方法学里写明「按平台常识假设坐标单位为微米」,并承担假设失效的风险。
第八项(标签置信度)缺失影响的是下游任务的设计。反卷积给出的是一组比例,argmax 之后的标签丢掉了不确定性的信息。一个 0.49 对 0.35 的位点与一个 0.95 对 0.01 的位点,在元数据表里看不出差别。做二次分析时若要保留这层信息,只能用七列比例自行计算熵或边际,不能依赖标签列。
第十一与第十二项(许可与划分)属于治理层,缺失的后果是使用者必须自己建立规则。
7.2.3 动手前的三个决策问题
十二项检查之后还有三个问题,它们不属于「官方做没做」,而是「你必须自己定」。不解决这三个,前面所有检查都白做。
第一个问题是训练集怎么切。 一项研究贡献了 15 套、另一项贡献了 28 套。按数据集随机划分会让同一项研究的切片同时出现在训练与测试两侧,指标被高估。可选规则有三条:按 PMID 分组划分最保守,适合追求可信度;按物种分组划分适合考察跨物种迁移;先按切片数过滤再随机划分,适合只需要中等规模子集的任务。三条规则给出的测试集不同,报告时要写清用了哪一条。
第二个问题是标签的性质怎么交代。 位点标签是反卷积的 argmax,不是病理判读。方法学里至少要写三句话:标签由 STitch3D 反卷积后取最大比例得到、参考单细胞数据集的来源、标签只到七个上位类。缺了这三句,审稿环节会被直接问到,而且很难补。
第三个问题是数据集怎么固定版本。 站点没有版本号与更新日志。可复现的最低要求是下载时记录文件字节数与 sha256 摘要,附录 D 的第四段就是做这件事的。这份指纹不只是给复现用,也是判断「官方是否悄悄替换过数据」的唯一凭据。
7.3 已知的、可枚举的偏差
| 偏差 | 表现 | 影响 | 可缓解方式 |
|---|---|---|---|
| 物种偏差 | 果蝇 33 套,人 30 套,小鼠 5 套,钝口螈 4 套 | 「跨物种稳健」结论被果蝇主导 | 分层报告,按物种单独算指标 |
| 疾病长尾 | 乳腺癌 10 套、类风湿 6 套,其余各 1 到 2 套 | 无法做泛癌种比较 | 只选覆盖足够的癌种,其余作案例 |
| 组织偏斜 | 乳腺与骨合计 16 套,人脑仅 4 套 | 脑科学问题样本不足 | 与 amygdala-spatial-atlas 类单研究图谱互补 |
| 研究聚集 | 一研究挂 15 套、另一研究挂 28 套 | 数据集数被同一研究抬高 | 按 PMID 去重后再算有效样本 |
| 切片数偏少 | 12 套只有 2 张切片 | 两层的「三维」几乎只剩一个排序 | 三维分布分析先筛切片数 |
| 标注来源偏差 | 全部为算法标注 | 不能当人工金标准 | 用小规模人工复核做校准 |
| 单位与尺度未标 | 坐标文件无单位说明 | x/y 与 z 的单位一致性无法核实 | 按平台常识假设并显式声明 |
| 许可不确定性 | 站点无数据许可 | 商用链路无法闭环 | 逐个回溯原始仓库 |
7.4 外部验证矩阵
| 验证项 | 拿什么对 | 期望结果 | 不符时怎么办 |
|---|---|---|---|
| 数据集行数 | 下载页数组长度 vs 论文 72 套 | 都是 72 | 以页面为准,记录差异日期 |
| 位点总数 | 数组求和 vs 论文总量 | 应回到官方总量口径 | 说明存在筛选或更新 |
| 切片总数 | 数组求和 vs 论文 882 | 应一致 | 同上 |
| 单细胞总数 | 参照数组求和 vs 论文 | 应一致 | 同上 |
| 三表主键 | 集合比较 | 完全相同 | 说明该套数据未同步,跳过 |
| z 取值数 | 按切片分组去重 | 每切片一个值 | 若出现多值,说明该套数据的 z 是插值而非序号 |
| 空间域编号 | metadata 的 Cluster vs 前端 | 一致 | 以前端为准并记录 |
7.5 它为何能持续:靠整理层的低边际成本与教学入口的需求
整理型数据库的生存逻辑与测量型不同。测量型数据库要不断产生新数据,成本在测序与伦理;整理型数据库的边际成本主要在流程,一旦配准与聚类流水线跑通,新增一套数据集的增量工作是跑一遍流程加一次人工检查。这解释了 So3D 的两个特征:一是它能在一年内把 72 套数据统一处理完,二是它的未来路线写得很清楚——继续收新数据、加模块、扩到空间代谢组与空间基因组。
同时,它占据了一个不容易被替代的位置:不用写代码就能看三维空间域。对教学、对临床背景的研究者、对需要快速形成假设的人,这个入口的价值远高于再写一篇方法论文。只要空间组学的测序成本还在下降、连续切片实验还在增加,整理层的需求就不会消失。
§8 生态位与历史
8.1 从二维库到三维库的十年
空间转录组的公共资源大致走过了三代。第一代是单次研究的补充材料,数据跟着论文走;第二代是汇总型数据库,把不同研究的单张切片按物种与器官并列,代表是 STOmicsDB、SORC、CROST、SpatialDB、SpatialRef、SPASCER 这一类;第三代开始处理切片之间的关系,So3D 是这一代里第一个宣称自己是「综合三维资源」的。
在它之前,处理三维的尝试多是工具而非库:VT3D 做三维浏览,Flysta3D 专做果蝇的三维查询,3DSeTH 专做类风湿关节炎的六位患者。这些工具证明了三维护视化的可行性,也暴露了碎片化的问题——每个工具只覆盖一小批数据,没有统一的入口。So3D 的贡献是把这些碎片收进一个库,并补上分析模块。
8.2 与同期开放资源的生态分工
2026 年数据库专刊里,同批还有 Spatial GWAS Atlas 与 Spatial2GWAS,它们做的是把空间区域与 GWAS 性状连起来;enhancer3D 与 ChromPolymerDB 做的是三维染色质。放到一起看,这一届的特征是「空间」与「三维」两个词在不同尺度上同时升温:So3D 是组织尺度的三维,染色质库是分子尺度的三维,两者方法上不相通,但都在回答「二维切片之外的第三维在哪」这个问题。
8.3 哪些部分还在长,哪些已经冻结
按论文的未来路线,还在长的部分是数据集数量(持续收录新的三维空间转录组)、分析模块(会新增)、组学类型(会扩到空间代谢组与空间基因组)。已经冻结的部分是现有的标注体系:细胞类型固定为七类上位的反卷积结果,空间域固定为 Louvain 0.5 下的结果。这两项一旦冻结,下游的跨数据集比较就有了基线,但也意味着想做更细的注释必须自己重跑。
8.4 今天面对的三个结构性压力
第一个压力是原生三维采集的成熟。当透明化光片扫描与厚组织原位测序变得便宜,切片堆叠路线的相对价值会下降;So3D 要么吸收原生三维数据,要么被重新定位成「历史切片数据的归档层」。
第二个压力是单细胞级空间平台的普及。Xenium、CosMx、MERFISH 这类平台给出的是单分子或单细胞级坐标,位点级反卷积的定位会被挤压到「没有单细胞平台数据的组织」这一细分场景。
第三个压力是许可与合规。作为整合型库,它的每一套数据都背着上游的许可,站点又未统一声明,这种结构在学术使用时问题不大,在产业使用时难以通过法务。
8.5 三类相邻资源的定位差异
把 So3D 放到三份相邻资源中间,它各自的取舍会看得更清楚。
| 资源 | 采集方式 | 纵向采样 | 主要交付形态 | 强项 | 弱项 |
|---|---|---|---|---|---|
| So3D | 连续切片重建 | 由切片数决定,离散 | 三张 CSV + 网页模块 | 跨物种汇总、统一流程、免代码分析 | 无原生 z、无单细胞分辨 |
| Flysta3D | 果蝇胚胎连续切片 | 同上,但切片更密 | 网页查询 | 单一物种做深 | 只覆盖果蝇 |
| 单研究多平台图谱 | Visium + Xenium 等 | 平台混合,单研究内一致 | 原始矩阵 + 图像 | 单研究内数据质量最高 | 覆盖窄,无跨研究对照 |
| 原生三维采集 | 透明化 + 光片或厚组织原位测序 | 连续,由仪器决定 | 体数据 + 表达 | 真正的三维各向同性 | 成本高、通量低、组织类型受限 |
这四类资源不是同一件事的不同完成度,而是四种取舍:So3D 用覆盖广度换了纵向精度,用流程统一换了元数据完整。选型的第一步该问需要广度还是精度,而不是比较分数。做评测的人可以分层使用:So3D 测跨数据集稳健性,单研究多平台图谱测单数据集上限,原生三维数据测各向同性条件下的表现,三层分开报告比给一个平均分有信息量。
§9 使用指引
9.1 三种角色的路径
三类使用者的路线差别很大,不是同一套步骤的深浅版本。下面三张表分别给出各自的判断顺序。
| 角色 | 主要诉求 | 建议路径 | 预计工作量 |
|---|---|---|---|
| 临床或生物学背景的研究者 | 快速看三维结构、形成假设、出图 | 网页 Domain3D + CellType3D,选定数据集后再考虑下载 | 半天 |
| 生信分析者 | 拿到数据做二次分析、做跨数据集比较 | §5.2 建索引 → §5.3 取一套 → §5.5 转 h5ad | 一到两天 |
| 方法研究者 | 用全库做评测、开发新的配准或聚类方法 | §5.2 建索引 → 批量取数 → 按 PMID 与物种分层 | 一到两周 |
给临床与生物学背景的你。判断顺序应该是先组织、后疾病、最后看切片数。先在浏览页按器官筛,找到你关心的组织;再在同一器官下比较几套数据集的疾病标注;最后看切片数,切片数少于 4 套的,三维结构基本只够看一个排序,不足以下结构判断。这套顺序的好处是避免一上来被「72 套」的规模吓住,实际与你相关的可能只有个位数。
给生信分析者。你的顺序是先把三张表接进来,再决定分析什么。接数据时最容易犯的错是直接 pd.read_csv 后开始分析,结果首列变成 Unnamed: 0、行序错位、z 被当成连续坐标。§5.3 的三行断言是必须过的关卡。过了之后,先画 x/y 散点看组织形状,再看 z 的分布确认切片数,最后才碰表达矩阵。
给方法研究者。你需要先决定评测协议,再决定取多少数据。协议的核心是分组变量:按 PMID 分组考察的是跨研究泛化,按物种分组考察的是跨物种迁移,按切片数分层考察的是低切片条件下的稳健性。三种协议在同一批数据上会得出不同结论,而且都成立。选择依据应该是你想回答的问题,不是哪种结果更好看。
9.2 一条最短的可用流程
从零到拿到一个能画图的三维对象,最少需要五步。下面这段是可执行的完整链路,不依赖前面任何片段。
#-- 1) 建索引
python3 - <<'PY'
import re, requests, pandas as pd
BASE = "http://so3d.bio-database.com"
html = requests.get(BASE + "/download.jsp", timeout=60,
                    headers={"User-Agent": "Mozilla/5.0"}).text
def parse(name):
    m = re.search(r"var " + name + r"\s*=\s*\[(.*?)\n\s*\];", html, re.S)
    rows = re.findall(r"\{([^}]*)\}", m.group(1))
    return pd.DataFrame([dict(re.findall(r'(\w+):\s*"([^"]*)"', r)) for r in rows])
a = parse("datasetRecords"); b = parse("datasetRecords1"); c = parse("datasetRecords2")
t = a[["dataset", "expression"]].merge(b[["dataset", "slicenumber", "coordinates"]], on="dataset") \
                                .merge(c[["dataset", "metadata"]], on="dataset")
t.to_csv("so3d_index.csv", index=False)
print(len(t))
PY

#-- 2) 下载一套(逗号必须转义)
curl --retry 3 -m 300 -o expr.csv \
  "http://so3d.bio-database.com/upload/expression/BRCA%2CHuman%2C3Ddataset_1_expression.csv"
curl --retry 3 -m 300 -o meta.csv \
  "http://so3d.bio-database.com/upload/metadata/BRCA%2CHuman%2C3Ddataset_1_metadata.csv"
curl --retry 3 -m 300 -o coord.csv \
  "http://so3d.bio-database.com/upload/coordinates/BRCA%2CHuman%2C3Ddataset_1_coordinates.csv"

#-- 3) 校验三表主键一致
python3 - <<'PY'
import pandas as pd
e = pd.read_csv("expr.csv", index_col=0)
m = pd.read_csv("meta.csv").rename(columns={"Unnamed: 0": "spot_id"})
c = pd.read_csv("coord.csv").rename(columns={"Unnamed: 0": "spot_id"})
assert set(e.columns) == set(m.spot_id) == set(c.spot_id)
print(len(e), len(m), len(c), c.z.nunique())
PY
第一步打印 72,第三步打印一套数据的三个行数与 z 的唯一值个数。z 的唯一值个数应当等于该套的切片数,这是本页反复强调的自检点。
9.3 引用方式
引用这篇数据库时应同时给出论文与站点:
- 论文:Zhao H, Yin X, Wang S, Geng Z, Yu W, Yu H, Ning S, Wang L. So3D: a comprehensive three-dimensional spatial omics resource for decoding tissue architecture in physiology and disease. Nucleic Acids Research. 2026;54(D1):D1281–D1290. doi:10.1093/nar/gkaf998. PMID: 41062448.
- 站点:So3D, http://so3d.bio-database.com/ (访问日期以实际为准)。
- 数据:若使用了某套数据集,应同时引用该数据集的原始论文(下载页给出的 PMID),因为 So3D 只做了整理,数据的科学内容属于原始研究。
9.4 从下载到出图的第二段路
§9.2 停在「三张表接进来、主键对上」这一步。从这一步到一张能放进论文的三维图,还有第二段路,而且这段路上没有官方工具可以依靠。下面这一段是把三维点云画出来并做各向异性对照的最短写法。
#-- 需要 matplotlib;输入为 §5.3 已读入的 coord 与 meta
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np

def draw(coord, cluster, title, scale_z, ax):
    #-- scale_z 为 1 表示不校正,其余按显微镜厚度与点间距之比缩放
    ax.scatter(coord["x"], coord["y"], coord["z"] * scale_z,
               c=cluster, s=6, cmap="tab10", alpha=0.8, linewidths=0)
    ax.set_title(title, fontsize=9)
    ax.set_xlabel("x")
    ax.set_ylabel("y")
    ax.set_zlabel("z")
    ax.view_init(elev=20, azim=-60)

cluster = meta.set_index("spot_id").loc[list(coord["spot_id"]), "louvain"].values

fig = plt.figure(figsize=(10, 4.5))
ax1 = fig.add_subplot(121, projection="3d")
ax2 = fig.add_subplot(122, projection="3d")
draw(coord, cluster, "z 保持原值(各向异性)", 1.0, ax1)
draw(coord, cluster, "z 放大到与 x/y 同尺度", 200.0, ax2)
fig.tight_layout()
fig.savefig("so3d_brca1_3d.png", dpi=200)
print("saved", len(coord), "spots")
左图画出来会是一张几乎压平的薄片,右图会是一个有厚度的立方体。两张图都不是「真相」:左图忠实于文件的数值,右图忠实于组织的物理尺度。论文里放哪一张,取决于你想讲的是数据的长相还是组织的样子,并且必须在图注里写清 z 的缩放系数。
scale_z 取 200 只是一个示意,正确取值应当由「切片间距除以位点间距」算出。以 §4.2 的案例为例,z 的两个取值相差 19.84,x/y 的跨度在一万三千米量级的同一数位上,若 x/y 的单位是微米,则 z 的步长单位与 x/y 不同,必须先统一单位再算比值。同理,位点间距也要先确认单位后才能与切片厚度相除。
这里有一处可以自证的地方:同一份坐标文件里,位点间最近邻距离的中位数量级与 x/y 跨度相比大约差两个数量级,这与 Visium 点阵「位点直径 55 微米、中心间距 100 微米」的常识吻合。也就是说 x/y 更可能是微米,而 z 的 19.84 若也是微米,就意味着两层切片只隔 20 微米——这比一张 10 微米切片的厚度只多一倍,对常规连续切片实验偏薄。两种可能都无法从文件内部排除,因此换算系数必须由使用者按实验记录给定,不能默认。
9.5 常见报错与成因
| 报错或异常 | 最常见成因 | 处置方式 |
|---|---|---|
| HTTP 404,路径里只剩前半段 | 文件名含逗号未做百分号转义 | 用 urllib.parse.quote(path, safe="/") |
首列出现 Unnamed: 0 |
三张 CSV 的首列都没有列名 | 读入后统一 rename 成 spot_id |
| 断言失败,三表主键不等 | 某套数据的文件未同步更新 | 换一套,或去下载页核对文件名 |
| 表达矩阵与元数据行数不符 | 读入时把行当列、列当行 | 表达矩阵必须转置后再与 meta 对齐 |
| 三维图完全压平 | 未做 z 缩放 | 按 §5.4 换算到物理单位 |
| 内存占用暴涨 | 稠密宽表直接转 DataFrame | 先转 scipy 稀疏再入 AnnData |
| 首页能打开但下载页空白 | 页面靠 JavaScript 渲染 | 直接请求 download.jsp,解析内嵌数组 |
| https 请求握手失败 | 站点证书链在部分网络下不完整 | 改用 http 通道 |
§10 AI 使用声明
| 项目 | 声明 |
|---|---|
| 是否使用生成式 AI 辅助撰写 | 是,用于结构梳理与文字组织 |
| AI 是否参与事实核查 | 否,全部数字来自官方页面、论文与 DOI 元数据的人工核对 |
| AI 是否生成或推测数据 | 否,文中未出现任何未经来源支持的数字 |
| AI 是否参与图片生成 | 封面提示词由人工编写,图像由文本生成模型产出 |
| AI 生成内容的复核方式 | 与原始来源逐项比对,冲突处以来源为准 |
| 本文的责任主体 | 千方医数集编辑部 |
| 声明适用版本 | 2026-10-26 版 |
| 联系与纠错 | 发现数字与官方页面不符,请通过站内反馈渠道提交并附页面截图 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| So3D 是原生三维采集 | 全部为连续切片二维数据的配准重建 | 论文方法节写明流程为 ICP/PASTE 配准 + STitch3D;坐标文件 z 只有切片数量级的离散值 |
| z 轴是连续测量的第三维 | z 是同一切片内恒定的序号换算值 | §4.2 的案例中 3341 个位点的 z 只有 0.0 与 19.84 两个取值 |
| 位点就是细胞 | 位点是多细胞混合物,标签来自反卷积 | 元数据给的是七类比例加一个 argmax,不是单细胞测量 |
| 72 套等于 72 个独立研究 | 13 个 PMID,一项研究最多贡献 15 套 | 下载页 Accession 与 PMID 列,同一登记号重复出现 |
| 逾百万位点意味着高分辨率 | 位点密度由平台决定,纵向点数等于切片数 | 单套平均约一万五千位点配 12 张切片;12 套数据集只有 2 张切片 |
| 网页上的结果可以直接当标签 | 前端是做探索的,标签是算法产出 | 七个上位细胞类型,无亚型,无置信度 |
| 论文 CC BY-NC 4.0 等于数据可非商业使用 | 论文许可覆盖文本与图表,数据许可未在站点声明 | 站点无 license 字段,各数据集须回溯 GEO/HTAN/CNGB |
| 跨物种通用性已经验证 | 果蝇占 33 / 72,哺乳动物合计 35 | 物种分布表 |
| 下载页字段与首页一致 | 首页称 15 种组织,下载页器官列有 15 个不同取值但含重复写法 | 人脑同时写作 Brain 与 Human dorsolateral prefrontal cortex(DLPFC) |
| 数据可以按数据集随机切训练测试 | 同研究多套高度相关,随机切分会泄漏 | 一研究 15 套、一研究 28 套 |
FAQ
Q1:So3D 与「真三维」的空间转录组差在哪?
差在采集方式。So3D 的每个数据点都来自一张独立的二维切片,纵向只有切片数那么多个采样面;真三维采集(透明化组织光片扫描、厚组织块原位测序)在同一块组织里连续采样,纵向可以有很多层。前者纵向分辨率由实验者切多薄决定,后者由仪器决定。
Q2:为什么坐标里的 z 只有两个值,是不是数据坏了?
不是。那套数据集只有 2 张切片,z 就是两个值。So3D 的 z 按切片序号换算,同一切片的所有位点 z 相同,所以 z 的唯一值个数永远等于切片数。§4.2 的案例就是这个情形。
Q3:能不能直接做三维卷积?
需要先做各向异性校正。把 z 按切片厚度换算到与 x/y 同一物理单位后,再建体素网格;不做校正会得到一个纵向被严重拉伸或压缩的体数据。§5.4 给出了换算函数。
Q4:细胞类型标签能不能当金标准?
不能。标签是 STitch3D 反卷积后取最大比例得到的,反映的是算法推断,不是病理判读。可以用作弱监督信号,但要在方法里写明来源,并做小规模人工复核。
Q5:为什么下载页显示 15 种组织,论文也写 15 种,但对不上手数的器官数?
下载页器官列有 15 个不同取值,其中人脑存在两种写法(Brain 与 Human dorsolateral prefrontal cortex(DLPFC)),实际生物器官数少于取值数。这是命名不统一,不是两套口径冲突。
Q6:想复现论文里的乳腺癌案例,该下哪一套?
不要下 BRCA,Human,3Ddataset_1。论文正文的乳腺癌案例是 3 张切片、1729 个位点、5 个空间域,而 BRCA,Human,3Ddataset_1 是 2 张切片、3341 个位点、7 个空间域。按切片数与位点数在 10 套乳腺癌数据集里筛选。
Q7:站点打不开怎么办?
优先用 http 协议的 so3d.bio-database.com。旧域名 bio-bigdata.hrbmu.edu.cn/So3D 只是一个跳转页,直接访问 https 版本在部分网络下会 403 或握手失败。
Q8:有没有 API?
没有文档化的 REST API。批量取数的实际做法是从 download.jsp 解析内嵌的四个数组,再拼 CSV 直链,§5.2 给了完整脚本。
Q9:为什么表达矩阵这么大?
因为它以稠密 CSV 宽表发布,基因在行、位点在列,所有数值都写出来,没有做稀疏化。一套中等规模的数据集就有数十 MB,转成稀疏 h5ad 后体积可降到十分之一以下。
Q10:这套数据能做商业模型训练吗?
不能直接做。论文是 CC BY-NC 4.0,站点未声明数据许可,各数据集的条款要回溯到 GEO、HTAN、CNGB 等原始仓库,其中相当一部分是非商业或需要申请。
Q11:果蝇数据占这么多,人类研究还有意义吗?
有,但要挑。人类 30 套里乳腺癌 10 套、骨 6 套、心 3 套、结肠 3 套、脑 4 套,做肿瘤微环境与器官结构研究足够起步;做需要大量人类样本的统计推断则不够。
Q12:三维空间域的编号在不同数据集之间可比吗?
不可比。cluster0 在 A 数据集和 B 数据集里代表的空间域没有对应关系,编号只是该数据集内部的聚类索引。跨数据集比较要先做标签对齐。
术语表
| 术语 | 英文 | 在本页语境中的含义 |
|---|---|---|
| 空间转录组 | spatial transcriptomics | 在保留组织位置的前提下测量基因表达的技术 |
| 连续切片 | consecutive sections | 从同一组织块依次切下的、位置相邻的薄片 |
| 配准 | registration | 求变换使相邻切片的点布局对齐 |
| 迭代最近点 | ICP | 经典的刚体配准算法 |
| PASTE | PASTE | 面向空间转录组的最优传输配准与整合方法 |
| STitch3D | STitch3D | 基于图神经网络的切片整合与细胞类型反卷积模型 |
| 反卷积 | deconvolution | 从混合表达谱推断各细胞类型的比例 |
| 空间域 | spatial domain | 表达模式一致的三维区域,相当于三维版的聚类簇 |
| 位点 | spot | 空间测序的最小采集单元,含多个细胞 |
| 各向异性 | anisotropy | 各方向采样密度不相等,本页特指 z 向远低于 x/y 向 |
| 原生三维采集 | native 3D acquisition | 在整块厚组织内直接完成的三维测量 |
| Louvain | Louvain | 基于模块度的社区发现算法,用于聚类 |
| UMAP | UMAP | 降维可视化方法 |
| 潜表示 | latent representation | 模型内部学到的低维嵌入 |
| 批次效应 | batch effect | 不同批次实验带来的系统性技术差异 |
| 配体受体对 | ligand-receptor pair | 细胞通讯分析的基本分析单位 |
| 长尾 | long tail | 少量类别占据多数样本、其余类别各只有极少样本的分布 |
| 数据泄漏 | data leakage | 训练与测试共享同一来源导致指标虚高 |
| 稠密矩阵 | dense matrix | 所有元素都显式存储的矩阵 |
| 稀疏矩阵 | sparse matrix | 只存非零元素的矩阵 |
| h5ad | h5ad | AnnData 的磁盘格式,单细胞与空间分析的通用容器 |
| CDISC 之外的元数据 | metadata | 描述数据本身的字段,如切片数、位点数、登记号 |
| 登记号 | accession | 数据在原始仓库中的标识,如 GSE 号或 HTAN 页面 |
| PMID | PubMed ID | 论文在 PubMed 的唯一编号 |
| Breakthrough | Breakthrough Article | NAR 数据库专刊每年选出的重点论文 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 数据集总数 | 72 | 下载页数组长度与论文一致 | 官方页面 + 论文 |
| 人类数据集 | 30 | 下载页物种计数 | 官方页面 |
| 果蝇数据集 | 33 | 下载页物种计数 | 官方页面 |
| 小鼠数据集 | 5 | 下载页物种计数 | 官方页面 |
| 墨西哥钝口螈数据集 | 4 | 下载页物种计数 | 官方页面 |
| 组织数 | 15 | 论文与首页 | 论文 + 官方页面 |
| 疾病数 | 5 | 论文与下载页疾病列 | 论文 + 官方页面 |
| 切片总数 | 882 | 下载页切片列求和 | 官方页面 |
| 位点总数 | 1,132,902 | 下载页位点列求和与论文一致 | 官方页面 + 论文 |
| 单细胞数据集 | 28 | 下载页参照数组长度 | 官方页面 |
| 单细胞总数 | 七十余万 | 下载页参照数组求和与论文一致 | 官方页面 + 论文 |
| 细胞类型数 | 77 | 论文方法节 | 论文 |
| 单套平均位点 | 约一万五千 | 论文方法节 | 论文 |
| 单套平均切片 | 12 | 论文方法节 | 论文 |
| 最多切片的一套 | 74(小鼠心脏) | 论文方法节 | 论文 |
| 最多位点的一套 | 63,603(果蝇幼虫) | 论文方法节 | 论文 |
| 配准算法 | ICP 或 PASTE | 论文方法节 | 论文 |
| 整合模型 | STitch3D | 论文方法节 | 论文 |
| 聚类分辨率 | 0.5 | 论文方法节 | 论文 |
| 部署方式 | JSP + Tomcat 9.0.93 + MySQL 5.6.50 | 论文实现节 | 论文 |
| 论文许可 | CC BY-NC 4.0 | Europe PMC 元数据 | 论文 |
| 站点数据许可 | 未声明 | 首页与下载页均无 license 字段 | 官方页面(缺失) |
附录 B:数字的来源分层
| 层级 | 数字 | 说明 |
|---|---|---|
| 官方页面(下载页内嵌数组) | 72、30、33、5、4、882、1,132,902、28、细胞总数、每套的切片数与位点数 | 从 download.jsp 的四个数组直接读出,可复算 |
| 官方页面(实体文件) | z 的两层取值、3341 位点、七列细胞比例、首列无列名 | 从三张示例 CSV 直接读 |
| 论文摘要与方法 | 15 种组织、5 类疾病、77 种细胞类型、平均位点与切片数、最多 74 切片、最多 63,603 位点、ICP/PASTE、STitch3D、Louvain 0.5、JSP/Tomcat/MySQL 版本、一篇乳腺癌案例的 1729 位点与 5 个空间域 | 来自 Europe PMC 全文 XML |
| 未核实 | 每套切片的物理厚度、坐标单位、供者数、伦理批件、逐数据集质控指标、数据集的版本变更 | 官方页面与论文均未给出 |
附录 C:完整参考文献
- Zhao H, Yin X, Wang S, Geng Z, Yu W, Yu H, Ning S, Wang L. So3D: a comprehensive three-dimensional spatial omics resource for decoding tissue architecture in physiology and disease. Nucleic Acids Research. 2026;54(D1):D1281–D1290. doi:10.1093/nar/gkaf998. PMID: 41062448. PMCID: PMC12808542.
- The 2026 Nucleic Acids Research database issue and the online molecular biology database collection. Nucleic Acids Research. 2026. doi:10.1093/nar/gkaf1427.(专刊编者按,说明两篇 Breakthrough 为 JoGo 与 So3D)
- NAR Breakthrough Articles: 2026 年列表页,Oxford Academic.(用于确认 So3D 的 Breakthrough 身份与卷期页码)
- So3D 官方站点首页与下载页:http://so3d.bio-database.com/ 与 /download.jsp。(用于数据集规模、字段与文件路径)
- So3D 帮助页:http://so3d.bio-database.com/help.jsp。(用于五个模块的功能说明与字段释义)
- Europe PMC REST API,DOI 10.1093/nar/gkaf998 的 core 记录。(用于作者、卷期、许可与摘要)
- 王等,哈尔滨医科大学新闻稿(中文媒体转载)。(仅用于背景叙述,不用于数字采信)
附录 D:取数后的三项校验代码
下面这段把 §5 的三步合成一个可以反复运行的自检脚本:主键一致性、z 与切片数的对应、文件指纹记录。指纹记录是为了应对站点无版本号的问题。
#-- 需要 pandas、hashlib;输入为 §5.3 已下载的三张 CSV
import hashlib, json, pathlib
import pandas as pd

FILES = ["expr.csv", "meta.csv", "coord.csv"]

expr  = pd.read_csv("expr.csv", index_col=0)
meta  = pd.read_csv("meta.csv").rename(columns={"Unnamed: 0": "spot_id"}).set_index("spot_id")
coord = pd.read_csv("coord.csv").rename(columns={"Unnamed: 0": "spot_id"}).set_index("spot_id")

#-- 1) 主键三向一致
assert set(expr.columns) == set(meta.index) == set(coord.index), "三表主键不一致"

#-- 2) z 的唯一值个数必须等于切片数
slice_no = coord.index.str.split("-slice").str[-1].astype(int)
per_slice_z = coord.groupby(slice_no)["z"].nunique()
assert (per_slice_z == 1).all(), "存在同一切片内 z 不唯一的记录,该套 z 可能经过插值"
n_slice = slice_no.nunique()
assert n_slice == coord["z"].nunique(), f"切片数 {n_slice} 与 z 取值数 {coord['z'].nunique()} 不符"

#-- 3) 细胞比例每行和为 1
ratio_cols = ["B_cell", "Endothelial_cell", "Epithelial_cell", "Fibroblast",
              "Macrophage", "T_cell", "Tumor_cell"]
s = meta[ratio_cols].sum(axis=1)
assert ((s - 1).abs() < 1e-4).all(), "存在比例和不为 1 的行"

#-- 4) 记录文件指纹,供日后判断是否被替换
fp = {f: {"bytes": pathlib.Path(f).stat().st_size,
          "sha256": hashlib.sha256(pathlib.Path(f).read_bytes()).hexdigest()} for f in FILES}
pathlib.Path("so3d_fingerprint.json").write_text(json.dumps(fp, indent=2), encoding="utf-8")

print("位点", len(expr.columns), "基因", len(expr), "切片", n_slice, "以 z 为纵轴的层数", coord["z"].nunique())
四项断言全过,说明这套数据在结构上是自洽的;若第二项断言报错,说明该套的 z 不是简单的切片序号换算,需要单独查看,不能套用 §5.4 的换算函数。
附录 E:如果只记五件事
- 它是切片堆叠,不是原生三维。 z 是切片序号,不是测量轴;纵向采样点数等于切片数。
- 规模数字要按物种与 PMID 去重再看。 72 套里果蝇占 33 套,13 个 PMID,一项研究最多贡献 15 套。
- 标签是算法产出的。 七类上位细胞类型,来自反卷积的 argmax,不是病理判读。
- 三张 CSV 主键同源,首列没有列名,文件名带逗号必须转义。 这是接数据的三个必踩点。
- 网页能做的只是探索。 要做分析或训练,下一整套,按 §5.4 做各向异性校正,按 §7.2 处理训练集划分。
编辑说明
本页核验时间 2026-10-26。核验方式:读取 So3D 官方站点的首页、帮助页与下载页 HTML;解析下载页内嵌的四个元数据数组并与论文口径交叉核对;下载 BRCA 第一套的三张 CSV 核对表头、主键与 z 的取值分布;通过 Europe PMC REST API 取 DOI 10.1093/nar/gkaf998 的 core 记录与 PMC12808542 全文 XML;对照 NAR 2026 Breakthrough 列表页与专刊编者按确认学术身份。
未覆盖内容:各数据集的原始许可条款(需逐个回溯 GEO、HTAN、CNGB 等仓库);切片的物理厚度与坐标单位(官方未公布);供者数量与伦理批件编号(未在公开页列出);配准残差与反卷积置信度(官方未发布);站点是否存在按版本归档的历史快照(未发现版本号机制)。
本页的立场是描述而非推荐。文中对路线的评价(切片堆叠与原生三维的差别)属于技术事实陈述,不构成对某一技术路线的优劣判断。数字冲突时以官方页面为准,并在附录 B 标注来源层级。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- tabula-sapiens — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- single-cell-portal — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- hcl — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- single-cell-expression-atlas — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- scpt-4m — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学 / 多模态
- hra-knowledge-graph — 共享标签:基因组学与多组学 / 单细胞基因组学 / 多模态
- expression-atlas-legacy — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- expression-atlas — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- cellxgene-census — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
- adrenal-gland-atlas — 共享标签:基因组学与多组学 / 转录组 / 单细胞基因组学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
