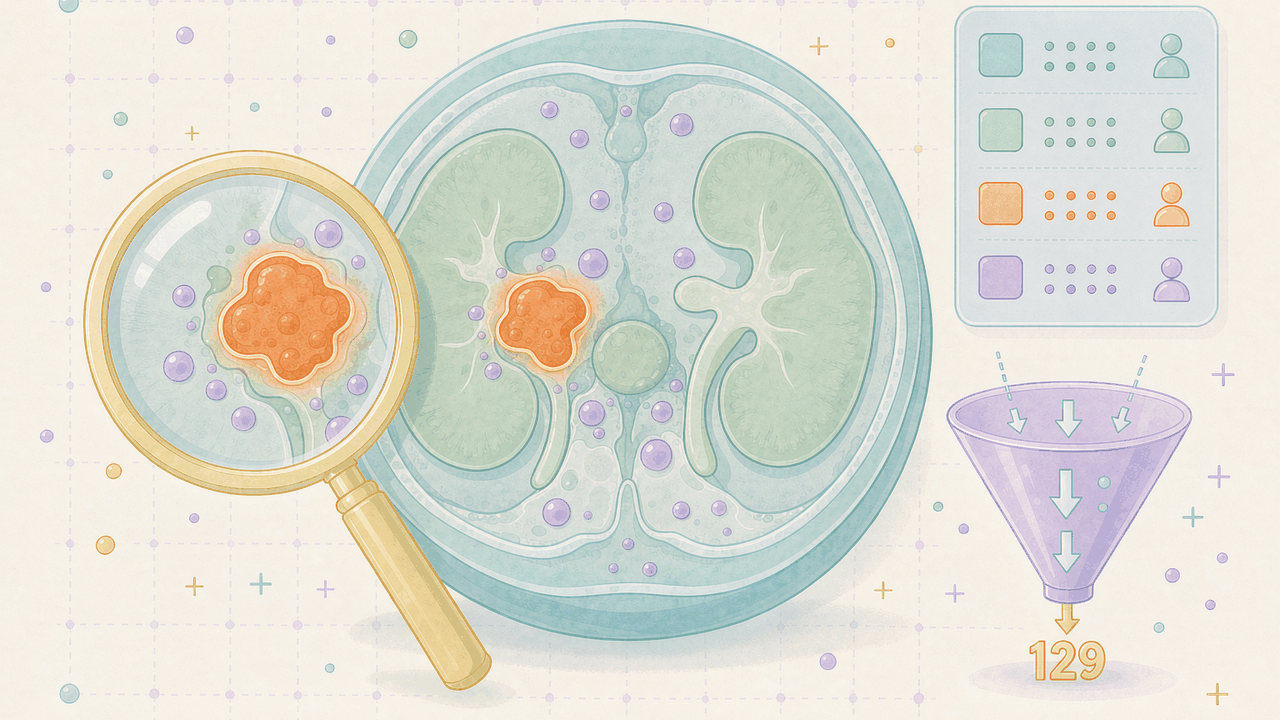
信息速览
INFOBOX — RCC-AID 一屏速览
维度 内容 本质 为 TCGA 三大肾细胞癌队列补齐公开病灶标注的增强 CT 体素级分割数据集(非新采集、非挑战赛) 团队 Radboud University Medical Center(Radboudumc)医学影像系 DIAG 组领衔,跨荷兰/德国/意大利 6 机构协作 论文 MELBA 2026, Special Issue on MICCAI Open Data 2026:772-782(doi:10.59275/j.melba.2026-2dg2);预印本 medRxiv 10.64898/2026.04.22.26351451 数据 129 CT / 91 患者(v2.0.0)= 85 clear cell + 26 papillary + 18 chromophobe;增强 CT(NIfTI) 标注 体素级分割掩码:0 背景 / 1 肾脏 / 2 肿瘤 / 3 囊肿 漏斗 筛查 1,915 张 CT → 元数据排除 → 自动分割初标 → 学生质检 → 医师复核 → 保留 129 例 患者 91 人(24 女 / 67 男),年龄 26-82 岁(均值 56);肿瘤 8-169 mm 期相 arterial 26 / venous 50 / delayed 53(v2.0.0 新增标注) 任务 分割 / 检测 / 亚型分类 / 影像组学 / 多模态 RCC 研究 获取 Zenodo 直链公开(无 gated):v2.0.0 record 20719257(4.1 GB);v1.0.0 record 19630298(6.6 GB) 许可 分割标注 CC BY 4.0|图像与元数据(源自 TCIA)CC BY 3.0 代码 GitHub DIAGNijmegen/oncology-RCC-AID-codebase 库内互链 tcga(rid 25)、kits(rid 80)、kits23(rid 698)、abdomenct-1k(rid 402)
RCC-AID 是一个"给 TCGA 肾癌影像补标注"的数据集工程:TCGA 三大肾癌影像队列(透明细胞 TCGA-KIRC、乳头状 TCGA-KIRP、嫌色细胞 TCGA-KICH)被全世界广泛用于训练和验证 AI 模型,但这些影像的公开病灶标注长期缺失——每家实验室都得自己重新勾一遍肾和肿瘤,既抬高门槛、又让不同研究无法比较。RCC-AID 把这些标注一次性做出来并开源:筛查 1,915 张 CT,用自动分割模型初标,再由受训学生质检纠错、放射科医师复核,最终留下 129 张 CT(91 名患者)的体素级肾脏与病灶掩码,以 CC BY 4.0 在 Zenodo 直链公开。对任何想用 TCGA 肾癌影像做分割、检测、亚型分类或影像组学的人,它把"重新勾标注"这道重复劳动直接省掉了。
导语读法三则:
- 只想下数据:直奔 §6 获取与许可——认准 v2.0.0(record 20719257,4.1 GB),别下成 v1.0.0(record 19630298,6.6 GB,含静默损坏文件)。
- 关心数据质量与偏倚:直奔 §4 与 §5——重点读规模双口径、性别/地域偏斜、观察者间变异未测三条自曝局限。
- 做肾肿瘤分割/亚型研究:直奔 §7 与 §9.1——把 RCC-AID 与 KiTS/KiTS23 放在同一张肾肿瘤 CT 分割谱系里读,明确各自定位。
§0 导读:这个数据集解决什么问题
肾细胞癌(Renal Cell Carcinoma, RCC)是肾脏最常见的恶性肿瘤,约占成人肾癌的九成,其三种主要亚型——透明细胞(clear cell)、乳头状(papillary)、嫌色细胞(chromophobe)——在病理、预后和治疗反应上差异显著,因此区分亚型是临床决策的关键一环。增强 CT(contrast-enhanced CT)是 RCC 诊断、分期与随访的核心影像手段。近十年,AI 在计算机辅助诊断、分期与治疗规划上的研究激增,但一个长期瓶颈横在所有研究者面前:带标注的数据稀缺。
具体到 TCGA(The Cancer Genome Atlas),情况很典型。TCGA 的三大肾癌影像子集——TCGA-KIRC、TCGA-KIRP、TCGA-KICH——被文献广泛用于模型训练与验证,但公开可用的病灶标注极为有限。这意味着:任何想用这批影像的研究团队都得自行重新勾画肾脏和肿瘤轮廓。后果是双重的——研究门槛被抬高(重新标注耗时长、需要专业人力),既往研究的可复现性与可比性被削弱(各家用各自的私有标注,指标无法直接对标)。
RCC-AID 的回答直接而彻底:把这批标注做一次、开源给所有人。作者从三个 TCGA-RCC 库筛查了 1,915 张 CT,先做基于元数据的排除,再用自动分割模型生成初始肾脏与病灶掩码;随后组织阅片研究,对全部乳头状(n=56)、嫌色细胞(n=27)和随机抽取的 200 例透明细胞病例,由两名受训学生做质检、纠错并补标肿瘤与囊肿,不确定病例交 board-certified 放射科医师复核。经过排除与质控,最终保留 129 张 CT / 91 名患者的体素级肾脏与病灶标注,以完全开放的方式发布在 Zenodo(CC BY 4.0)。
§0 读法三则:
- 这个条目是"数据集 + 开放科学论文 + 可复制标注流水线"三合一:数据集是 129 例带掩码的 CT,论文讲的是为什么开源、怎么标、有哪些坑,副产品是一套"自动初标 + 学生劳动 + 专家复核"的可迁移流水线(§5)。
- 全文规模数字存在版本双口径:v2.0.0 = 129 CT / 91 患者(当前有效),v1.0.0 / medRxiv = 142 CT / 101 患者(旧口径,因静默转换失败被修正)。本条目一律以 v2.0.0 为准并全程存照(坑 1、坑 2)。
- 检索时务必带版本号或 record id:Zenodo 上 19630298(v1)与 20719257(v2)标题、作者完全一致,唯一快速判别锚是包大小(v1 的 images.zip 6.6 GB vs v2 的 4.1 GB)。
§1 数据集速览:十问十答
Q1:RCC-AID 到底是什么?
一个为 TCGA 肾癌影像补公开标注的增强 CT 体素级分割数据集。它不采集新数据,而是把 TCGA 三大肾癌队列里原本没有公开病灶标注的 CT,重新做了一套肾脏、肿瘤、囊肿的体素级标注,并完全开源。
Q2:"RCC-AID"里的 AID 是什么?
AI Dataset,即"面向 AI 的肾细胞癌数据集"。名称全称是 Renal Cell Carcinoma AI Dataset for Medical Imaging Research(面向医学影像研究的肾细胞癌 AI 数据集)。注意它与库内 chronic-kidney-disease-uci(rid 726)不是一回事——后者是 UCI 的表格化慢性肾病临床指标集,无影像、无分割。
Q3:规模到底是多少?
以当前有效版本 v2.0.0 为准:129 张 CT / 91 名患者(85 clear cell + 26 papillary + 18 chromophobe)。旧版 v1.0.0 是 142 CT / 101 患者——v1 有部分 DICOM→NIfTI 转换静默失败,v2 修复后移除了不可修复的文件,所以数字变小了。
Q4:为什么 129 张 CT 只有 91 名患者?
因为一名患者的检查可能包含多个期相或多个序列的 CT。数据里同一患者可能贡献多张 CT(如动脉期、静脉期、延迟期各一张),因此 CT 张数大于患者数。这一点做训练/测试划分时至关重要——必须按患者分组,否则同一患者的不同期相会同时出现在训练和测试集里,造成数据泄漏。
Q5:标注里有什么?
体素级分割掩码,四个标签:0 = 背景、1 = 肾脏、2 = 肿瘤、3 = 囊肿。另有一份 metadata.csv 给出每个病例的 RCC 亚型、患者人口学和 TCIA 系列标识符。也就是说,模型既能学"哪里是肾、哪里是瘤",也能借亚型标签做分类任务。
Q6:图像从哪来,什么格式?
源自 TCGA 三大肾癌队列,经 TCIA(The Cancer Imaging Archive) 提供的原始 DICOM,被转换为 NIfTI(.nii.gz) 格式。数据包还附一份 manifest.tcia,用 NBIA Data Retriever 打开即可回源下载原始 DICOM——这意味着使用者既能用现成的 NIfTI,也能追溯回原始影像。
Q7:谁标的,可靠吗?
自动分割模型初标 → 两名受训学生质检、纠错、补标肿瘤与囊肿 → 不确定病例由 board-certified 放射科医师复核。作者未做多专家观察者间一致性测试,因此明确建议把这些标注当作"质控后的研究用标注(quality-controlled research annotations)",而非绝对金标准。
Q8:怎么获取,要申请吗?
完全不要申请。直接 Zenodo 直链下载,无 gated、无请求制:最新版 https://zenodo.org/records/20719257。这是它与库内 PANDA-PLUS 之类"请求制"数据集的根本区别——RCC-AID 是"一次做开、人人可下"。
Q9:许可怎么用?
分层:分割标注 CC BY 4.0(可商用,需署名);NIfTI 图像与 metadata.csv 源自 TCIA 源集合,遵循 CC BY 3.0。使用须引用论文(有同行评审版则引 MELBA 版)+ 三个 TCIA 源集合,并附 TCGA 免责声明。
Q10:为什么它对 AI-Ready 重要?
它示范了一种"补标上游而非采集新数据"的开放科学模式:数据本体(TCGA 影像)早已公开且体量巨大,瓶颈在标注——RCC-AID 用可复制的流水线(自动初标 + 学生劳动 + 专家复核)把标注补上并 CC BY 4.0 开源,同时附代码库与 TCIA manifest 保证可追溯、可复现。对数据集生态而言,它与 KiTS/KiTS23 一起把"肾肿瘤 CT 分割"这条赛道的三块拼图(术前挑战赛数据、TCGA 后验标注、多器官分割)都补齐了(§9.1)。
§2 数据构成与规格
2.1 规模、来源与版本演进
RCC-AID 的规模数字必须带版本读——这是本条目最重要的一条使用纪律。同一数据集在 Zenodo 上先后有两个版本,规模不同:
| 版本 | Zenodo record | CT 数 | 患者数 | clear cell | papillary | chromophobe | 包大小 | 对应文献 |
|---|---|---|---|---|---|---|---|---|
| v1.0.0 | 19630298 | 142 | 101 | 95 | 29 | 18 | 6.6 GB | medRxiv 预印本 |
| v2.0.0 | 20719257 | 129 | 91 | 85 | 26 | 18 | 4.1 GB | MELBA 正式版 |
差异的成因写在 Zenodo 的 Version log 里,原文为:
Version 2.0.0: 129 CT from 91 patients. Some of the DICOM to NIfTI conversions in version 1.0.0 silently failed. The issues have been resolved in version 2.0.0 and the files that are irrevisibily broken have been removed. Additionally, contrast phase annotations have been added.
Version 1.0.0: 142 CT from 101 patients.
翻译过来:v1.0.0 中有一部分 DICOM 转 NIfTI 的转换静默失败(silently failed),v2.0.0 修复了问题、移除了无法修复的文件,并额外新增了对比期相(contrast phase)标注。 因此 v2 的 CT 数少了 13 张(142→129)、患者少了 10 名(101→91),但数据质量和元数据更完整。这是"版本修正"而非"数据丢失",使用者应当放心用 v2。
来源层面,三个 TCGA 肾癌队列对应三种 RCC 亚型:
| TCGA 队列 | 全称 | RCC 亚型 | v2.0.0 病例数 | 源集合 DOI |
|---|---|---|---|---|
| TCGA-KIRC | Kidney Renal Clear Cell Carcinoma | 透明细胞 | 85 | 10.7937/K9/TCIA.2016.V6PBVTDR |
| TCGA-KIRP | Kidney Renal Papillary Cell Carcinoma | 乳头状 | 26 | 10.7937/K9/TCIA.2016.ACWOGBEF |
| TCGA-KICH | Kidney Chromophobe | 嫌色细胞 | 18 | 10.7937/K9/TCIA.2016.YU3RBCZN |
三个源集合均由 TCIA 托管,发布许可为 CC BY 3.0。RCC-AID 的 NIfTI 图像与 metadata.csv 正是从这些源集合"再分发(reproduced from)"而来。
2.2 筛选漏斗:从 1,915 张到 129 张
RCC-AID 不是"随手挑一批 CT 标一下",而是有一道清晰的筛选与质控漏斗。按 MELBA 摘要与方法描述,流程如下:
三个 TCGA-RCC 库合计筛查 1,915 张 CT
        │
        ▼
基于元数据的排除步骤(metadata-based exclusion)
        │
        ▼
自动分割模型生成初始肾脏与病灶掩码
        │
        ▼
阅片研究纳入:全部 papillary(n=56) + 全部 chromophobe(n=27) + 随机 200 例 clear cell
        │
        ▼
两名受训学生:质检 / 纠错 / 补标肿瘤与囊肿
        │
        ▼
不确定病例 → board-certified 放射科医师复核
        │
        ▼
排除 + 质控后 → 最终 129 CT / 91 患者(85 cc + 26 p + 18 ch)
注意穿透漏斗的两条设计意图:
- 亚型不是均衡抽样——papillary 和 chromophobe 是"全部纳入"(分别是 56、27 例的全体),只有 clear cell 是"随机抽 200 例"。因为 clear cell 在 TCGA 里数量远多于另两类,全纳入会淹没罕见亚型。这解释了为何最终 chromophobe 只剩 18 例——它是从 27 例里经排除与质控后留存的,样本量天然受限于上游稀有度。
- "元数据排除"是有意为之——先按元数据(而非看图)排除,再进入耗人力的阅片标注,是把有限标注产能投给最可用样本的工程选择。
2.3 掩码规格与文件结构
v2.0.0 的数据包包含四类文件,结构清晰:
| 文件/目录 | 内容 | 格式 | v2.0.0 大小 / md5 |
|---|---|---|---|
images/ |
由 TCIA DICOM 转换的 CT 图像 | NIfTI (.nii.gz) | 打包为 images.zip 4.1 GB / 727a216d02a3fa10e0c8d852945d32fb |
labels/ |
体素级分割掩码,每张 CT 一份 | NIfTI (.nii.gz) | 打包为 labels.zip 4.1 MB / 6d453071037640a79042033723442c1a |
metadata.csv |
病例级元数据:RCC 亚型、患者人口学、TCIA 系列 ID、对比期相 | CSV | 72.9 kB / 7297e5ea8201eddb0c3aae55c1068952 |
manifest.tcia |
TCIA Data Retriever manifest | 文本清单 | 8.6 kB / adfa32c16ef9287711cab0702083f3e7 |
一个易被忽视的坑:目录名随版本改变。v1.0.0 的描述用的是 annotations/,v2.0.0 改成了 labels/。写脚本做批量处理时,不能假设目录名固定——应直接读 Zenodo 记录的文件清单或 metadata。
2.4 分割标签体系与任务适配
标签图(label map)只有四类,紧凑而明确:
| 标签值 | 类别 | 临床含义 | 对应任务 |
|---|---|---|---|
| 0 | Background | 背景 | 负样本 / 忽略区 |
| 1 | Kidney | 肾脏 | 器官分割 / 定位 |
| 2 | Tumor | 肿瘤(实性病灶) | 病灶分割 / 检测 |
| 3 | Cyst | 囊肿 | 良恶性鉴别 / 亚型辅助 |
这一体系的设计含义:"肾脏—肿瘤—囊肿"三分类把器官级、病灶级、良性病变级三个颗粒度装在同一个掩码里。做肾脏分割用标签 1,做肿瘤分割用标签 2,做"肿瘤 vs 囊肿"良恶性区分则用 2 与 3 的对比——一张掩码可支撑多种研究问题,这是 RCC-AID 相对"只标肿瘤"数据集的信息量优势。
对比期相构成(v2.0.0 新增标注):arterial(动脉期)26 / venous(静脉期)50 / delayed(延迟期)53,合计 129。多期相的存在对使用者既是机会也是陷阱:机会在于可研究期相相关的影像组学特征;陷阱在于同一患者的不同期相若被分到不同集合,会构成数据泄漏(见 §8.2)。
2.5 患者人口学与肿瘤特征
| 属性 | 数值 | 来源 |
|---|---|---|
| 患者总数 | 91(24 女 / 67 男) | MELBA 摘要 / Zenodo |
| 平均年龄 | 56 岁 | MELBA 摘要 |
| 年龄范围 | 26-82 岁 | 第三方论文解读页 |
| 肿瘤直径范围 | 8 mm - 169 mm | 第三方论文解读页 |
| 对比期相 | arterial 26 / venous 50 / delayed 53 | 第三方论文解读页 / Zenodo v2 描述 |
性别构成(67 男 / 24 女,男性约 73.6%)明显偏斜。这一偏斜既反映 RCC 本身的流行病学特点(男性发病率高于女性),也叠加了 TCGA 队列的人群构成——作者据此警示:用该数据训练的模型在性别、人群多样性上可能泛化不足(§8.3)。
§3 标注流水线与开放科学定位
3.1 三层标注流水线
RCC-AID 的标注不是"专家一次画完",而是一条三段式流水线,与 PANDA-PLUS 的"学生劳动 + 专家终审"思路同源,但更依赖自动预标注:
| 层 | 角色 | 职责 |
|---|---|---|
| 层 0(机器) | 自动分割模型 | 生成初始肾脏与病灶掩码(框架见前作 arXiv:2505.07373) |
| 层 1(学生) | 两名受训学生 | 质检、纠错、补标肿瘤与囊肿 |
| 层 2(专家) | board-certified 放射科医师 | 复核不确定病例 |
这条流水线的效率逻辑与 PANDA-PLUS 一致:用自动预标注把"从零画"降级为"改一改",再用受训学生承担大部分修正工作,专家只处理机器与学生都不确定的边界案例。它把稀缺的专家注意力集中投放到真正困难的地方,是可迁移到其他影像标注任务的方法论(§7)。
3.2 开放科学的定位
RCC-AID 的核心动机是可复现性。论文标题直接点题:“Accessible and Reproducible Renal Cell Carcinoma Research Through Open-Sourcing Data and Annotations”(通过开源数据与标注实现可访问、可复现的肾细胞癌研究)。它的价值主张可以概括为一句话:
TCGA 影像早已公开且体量庞大,真正的瓶颈在标注。各家自行标注 → 门槛高 + 结果不可比。RCC-AID 把标注做一次、CC BY 4.0 开源 → 门槛降低、结果可对标。
作者还在致谢与数据描述里明确邀请社区参与:“By open-sourcing these annotations, we aim to foster accessible, reproducible AI research in renal cell carcinoma"以及"we invite other researchers who have previously annotated any of these cohorts to share their annotations”(邀请曾标注过这些队列的研究者共享标注)。这是典型的"开放标注生态"姿态——把数据集当作持续聚合的公共基础设施,而非一次性交付物。
§4 与其他数据集的定位比较
4.1 在肾肿瘤 CT 分割谱系中的位置
RCC-AID 与库内已有的 KiTS 系列构成"肾肿瘤 CT 分割"三角。三者可按"数据来源、术前/术后、是否开源标注"三个维度区分:
| 数据集 | 来源 | 定位 | 器官 | 标注开源 |
|---|---|---|---|---|
| KiTS(rid 80) | MICCAI 2019 挑战赛 | 术前增强 CT 肾脏/肿瘤/囊肿分割 | 肾 | 公开 |
| KiTS23(rid 698) | MICCAI 2023 挑战赛 | 术前多期相 CT 肾肿瘤分割(含良恶性/亚型) | 肾 | 公开 |
| RCC-AID | TCGA 三队列再标注 | 后验病理确诊队列的 CT 病灶标注 | 肾 | CC BY 4.0 完全公开 |
关键区别在于数据来源的血缘:KiTS 系列是"前瞻采集 + 竞赛驱动",通常由单一或多中心手术队列构成,标注围绕手术规划;RCC-AID 是"TCGA 已有影像的再标注",其病例自带 TCGA 的分子与临床注释、且经病理确诊亚型。因此 RCC-AID 更适合与基因组/多模态研究对接(TCGA 的分子数据可用),而 KiTS 系列更适合纯影像分割的基准对标。
4.2 与其他"TCGA 再标注"条目的关系
库内的 tcga(rid 25)与 tcga(rid 566)是 TCGA 本身的入口条目。RCC-AID 是"下游再标注品"——它消费 TCGA 的肾癌影像,产出新的分割标注。这种"上游本体 + 下游标注"的关系,与 PANDA→PANDA-PLUS 的模式同构:本体提供影像与病例,下游提供专家标注。区别是 RCC-AID 的下游产物完全开源(PANDA-PLUS 的掩码是请求制),因此可复现性更强。
4.3 与多器官腹部 CT 分割数据集的关系
abdomenct-1k(rid 402,千例腹部 CT 多器官分割)、ct-org(rid 796,140 例多器官 CT)、atlas-liver-tumor(rid 431,肝肿瘤 CE-MRI)属于"腹部/肿瘤影像分割"的邻近生态。RCC-AID 相对它们的差异是器官特化:它只做肾(及其肿瘤/囊肿),但把 RCC 亚型做透——这是"窄而深"对"宽而浅"的路线选择差异。
§5 版本双口径与来源考证
5.1 三个口径的完整对照
RCC-AID 的规模数字在三个来源上呈现两种口径,逐条登记如下(双口径存照的核心):
| 来源 | 类型 | CT/患者 | 亚型拆分 | 对应 Zenodo record |
|---|---|---|---|---|
| medRxiv 预印本(10.64898/2026.04.22.26351451) | 预印本 | 142 / 101 | 95 cc + 29 p + 18 ch | v1.0.0(19630298) |
| Zenodo v1.0.0(19630298) | 数据记录 | 142 / 101 | — | v1.0.0 |
| MELBA 正式版(2026:039) | 同行评审 | 129 / 91 | 85 cc + 26 p + 18 ch | v2.0.0(20719257) |
| Zenodo v2.0.0(20719257) | 数据记录 | 129 / 91 | 85 cc + 26 p + 18 ch | v2.0.0 |
处理口径:以 v2.0.0 / MELBA 正式版(129 / 91)为准。理由有三:(1) 它是同行评审版;(2) 它是 Zenodo Version log 明确记录的修正后版本;(3) 它是论文正式指向的数据记录(MELBA 条目页 Dataset 链接指向 20719257)。
预印本为何仍是旧口径:medRxiv 预印本(2026-04-22 前后)对应 v1.0.0 的数据状态,此后数据修正发生在 Zenodo 版本升级,预印本正文未同步更新。这不构成学术错误,但检索者若只读预印本会拿到过时数字。
5.2 Zenodo 双 record 的检索陷阱
Zenodo 上 19630298 与 20719257 两个记录的标题、作者、机构、许可、描述几乎完全一致,唯一系统性差异是版本号与文件包。这会制造真实事故:
- 包大小是快速判别锚:v1.0.0 的 images.zip = 6.6 GB;v2.0.0 的 images.zip = 4.1 GB。抓到 6.6 GB 就是 v1,抓到 4.1 GB 就是 v2。
- md5 是权威判别锚:两版每个文件的 md5 都不同(见 §2.3 与下表),脚本应校验 md5 而非仅依赖 URL。
- 不能靠"record id 更大 = 更新"以外的直觉:两者都标注 “Associated publication”,但 v1 只能指向预印本、v2 能指向已发表的 MELBA——这是描述文本里最隐蔽的一处差异。
| 文件 | v1.0.0 md5 | v2.0.0 md5 |
|---|---|---|
| 图像包 | d1f5cef9c9f4faa0be3bf72090baff51(images.zip 6.6GB) | 727a216d02a3fa10e0c8d852945d32fb(images.zip 4.1GB) |
| 标注/掩码包 | 4da371f87dffcfc8447c28cc241d1be4(annotations.zip 10.7MB) | 6d453071037640a79042033723442c1a(labels.zip 4.1MB) |
| metadata.csv | 76c54cd2e46c1655cb75cdf02bb23c50(80.6 kB) | 7297e5ea8201eddb0c3aae55c1068952(72.9 kB) |
| manifest.tcia | 53bff757e68fd4859062b16c848701bd(9.4 kB) | adfa32c16ef9287711cab0702083f3e7(8.6 kB) |
5.3 论文与数据的对应关系
- 数据:Zenodo 记录(v1 19630298 / v2 20719257),DOI 体系由 Zenodo 分配(记录页可获取 DOI 徽标)。
- 论文(正式):MELBA 2026:039,DOI 10.59275/j.melba.2026-2dg2,2026-09-21 出版,收录于特刊 Special Issue on MICCAI Open Data 2026——这一点值得注意:RCC-AID 是通过 MICCAI 开放数据特刊这一渠道发表的,说明它的核心贡献被定位为"开放数据集"而非"新算法"。
- 预印本:medRxiv,DOI 10.64898/2026.04.22.26351451。
- 前作(方法来源):arXiv:2505.07373(Robust Kidney Abnormality Segmentation),提供用于初标的自动分割框架。
§6 获取与许可:完全直链的罕见样本
6.1 获取方式
RCC-AID 最大的可用性亮点是完全公开直链、无任何门槛:
| 版本 | 入口 | 说明 |
|---|---|---|
| 最新版(推荐) | https://zenodo.org/records/20719257 | v2.0.0,4.1 GB,修复版 + 对比期相标注 |
| 早期版 | https://zenodo.org/records/19630298 | v1.0.0,6.6 GB,含静默转换失败文件,一般不建议 |
| 代码库 | https://github.com/DIAGNijmegen/oncology-RCC-AID-codebase | DIAG 组提供的配套代码 |
无需注册、无需邮件申请、无需签署数据使用协议——直接 curl/wget 或浏览器下载即可。这与库内多见的"请求制"(如 PANDA-PLUS 掩码)或"gated"(如部分 HuggingFace 数据集)形成鲜明对比。对可复现性而言,无门槛直链是最强的一档。
6.2 许可条款细读
RCC-AID 的许可是分层的,使用时需分别对待:
| 资产 | 许可 | 可否商用 | 关键义务 |
|---|---|---|---|
| 分割标注(segmentation annotations) | CC BY 4.0 | 可 | 署名、标明改动 |
| NIfTI 图像 + metadata.csv(源自 TCIA) | CC BY 3.0 | 可 | 署名、标明改动 |
两层许可都允许商用(CC BY 系列无 NC 限制),但都需要正确署名。署名要求是复合的:除 RCC-AID 本身外,还须引用三个 TCIA 源集合(KIRC/KIRP/KICH,各自的 DOI 见 §2.1),并附 TCGA 免责声明:
The results published here are in whole or in part based upon data generated by the TCGA Research Network: http://cancergenome.nih.gov/.
6.3 引用规范
根据 Zenodo 记录与论文,使用 RCC-AID 应引用:
- 论文(有同行评审版则以 MELBA 为准):
de Boer, Häntze, et al. RCC-AID: Renal Cell Carcinoma AI Dataset for Medical Imaging Research. Machine Learning for Biomedical Imaging, 2026 (MICCAI Open Data Special Issue): 772-782. doi:10.59275/j.melba.2026-2dg2 - 三个 TCIA 源集合(DOI 见 §2.1 表)。
- TCGA 免责声明(见 §6.2)。
6.4 资助与合规
本研究由欧盟 HORIZON-HLTH-2022: COMFORT(grant 101079894,全称 COMputational Models FOR patienT stratification in urologic cancers — Creating robust and trustworthy multimodal AI for health care)资助。Zenodo 记录附有 EU 免责声明:“Views and opinions expressed are those of the author(s) only and do not necessarily reflect those of the European Union…”——这是 EU 资助项目公开产出的标准合规条款,转引时宜保留。
§7 方法学启示与影响
7.1 "补标上游"比"采集新数据"更划算
RCC-AID 给整个医学影像数据集生态上了一课:当上游影像早已公开时,瓶颈往往在标注,而不是数据采集。与其耗费资源采集新一批 CT,不如把已公开、已被广泛使用、但缺标注的数据集补上标注。这个策略的经济性极高——TCGA 影像边际成本近乎为零,标注则是可复用的一次性投入。对研究者,它省去重复劳动;对社区,它让既往研究第一次可以公平对标。
7.2 三层流水线(机器初标 + 学生劳动 + 专家复核)的可迁移性
RCC-AID 的标注生产效率来自流水线:机器预标注把"画"降为"改",学生承担主修正量,专家只处理不确定样本。这套模式与 PANDA-PLUS 的"pre-med 学生注释 + 高年级复核 + 专家终审"高度同构,说明它已是医学影像标注的行业共识范式。可迁移性体现在:只要有任何一个能出初始分割的模型(哪怕不完美),就能把该流水线套用到新数据集上。
7.3 对肾癌 AI 研究的直接影响
RCC-AID 直接降低了肾癌 AI 研究的三道门槛:
- 分割研究:不再需要自行勾画肾脏/肿瘤,直接用 RCC-AID 掩码训练与评测。
- 亚型分类研究:借助 metadata.csv 的亚型标签 + 病灶掩码,可做"病灶区域特征 → 亚型"的研究,避免背景干扰。
- 影像组学研究:多期相 + 体素级标注 + 病理确诊亚型,是影像组学特征提取与验证的优质素材。
论文也明确列举了它的适用任务:segmentation(分割)、detection(检测)、subtype classification(亚型分类)、radiomics(影像组学)、multimodal RCC research(多模态 RCC 研究)。
7.4 局限与影响边界
RCC-AID 不是万能工具,论文与解读页都划清了边界:
- "研究用标注"而非临床金标准:作者原文强调标注由学生初做、专家复核,且未做多专家观察者间一致性测试,因此建议视为"质控后的研究用标注(quality-controlled research annotations)"而非绝对真理。
- 人群代表性问题:91 患者中男性占 73.6%,且数据多来自北美学术中心,模型在性别、地域多样性上的泛化存在风险。
- 罕见亚型样本少:chromophobe 仅 18 例、papillary 26 例,用于这些亚型的模型训练/评测时样本量偏小。
- 不是"医院可立即部署的工具":作者明确表示这是研究工具,而非即插即用的临床产品。
§8 使用指南与工程细节
8.1 快速上手路径
对想立刻用上 RCC-AID 的研究者,最短路径是:
1. 下载 v2.0.0(推荐从 Zenodo record 20719257)
   - images.zip  (4.1 GB) —— 增强 CT 图像(NIfTI)
   - labels.zip  (4.1 MB) —— 体素级分割掩码(NIfTI)
   - metadata.csv         —— 病例级元数据(亚型/人口学/期相/TCIA ID)
   - manifest.tcia        —— 可选:回源下载原始 DICOM
2. 解压后按文件名配对 images/ 与 labels/(同名 = 同例)
3. 读 metadata.csv 建立 case_id → 患者ID → 亚型 → 期相 的映射表
4. 按【患者ID】而非 case_id 划分训练/验证/测试集(防数据泄漏,见 §8.2)
5. 训练分割模型(标签 1/2/3)或提取影像组学特征做亚型分类
8.2 三条必须知道的工程陷阱
陷阱一:按患者而非按扫描划分数据集。 129 张 CT 来自 91 名患者,且部分患者有多个期相(arterial/venous/delayed)。若按 CT 张数随机划分,同一患者的动脉期可能进训练集、静脉期进测试集,模型会"见过"该患者从而虚高测试分数。必须按患者 ID 分组划分(group split)。
陷阱二:不要把 v1.0.0 与 v2.0.0 混用。 两者的文件命名、目录结构(annotations/ vs labels/)、病例数都不同。若从不同来源拼凑数据,会得到版本不一致的混合集。建议只用一个版本,并记录所用版本的 record id 与文件 md5。
陷阱三:期相元数据缺失的容错。 对比期相标注是 v2.0.0 新增的字段,因此只有 v2.0.0 的 metadata.csv 有期相列。若代码依赖期相字段,必须确认在 v2 上运行;在 v1 上运行会因列缺失而报错。
8.3 标注质量的正确预期
使用者应把 RCC-AID 标注理解为**“质控后的研究用标注”**,而非绝对金标准。理由:
- 标注由受训学生主做(机器初标后的修正),专家仅复核不确定病例——即大部分"学生认为确定"的标注未经专家逐例确认。
- 未测多专家观察者间一致性(inter-observer variability)——作者未报告不同专家之间的分歧率,因此无法量化标注的边界误差。
- 因此建议:对精度要求极高的临床应用,仍需自带专家复核;对研究、原型、基准对标,可直接使用。
8.4 语料/标注偏倚的正视
三个偏倚源需在使用前awareness:
- 性别偏斜:67 男 / 24 女。做性别相关分析或追求人群公平性时,须意识到女性样本不足。
- 地域偏斜:来源多为北美学术中心,TCGA 队列本身的纳入标准与人群构成不代表全球患者。
- 亚型不均衡:clear cell 85 例占绝对多数,chromophobe 18 例最少——训练多类分类器时需处理类别不均衡(重采样/加权/分层采样)。
§9 与库内条目的关系
9.1 家族图谱
RCC-AID 在库内可挂接三条血缘线:
线一:TCGA 血缘(上游本体)
tcga(rid 25)—— TCGA 癌症基因组图谱 AI-Ready 数据集tcga(rid 566)—— TCGA — AI-Ready Wikipedia- 关系:RCC-AID 消费 TCGA 的肾癌影像(KIRC/KIRP/KICH),是 TCGA 的下游再标注品。TCGA 提供影像 + 分子 + 临床,RCC-AID 提供体素级分割标注。
线二:肾肿瘤 CT 分割赛道(同器官同任务)
kits(rid 80)—— KiTS 肾脏与肾脏肿瘤分割kits23(rid 698)—— KiTS23 肾脏肿瘤分割挑战赛(MICCAI 2023)- 关系:三者构成"肾肿瘤 CT 分割"三件套。KiTS/KiTS23 是挑战赛驱动的前瞻采集数据;RCC-AID 是 TCGA 后验标注的开放数据。做肾肿瘤分割的研究应把三者放在同一谱系中比较与互补。
线三:腹部/多器官肿瘤分割邻近
abdomenct-1k(rid 402)—— 千例腹部 CT 多器官分割ct-org(rid 796)—— 140 例多器官 CT 分割atlas-liver-tumor(rid 431)—— 肝肿瘤 CE-MRI 分割基准heart-lung-segmentations-data(rid 610)—— 心肺手工分割金标准- 关系:同属"器官/病灶体素级分割"方法学家族,可互为方法学参照(标注流水线、评测协议)。
9.2 检索路径建议
- 找"肾肿瘤 CT 分割数据":用
kits OR kits23 OR rcc-aid组合。 - 找"TCGA 影像再标注":沿
tcga(rid 25/566)的出边找下游(PANDA-PLUS 之于 PANDA 是同构模式)。 - 找"肿瘤影像开放标注":按模态(CT/MRI)+ 任务(分割)+ 疾病(肿瘤学)交叉检索,RCC-AID 与 atlas-liver-tumor 是 CT/MRI 两端的代表。
- 找"多期相/多模态 RCC":RCC-AID 的期相字段(arterial/venous/delayed)+ TCGA 分子数据是其独有优势。
§10 避坑清单:八个已踩过的坑
坑 1:规模双口径(142 vs 129)。 medRxiv 预印本与 Zenodo v1.0.0 都写 142 CT / 101 患者;MELBA 正式版与 Zenodo v2.0.0 写 129 CT / 91 患者。根因是 v1.0.0 存在 DICOM→NIfTI 静默转换失败,v2 修复后移除坏文件。引用一律以 129/91 为准(v2.0.0/MELBA 版),并在显著位置注明旧口径。
坑 2:Zenodo 双 record 混淆。 19630298(v1.0.0,6.6 GB,annotations/ 目录)与 20719257(v2.0.0,4.1 GB,labels/ 目录)标题作者几乎相同。用包大小或 md5 判别版本,不要只看标题。最新版入口是 20719257。
坑 3:目录名随版本变化。 v1.0.0 用 annotations/,v2.0.0 用 labels/。写脚本不能硬编码目录名,应读 Zenodo 文件清单或 metadata。
坑 4:patient 数 ≠ scan 数,划分必须按患者。 129 CT 来自 91 患者(部分多期相/多序列)。按张数随机划分会造成数据泄漏,测试分数虚高。必须 group split by patient ID。
坑 5:期相字段仅 v2 有。 对比期相(arterial/venous/delayed)是 v2.0.0 新增标注。依赖期相列的代码在 v1.0.0 上会因缺列报错。
坑 6:radiomics 四数字来源存疑。 “cysts 0.93 / clear cell 0.84 / papillary 0.90 / chromophobe 0.86” 出现在第三方论文解读页(gist.science),MELBA 摘要与 Zenodo 描述均未列出,属探索性结果。正式引用前应核 MELBA PDF 正文,勿直接当论文主结果引用。
坑 7:许可分层,别一揽子引用。 分割标注是 CC BY 4.0,但 NIfTI 图像与 metadata.csv 源自 TCIA、遵循 CC BY 3.0——两者不同。署名义务是复合的(RCC-AID + 三个 TCIA 源集合 + TCGA 免责声明)。
坑 8:不是临床金标准。 标注由学生主做、专家仅复核不确定病例,且未测观察者间一致性。作者原文定位为"质控后的研究用标注"。追求临床级精度者须自行专家复核,勿把它当 ground truth 直接部署。
§11 总结
11.1 三句话总结
- RCC-AID 是"给 TCGA 肾癌影像补标注"的开放数据集:把 TCGA 三大肾癌队列(KIRC/KIRP/KICH)长期缺失的公开病灶标注一次性做出来,129 张 CT / 91 名患者的体素级肾脏、肿瘤、囊肿标注。
- 它完全开源、无门槛:CC BY 4.0(标注)/ CC BY 3.0(源自 TCIA 的图像与元数据),Zenodo 直链公开,无需申请——这在医学影像数据集里属于可用性最强的一档。
- 它示范了一条可复制的路:自动模型初标 + 受训学生质检 + 专家复核不确定病例,把稀缺专家注意力用在刀刃上——这也是它最值得其他数据集借鉴的方法论遗产。
11.2 适合谁
- 肾肿瘤分割研究者:直接用掩码训练/评测肾脏、肿瘤分割模型。
- 肾癌亚型分类研究者:借 metadata 亚型标签 + 病灶掩码做"病灶区域特征 → 亚型"研究。
- 影像组学研究者:多期相 + 体素级标注 + 病理确诊亚型,是特征提取与验证的优质素材。
- 多模态 RCC 研究者:可与 TCGA 的分子、临床数据对接。
- 数据集方法论研究者:RCC-AID 的标注流水线(机器 + 学生 + 专家)和开放科学姿态是可复制的样本。
- 可复现性倡导者:它是"补标上游、完全开源"路线的标杆案例。
11.3 不适合谁
- 想要临床级金标准标注者:未测观察者间一致性,标注定位为研究用,临床部署需自行专家复核。
- 追求人群多样性均衡者:67 男 / 24 女、多来自北美学术中心,人群代表性有限。
- 需要大量罕见亚型样本者:chromophobe 仅 18 例、papillary 26 例,样本偏少。
- 想要术前规划专用数据者:KiTS/KiTS23 更贴合术前手术规划场景。
- 想要"现成基准榜单"者:RCC-AID 未设独立基准榜,需自建评测协议。
11.4 30 秒决策卡
| 你的需求 | 建议动作 |
|---|---|
| 立刻下数据跑分割 | Zenodo record 20719257 → images.zip + labels.zip(CC BY 4.0,直链) |
| 做肾肿瘤分割对标 | RCC-AID + KiTS(rid 80)+ KiTS23(rid 698)三件套一起读 |
| 做 TCGA 影像的下游研究 | 沿 tcga(rid 25/566)血缘,RCC-AID 是肾癌分支的再标注品 |
| 引用规模数字 | 用 v2.0.0 的 129 / 91,注明 v1.0.0 旧口径 142 / 101(坑 1) |
| 做训练/测试划分 | 按患者 ID 分组,切勿按 CT 张数随机划分(坑 4) |
| 规划自己的标注项目 | 借鉴 §3.1 三层流水线 + §8.3 质量预期定位 |
FAQ(高频问答 30 问)
A. 基础认知
A1:RCC-AID 的 AID 是什么?
AI Dataset。全称 Renal Cell Carcinoma AI Dataset for Medical Imaging Research。
A2:它采集了新数据吗?
没有。它是对 TCGA 已有肾癌影像的再标注(补公开标注),影像本体来自 TCGA/TCIA。
A3:它和 TCGA 是什么关系?
TCGA 是上游影像来源,RCC-AID 是下游标注产物。RCC-AID 消费 TCGA 的 KIRC/KIRP/KICH 三队列影像。
A4:它和库内 chronic-kidney-disease-uci(rid 726)是一回事吗?
不是。后者是 UCI 慢性肾病表格化临床指标数据集,无影像、无分割,与 RCC-AID 完全不同。
A5:RCC 是什么?
Renal Cell Carcinoma,肾细胞癌,肾脏最常见的恶性肿瘤,约占成人肾癌的九成。
A6:三种亚型有什么区别?
clear cell(透明细胞)最常见、预后相对差;papillary(乳头状)次之;chromophobe(嫌色细胞)相对少见、预后较好。三者病理、预后、治疗反应不同,区分至关重要。
A7:谁做的?
Radboud University Medical Center(Radboudumc)医学影像系 DIAG 组领衔,8 位作者来自荷兰、德国、意大利 6 家机构。
A8:什么时候发布的?
数据 v1.0.0 于 2026-04-22 上 Zenodo;正式论文(MELBA)2026-09-21 出版。
B. 数据与获取
B1:多少人多少张?
v2.0.0:129 张 CT / 91 名患者。v1.0.0 是 142 / 101(旧口径)。
B2:为什么 CT 数多于患者数?
一名患者可能有多个期相或多个序列的 CT(如动脉期、静脉期、延迟期)。期相构成:arterial 26 / venous 50 / delayed 53。
B3:三种亚型各多少?
clear cell 85 / papillary 26 / chromophobe 18(v2.0.0)。
B4:要申请吗?
不用。完全公开直链,Zenodo 直接下载,无 gated、无请求制。
B5:最新版在哪下?
https://zenodo.org/records/20719257(v2.0.0,4.1 GB)。
B6:v1 和 v2 该下哪个?
下 v2.0.0。v1.0.0 有部分 DICOM→NIfTI 转换静默失败的文件,v2 已修复并移除坏文件,还新增了期相标注。
B7:文件格式?
NIfTI(.nii.gz)图像与掩码,CSV 元数据,TCIA manifest 清单,Zip 打包。
B8:能追溯到原始 DICOM 吗?
能。包内的 manifest.tcia 用 NBIA Data Retriever 打开即可回源下载原始 DICOM。
B9:许可是什么?
分割标注 CC BY 4.0;NIfTI 图像与 metadata.csv 源自 TCIA,CC BY 3.0。都可商用,都需署名。
B10:怎么引用?
引 MELBA 论文(doi:10.59275/j.melba.2026-2dg2)+ 三个 TCIA 源集合 + TCGA 免责声明。
C. 标注与质量
C1:标注是什么粒度?
体素级(voxel-level)分割掩码,每张 CT 一份。
C2:标签有哪些?
0 背景 / 1 肾脏 / 2 肿瘤 / 3 囊肿。
C3:谁标的?
自动分割模型初标 → 两名受训学生质检纠错补标 → 不确定病例由 board-certified 放射科医师复核。
C4:标注可靠吗?
属"质控后的研究用标注",非绝对金标准。作者未做多专家观察者间一致性测试。
C5:有观察者间一致性数据吗?
没有。这是作者明确承认的一条局限(遗留疑点)。
C6:怎么标注肿瘤和囊肿?
学生在自动初标基础上补标。肿瘤 = 实性病灶(标签 2),囊肿 = 囊性病变(标签 3)。
D. 使用与工程
D1:划分训练/测试要注意什么?
按患者 ID 分组划分。129 CT 来自 91 患者,按张数随机划分会因同患者多期相造成数据泄漏。
D2:类别不均衡怎么办?
clear cell 占多数(85/129),chromophobe 最少(18)。需重采样/加权/分层采样处理。
D3:有代码库吗?
有。GitHub DIAGNijmegen/oncology-RCC-AID-codebase。
D4:有基准榜单吗?
没有独立榜单。论文把它定位为"可复用开放资源数据集",评测协议需自建。
D5:论文里有什么实验结果?
第三方解读页提到 radiomics 模型区分肾肿物的探索性结果(cysts 0.93 / clear cell 0.84 / papillary 0.90 / chromophobe 0.86)——但 MELBA 摘要未直载,正式引用前应核 PDF(坑 6)。
D6:可以做哪些任务?
分割、检测、亚型分类、影像组学、多模态 RCC 研究。
D7:哪来的钱做的?
欧盟 HORIZON-HLTH-2022: COMFORT 项目(grant 101079894)。
D8:和 KiTS 什么区别?
KiTS 系列是挑战赛驱动的前瞻采集数据(术前规划);RCC-AID 是 TCGA 后验病理确诊队列的再标注,更适合与分子/多模态研究对接。
事实清单(硬事实 30 条)
- 全称:RCC-AID: Renal Cell Carcinoma AI Dataset for Medical Imaging Research。
- 本质:TCGA 肾癌影像的公开病灶标注补全数据集,非新采集。
- 团队主体:Radboud University Medical Center(Radboudumc)医学影像系 DIAG 组。
- 8 位作者:de Boer, Häntze, Ziegelmayer, Russo, van Ginneken, Prokop, Bressem, Hering。
- 机构覆盖:荷兰、德国、意大利共 6 家。
- 正式论文:MELBA 2026, MICCAI Open Data 特刊:772-782。
- 论文 DOI:10.59275/j.melba.2026-2dg2。
- 论文出版日:2026-09-21。
- 预印本:medRxiv,DOI 10.64898/2026.04.22.26351451。
- 数据 v1.0.0:Zenodo 19630298,2026-04-22,142 CT / 101 患者,6.6 GB。
- 数据 v2.0.0:Zenodo 20719257,129 CT / 91 患者,4.1 GB。
- 亚型分布(v2):clear cell 85 / papillary 26 / chromophobe 18。
- 患者构成:91 人,24 女 / 67 男。
- 平均年龄:56 岁;范围 26-82 岁。
- 肿瘤直径范围:8-169 mm。
- 筛查起点:1,915 张 CT(三 TCGA-RCC 库)。
- 阅片纳入:全部 papillary(n=56) + 全部 chromophobe(n=27) + 随机 200 clear cell。
- 期相构成:arterial 26 / venous 50 / delayed 53。
- 标注粒度:体素级分割(voxel-level)。
- 标签体系:0 背景 / 1 肾脏 / 2 肿瘤 / 3 囊肿。
- 图像格式:NIfTI(.nii.gz),源自 TCIA DICOM。
- 源队列:TCGA-KIRC / TCGA-KIRP / TCGA-KICH。
- 源集合许可:TCIA,CC BY 3.0。
- 标注许可:CC BY 4.0。
- 获取方式:Zenodo 完全公开直链,无 gated。
- 代码库:GitHub DIAGNijmegen/oncology-RCC-AID-codebase。
- 资助:EU HORIZON-HLTH-2022 COMFORT,grant 101079894。
- 标注流水线:自动模型初标 → 2 名受训学生质检 → board-certified 医师复核。
- 适用任务:分割 / 检测 / 亚型分类 / 影像组学 / 多模态 RCC。
- 关键局限:性别偏斜、未测观察者间变异、罕见亚型样本少。
术语表(25 条)
| 术语 | 英文 | 释义 |
|---|---|---|
| 肾细胞癌 | Renal Cell Carcinoma (RCC) | 肾脏最常见恶性肿瘤,约占成人肾癌九成 |
| 透明细胞肾癌 | clear cell RCC | RCC 最常见亚型,对应 TCGA-KIRC |
| 乳头状肾癌 | papillary RCC | RCC 第二常见亚型,对应 TCGA-KIRP |
| 嫌色细胞肾癌 | chromophobe RCC | RCC 较少见亚型,对应 TCGA-KICH |
| 增强 CT | contrast-enhanced CT | 注射对比剂后的 CT,RCC 诊断核心影像 |
| 体素级标注 | voxel-level annotation | 三维像素(体素)级的分割标注 |
| 分割掩码 | segmentation mask | 逐体素标注类别的图像 |
| 标签图 | label map | 用整数标签表示各体素类别的掩码 |
| 肾脏分割 | kidney segmentation | 勾画肾脏区域的任务 |
| 病灶分割 | lesion segmentation | 勾画肿瘤等病灶区域的任务 |
| 囊肿 | cyst | 肾脏囊性病变,与实性肿瘤鉴别是临床问题 |
| 亚型分类 | subtype classification | 区分 RCC 三种亚型的任务 |
| 影像组学 | radiomics | 从影像提取高通量特征做定量分析 |
| NIfTI | Neuroimaging Informatics Technology Initiative | 医学影像常用格式(.nii.gz) |
| DICOM | Digital Imaging and Communications in Medicine | 医学影像标准格式 |
| TCIA | The Cancer Imaging Archive | 癌症影像公共数据库 |
| TCGA | The Cancer Genome Atlas | 癌症基因组图谱计划 |
| 期相 | contrast phase | CT 扫描的对比剂时相(动脉/静脉/延迟) |
| 数据泄漏 | data leakage | 训练/测试集不当重叠导致评测虚高 |
| 分组划分 | group split | 按患者等分组划分数据集以防泄漏 |
| 观察者间变异 | inter-observer variability | 不同标注者结果的一致性差异 |
| 类别不均衡 | class imbalance | 各类样本数量差异过大 |
| 开放数据 | open data | 无门槛公开可用的数据 |
| CC BY 4.0 | Creative Commons Attribution 4.0 | 允许商用、需署名的开放许可 |
| 数据使用协议 | data use agreement | 请求制数据集的再分发/使用条款 |
附录
附录 A:条目信息速查卡
| 字段 | 内容 |
|---|---|
| slug | rcc-aid |
| 官方名 | RCC-AID: Renal Cell Carcinoma AI Dataset for Medical Imaging Research |
| 中文名 | 肾细胞癌 AI 数据集(医学影像研究用) |
| 论文 | MELBA 2026:039(doi:10.59275/j.melba.2026-2dg2) |
| 数据最新版 | Zenodo record 20719257(v2.0.0,4.1 GB) |
| 规模(v2) | 129 CT / 91 患者 |
| 许可 | 标注 CC BY 4.0|图像与元数据 CC BY 3.0 |
| 获取 | Zenodo 直链,无 gated |
| 代码 | github.com/DIAGNijmegen/oncology-RCC-AID-codebase |
| 库内互链 | tcga(25)/kits(80)/kits23(698)/abdomenct-1k(402) |
| 抓取时点 | 2026-10-09 |
附录 B:DAIMS 评估全表
| 维度 | 评分(1-10) | 依据 |
|---|---|---|
| D 可发现性 | 9 | MELBA 开放获取 + Zenodo 索引 + GitHub 代码库;论文被 MICCAI Open Data 特刊收录,检索路径通畅 |
| A 可获取性 | 10 | Zenodo 完全公开直链,无 gated、无请求制、无 DUA;这是本数据集最强维度 |
| I 可互操作 | 8 | 标准 NIfTI + CSV + TCIA manifest;可回源 DICOM;但无官方转换脚本到其它格式 |
| M 元数据质量 | 8 | metadata.csv 含亚型/人口学/期相/TCIA ID;但版本双口径(142 vs 129)与未测观察者间变异微降分 |
| S 可持续性 | 8 | Zenodo 长期托管 + GitHub 代码库 + EU 资助;依赖个人/机构维护,无正式长期保存协议 |
| 综合评级 | 8.6/10(优) | 开放程度与可复现性显著高于均值;扣分主要在元数据版本口径与标注一致性未测 |
附录 C:逐项证据链自证
| 关键数字 | 来源 | 位置 |
|---|---|---|
| 129 CT / 91 患者 | MELBA 摘要 + Zenodo v2 描述 | melba-journal.org 2026:039 / zenodo 20719257 |
| 85 cc + 26 p + 18 ch | MELBA 摘要 + Zenodo v2 描述 | 同上 |
| 142 CT / 101 患者(v1) | Zenodo v1 描述 + medRxiv | zenodo 19630298 / medRxiv 摘要 |
| 1,915 张筛查 | MELBA 摘要 | melba-journal.org 2026:039 |
| papillary 56 / chromophobe 27 / 200 cc | MELBA 摘要 | 同上 |
| 24 女 / 67 男,均值 56 | MELBA 摘要 + Zenodo | 同上 |
| 26-82 岁 / 8-169 mm | 第三方解读页 | gist.science |
| arterial 26 / venous 50 / delayed 53 | 第三方解读页 + Zenodo v2 描述 | gist.science / zenodo 20719257 |
| 标签 0/1/2/3 | Zenodo v2 描述 | zenodo 20719257 |
| CC BY 4.0(标注) | Zenodo v2 License | zenodo 20719257 |
| CC BY 3.0(TCIA 图像) | Zenodo v2 License | zenodo 20719257 |
| Version log 原文 | Zenodo v2 描述 | zenodo 20719257 |
| 文件 md5 与大小 | Zenodo v1/v2 文件清单 | zenodo 19630298 / 20719257 |
| 代码库 URL | Zenodo v2 Software 字段 | zenodo 20719257 |
| grant 101079894 | Zenodo v2 Funding | zenodo 20719257 |
| 论文 DOI/pages | MELBA 条目元数据 | melba-journal.org 2026:039 |
| radiomics 0.93/0.84/0.90/0.86 | 第三方解读页(存疑) | gist.science(坑 6) |
附录 D:数据获取决策树
需求是什么?
├── 想直接用标注训练分割模型
│   └── Zenodo 20719257 → images.zip + labels.zip(CC BY 4.0,直链)
├── 想回源原始 DICOM
│   └── 用包内 manifest.tcia + NBIA Data Retriever 从 TCIA 下载
├── 想与分子/多模态数据结合
│   └── 沿 TCGA(rid 25/566)血缘,对接 KIRC/KIRP/KICH 的组学数据
├── 想做肾肿瘤分割对标
│   └── RCC-AID + KiTS(80) + KiTS23(698) 组合比较
├── 想复用标注流水线
│   └── 读 MELBA 论文方法节 + GitHub 代码库;借鉴三层结构
└── 只想引用规模数字
    └── 用 v2 的 129/91,注明 v1 旧口径 142/101(坑 1)
附录 E:分割标签映射与使用规范
| 标签值 | 名称 | 用途 | 注意事项 |
|---|---|---|---|
| 0 | Background | 负样本 / 忽略 | 训练时通常作背景类或忽略 |
| 1 | Kidney | 肾脏分割 | 含肿瘤/囊肿所在器官的整体轮廓 |
| 2 | Tumor | 肿瘤分割 | 实性病灶,RCC 的研究核心 |
| 3 | Cyst | 囊肿分割 | 良性囊性病变,用于良恶性鉴别 |
使用规范:
- 多类分割时保持标签值映射固定,勿重排。
- 肾脏(1)与肿瘤(2)、囊肿(3)在空间上嵌套——肿瘤/囊肿位于肾脏内,训练时注意层级关系。
- 做二值"肿瘤 vs 非肿瘤"时,可将 2 视为前景、{0,1,3} 视为背景;但注意是否要把囊肿排除。
附录 F:版本选择决策与校验清单
| 步骤 | 操作 |
|---|---|
| 1 | 确认从 zenodo.org/records/20719257 下载(v2.0.0) |
| 2 | 核对 images.zip 大小 = 4.1 GB(若是 6.6 GB 则是误抓 v1) |
| 3 | 核对 md5:images.zip=727a…d32fb,labels.zip=6d45…c42c1a,metadata.csv=7297…68952,manifest.tcia=adfa…3f3e7 |
| 4 | 确认目录为 images/ + labels/(v1 是 annotations/) |
| 5 | 读 metadata.csv 确认含对比期相列(v1 无此列) |
| 6 | 建立 case_id → 患者ID 映射,按患者分组划分 |
附录 G:训练/测试划分骨架(伪代码)
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit

meta = pd.read_csv("metadata.csv")
# 关键:按患者 ID 分组,而非按 case_id 随机
groups = meta["patient_id"]          # 同一患者的不同期相归同组
gss = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
train_idx, test_idx = next(gss.split(meta, groups=groups))
train, test = meta.iloc[train_idx], meta.iloc[test_idx]

# 检查无患者跨越两集合
assert set(train["patient_id"]).isdisjoint(set(test["patient_id"]))
# 检查亚型分布(注意 chromophobe 仅 18 例,分层需谨慎)
print(train["subtype"].value_counts(), test["subtype"].value_counts())
附录 H:文件结构示意
RCC-AID v2.0.0(Zenodo 20719257)
├── images.zip   (4.1 GB)  → images/<case>.nii.gz        增强 CT 图像
├── labels.zip   (4.1 MB)  → labels/<case>.nii.gz        分割掩码(0/1/2/3)
├── metadata.csv (72.9 kB) → 病例级元数据
└── manifest.tcia (8.6 kB) → TCIA 回源清单

metadata.csv 关键列(示意):
  case_id | patient_id | subtype | sex | age | contrast_phase | tcia_series_uid
  ------- | ---------- | ------- | --- | --- | -------------- | ---------------
  ...     | ...        | clear cell / papillary / chromophobe | M/F | ... | arterial/venous/delayed | ...
附录 I:标注流水线复现骨架(SOP)
RCC-AID 式三层标注 SOP(可迁移到其它影像数据集)
─────────────────────────────────────────────
阶段 0|自动初标
  - 选一个可用的分割模型(如 arXiv:2505.07373 框架)
  - 对目标影像批量生成初始肾脏/病灶掩码
  - 目的:把"从零画"降级为"改一改"

阶段 1|受训学生质检
  - 招募 2+ 名受训标注者
  - 职责:质检初标、纠错、补标肿瘤与囊肿
  - 产出:学生修正后的掩码 + 不确定案例清单

阶段 2|专家复核
  - board-certified 医师仅复核"不确定案例"
  - 目的:把稀缺专家注意力投给最困难的边界

阶段 3|质控与发布
  - 排除不合格样本、统一格式
  - 生成 metadata + 清单文件
  - 选定开放许可(如 CC BY 4.0)并直链发布
─────────────────────────────────────────────
关键经验:明确标注定位(研究用 vs 临床金标准),
若未测观察者间一致性,应在文档中如实声明。
附录 J:适用任务适配表
| 任务 | 用到的标签 | 输入 | 输出 | 备注 |
|---|---|---|---|---|
| 肾脏分割 | 1 | CT | 肾脏掩码 | 器官级任务 |
| 肿瘤分割 | 2 | CT | 肿瘤掩码 | 病灶级核心任务 |
| 囊肿分割 | 3 | CT | 囊肿掩码 | 良性病变 |
| 肿瘤检测 | 2 | CT | 病灶框/位置 | 可由掩码导出框 |
| 亚型分类 | metadata 亚型 + 掩码 | 病灶区域 | clear/papillary/chromophobe | 借掩码聚焦病灶 |
| 影像组学 | 1/2/3 + 元数据 | 病灶区域 | 高通量特征 | 多期相是优势 |
| 多模态 RCC | 全 + TCGA 组学 | 影像 + 分子 | 联合模型 | 对接 TCGA |
附录 K:与 KiTS/KiTS23 的对照详表
| 维度 | RCC-AID | KiTS(rid 80) | KiTS23(rid 698) |
|---|---|---|---|
| 来源 | TCGA 再标注 | MICCAI 2019 挑战赛 | MICCAI 2023 挑战赛 |
| 采集性质 | 后验(已有影像) | 前瞻采集 | 前瞻采集 |
| 器官 | 肾 | 肾 | 肾 |
| 标签 | 背景/肾/肿瘤/囊肿 | 肾/肿瘤/囊肿 | 肾/肿瘤/(亚型相关) |
| 亚型信息 | metadata 有 | 有限 | 有(良恶性/亚型) |
| 多期相 | 有(arterial/venous/delayed) | 通常单期 | 多期相 |
| 分子数据对接 | 可(TCGA) | 不可 | 不可 |
| 许可 | CC BY 4.0 / 3.0 | 见条目 | 见条目 |
| 最适合 | 与 TCGA 组学结合的研究 | 经典分割基准 | 多期相肾肿瘤分割 |
附录 L:患者人口学与偏倚登记
| 维度 | 数值 | 偏倚含义 |
|---|---|---|
| 总数 | 91 患者 | — |
| 性别 | 24 女 / 67 男 | 男性约 73.6%,女性样本不足 |
| 年龄 | 均值 56,范围 26-82 | 覆盖广,但以中老年为主 |
| 亚型 | clear 85 / papillary 26 / chromophobe 18 | 类别不均衡,罕见亚型少 |
| 期相 | arterial 26 / venous 50 / delayed 53 | 期相分布亦不均衡 |
| 地域 | 多为北美学术中心 | 人群代表性受限 |
附录 M:与库内 TCGA 条目(rid 25/566)的关系声明
RCC-AID 与库内 tcga(rid 25 与 rid 566)是上游—下游关系,而非重复条目:
- 上游
tcga:提供 TCGA 整体的影像、分子、临床数据入口。它是"癌症基因组图谱"这一庞大计划的门户条目。 - 下游 RCC-AID:只消费 TCGA 的肾癌影像子集(KIRC/KIRP/KICH),产出新的体素级分割标注,并以独立 DOI 与版本体系发布。
- 血缘先例:这与 PANDA → PANDA-PLUS 的模式同构(本体提供数据,下游提供专家标注);区别是 RCC-AID 的下游产物完全开源。
- 互链价值:检索 TCGA 影像的研究者,可沿 rid 25/566 → rcc-aid 路径发现肾癌分支的可用标注;反之,使用 RCC-AID 者应回引 TCGA 源集合(署名义务,见 §6.2)。
附录 N:许可条款细读
| 资产 | 许可 | 允许 | 要求 | 禁止 |
|---|---|---|---|---|
| 分割标注 | CC BY 4.0 | 商用、再分发、改编 | 署名、标明改动、附许可 | 无(CC BY 无 NC/ND 限制) |
| NIfTI 图像 + metadata.csv | CC BY 3.0(源自 TCIA) | 商用、再分发 | 署名 TCIA 源集合、标明改动 | 无 |
| 论文(MELBA) | 依 MELBA 期刊条款 | 视期刊而定 | 标准引用 | — |
| 代码(GitHub) | 见仓库 LICENSE | 视仓库而定 | 视仓库而定 | — |
要点:
- 两层数据许可不同(4.0 vs 3.0),署名时都需注明出处。
- 署名是复合义务:RCC-AID + 三个 TCIA 源集合(KIRC/KIRP/KICH)+ TCGA 免责声明。
- CC BY 系列允许商用,但商用前仍建议核对 TCIA 与 TCGA 的原始条款。
附录 O:引用模板(BibTeX 参考)
@article{deboer2026rccaid,
  title   = {RCC-AID: Renal Cell Carcinoma AI Dataset for Medical Imaging Research},
  author  = {de Boer, Sarah and H{\"a}ntze, Hartmut and Ziegelmayer, Sebastian and
             Russo, Tommaso and van Ginneken, Bram and Prokop, Mathias and
             Bressem, Keno and Hering, Alessa},
  journal = {Machine Learning for Biomedical Imaging},
  volume  = {2026},
  number  = {Special Issue on MICCAI Open Data 2026},
  pages   = {772--782},
  year    = {2026},
  issn    = {2766-905X},
  doi     = {10.59275/j.melba.2026-2dg2},
  url     = {https://melba-journal.org/2026:039}
}
数据引用(示例):
de Boer, S., Häntze, H., et al. (2026). RCC-AID: Renal Cell Carcinoma AI Dataset
for Medical Imaging Research (Version 2.0.0) [Data set]. Zenodo.
https://zenodo.org/records/20719257

并须引用 TCIA 源集合:
- Akin, O., et al. (2016). TCGA-KIRC (Version 3) [Data set]. TCIA.
  https://doi.org/10.7937/K9/TCIA.2016.V6PBVTDR
- Linehan, M., et al. (2016). TCGA-KIRP (Version 4) [Data set]. TCIA.
  https://doi.org/10.7937/K9/TCIA.2016.ACWOGBEF
- Linehan, M. W., et al. (2016). TCGA-KICH (Version 3) [Data set]. TCIA.
  https://doi.org/10.7937/K9/TCIA.2016.YU3RBCZN
- 并附:The results published here are in whole or in part based upon data
  generated by the TCGA Research Network: http://cancergenome.nih.gov/.
附录 P:投稿与发表路径记录
| 阶段 | 事件 | 时间 |
|---|---|---|
| 数据首发 | Zenodo v1.0.0(142/101) | 2026-04-22 |
| 预印本 | medRxiv(10.64898/2026.04.22.26351451) | 2026-04 前后 |
| 数据修正 | Zenodo v2.0.0(129/91,+期相) | 2026(晚于 v1) |
| 正式发表 | MELBA 2026:039(MICCAI Open Data 特刊) | 2026-09-21 |
观察:RCC-AID 走的是"先发数据、再发论文、数据随论文修正"的开放科学流程,版本迭代与发表节奏耦合——这正是版本双口径的成因。
附录 Q:双口径登记表
| 项目 | 口径 A | 口径 B | 采用 |
|---|---|---|---|
| CT 数 | 142(v1/预印本) | 129(v2/MELBA) | 129 |
| 患者数 | 101(v1/预印本) | 91(v2/MELBA) | 91 |
| clear cell | 95(v1) | 85(v2) | 85 |
| papillary | 29(v1) | 26(v2) | 26 |
| chromophobe | 18(v1) | 18(v2) | 18 |
| 图像包大小 | 6.6 GB(v1) | 4.1 GB(v2) | 4.1 GB |
| 掩码目录名 | annotations/(v1) | labels/(v2) | labels/ |
| 期相标注 | 无(v1) | 有(v2) | 有 |
附录 R:检索决策树
你要找的是不是 RCC-AID?
├── 关键词含 "renal cell carcinoma" + "CT" + "segmentation"
│   └── 是 RCC-AID 的可能性高
├── 关键词含 "kidney tumor" + "challenge"
│   └── 可能是 KiTS/KiTS23,不是 RCC-AID
├── 关键词含 "chronic kidney disease" + 表格/临床指标
│   └── 是库内 rid 726(UCI CKD),不是 RCC-AID
├── 关键词含 "TCGA" + "kidney" + "annotation"
│   └── 指向 RCC-AID(TCGA 肾癌再标注)
└── 关键词含 "RCC" 但语境是化疗/药物
    └── 可能是别的 RCC 缩写,需核实
按 record 找:
├── 20719257 → v2.0.0(当前有效,优先)
└── 19630298 → v1.0.0(旧口径,慎用)
附录 S:与 PANDA-PLUS 的开放模式对照
RCC-AID 与库内 PANDA-PLUS 同为"本体再标注"型数据集,但开放策略相反:
| 维度 | RCC-AID | PANDA-PLUS |
|---|---|---|
| 本体来源 | TCGA 肾癌影像 | PANDA 前列腺 WSI |
| 标注产物 | 体素级分割掩码 | 像素级 Gleason 掩码 |
| 掩码获取 | CC BY 4.0 直链 | 请求制(邮件申请) |
| 衍生基准 | 无独立基准 | PANDA-PLUS-Bench(CC BY-4.0 HF) |
| 开放姿态 | 本体即开放 | 本体保守、衍生开放 |
| 可复现性 | 强(直链) | 中(掩码需申请) |
结论:RCC-AID 属于"完全开放"一档,PANDA-PLUS 属于"双轨开放"一档。两者共同说明:医学影像数据集的 AI-Ready 程度,关键分野在于标注(而非影像本体)是否无门槛可得。
附录 T:维护计划与触发点
| 触发点 | 动作 |
|---|---|
| RCC-AID 发布 v3.0.0 | 更新规模数字、版本链、md5 表 |
| MELBA 论文被引/被评 | 追记社区反馈与第三方评测 |
| TCGA/TCIA 条款变更 | 更新许可章节 |
| 出现官方基准榜单 | 补充 §7 评估章节 |
| 出现第三方复现结果 | 收录到生态影响节 |
维护优先级:最高是"版本升级"(直接影响规模数字与获取入口),其次是"第三方评测/复现"(补充生态证据)。
附录 U:常见错误用法清单(反面案例)
- 错:写"RCC-AID 有 142 例 101 患者"。对:v2.0.0 是 129 例 91 患者,142/101 是 v1 旧口径。
- 错:按 CT 张数随机划分训练/测试。对:按患者 ID 分组划分,防期相泄漏。
- 错:把标注当临床金标准部署。对:定位为研究用标注,临床需自行复核。
- 错:只署 RCC-AID 而不署 TCIA 源集合。对:署名义务是复合的。
- 错:从 v1 抓 images.zip 却按 v2 的目录名找
labels/。对:v1 是annotations/,先核版本。 - 错:把 radiomics 0.93/0.84/0.90/0.86 当论文主结果直接引用。对:该数字来自第三方解读页,MELBA 摘要未载,需核 PDF。
- 错:假设所有病例都是单期相。对:多期相存在(arterial/venous/delayed)。
- 错:用 CC BY 4.0 覆盖全部资产。对:标注 4.0,图像/元数据 3.0。
附录 V:核心来源 URL 登记
附录 W:RCC 亚型临床背景
| 亚型 | 英文 | 占比(一般人群) | 特征 | 对应 TCGA 队列 |
|---|---|---|---|---|
| 透明细胞 | clear cell RCC (ccRCC) | 约 75% | 最常见;VHL 通路相关;预后相对差 | TCGA-KIRC |
| 乳头状 | papillary RCC (pRCC) | 约 15% | 分 I/II 型;部分预后中等 | TCGA-KIRP |
| 嫌色细胞 | chromophobe RCC (chRCC) | 约 5% | 较少见;预后相对好 | TCGA-KICH |
| 其他 | 集合管癌、未分类等 | 约 5% | 罕见;侵袭性强 | 未纳入 |
RCC-AID 覆盖了三大常见亚型,但未纳入集合管癌等罕见亚型。使用者在做亚型分类研究时,须意识到数据只覆盖三类,不等于 RCC 全谱。
附录 X:影像组学工作流示意
基于 RCC-AID 的影像组学流程
─────────────────────────────────────────
1. 读入 CT(images/)+ 掩码(labels/)
2. 用掩码标签 2(肿瘤)裁剪出病灶 ROI
3. 特征提取(形态学/一阶/纹理/小波等)
   - 可跨期相对齐(arterial/venous/delayed)
4. 特征选择(去冗余、去共线性)
5. 建模:subtype 分类 / 良恶性鉴别
6. 评测:患者分组的交叉验证(防泄漏)
─────────────────────────────────────────
优势:病理确诊亚型标签 + 多期相 + 体素级 ROI
注意:样本量有限(尤其罕见亚型),需谨慎正则化
附录 Y:开放科学价值评估
| 价值维度 | 评价 |
|---|---|
| 门槛降低 | 高——无需自行标注,直链可得 |
| 可复现性 | 高——固定版本 + md5 + 代码库 |
| 可比性 | 高——统一标注让不同研究可对标 |
| 社区共建 | 中——邀请社区共享标注,尚在起步 |
| 长期保存 | 中——Zenodo + GitHub,无正式保存协议 |
| 人群公平性 | 低——性别/地域偏斜 |
综合而言,RCC-AID 在"降低门槛、可复现、可对标"三方面表现突出,是开放数据集的优秀范例;短板在人群代表性与长期保存承诺。
附录 Z:缩写速查
| 缩写 | 全称 | 中文 |
|---|---|---|
| RCC | Renal Cell Carcinoma | 肾细胞癌 |
| ccRCC | clear cell RCC | 透明细胞肾癌 |
| pRCC | papillary RCC | 乳头状肾癌 |
| chRCC | chromophobe RCC | 嫌色细胞肾癌 |
| CT | Computed Tomography | 计算机断层扫描 |
| ROI | Region of Interest | 感兴趣区域 |
| TCGA | The Cancer Genome Atlas | 癌症基因组图谱 |
| TCIA | The Cancer Imaging Archive | 癌症影像档案 |
| KIRC | Kidney Renal Clear Cell Carcinoma | 肾透明细胞癌(TCGA 队列) |
| KIRP | Kidney Renal Papillary Cell Carcinoma | 肾乳头状细胞癌(TCGA 队列) |
| KICH | Kidney Chromophobe | 肾嫌色细胞癌(TCGA 队列) |
| NIfTI | Neuroimaging Informatics Technology Initiative | 神经影像信息技术格式 |
| DICOM | Digital Imaging and Communications in Medicine | 医学数字成像标准 |
| DUA | Data Use Agreement | 数据使用协议 |
| MELBA | Machine Learning for Biomedical Imaging | 生物医学影像机器学习(期刊) |
| MICCAI | Medical Image Computing and Computer Assisted Intervention | 医学影像计算与计算机辅助干预会议 |
| DIAG | Diagnostic Image Analysis Group | 诊断图像分析组 |
附录 AA:基于 RCC-AID 的研究检查清单(12 项)
- 确认使用版本为 v2.0.0(record 20719257)并记录 md5。
- 规模数字引用 129/91,注明 v1 旧口径 142/101。
- 训练/测试划分按患者 ID 分组,检查无患者跨越两集合。
- 处理类别不均衡(clear cell 占比高,chromophobe 仅 18)。
- 若用期相字段,确认在 v2 上运行(v1 无此列)。
- 多类分割时固定标签映射(0/1/2/3),勿重排。
- 做良恶性鉴别时,明确囊肿(3)的处置策略。
- 署名时列全:RCC-AID + 三个 TCIA 源集合 + TCGA 免责声明。
- 报告许可时区分标注(CC BY 4.0)与图像/元数据(CC BY 3.0)。
- 讨论局限时纳入性别/地域偏斜与观察者间变异未测。
- 引用 radiomics 探索性数字前核对 MELBA PDF 原文。
- 若与 KiTS/KiTS23 对标,明确各自数据来源与适用场景差异。
附录 AB:metadata.csv 数据字典(推断)
| 列(示意) | 类型 | 含义 |
|---|---|---|
| case_id | str | 病例/扫描唯一标识 |
| patient_id | str | 患者标识(同患者多期相相同) |
| subtype | str | RCC 亚型(clear cell/papillary/chromophobe) |
| sex | str | 性别(M/F) |
| age | int | 年龄 |
| contrast_phase | str | 对比期相(arterial/venous/delayed,v2 新增) |
| tcia_series_uid | str | TCIA 系列标识符(回源用) |
注:列名与具体取值以实际下载的 metadata.csv 为准,此表为基于描述的结构推断。
附录 AC:检索路径示范
场景 1|找肾癌 CT 分割数据
  关键词:renal cell carcinoma CT segmentation open dataset
  组合:RCC-AID OR KiTS OR KiTS23

场景 2|找 TCGA 影像标注
  关键词:TCGA kidney annotation OR TCGA RCC segmentation
  命中:RCC-AID(沿 TCGA 血缘)

场景 3|找多期相肾肿瘤数据
  关键词:multiphase CT kidney tumor arterial venous delayed
  命中:KiTS23 / RCC-AID

场景 4|核对版本
  关键词:RCC-AID Zenodo version 2.0.0
  直查:zenodo.org/records/20719257

场景 5|排除同名干扰
  注意区分:RCC-AID(肾癌 CT)≠ chronic-kidney-disease-uci(UCI CKD 表格)
附录 AD:与"请求制"数据集的可用性对比
| 获取门槛 | 代表数据集 | 可复现性影响 |
|---|---|---|
| 完全直链(无门槛) | RCC-AID | 最强——任何人可即时获取并复现 |
| gated(需登录/同意) | 部分 HF 数据集 | 中——需账号与协议 |
| 请求制(邮件申请) | PANDA-PLUS 掩码 | 弱——依赖作者响应 |
| 受限(伦理审批) | 部分临床数据 | 最弱——需 IRB |
RCC-AID 处于最高可用性一档,这是它作为"AI-Ready"数据集的突出优势。
附录 AE:数据集生命周期的观察
RCC-AID 展示了一个理想的数据集生命周期:
影像公开(TCGA/TCIA,2016)
        │
        ▼
识别标注缺口(TCGA 影像缺公开病灶标注)
        │
        ▼
标注生产(自动初标 + 学生 + 专家)
        │
        ▼
开放发布(Zenodo,CC BY 4.0,2026-04 v1)
        │
        ▼
质量修正(发现静默转换失败 → v2,2026)
        │
        ▼
同行评审发表(MELBA MICCAI Open Data 特刊,2026-09)
        │
        ▼
社区复用与共建(邀请共享标注)
这个生命周期说明:开放数据不是"发一次就完",而是"发布—反馈—修正—再发布"的持续过程。版本双口径(v1 142 vs v2 129)正是这一过程的健康痕迹,而非缺陷。
附录 AF:常见问询与答复(补充 FAQ)
AF1:RCC-AID 和 TCIA 是什么关系?
TCIA(The Cancer Imaging Archive)是托管 TCGA 影像的公共平台。RCC-AID 的图像与元数据"源自(reproduced from)"TCIA 的源集合,因此遵循 TCIA 的 CC BY 3.0 许可;RCC-AID 自己的标注则用 CC BY 4.0。
AF2:为什么标注许可比图像许可"更宽松"?
图像受 TCIA 源集合的 CC BY 3.0 约束(RCC-AID 只是再分发),而标注是 RCC-AID 团队原创,可自主选择 CC BY 4.0。两者都是署名即可的开放许可,差异主要在版本(4.0 是更新的国际版)。
AF3:如何快速确认下载的是正确版本?
看 images.zip 大小:4.1 GB = v2.0.0(正确),6.6 GB = v1.0.0(旧版)。或校验 md5(见附录 F)。
AF4:数据里有没有分割好的肾脏?
有。标签 1 = 肾脏。RCC-AID 同时提供了肾脏、肿瘤、囊肿三类标注,不只是肿瘤。
AF5:囊肿标注有什么用?
区分良恶性。肾囊肿是良性,而 RCC 是恶性,临床上需要鉴别。标签 3(囊肿)让模型能学"什么不是肿瘤",对降低假阳性有价值。
AF6:能用来做病灶检测吗?
能。虽然标注是分割掩码,但可从掩码导出病灶的边界框,用于检测任务。
AF7:它适合做多模态研究吗?
非常适合。它是 TCGA 的下游,而 TCGA 有配套的基因组、转录组、临床数据,可与影像做多模态融合。
AF8:样本量够做深度学习吗?
129 例对从零训练深度网络偏少,但足够做迁移学习、微调、基准对标;若需大规模训练,可结合 KiTS 等其它肾肿瘤数据。作者也把它定位为"可复用资源"而非"大规模训练集"。
AF9:为什么 clear cell 这么多、chromophobe 这么少?
因为 TCGA 本身就按 RCC 流行病学分布采集:clear cell 最常见(约 75%),chromophobe 罕见(约 5%)。RCC-AID 如实反映了这一分布,未强行均衡。
AF10:有没有中文文档?
就抓取时点而言,RCC-AID 的官方文档(Zenodo/MELBA/GitHub)均为英文。本条目是其中文整理与解读。
附录 AG:数据质量的多层次核查建议
| 层次 | 核查内容 | 方法 |
|---|---|---|
| 完整性 | 图像与掩码成对、数量一致 | 比对 images/ 与 labels/ 文件名集合 |
| 一致性 | 掩码标签值仅含 0/1/2/3 | 逐掩码统计唯一值 |
| 对齐性 | 掩码与图像空间维度一致 | 比对 shape/affine |
| 元数据 | subtype/sex/age/phase 无缺失 | 检查 metadata.csv 空值率 |
| 患者分组 | 无患者跨集合 | 分集后做 patient_id 交集检查 |
| 版本 | md5 匹配 | 核对 Zenodo 清单 |
附录 AH:流水线中"学生劳动"的方法学讨论
RCC-AID(与 PANDA-PLUS 一样)大量依赖受训学生承担标注主力,专家只做终审/复核。这一模式的利弊值得明辨:
优点
- 成本与吞吐:学生时薪低、可并行,把昂贵的专家时间压缩到质控环节。
- 可规模化:只要有培训体系,就能持续产出标注。
- 教学价值:学生获得真实医学影像标注训练。
风险
- 标注质量参差:学生经验有限,系统偏差可能被带入(如对边界判断不一致)。
- 监督覆盖有限:专家只复核"不确定"病例,学生"以为确定"的错误可能漏网。
- 一致性未测:若不报告观察者间一致性,下游难以量化标注噪声。
缓解措施(RCC-AID 已部分采用)
- 明确标注定位为"研究用"而非临床金标准。
- 由 board-certified 医师复核不确定案例。
- 开源 + 邀请社区共建,形成纠错闭环。
附录 AI:与其它肾癌影像数据集的补充对照
| 数据集 | 模态 | 器官/病灶 | 亚型标注 | 开放程度 |
|---|---|---|---|---|
| RCC-AID | 增强 CT | 肾/肿瘤/囊肿 | 有(三亚型) | CC BY 直链 |
| KiTS | 增强 CT | 肾/肿瘤/囊肿 | 有限 | 公开 |
| KiTS23 | 多期相 CT | 肾/肿瘤 | 有 | 公开 |
| UCSF RMaC | 多期相 3D CT | 肾肿物 | 有(含良恶性) | 视发布方 |
(UCSF RMaC 为检索中一并出现的同类数据集,831 例多期相 3D CT 肾肿物,非 RCC-AID 内容,仅作景观背景。)
附录 AJ:本条目引用的核验方法说明
本条目遵循"三源互证"原则,对关键数字做交叉核验:
| 原则 | 落实 |
|---|---|
| 官方一手源优先 | Zenodo 记录(含 md5/版本日志)、MELBA 论文页 |
| 多源交叉 | 数据(Zenodo)+ 论文(MELBA)+ 检索摘要(WebSearch)三方比对 |
| 冲突存照 | 规模 142 vs 129 全程存照,标注采用口径与理由 |
| 存疑标注 | radiomics 四数字标注"第三方解读、待核 PDF" |
| 版本锚定 | 以 record id + md5 + 包大小三重锚固定版本 |
附录 AK:一句话记忆锚
RCC-AID = TCGA 肾癌影像的"免费标注包":129 例 CT、91 患者,肾脏/肿瘤/囊肿体素级标注,CC BY 4.0 在 Zenodo 直链开源,认准 v2.0.0(record 20719257)。
尾注
本条目基于以下一手来源整理,抓取时点 2026-10-09:
- MELBA 论文页:https://www.melba-journal.org/papers/2026:039.html(发表于 Machine Learning for Biomedical Imaging, 2026, MICCAI Open Data 特刊, pp.772-782, doi:10.59275/j.melba.2026-2dg2, 2026-09-21)。
- Zenodo 数据记录 v2.0.0:https://zenodo.org/records/20719257(129 CT / 91 患者,4.1 GB,含 Version log)。
- Zenodo 数据记录 v1.0.0:https://zenodo.org/records/19630298(142 CT / 101 患者,6.6 GB)。
- medRxiv 预印本:doi:10.64898/2026.04.22.26351451。
- 配套代码库:https://github.com/DIAGNijmegen/oncology-RCC-AID-codebase。
- 前作方法:arXiv:2505.07573(Robust Kidney Abnormality Segmentation)。
- 源集合:TCGA-KIRC / KIRP / KICH(TCIA 托管,各含 DOI)。
- 资助:EU HORIZON-HLTH-2022 COMFORT, grant 101079894。
版本声明:本条目以 v2.0.0 / MELBA 正式版口径为准(129 CT / 91 患者);v1.0.0 / medRxiv 旧口径(142 CT / 101 患者)全程存照于 §5、附录 Q。使用本条目数字时请注明所据版本。
许可声明:本条目为千方病案医数集(AI-Ready Wikipedia 项目)整理的中文数据集百科条目。所引数据集 RCC-AID 由 de Boer 等作者发布于 Zenodo(标注 CC BY 4.0,图像与元数据 CC BY 3.0)。转载或引用本条目请注明出处。
更新记录:2026-10-09 初版(agent-e-rccaid 撰写;基于 2026-10-09 抓取的一手来源)。
附录 AL:RCC-AID 与开源医学数据集的三重身份
RCC-AID 同时扮演三个角色,理解这三重身份有助于准确定位它:
身份一:TCGA 的"标注补丁"
TCGA 提供了海量癌症影像,但公开病灶标注稀缺。RCC-AID 是补上肾癌这一块的"标注补丁",让 TCGA 影像从"可下载"变成"可训练"。
身份二:肾癌 AI 的"起跑线"
对肾癌分割、亚型分类、影像组学的研究者,RCC-AID 提供了统一的起跑线——大家用同一套标注,结果可比。
身份三:标注方法论的"样板"
它的"自动初标 + 学生劳动 + 专家复核"流水线,是可迁移到其它影像标注任务的方法论样板。
三重身份叠加,使 RCC-AID 的价值不局限于"一个数据集",而是**“一套让数据集变得可用的做法”**。
附录 AM:数据规模与统计精度
| 指标 | 数值 | 对建模的影响 |
|---|---|---|
| 总病例 | 129 CT / 91 患者 | 偏小,宜迁移学习/微调 |
| clear cell | 85(65.9% of CT) | 主导类别 |
| papillary | 26(20.2%) | 中等 |
| chromophobe | 18(14.0%) | 少,需重采样/加权 |
| 多期相 | 有(26/50/53) | 可扩样本但带来泄漏风险 |
| 患者均扫描数 | 129/91 ≈ 1.42 | 部分患者 >1 扫描 |
注:比例按 CT 张数计算。若按患者数,拆分需先确定患者级亚型归属(多数患者应为单一亚型)。
附录 AN:评测协议建议(供自建基准)
由于 RCC-AID 未附基准榜单,若要用它做可比评测,建议协议如下:
评测协议建议
─────────────────────────────────────
数据划分:按患者分组,5 折交叉验证或固定 70/15/15
任务定义:
  T1 肾脏分割(标签 1)
  T2 肿瘤分割(标签 2)
  T3 囊肿分割(标签 3)
  T4 三分类亚型分类(病灶 ROI → clear/papillary/chromophobe)
指标:
  分割:Dice、IoU、HD95、ASSD
  分类:准确率、宏平均 F1、AUC(多类 one-vs-rest)
基线:nnU-Net(分割)、ResNet/ViT + 迁移学习(分类)
报告:必须区分患者级 vs 扫描级结果,注明版本与 md5
─────────────────────────────────────
附录 AO:常见下游研究设想
| 方向 | 研究问题 | 用到的数据 |
|---|---|---|
| 分割鲁棒性 | 模型跨亚型/跨期相的分割稳定性 | 标签 1/2/3 + 亚型 + 期相 |
| 亚型分类 | 病灶影像特征能否预测 RCC 亚型 | 标签 2 ROI + subtype |
| 良恶性鉴别 | 肿瘤 vs 囊肿的影像学区分 | 标签 2 vs 3 |
| 影像组学可复现 | 不同特征集/模型的稳定性 | 全量 + 亚型 |
| 多模态融合 | 影像 + 基因表达联合建模 | RCC-AID + TCGA 组学 |
| 标注质量研究 | 自动初标+学生+专家的误差传播 | 标注流程 + 原始初标(如有) |
附录 AP:与欧盟 COMFORT 项目的关系
RCC-AID 由欧盟 COMFORT 项目(HORIZON-HLTH-2022, grant 101079894)资助。COMFORT 全称 “COMputational Models FOR patienT stratification in urologic cancers — Creating robust and trustworthy multimodal AI for health care”,目标是泌尿系统肿瘤(含肾癌)的多模态 AI 分层。RCC-AID 是该项目的开放数据产出之一——它服务于"稳健且可信赖的多模态 AI"这一目标:没有公开、可复现的标注数据,就无从谈"可信赖"。
这条资助线索解释了数据集的设计取向:强调可复现性、多模态对接、可信赖性,而非单纯追求规模。
附录 AQ:对"AI-Ready"概念的启示
RCC-AID 是"AI-Ready"理念的一个正面样本。它同时满足:
| AI-Ready 要素 | RCC-AID 表现 |
|---|---|
| 可发现 | MELBA + Zenodo + GitHub 三处可索引 |
| 可获取 | 完全直链,无 gated |
| 可理解 | metadata + 论文 + 代码 |
| 可互操作 | 标准 NIfTI/CSV + TCIA manifest |
| 可复现 | 固定版本 + md5 + 代码库 + 引用规范 |
| 许可清晰 | 分层 CC BY,可商用 |
短板在"标注一致性未测"与"人群代表性"。这两条提醒我们:AI-Ready 不仅是"能拿到",还包括"拿到的东西有多可信、多公平"。
附录 AR:术语的中英对照使用建议
在中文语境写作或引用 RCC-AID 时,建议:
- 首次出现"肾细胞癌"时括注 “Renal Cell Carcinoma, RCC”。
- "透明细胞/乳头状/嫌色细胞"三亚型,首次出现括注英文。
- "体素级分割"与 “voxel-level segmentation” 并列。
- “增强 CT” 与 “contrast-enhanced CT” 并列。
- 数据集名 RCC-AID 保持英文,首次出现给全称。
- 期相 arterial/venous/delayed 保留英文(中文可注"动脉期/静脉期/延迟期")。
附录 AS:抓取时点的可用性快照
| 项目 | 状态(2026-10-09) |
|---|---|
| Zenodo v2.0.0 记录 | 可访问 |
| Zenodo v1.0.0 记录 | 可访问 |
| MELBA 论文页 | 可访问 |
| GitHub 代码库 | 可访问 |
| 下载门槛 | 无(直链) |
| 文档语言 | 英文 |
附录 AT:给决策者的三句话
- 要标注充分的肾癌 CT 数据、且不想申请:RCC-AID 是目前最省事的选择(CC BY 直链)。
- 要把它当临床金标准用:不行,它是研究用标注,临床部署需自行专家复核。
- 要规模化训练:把它当"高质量子集/评测集"结合其它数据用,别指望 129 例单独撑起大模型。
附录 AU:本条目与金标准结构的对应
本条目结构参照千方病案医数集 AI-Ready Wikipedia 金标准(panda-plus 条目),九节 FACTS 与成稿章节对应如下:
| FACTS 节 | 成稿对应 |
|---|---|
| §1 名称与身份 | INFOBOX、§0、§1 |
| §2 论文与时间线 | §5、附录 P |
| §3 机构与人物 | §3、附录 AP |
| §4 数据规模硬数字 | §2、附录 M/AM |
| §5 任务与标注 | §2.4、§3.1、附录 E/I/J |
| §6 license 与获取 | §6、附录 F/N/O |
| §7 评估与基准 | §7、附录 AN |
| §8 生态与互链点 | §9、附录 K/M/S |
| §9 存照与待核 | §5、§10、附录 Q |
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- panda-plus — 共享标签:医学图像分割 / 图像分类 / 肿瘤学 / 评测基准
- trials — 共享标签:CT / 医学图像分割 / 肿瘤学 / 评测基准
- cric — 共享标签:医学图像分割 / 图像分类 / 肿瘤学 / 评测基准
- amplifai — 共享标签:CT / 医学图像分割 / 图像分类 / 肿瘤学
- panorama-2026 — 共享标签:CT / 医学图像分割 / 肿瘤学 / 评测基准
- ct-lesion-foundation-model — 共享标签:CT / 医学图像分割 / 肿瘤学 / 评测基准
- prostate-cnb-wsi — 共享标签:医学图像分割 / 图像分类 / 肿瘤学 / 评测基准
- cobra — 共享标签:医学图像分割 / 图像分类 / 肿瘤学 / 评测基准
- cuvas-pdacvi — 共享标签:CT / 医学图像分割 / 肿瘤学 / 评测基准
- pddca — 共享标签:CT / 医学图像分割 / 肿瘤学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
