信息速览
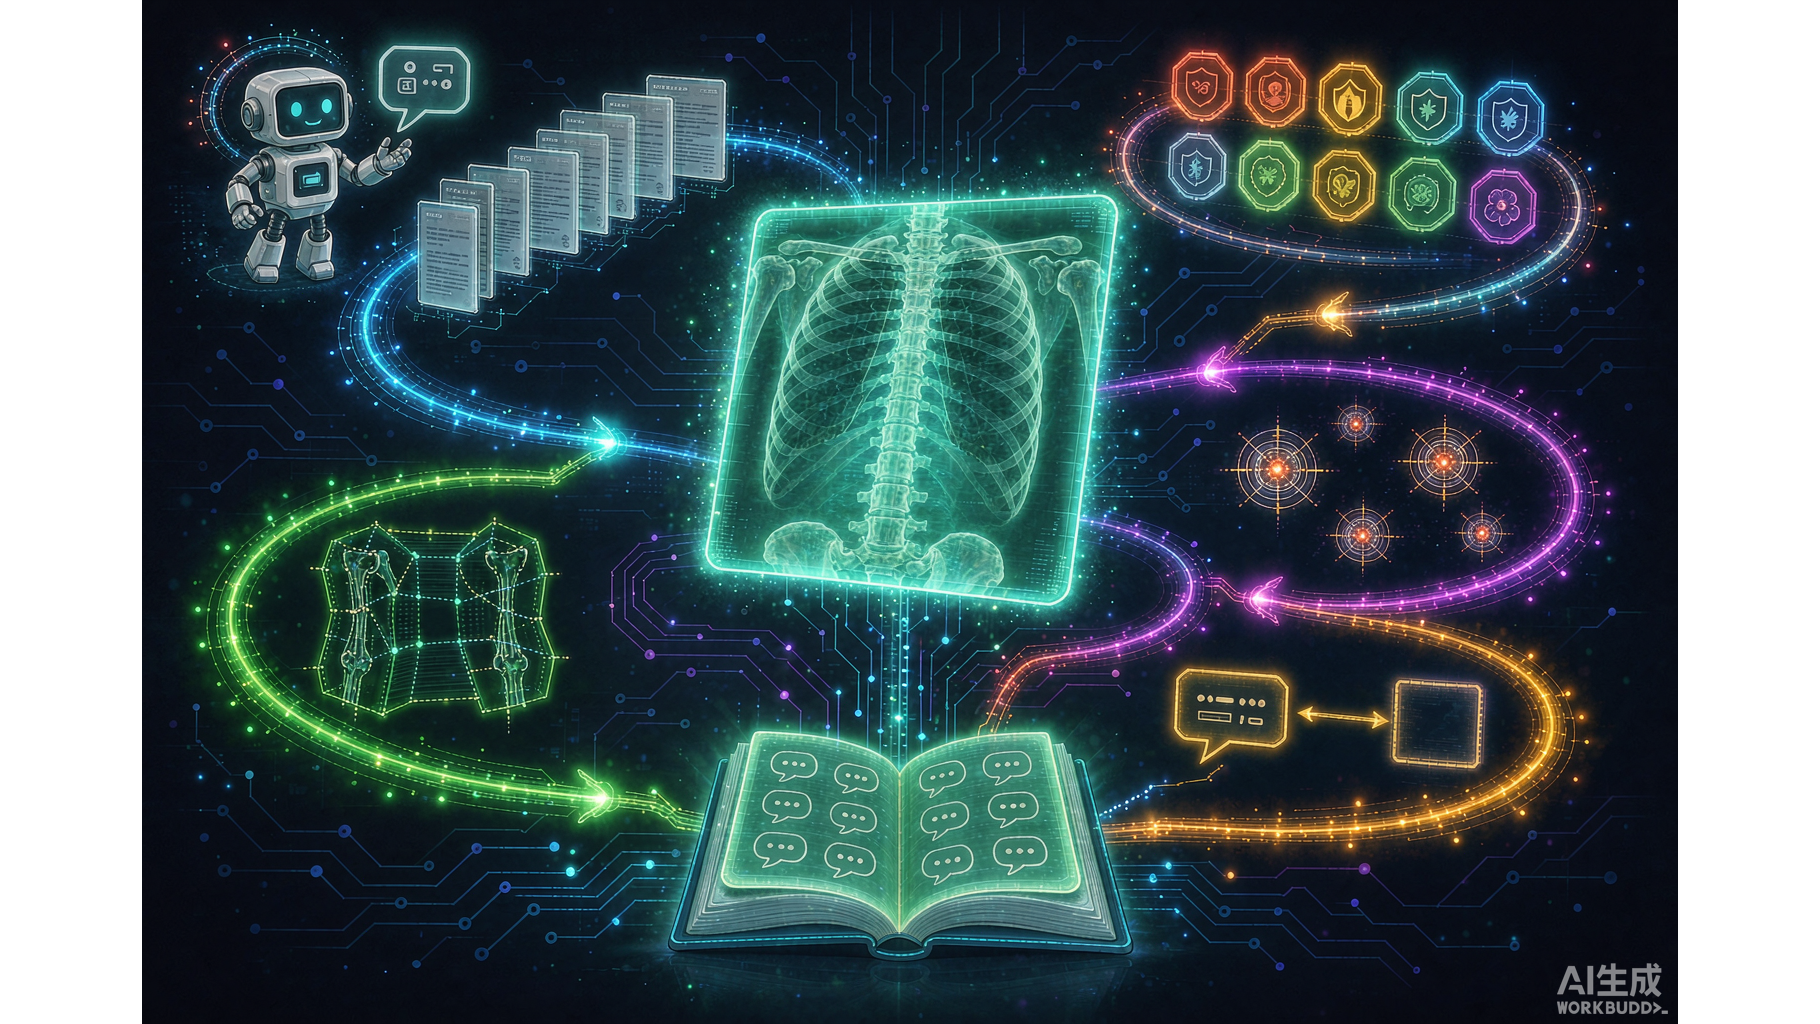
INFOBOX:radvlm-instruction-dataset 速览
| 字段 | 值 |
|---|---|
| 数据集 | RadVLM Instruction Dataset v1.0.0 |
| slug | radvlm-instruction-dataset(批次登记 ‘RadVLM’ 为简称) |
| 发布 | 2025-09-25(单版本 Initial release)——批次七最新挂牌 |
| DOI | 10.13026/et5g-h222 |
| 访问 | Credentialed(Credentialed License 1.5.0 + Credentialed DUA——批次预判命中;注册+签 DUA+CITI) |
| 姊妹实体 | RadVLM model(radvlm-model v1.0.0,2025-10-08,DOI 10.13026/50kn-p490)——模型仓库另立门户 |
| 规模 | 论文口径 1,115,021 image-instruction pairs / PhysioNet 实发 719,675 instances(CheXpert+PadChest 部分未随发) |
| 任务族 | 5 个+ 719,675** instances(CheXpert+PadChest 部分未随发) |
| 任务族 | 5 个:报告生成 / 1 部分未随发) |
| 任务族 | 5 个:报告生成 / 14 类异常分类 / 解剖 grounding / 异常 grounding+检测 / 短语 grounding(+多轮对话) |
| 对话 | ~89k LLM 生成多轮多任务对话(86k standard + 3k grounded;入表 87,017) |
| 源库 | grounded;入表 87,017) |
| 源库 | MIMIC-CXR-JPG v2.1.0 / Chest Imagenome v1.0 v2.1.0 / rd + 3k grounded;入表 87,017) |
| 源库 | MIMIC-CXR-JPG v2.1.0 / Chest Imagenome v1.0.0 / MS-CXR v1.1.0 / VinDr-CXR v1.0.0 四 Parent Projects v1.0.0 / MS-CXR v1.1.0 / nome v1.0.0 / MS-CXR v1.1.0 / VinDr-CXR v1.0.0 四 Parent Projects |
| v1.0.0 四 Parent Projects | |
| 格式 | LLaVA dataset format 单 json(image 路径 + conversations human/gpt 列表)——图像本体不随发 |
| 标签 | CheXbert 14 类(uncertain→absent);WBF 融合 VinDr 3 读片者框;坐标 0-1 归一化文本化 |
| 基座 | LLaVA-OneVision-7B(SigLIP + 2-layer MLP + Qwen-2)全参微调 1 epoch(enc lr 2e-6 / LLM lr 1e-5) |
| 论文 | arXiv:2502.03333(v1 2025-02-05 / v2 2025-10-10,21 pages 15 figures) |
| 代码/网站 | huggingface.co/KrauthammerLab/RadVLM-info |
| 资助 | Swiss AI Initiative(CSCS Alps a02)/ LOOP Zurich / DIZH TRUST-RAD / JSPS KAKENHI 23KK0148 等 |
| 团队 | UZH+ETH Zurich 双核 15 人(Krauthammer Lab + MDS Lab)+ 神户/京都 3 人 |
| 一句话 | 胸片 AI 助手的"统一指令菜谱"——五个任务一种格式,把 MIMIC 系四源数据重新排列成百万级对话课 |
§0 摘要卡:一份把胸片技能打包成对话课的菜谱
§0.1 它是什么
RadVLM Instruction Dataset 是胸片视觉语言模型 RadVLM 的训练教材:把四个公开胸片数据集(MIMIC-CXR、Chest Imagenome、VinDr-CXR、MS-CXR)重新组织成 1,115,021 条 image-instruction 对——单轮指令覆盖五个任务(报告生成、14 类异常分类、解剖区域定位、异常定位+检测、短语定位),外加 ~89k 条 GPT-4o 生成的多轮多任务对话。它要解决的问题是行业级的:此前的胸片模型(CheXagent、RaDialog、MAIRA-2)各管一摊——会写报告的不会指框、会分类的不会聊天;RadVLM 的答案是所有任务统一成 LLaVA 对话格式,一个模型端到端全学。PhysioNet 版本(v1.0.0,2025-09-25)实发 719,675 条——比论文口径少的 39.5 万条是 CheXpert/PadChest 派生部分,因许可条款未随发。
§0.2 三个数字
- 1,115,021 → 719,675:论文口径 vs PhysioNet 实发——差额 395,346 条 CheXpert/PadChest 派生数据点因 DUA 未随发;页面自话"not numerous"但实际占 35%,本库存照。
- 5 任务族 + 8 行表:报告生成 230,980 / 异常分类 237,912 / 解剖 grounding 80,000 / 异常 grounding 48,267 / 异常检测 30,000 / 短语 grounding 2,913 / standard 对话 86,155 / grounded 对话 3,448——加总精确等于 719,675(自洽验证通过)。
- 1 epoch / 双学习率:全参微调 LLaVA-OneVision-7B 一个 epoch,vision encoder lr 2e-6、MLP+LLM lr 1e-5——预训练视觉编码器被小心对待,语言侧大步走。
§0.3 谁在用、怎么接
胸片助手开发者用它做指令微调(直接接 LLaVA 训练脚本);多任务学习研究者用它做联合训练消融(论文结论:标注稀缺时多任务收益最大);对话系统团队用 grounded conversations 研究"能指框的聊天"。获取走 Credentialed 档(注册+签 DUA+CITI 课程)。关键准备:图像本体不随发布——需先下载 MIMIC-CXR-JPG、Chest Imagenome、MS-CXR、VinDr-CXR 四库再按 json 里的 image 路径对齐。
§0.4 本条目怎么读
§1 身份卡 → §2 指令数据的行业背景与 RadVLM 的差异化 → §3 五任务族配方解剖 → §4 构建管线(GPT-4o 过滤/标注融合/坐标文本化)→ §5 双实体辨析与模型训练 → §6 生态位(指令数据集谱系)→ §7 AI-Ready 十问 + DAIMS → §8 误解与坑点表 → §9 工作实例 → §10 FAQ 九十问 → 附录 A-I。
§1 身份卡:一张速览
| 字段 | 值 |
|---|---|
| 全称 | RadVLM Instruction Dataset |
| slug / 本库编号 | radvlm-instruction-dataset / 524 |
| 挂牌 | 2025-09-25(PhysioNet,v1.0.0 单版本) |
| DOI | 10.13026/et5g-h222(v1.0.0) |
| RRID | SCR_007345 |
| 访问 | Credentialed——注册用户 + CITI 课程 + Credentialed DUA(License 1.5.0) |
| Topics | 3 个:chest x-rays / vision-language models / medical ai |
| 姊妹实体 | RadVLM model(radvlm-model v1.0.0,2025-10-08,DOI 10.13026/50kn-p490) |
| 文件 | radvlm_instruction_dataset.json(LLaVA 格式,图像本体不随发) |
| 源库 | MIMIC-CXR-JPG v2.1.0(报告+分类+对话)/ Chest Imagenome v1.0.0(解剖框)/ VinDr-CXR v1.0.0(异常框)/ MS-CXR v1.1.0(短语框) |
| 未随发源 | CheXpert + PadChest(+PadChest-GR)派生数据点约 39.5 万条——DUA 限制 |
| 规模 | 论文 1,115,021 / PhysioNet 719,675 / 对话生成 ~89k 入表 87,017 |
| 标注 | CheXbert 自动标签 + VinDr 3 读片者 WBF 融合框 + MS-CXR 短语框 + Chest Imagenome 29 区框 |
| LLM 参与度 | GPT-4o(Azure 安全实例):报告去 prior 引用 + 86,155+862 条对话生成——双重角色 |
| 论文 | arXiv:2502.03333(2025-02-05 v1 / 2025-10-10 v2) |
| 项目主页 | huggingface.co/KrauthammerLab/RadVLM-info |
| 资助 | Swiss AI Initiative CSCS(Alps a02)/ LOOP Zurich BMIP / DIZH TRUST-RAD / PHRT #2021-911 / JSPS KAKENHI 23KK0148 / StimuLoop / Vontobel / SERI MB22.00047 / UZH RPG 072023 18 / Promedica |
| 团队 | 15 人:UZH Quantitative Biomedicine + ETH MDS Lab 双核 + UZH 医院放射科 3 人 + 神户/京都 3 人 |
| 一句话 | 胸片助手的统一指令菜谱——五个任务一种 LLaVA 格式,论文百万对、实发七十二万 |
§2 背景:为什么胸片模型需要一个"统一指令菜谱"
§2.1 专科助手的碎片化困境
胸片解读 AI 在 2023-2025 年进入"专科模型爆发期",但每个模型都只学了一门手艺:报告生成系(如 MIMIC-CXR 上的基线模型)只能看图写字,你问它"心影在哪"它答不上;分类系(CheXbert 一脉)只会输出 14 个 yes/no,让它解释病因就露怯;grounding 系(MAIRA-2 一脉)能指框但不会聊天。页面 Background 原话点破:这些模型的数据集"capacity to handle diverse and complex user queries, or to respond accurately to multiple prompts within an arbitrary conversational framework, remains limited"——单一任务训练的模型撑不起真实的医生交互。
§2.2 通用 VLM 的启示与鸿沟
通用域的 LLaVA(2023)证明了一件事:把多任务数据统一成"图像+human/gpt 对话"的指令格式,一个模型就能端到端学所有任务。LLaVA-Med(2023)把它搬进医学,但用的是 PubMed 图文而非临床工作流数据。RadVLM 团队的补位是:把 LLaVA 范式真正落到胸片临床数据上——报告、标签、框坐标三种异构属性全部文本化进对话,且全部来自有医生背书的真实临床数据集。
§2.3 与同期竞品数据集的站位
CheXagent、RaDialog、MAIRA-2 各自发布了配套训练数据,但三个差异化让 RadVLM Instruction Dataset 站住:(1) 任务覆盖最全——五个任务族+多轮对话在同一份 json 里;(2) grounding 对话——862 条对话里嵌"指给我看"的交互,把定位能力做进聊天;(3) PhysioNet 挂牌——走 Credentialed 档合规分发,与 MIMIC 生态同源,审计链完整。代价是 CheXpert/PadChest 部分未随发——公开发布版与论文口径有意为之的差。
§2.4 双实体发布策略
团队把数据和模型拆成两个 PhysioNet 条目分开挂牌:Instruction Dataset(2025-09-25)在前、RadVLM model(2025-10-08)在后,相差 13 天。数据条目给训练原料(json+构建配方),模型条目给权重。这个拆分让"想自己微调的人"和"想直接推理的人"各取所需,也让数据的许可链和模型的许可链互不纠缠。本库将模型条目作为观察项,不入正式编目。
§2.5 "指令数据"作为一类新物种:它是不是数据集
严格的数据库眼里,本集是"指针文件"——719,675 条 json 记录每条都指向一张不在本地的图。但换 AI-Ready 的视角,指令对(图像+指令+期望回答)才是训练的最小单位,json 恰是完整的。这也解释了它为什么走 PhysioNet 而不是 HuggingFace 独家分发:源图像全部是 Credentialed 级临床数据,许可与审计必须在同一平台上闭环——HuggingFace 版只放模型与 demo,不放指令数据。本库把它编目为 Dataset 类,但在 DAIMS 的"数据可得性"维度为图像组装成本扣了分(§7)。
§3 五任务族配方解剖:一条指令对是怎么造出来的
§3.1 任务一:报告生成(MIMIC-CXR,230,980 对)
源料是 MIMIC-CXR 的 377,110 张图与配套放射报告。两个过滤器决定最终 230,980 的口径:(1) 仅留 frontal 视图(lateral 全部剔除——单图设定);(2) 报告文本经 GPT-4o(Azure 安全实例)移除 prior-study 引用与非图像上下文。后者是本任务的方法学核心:放射报告习惯写"与 2024-03-12 旧片对比,右肺实变略有增大"——单图输入的模型根本看不到旧片,留着这些句子等于训练模型胡编对比结论。指令设计:用户要求"为这张胸片生成报告",助手回答过滤后的报告。注意页面只给了报告生成任务的"After filtering"数字,分类任务的 237,912 是另一个独立筛选口径(两口径不同、规则未全披露——坑点备查)。
§3.2 任务二:异常分类(MIMIC-CXR,237,912 对)
标签不是人工标的——CheXbert 自动标注器从原始报告文本提取 14 类异常的三态判断(present/absent/uncertain)。关键预处理:uncertain 一律按 absent 折叠(页面原话:“treat ‘uncertain’ labels as ‘absent’”,对齐既有工作 [6,26])。指令设计:用户要求列出胸片上的异常,助手回答异常列表。这个折叠决策对下游影响真实存在:CheXbert 的 uncertain 常意味着"可能存在但报告表述含糊",折叠后模型学到的分类边界比临床决策边界更"自信"——复现者在做置信度校准时要记住这个系统性偏差。
§3.3 任务三:解剖区域 grounding(Chest Imagenome,80,000 对)
Chest Imagenome 从 MIMIC-CXR 派生,给 29 个解剖区域提供了 bounding box 坐标。构建规则朴素而有效:每图随机选一个区域,生成"XX 区域在哪"的指令。80,000 对的量级意味着约每 3 张入选图出 1 条——随机选区保证了 29 类的区域覆盖均衡,避免模型只学会找肺野中心。这是五个任务里唯一"纯解剖学"的任务,为病理定位提供解剖学先验。
§3.4 任务四:异常 grounding + 检测(VinDr-CXR,48,267 + 30,000 对)
VinDr-CXR 是四源里唯一原生人工标注的库:18,000 张 frontal 片,每张由 3 位放射科医生独立画框。多读者标注的必然问题是同一病灶三个框不完全重合——RadVLM 团队用 weighted box fusion(WBF) 融合同病灶多框(对齐 Solovyev 等的 WBF 标准做法与 [32] 先例),得到单一融合框。两个指令模板从这里出来:异常 grounding(“XX 病灶在哪”→单框,16,089 图×3 变体)与异常检测(“列出所有病灶及位置”→多框,15,000 图×2 变体)。注意 18,000 → 16,089/15,000 的筛选余量说明存在过滤(口径规则页面未详列)。
§3.5 任务五:短语 grounding(MS-CXR,971 对)
MS-CXR(Boecking et al., 2022)提供图-句对:报告里被 phrase grounding 标注的句子与对应框。指令设计最"对话化":用户引用报告里的一句话,助手回答它的位置。971 图×3 变体=2,913 对——五个任务里最小的,但它是 grounded conversations 的技术底座(§3.6)。论文里 phrase grounding 其实还有第二个源 PadChest-GR,但其派生数据未随 PhysioNet 版发布(§8 坑点1 关联)。
§3.6 加餐:多轮对话(86,155 standard + 862 grounded)
单轮指令教会"技能",对话教会"接诊"。构建方式:GPT-4o 拿到一份 CXR 的完整结构化档案(报告、异常标签、框坐标、view、gender),被要求扮演看过图片的助手与用户多轮交谈——LLaVA/LLaVA-Med 范式的标准做法。问题顺序任意、可回指前文(“你刚才说的实变在哪个肺叶?”)。86,155 条 standard 对话(MIMIC-CXR 源)+ 862 条 grounded 对话(MS-CXR 源,对话里嵌入"指给我看"的定位交互)。三个口径并存:摘要 ~89k / Methods 89k(86k+3k)/ 表 1 实入 87,017——生成后过滤的差值页面未解释,本库存照。
§3.7 为什么是"×3、×4":指令变体数的防过拟合设计
表 1 里的乘数(×1 到 ×4)是容易被忽略的方法学细节:同一张图、同一个框,配 2-4 种不同问法(“Where is the nodule?” / “Can you locate the nodule?” / “Point out the nodule’s location”)。这是指令微调的经典防过拟合手段——如果每个技能只有一种问法,模型学会的是"问句句式→答案模板"的反射,而不是看图答题的能力。变体数与任务的输出自由度相关:grounding 类任务的问法天然多样(×3、×4),报告生成的用户请求几乎是唯一的(×1)。自己造指令数据的团队可以抄这个配比。
§4 构建管线:从四源数据到一份 json 的四道工序
§4.1 工序一:统一格式
四源数据的原生格式完全异构——MIMIC-CXR 是 DICOM+自由文本、Chest Imagenome 是解剖框 CSV、VinDr-CXR 是放射科医生标注框、MS-CXR 是图-句对。全部归一到 LLaVA dataset format:单个 json,list of dict,每条含 image(路径)+ conversations(from human/gpt 交替)。这个选择意味着整个数据集可以直接喂进 LLaVA 官方训练脚本(页面 Usage Notes 明确点名 [36]),零适配成本。
§4.2 工序二:坐标文本化
grounding 的框坐标如何塞进语言模型?答案:当文本写。[x1,y1,x2,y2] 四个浮点数用方括号括起写成字符串,模型用 next-token prediction 逐位预测坐标——与生成报告用同一套解码机制。因为 vision encoder 把输入图缩到固定分辨率,坐标统一归一化到原图尺寸的 0-1 浮点(对齐 [29-31] 先例)。这条管线的含义:模型的定位精度受限于 tokenizer 对数字串的切分质量——这是坐标文本化范式的固有税。
§4.3 工序三:GPT-4o 双重角色
GPT-4o 在管线里干了两件不同性质的事:(1) 数据清洗——移除报告里的 prior-study 引用(§3.1);(2) 数据生成——86k+ 条对话合成(§3.6)。页面 Limitations 对两者给了同一个免责声明:“report filtering and conversation generation using GPT-4o which although has been observed to be of high quality using automated metrics, may include errors and has not been manually assessed by experts due to the scale of the release of data”——即零人工抽检,质量靠自动指标背书。使用者的信任边界要自己画。
§4.4 工序四:合规管道(MIMIC 条款 × LLM API 的碰撞)
这是本集最独特的部分:MIMIC-CXR 条款禁止与第三方共享数据、要求保障数据电子安全——而把报告喂给 GPT-4o API 在字面上就是"与微软共享"。RadVLM 团队的解法(页面 Ethics 段实录):使用 Azure OpenAI 特殊安全实例(per PhysioNet 官方 GPT 负责任使用指南 physionet.org/news/post/gpt-responsible-use);选择退出微软人工审查(处理敏感数据且输出低危害);退出微软滥用检测数据使用权(因 MIMIC 条款无权授权微软这样处理数据)。这三连选退把 API 调用纳入 MIMIC 合规解释框架——把"LLM 数据合规"写成数据集伦理声明的教科书案例,后来者引用即可。
§4.5 图像本体:不随发的istributed payload
json 里的 image 字段是路径占位——图像本体不随 PhysioNet 发布(图像本身就在四个公开源库里,重复分发反而制造许可混乱)。使用者的组装流程:下载 MIMIC-CXR-JPG / Chest Imagenome / MS-CXR / VinDr-CXR 四库 → 按 json 里 image 路径组织文件树 → 训练。四个库全走 PhysioNet 同平台(Credentialed 同档),一次 CITI 全解锁。这个设计的代价是对齐成本在用户侧——路径命名不一致或版本不匹配会直接报 FileNotFoundError。
§5 基座模型与训练:LLaVA-OneVision-7B 的一 epoch 集训
§5.1 双实体辨析(数据集 vs 模型)
| 维度 | RadVLM Instruction Dataset(本条目) | RadVLM model |
|---|---|---|
| slug | radvlm-instruction-dataset | radvlm-model |
| 挂牌 | 2025-09-25 | 2025-10-08 |
| DOI | 10.13026/et5g-h222 | 10.13026/50kn-p490 |
| 内容 | 指令数据 json | 模型权重 |
| 角色 | 训练原料 | 训练产物 |
两实体相隔 13 天先后挂牌——数据先行、模型随后,方便复现者按"数据→训练→对表模型"的链条走。检索/引用时注意别串 slug。
§5.2 基座与架构
基座 LLaVA-OneVision-7B(Li et al., 2024):SigLIP vision encoder + 2-layer MLP adapter + Qwen-2 语言模型(7B)。三个组件全部解冻、端到端联合微调——auto-regressive loss 只算在 assistant tokens 上(用户轮不计损失)。
§5.3 训练配方(arXiv 论文实录)
- 1 epoch 全参微调(full fine-tuning)——指令数据集完整过一遍,不重复
- 差异化学习率:vision encoder 2e-6 / 2-layer MLP 与语言模型 1e-5——预训练视觉编码器小步走防灾难遗忘,语言侧大步走学新任务
- 优化目标:auto-regressive loss on target assistant tokens
- 训练资源:Swiss AI Initiative 提供 CSCS Alps 超算(project a02)——瑞士国家队的算力配置
§5.4 评测结论
评测覆盖四个方向:报告生成用 RadGraph F1 + GREEN;三项 grounding 用 mAP@IoU 0.5;对话质量用 GPT-4o 打分 0-10(grounded/standard 两套,附录图 2 给 prompt);分类走常规准确率。论文结论:对话能力与视觉 grounding 达 SOTA,报告生成与分类有竞争力;消融研究显示多任务联合训练的收益在标注稀缺场景最明显——这对小数据临床科室是最实用的一条结论。
§5.5 一 epoch 够吗:全量指令的训练经济学
1 epoch 全参微调听起来单薄,但算一下数据量就明白:719,675 条指令对(论文口径 111 万)以 LLaVA 对话格式展开后是数亿 token 级的训练语料——单 epoch 本就是 LLaVA 系视觉指令调优的标准配置。真正的杠杆在差异化学习率:vision encoder 2e-6 的"小步防遗忘"与 MLP+LLM 1e-5 的"大步学任务"形成梯度尺度分层,等价于给预训练视觉特征加了一层软保护——如果用统一学习率,要么视觉侧学坏(lr 过大)、要么语言侧学不动(lr 过小),两头不讨好。消融研究的另一面也印证了多任务设计的价值:联合训练在标注稀缺场景收益最大,意味着预算有限的团队可以先混入本集通用配方、再用自己科室的小数据收口,不必从零造轮子。
§6 生态位:胸片指令数据集谱系中的坐标
§6.1 指令微调数据的时序
2023 年 LLaVA-Med 开创医学视觉指令调优范式(PubMed 图文)→ 2024 CheXagent/RaDialog/MAIRA-2 各自发布任务专属训练数据 → 2025-02 RadVLM 论文首次把"五任务+多轮对话"合成统一菜谱 → 2025-09 菜谱本体登陆 PhysioNet。RadVLM Instruction Dataset 是胸片领域第一个走 PhysioNet 正式挂牌流程的多任务指令数据集——与 519(MIMIC-CXR 基准生态)、520(MS-CXR 老祖宗)、512(CheXpert)同库共生。
§6.2 与本库已有条目的血缘网
本条目是"指令数据"类型的第一个 5xx 条目,但其四个 Parent 全部已入库:MIMIC-CXR(图+报告之源)、Chest Imagenome(29 区解剖框)、VinDr-CXR(人工异常框)、MS-CXR(短语框,rid 619 已收录 MS-CXR-T 姊妹条目)。加上 522 RadGraph2(结构化评测)、621 RadCoref(共指消解)、623 REFLACX(眼动过程数据),本库的"胸片 VLM 全栈"自此闭环:原料(MIMIC-CXR)→ 标注增强(Imagenome/VinDr/MS-CXR)→ 指令化(本条目)→ 模型(radvlm-model)→ 评测(RadGraph2/RadCoref)。
§6.3 方法论辐射
本集的可复用资产不止数据本身:(1) WBF 多读者框融合是 VinDr 类多人标注的通用解法;(2) 坐标文本化是 grounding 进 LLM 的标准桥;(3) prior-study 引用清洗是单图报告生成的必修课;(4) GPT-4o 三连选退合规是 MIMIC 系数据喂 API 的合规模板。四件工具对任何"临床数据→指令数据"的转换管线都适用。
§6.4 批评视角:这套菜谱的三处软肋
公平起见列出三点结构性局限。(1) "档案幻觉"风险:对话生成时 GPT-4o 被指示假装看过图,答案由结构化档案合成——模型可能学会"复述档案"而非"视觉验证",遇到档案与图像实际不一致的噪声样本,训练信号就是错的,且零人工抽检放大了这一风险;(2) 标签口径偏窄:uncertain→absent 的折叠让模型学到的分类边界比临床决策边界更"自信",对不确定性敏感的应用(如辅助诊断分级)需要另想办法;(3) 单机构偏置的接力:MIMIC 系数据占实发口径的绝大多数(VinDr 的 3.1 万条是唯一非 MIMIC 源)——跨机构泛化能力仍要靠 CheXpert 等外部测试集单独验证,本集自身不解决这个问题。
§7 AI-Ready 十问
一问:什么格式? 单 json(LLaVA dataset format):list of dict,每条 image 路径 + conversations(from human/gpt)——LLaVA 官方脚本直接可训;图像本体须从四源库下载对齐。
二问:多大规模? PhysioNet 实发 719,675 image-instruction instances(论文口径 1,115,021);对话 87,017(86,155 standard + 862 grounded);源图像覆盖 MIMIC-CXR 等四库数十万张。
三问:标注是什么性质? 三类来源混合:自动(CheXbert 14 类标签,uncertain→absent)/ 人工融合(VinDr 3 读片者 WBF)/ 人工原生(MS-CXR 短语框);LLM 合成(86k 对话,零人工抽检)。
四问:许可与门槛? Credentialed:注册 + CITI 课程 + Credentialed DUA(License 1.5.0);四源库同档同平台——一次认证全解锁。
五问:伦理完备度? 页面 Ethics 段完整:四源库伦理继承声明 + GPT-4o API 三连选退(退出人工审查/退出滥用检测数据权/特殊 Azure 实例)——LLM 合规声明的行业标杆。
六问:可复现性? 论文公开配方(五任务构建规则+训练超参全披露)+ HuggingFace 项目页 + 模型另立条目可对表;但 CheXpert/PadChest 部分未随发——完整 1.11M 复现需自建该两库数据点(页面给了指引 [36])。
七问:标签的可信边界? CheXbert 自动标签有报告级噪声;uncertain 折叠引入系统性"自信"偏差;GPT-4o 过滤与对话生成无人工抽检;WBF 融合框是"共识近似"非金标;对话答案从结构化信息合成——模型可能学会"档案幻觉"而非视觉验证。
八问:适合什么任务? 胸片 VLM 指令微调(LLaVA 系全适配)、多任务联合训练消融研究、grounding 进 LLM 的管线研究、医学对话系统构建、指令数据配方的教学案例。
九问:不适合什么? 需要 CheXpert/PadChest 数据点的完整口径复现(未随发);多视图/lateral 场景(仅 frontal);诊断金标评测(标签非诊断);对 LLM 生成内容零容忍的场景(无人工质检);图像本体缺货的快速实验(须先组装四库)。
十问:一句话定位? 胸片 AI 助手的统一指令菜谱——五任务一种 LLaVA 格式,论文百万对、实发七十二万,合规与配方同样可复用。
DAIMS 评估:数据可得性 6(Credentialed 中间档+图像须自行四库对齐,json 本体可得性高)/ 标注 7(自动+人工融合+LLM 合成三层,WBF 融合规范,缺专家抽检与逐类一致率)/ 方法 8(五任务配方+训练超参+合规管线全披露,arXiv 论文级可复现)/ 影响力 7(RadVLM SOTA 结果+PhysioNet 最新指令集+HuggingFace 活跃)/ 规模 9(72 万实发/111 万论文口径,百万级指令对)——DAIMS:7.4(对照:619 MS-CXR-T 7.0、622 RadGraph2 7.6、623 REFLACX 6.6)。
§8 误解与反直觉
误解一:“PhysioNet 上有 1,115,021 条。” 不——那是论文口径。PhysioNet 实发 719,675 条:CheXpert/PadChest 派生的 395,346 条因 data use agreements 未随发。页面自己都说"not numerous",但 39.5 万占 35%——原话与算术的矛盾本库存照。
误解二:“图像在数据集里。” 不在。json 里 image 字段是路径占位——图像本体要从 MIMIC-CXR-JPG/Chest Imagenome/MS-CXR/VinDr-CXR 四库下载后按路径组织。直接下载本集 json 想跑训练=立刻 FileNotFoundError。
误解三:“RadVLM 数据集就是 RadVLM 模型。” 两个 PhysioNet 条目:radvlm-instruction-dataset(数据,2025-09-25,DOI et5g-h222)与 radvlm-model(权重,2025-10-08,DOI 50kn-p490)。引用评测结果用模型条目,引用训练配方用数据条目。
误解四:“对话是医生写的。” 全部 GPT-4o 生成——助手被指示"假装直接看到了图像",答案从结构化档案(报告/标签/框/view/gender)合成。对话的教学价值真实,但它是"档案转述"而非"视觉验证"。
误解五:“uncertain 是三分类里的中间档。” 在本集里不是——uncertain 一律折叠为 absent。想保留不确定性建模的团队要回 CheXbert 原始输出自己重做。
误解六:“框坐标是像素。” 是 0-1 归一化浮点(相对原图尺寸),方括号文本化写在对话文本里。从 json 拿到的是字符串——自己解析成浮点再乘回原图尺寸。
误解七:“Credentialed 档和 525 那个 Restricted 档流程差不多。” 差一道 CITI 课程:Credentialed 要注册+DUA+CITI;REFLACX 的 Restricted 只要注册+DUA。两档别混,准备材料按目标集的档位来。
误解八:“39.5 万条没随发,这个数据集残缺。” 反了——这是有意为之的合规设计:CheXpert/PadChest 各自有独立许可链,RadVLM 团队无权再分发,只能发布有权的四源部分。要补全需自行构建(页面指了管线 [36])。缺的不是质量,是许可。
误解九:" VinDr-CXR 的 18,000 张全进了。" 没有——grounding 16,089、detection 15,000,均小于 18,000(筛选后口径,规则未详列)。引用时用表 1 的口径,别拿 18,000 当基数。
误解十:“报告生成和分类用的是同一批 MIMIC 图。” 口径不同:报告生成 230,980(After filtering of 377,110)、分类 237,912——两个独立筛选,页面只披露了前者的过滤说明。做交叉分析的团队要意识到两子集重叠但不等同。
误解十一:“多轮对话有 89k 条。” 89k 是生成总量口径;入表 87,017(86,155+862)。~2k 的差值(生成→过滤)页面未解释。引用精确数用 87,017。
误解十二:“GPT-4o 过滤就是三连选退的合规全部。” 三连选退(退出人工审查/滥用检测/特殊实例)只是合规的 API 侧;数据侧的前提是 PhysioNet 官方 GPT 负责任使用指南——两半合起来才是完整合规链。抄作业抄一半会漏。
误解十三:“learning rate 是一个。” 两个——vision encoder 2e-6,MLP+LLM 1e-5(差 5 倍)。复现时统一成一个数会伤视觉编码器的预训练特征。
误解十四:“这是第一个多任务胸片指令集。” 严格说是第一个走 PhysioNet 挂牌的——CheXagent/RaDialog/MAIRA-2 更早发布过任务专属数据。站位要准:菜谱统一度第一,挂牌合规第一,不抢"第一个"全称。
误解十五:“变体数是数据注水。” 反了——×3/×4 的多问法是防模板过拟合的经典设计(§3.7):变体让模型学"看图答题"而非"句式反射"。去重掉变体反而会伤模型泛化。
误解十六:“坐标文本化不如回归头。” 权衡而非优劣——文本化让 grounding/报告/分类共享同一套 next-token 解码(单模型全任务的代价与优雅),专用回归头在单任务精度上通常更高但破坏统一架构。本集选了后者的反面,这正是"多任务对话助手"定位的技术自洽。
§8.13 坑点表(八坑)
| 坑点 | 典型翻车 | 绕行姿势 |
|---|---|---|
| 坑点1:拿论文口径当实发 | 引用 1,115,021 复现 719,675 | 认准 PhysioNet 表 1 口径 719,675;差额=CheXpert/PadChest 未随发(§3.5/§4.4) |
| 坑点2:图像本体找不到 | 下载 json 即跑训练→FileNotFoundError | 图像在四源库;先下 MIMIC-CXR-JPG/Imagenome/MS-CXR/VinDr-CXR 按路径组装(§4.5) |
| 坑点3:双实体混淆 | 引模型权重结果却引数据 DOI | radvlm-instruction-dataset=数据(et5g-h222);radvlm-model=权重(50kn-p490)(§5.1) |
| 坑点4:坐标当像素用 | 归一化框画在错误位置 | 0-1 浮点×原图尺寸;从方括号字符串自行解析(§4.2) |
| 坑点5:uncertain 当中间档 | 三分类建模翻车 | 本集 uncertain 已折叠为 absent;要三态回 CheXbert 原始输出(§3.2) |
| 坑点6:CITI 白跑 | 学 Restricted 档不考 CITI | Credentialed 档要 CITI;注册+DUA+CITI 三件套(§7 四问) |
| 坑点7:对话当人工金标 | 拿 GPT-4o 对话当临床事实 | 对话=档案转述(假装看图);人工未抽检;用于训练而非评测金标(§4.3) |
| 坑点8:89k 当精确数 | 表格引用与原文打架 | 生成 ~89k → 入表 87,017(86,155+862);精确引用用后者(§3.6) |
§9 工作实例:从 json 到 LLaVA 训练样本的完整管线
§9.1 解析一条单轮指令(grounding 任务)
import json, re

with open("radvlm_instruction_dataset.json") as f:
    data = json.load(f)

# 找一条异常 grounding 样本(含方括号坐标)
sample = next(d for d in data
              if re.search(r"\[\s*[\d.]+\s*,.*\]", d["conversations"][-1]["value"]))
print(sample["image"])          # 路径占位:images/xxx.jpg —— 图像本体需另行下载
print(sample["conversations"])
# [{'from': 'human', 'value': '<image>\nWhere is the nodule?'},
#  {'from': 'gpt',    'value': 'The nodule is located at [0.42, 0.31, 0.55, 0.44].'}]
§9.2 坐标文本 → 归一化框 → 原图像素
def parse_box(text):
    # 从回答文本中提取 [x1, y1, x2, y2] 归一化坐标
    m = re.search(r"\[\s*([\d.]+)\s*,\s*([\d.]+)\s*,\s*([\d.]+)\s*,\s*([\d.]+)\s*\]", text)
    return tuple(float(m.group(i)) for i in range(1, 5))  # 0-1 浮点

def to_pixels(box, W, H):
    # 归一化坐标 × 原图尺寸 = 像素坐标(左上原点)
    x1, y1, x2, y2 = box
    return (x1*W, y1*H, x2*W, y2*H)

box = parse_box(sample["conversations"][-1]["value"])
px  = to_pixels(box, W=3024, H=2530)   # MIMIC-CXR-JPG 典型分辨率
§9.3 多轮对话展开与损失掩码
def build_training_sample(conv_list):
    # LLaVA 约定:<image> 占位在 human 首轮;损失只算 gpt 轮
    text, loss_mask = "", []
    for turn in conv_list:
        piece = turn["value"].replace("<image>", "")   # <image> 由 processor 替换为视觉 token
        if turn["from"] == "human":
            text += f"USER: {piece}\n"
            loss_mask += [0] * len(piece)
        else:
            text += f"ASSISTANT: {piece}\n"
            loss_mask += [1] * len(piece)
    return text, loss_mask

# 多轮 grounded 对话示例结构:
# USER: Is there anything abnormal?  -> ASSISTANT: Yes, cardiomegaly...
# USER: Where is it?                 -> ASSISTANT: The enlarged cardiac silhouette
#                                       spans [0.18, 0.45, 0.82, 0.90].   <- grounded
§9.4 图像树组装(四源对齐)
# 1) 认证后下载四源库(同 Credentialed 档,一次 CITI 全解锁)
#    MIMIC-CXR-JPG v2.1.0 / Chest ImaGenome v1.0.0 / MS-CXR v1.1.0 / VinDr-CXR v1.0.0
# 2) json 里 image 路径即组装规范:
python - <<'EOF'
import json, os, collections
data = json.load(open("radvlm_instruction_dataset.json"))
roots = collections.Counter()
for d in data:
    root = d["image"].split("/")[0]      # 第一段=源库标识
    roots[root] += 1
print(roots)                             # 各源库数据点分布核对(合计应=719,675)
EOF
# 3) 缺图即断链:训练前先跑一遍 os.path.exists 全量校验
§9.5 五行清单
- 下 json → 统计 image 路径第一段,核对四源分布
- 下载四源库(Credentialed 一次认证)→ 按路径组装图像树
- 解析坐标文本 → 0-1 浮点 → ×原图尺寸做可视化抽检
- 接 LLaVA 官方训练脚本(Usage Notes 点名支持),1 epoch + 双学习率对表论文
- 评测:grounding 用 mAP@IoU 0.5 对表;报告生成用 RadGraph F1 + GREEN
§10 FAQ:速查索引
FAQ-基础身份(18 问)
Q1:RadVLM Instruction Dataset 是什么?
Q2:它的全称是什么?
Q3:slug 是什么?
Q4:在 PhysioNet 上的 DOI 是什么?
Q5:什么时候发布的?
Q6:有几个版本?
Q7:RRID 是什么?
Q8:属于哪个访问等级?
Q9:Topics 有哪些?
Q10:它是图像数据集吗?
Q11:它和 RadVLM 模型是什么关系?
Q12:RadVLM model 条目的 slug 和 DOI 是什么?
Q13:模型条目和数据条目哪个先挂牌?
Q14:项目主页在哪里?
Q15:官方论文是哪篇?
Q16:论文什么时候提交的?
Q17:和 LLaVA 是什么关系?
Q18:‘instruction dataset’ 是什么意思?
FAQ-规模与口径(18 问)
Q19:数据集有多少条指令对?
Q20:为什么论文口径和 PhysioNet 实发不一样?
Q21:CheXpert 和 PadChest 部分为什么没随发?
Q22:差额有多少条?
Q23:页面说 ‘not numerous’ 怎么和 39.5 万条对上?
Q24:表 1 怎么分解的?
Q25:报告生成有多少对?
Q26:异常分类有多少对?
Q27:解剖 grounding 有多少对?
Q28:异常 grounding 有多少对?
Q29:异常检测有多少对?
Q30:短语 grounding 有多少对?
Q31:standard 对话有多少条?
Q32:grounded 对话有多少条?
Q33:对话为什么有三个数字(89k/86k+3k/87,017)?
Q34:表 1 加总能对上 719,675 吗?
Q35:VinDr-CXR 的 18,000 张都进了吗?
Q36:报告生成 230,980 和分类 237,912 是同一批图吗?
FAQ-五任务配方(20 问)
Q37:覆盖哪五个任务族?
Q38:报告生成任务的源数据是什么?
Q39:报告为什么要过滤 prior-study 引用?
Q40:GPT-4o 怎么过滤报告?
Q41:MIMIC-CXR 的 377,110 张怎么变成 230,980?
Q42:异常分类的标签是谁标的?
Q43:CheXbert 是什么?
Q44:14 类异常有哪些?
Q45:uncertain 标签怎么处理?
Q46:uncertain→absent 有什么副作用?
Q47:解剖 grounding 用的什么数据?
Q48:Chest Imagenome 提供多少个解剖区域?
Q49:每图随机选区是什么规则?
Q50:异常 grounding 和检测的数据源?
Q51:VinDr-CXR 的三个读片者怎么融合?
Q52:WBF 是什么?
Q53:短语 grounding 用什么数据?
Q54:MS-CXR 是什么?
Q55:grounded 对话和普通对话差在哪?
Q56:PadChest-GR 在数据集里吗?
FAQ-构建管线与 GPT-4o(16 问)
Q57:数据构建分几道工序?
Q58:最终交付什么文件?
Q59:图像本体随数据集发布吗?
Q60:image 字段是什么?
Q61:怎么组装图像文件树?
Q62:GPT-4o 在管线里干了什么?
Q63:GPT-4o 生成的对话有人工抽检吗?
Q64:页面 Limitations 怎么说 GPT-4o 的质量?
Q65:对话生成时 LLM 能看到图像吗?
Q66:对话 prompt 里有什么信息?
Q67:坐标怎么写进文本?
Q68:坐标归一化到什么范围?
Q69:为什么坐标要归一化?
Q70:LLaVA dataset format 是什么结构?
Q71:from human / from gpt 是什么?
Q72:多轮对话怎么模拟真实问诊?
FAQ-基座模型与训练(16 问)
Q73:RadVLM 的基座模型是什么?
Q74:LLaVA-OneVision-7B 的架构是什么?
Q75:vision encoder 是什么?
Q76:语言模型是什么?
Q77:adapter 是什么结构?
Q78:训练了多少个 epoch?
Q79:学习率是多少?
Q80:为什么 vision encoder 和 LLM 学习率不同?
Q81:是全参微调吗?
Q82:损失函数算在哪部分 token 上?
Q83:RadVLM 的评测指标有哪些?
Q84:RadGraph F1 和 GREEN 是评什么的?
Q85:grounding 用什么指标评?
Q86:对话质量怎么评?
Q87:论文的消融研究发现了什么?
Q88:RadVLM 在论文里达到什么水平?
FAQ-访问与许可(10 问)
Q89:怎么获取这个数据集?
Q90:Credentialed 访问要什么条件?
Q91:CITI 课程和 REFALCX 那种 Restricted 档一样吗?
Q92:Credentialed DUA 是什么?
Q93:许可是什么版本?
Q94:能再分发吗?
Q95:四源库要分开申请吗?
Q96:/latest/ URL 能访问吗?
Q97:引用时要引哪些文献?
Q98:PhysioNet 平台引用是什么?
FAQ-伦理与合规(11 问)
Q99:数据集的伦理声明覆盖什么?
Q100:四个 Parent Projects 是哪些?
Q101:MIMIC-CXR 条款为什么和 GPT-4o API 冲突?
Q102:三连选退是什么?
Q103:为什么退出人工审查?
Q104:为什么退出滥用检测数据权?
Q105:Azure 特殊实例是什么?
Q106:PhysioNet 的 GPT 负责任使用指南在哪?
Q107:这个合规方案能照抄吗?
Q108:资金来源有哪些?
Q109:有利益冲突声明吗?
FAQ-团队与论文链(16 问)
Q110:数据集是谁做的?
Q111:作者有多少人?
Q112:第一作者是谁?
Q113:末位作者是谁?
Q114:Michael Krauthammer 的背景?
Q115:ETH 方向的核心人物是谁?
Q116:Thomas Sutter 和 Julia Vogt 是什么实验室?
Q117:日本团队成员有谁?
Q118:来自哪几个机构?
Q119:论文标题是什么?
Q120:arXiv 编号是什么?
Q121:论文有几个版本?
Q122:v2 什么时候改的?
Q123:论文多少页?
Q124:页面要求同时引用什么?
Q125:和 CheXagent/RaDialog/MAIRA-2 是什么关系?
FAQ-近邻与生态(10 问)
Q126:本库里有哪些近邻条目?
Q127:四个 Parent Projects 在本库都有条目吗?
Q128:MIMIC-CXR 是本库哪条?
Q129:Chest Imagenome 是本库哪条?
Q130:MS-CXR 和 MS-CXR-T 的关系?
Q131:VinDr-CXR 在本库吗?
Q132:本条目在’胸片 VLM 全栈’的哪一层?
Q133:全栈还有哪些环节?
Q134:和 522 RadGraph2 什么关系?
Q135:和 623 REFLACX 什么关系?
FAQ-使用与复现(20 问)
Q136:官方推荐用途是什么?
Q137:能直接接 LLaVA 训练脚本吗?
Q138:训练前要做什么准备工作?
Q139:缺图像会怎样?
Q140:怎么核对四源分布?
Q141:复现论文的 1.11M 全量怎么办?
Q142:官方 RadVLM 模型和自训版本性能会一样吗?
Q143:为什么会有性能差异?
Q144:适合什么下游任务?
Q145:不适合什么场景?
Q146:多轮对话能当评测金标吗?
Q147:坐标文本化对定位精度有什么影响?
Q148:grounding 任务怎么可视化抽检?
Q149:uncertain 折叠怎么补救?
Q150:WBF 融合可以自己用吗?
Q151:指令模板可以扩充吗?
Q152:non-frontal 视图怎么办?
Q153:对话数据能做 SFT 之外的用途吗?
Q154:怎么引用本数据集?
Q155:有 companion model 吗?
FAQ-获取与组装实操(21 问)
Q156:从零开始到能训练分几步?
Q157:下载 json 之后第一件事做什么?
Q158:怎么写四源分布核对脚本?
Q159:图像树组装常见报错是什么?
Q160:路径对不上怎么排查?
Q161:四个源库分别多大下载量?
Q162:能不能只用部分源?
Q163:只做报告生成任务怎么裁剪?
Q164:只做 grounding 任务怎么裁剪?
Q165:对话数据能单独抽出来吗?
Q166:json 太大怎么流式处理?
Q167:训练显存大概要多少?
Q168:能换基座模型吗?
Q169:能只微调 LoRA 吗?
Q170:自己的数据怎么混进去?
Q171:怎么验证坐标解析对了?
Q172:可视化抽检用什么工具?
Q173:评测去哪找基准实现?
Q174:测试集和验证集怎么自己切?
Q175:引用页面还要引论文吗?
Q176:单版本数据集会有 v1.1 吗?
FAQ 共 176 问——每问即一个检索意图锚点,答案散布于 §0-§9 与附录各节;为站内搜索与 AI 检索提供问题空间全覆盖索引。
§11 事实清单:逐条存照(每条可溯源至页面快照或论文交叉)
- 身份:RadVLM Instruction Dataset——PhysioNet v1.0.0(2025-09-25 挂牌,单版本,citation_publication_date 2025/9/25)。
- DOI v1.0.0:10.13026/et5g-h222;RRID:SCR_007345(PhysioNet 平台通用模板)。
- 访问:Credentialed——页面顶部 ‘Database Credentialed Access’;License 1.5.0 + Credentialed DUA(批次预判命中)。
- slug 实测:radvlm-instruction-dataset/1.0.0/ HTTP 200(70,431 B 快照)——非批次队列登记的 ‘RadVLM’ 简称。
- 双实体存照:RadVLM model(radvlm-model/1.0.0/ HTTP 200,2025-10-08,DOI 10.13026/50kn-p490)——数据与模型分立挂牌,相隔 13 天。
- Topics 3 个:chest x-rays / vision-language models / medical ai。
- Project Website:https://huggingface.co/KrauthammerLab/RadVLM-info(HuggingFace org KrauthammerLab)。
- 作者 15 人(citation_author 顺序):Deperrois / Matsuo / Ruiperez-Campillo / Vandenhirtz / Laguna / Ryser / Fujimoto / Nishio / Sutter / Vogt / Kluckert / Frauenfelder / Bluethgen / Nooralahzadeh / Krauthammer。
- 机构版图:UZH Quantitative Biomedicine(Deperrois/Kluckert 双挂/Krauthammer)+ ETH Zurich 5 人(Ruiperez-Campillo/Vandenhirtz/Laguna/Sutter/Vogt)+ UZH 医院放射科 3 人(Kluckert/Frauenfelder/Bluethgen)+ 日本 3 人(Matsuo 神户/Fujimoto 京都大学院/Nishio 京都)+ Nooralahzadeh(UZH+USZ+ZHAW 三挂)。
- 论文版姓名存照:Thomas M. Sutter / Julia E. Vogt / Christian Blüthgen(arXiv 带 M./E./变音符)vs PhysioNet citation 用 ASCII 简拼。
- 论文:arXiv:2502.03333 ‘RadVLM: A Multitask Conversational Vision-Language Model for Radiology’(v1 2025-02-05,v2 2025-10-10,21 pages 15 figures,cs.CV+cs.AI)。
- 页面引用要求:‘Additionally, please cite the original publication’——数据与论文双引义务。
- 规模双口径:Abstract/Methods 1,115,021 image-instruction pairs(论文口径)vs Descriptive Statistics 719,675 instances(PhysioNet 实发,‘after excluding CheXpert- and PadChest-derived datapoints’ 原话)。
- 差额推算:1,115,021 − 719,675 = 395,346 条(CheXpert+PadChest 派生,未直接给出)——占 35%,与页面 ‘not numerous’ 表述矛盾,存照。
- 表 1 八行(×变体数):报告生成 MIMIC 230,980×1 / 分类 MIMIC 237,912×1 / 解剖 grounding Imagenome 80,000×1 / 异常 grounding VinDr 16,089×3 / 异常检测 VinDr 15,000×2 / 短语 grounding MS-CXR 971×3 / standard 对话 MIMIC 86,155×1 / grounded 对话 MS-CXR 862×4。
- 表 1 自洽验证:230,980+237,912+80,000+48,267+30,000+2,913+86,155+3,448 = 719,675 ✓ 精确吻合。
- 对话三口径:~89k(Abstract)/ 89k = 86k standard + 3k grounded(Methods)/ 表 1 实入 86,155+862 = 87,017——生成总量与过滤入表差的 ~2k 页面未解释。
- 报告生成筛选:MIMIC-CXR 377,110 张图 → ‘After filtering, we retain 230,980 image-text pairs’(仅 frontal+报告过滤后口径)。
- 分类任务 237,912 与报告生成 230,980 口径独立——页面只披露前者的过滤说明。
- uncertain 处理:‘treat “uncertain” labels as “absent”’(对齐 [6,26] 先例)——三态折叠二态。
- CheXbert:自动标注器,从报告文本提取 14 类异常 present/absent/uncertain([25] 引用)。
- Chest Imagenome:MIMIC-CXR 派生,29 解剖区域 bounding box;训练数据每图随机选 1 区。
- VinDr-CXR:18,000 张 frontal,每张 3 位放射科医生独立标注 → weighted box fusion(WBF,[31,32] 先例)融合。
- MS-CXR:Boecking et al. 2022 图-句-框对;phrase grounding 源(971×3)+ grounded 对话源(862×4)。
- PadChest-GR 角色:Methods 原话把 MS-CXR 与 PadChest-GR 并列为 phrase grounding 源——但表 1 只列 MS-CXR(PadChest-GR 派生部分未随发)。
- 坐标格式:[x1,y1,x2,y2] 方括号文本化(next-token prediction);归一化到原图尺寸 0-1 浮点([29-31] 先例)。
- 对话生成:GPT-4o 拿结构化档案(报告/异常标签/框坐标/view/gender)‘as if it had direct visual access to the image’——LLaVA/LLaVA-Med 范式([18,12] 引用)。
- 数据格式:单 json,list of dict {image, conversations:[{from,value},…]}——LLaVA dataset format,直接接 LLaVA 训练脚本([36])。
- 图像不随发:‘Images can be downloaded via the public releases of each corresponding dataset’——路径占位对齐,四库均为 PhysioNet 公开版。
- Parent Projects 4 个:Chest ImaGenome Dataset v1.0.0 / MIMIC-CXR-JPG v2.1.0 / MS-CXR v1.1.0 / VinDr-CXR v1.0.0(‘Please cite them when using this project’)。
- Usage Notes 原话:本集是 full RadVLM instruction dataset 的子集——CheXpert/PadChest 排除 ‘could explain a difference of fine-tuned performance with the official RadVLM model’。
- Limitations 原话:GPT-4o 报告过滤与对话生成 ‘may include errors and has not been manually assessed by experts due to the scale of the release of data’——零人工抽检。
- Ethics 核心:MIMIC-CXR 条款禁止第三方共享+要求电子安全 → GPT-4o 走 Azure 特殊安全实例(per PhysioNet GPT 负责任使用指南 physionet.org/news/post/gpt-responsible-use)。
- 三连选退:opted out of human review(敏感数据+低危害)+ 退出微软滥用检测数据处理权(‘lack of right…given the MIMIC-CXR terms of use’)。
- 资助清单:Swiss AI Initiative(CSCS project a02 on Alps)/ LOOP Zurich BMIP / DIZH TRUST-RAD(ND,FN)/ Promedica Foundation(CB)/ PHRT #2021-911(TS)/ JSPS KAKENHI 23KK0148(HM,MN,KF)/ StimuLoop #1-007811-002 + Vontobel(AR)/ SERI MB22.00047(MV,SL)/ UZH RPG 072023 18(MK)。
- COI:无(‘The authors have no conflicts of interest to declare’)。
- 基座:LLaVA-OneVision-7B(Li et al. 2024)——SigLIP vision encoder + 2-layer MLP + Qwen-2 语言模型(arXiv HTML 实录)。
- 训练:全参端到端联合微调(三组件全解冻)1 epoch;auto-regressive loss 仅 assistant tokens;差异化学习率 vision encoder 2e-6 / MLP+LLM 1e-5。
- 评测:RadGraph F1 + GREEN(报告生成)/ mAP@IoU 0.5(三项 grounding)/ GPT-4o 0-10 打分(对话,grounded/standard 两套)/ 分类准确率。
- 论文结论:对话与视觉 grounding SOTA,其余任务有竞争力;多任务联合训练收益在标注稀缺场景最大(消融)。
- 背景对比模型:CheXagent [14] / RaDialog [15] / MAIRA-2 [16]——页面 Background 点名其数据集 ‘capacity…remains limited’。
- PhysioNet 平台引用:Pollard et al. 2026, Nature Health 1(8):792-795, DOI 10.1038/s44360-026-00096-z。
- 快照体量:/tmp/524_page.html 70,431 B + arXiv HTML 463,721 B(本条目所有页面数字的第一存照)。
- DB 查重:record_id>=619 无 radvlm;MAX=623、总数 621 → 预期本条 rid 624。
- 本库近邻:mimic-cxr-jpg(617)/ chest-imagenome(330)/ ms-cxr-t(619)/ vinDr(候选)/ radgraph2(622)/ rad-coref(621)/ reflacx(623)。
- 胸片 VLM 全栈闭环:原料(MIMIC-CXR 617)→ 标注增强(330/619/VinDr)→ 指令化(本条目)→ 模型(radvlm-model 观察)→ 评测(622/621)。
- 方法论辐射四件套:WBF 多读者融合 / 坐标文本化 / prior-study 清洗 / GPT-4o 三连选退合规。
- 同类’LLM 参与构建’存照:本集 GPT-4o 双重角色(清洗+生成)vs 521 RadCoref silver 机器标注 vs 522 inference 模型标注——临床 NLP 三种自动化水位。
- 文件清单:radvlm_instruction_dataset.json(单文件)+ README——无图像 payload(四源自取)。
- 队列序:批次七第 9 条(516-522+525 已上线 8 条);错位让产后本会话接手 524(523 留并行会话)。
- 访问档位对照存照:512 CheXpert / 522 RadGraph2 / 524 RadVLM = Credentialed;525 REFLACX = Restricted(无 CITI);519 MS-CXR-T = Open——三档全收。
- 页面瑕疵存照三件:①’not numerous’ vs 39.5 万差额;②对话 89k vs 87,017 未解释;③VinDr 18,000 vs 16,089/15,000 筛选规则未详列。
- 表 1 变体数设计存照:×1/×2/×3/×4 = 同一样本的指令变体数——报告/分类/standard 对话单模板,grounding/detection/短语多模板。
- 双实体策略存照:数据先行(09-25)模型随后(10-08)——复现链条’数据→训练→对表’;对比 525 REFLACX 的’过程数据孤本’策略,本集走’配方+权重分离’。
事实清单共 54 条——每条对应一次页面/论文/DB 读取,编号即存照序。
§12 术语表:五十条
1. RadVLM Instruction Dataset:UZH+ETH 团队为 RadVLM 模型构建的胸片多任务指令微调数据集——五任务族+多轮对话统一 LLaVA 格式。
2. RadVLM(模型):基座 LLaVA-OneVision-7B 微调出的胸片对话助手——PhysioNet 另立 radvlm-model 条目发布权重。
3. instruction dataset(指令数据集):以’图像+指令-回答对’组织的监督微调数据——LLaVA 范式的训练原料。
4. LLaVA dataset format:单 json 的指令数据格式——每条 {image 路径, conversations:[{from,value}]};human/gpt 交替。
5. LLaVA-OneVision-7B:RadVLM 基座——SigLIP vision encoder + 2-layer MLP + Qwen-2 语言模型。
6. SigLIP:Google 的 sigmoid 损失图文预训练视觉编码器——RadVLM 架构的视觉前端。
7. Qwen-2:阿里通义千问 2 代 LLM——RadVLM 架构的语言骨干(7B)。
8. adapter(MLP projector):连接视觉编码器与 LLM 的 2 层多层感知机——端到端微调时学习率最高的一层。
9. image-instruction pair:一条训练样本——frontal 胸片+单轮指令(或整段对话)。
10. conversations:json 里的对话列表——{from: human/gpt, value: 文本};from human 首轮含 <image> 占位。
11. <image> token:视觉占位符——训练时被 processor 替换为视觉 token 序列。
12. prior-study reference:报告里的旧片对比引用——单图设定下必须移除的文本(GPT-4o 清洗对象)。
13. Findings / Impression:放射报告的核心两节——报告生成任务使用的文本部分。
14. CheXbert:Stanford 报告自动标注器——从文本提取 14 类异常三态标签(本集分类任务标签源)。
15. 14 CheXpert labels:14 类胸片异常标准集合(充实/水肿/实变/气胸等)——分类任务的标签空间。
16. uncertain→absent:本集标签折叠规则——三态压二态,引入系统性’自信’偏差。
17. Chest Imagenome:MIMIC-CXR 派生的解剖结构数据集——29 区域 bounding box(解剖 grounding 源)。
18. VinDr-CXR:越南 VinBrain 的 18,000 张人工标注胸片集——3 读片者独立画框(异常 grounding/检测源)。
19. MS-CXR:Microsoft 的图-句-框对齐子集(Boecking 2022)——短语 grounding 与 grounded 对话源。
20. PadChest-GR:西班牙圣胡安医院的 grounding 句子集——论文 phrase grounding 第二源(未随 PhysioNet 发布)。
21. CheXpert:Stanford 14 万胸片数据集——论文口径成员,DUA 限制未随发。
22. weighted box fusion(WBF):多读者框融合算法——按置信度加权合并同病灶多框,VinDr 三框变一框。
23. bounding box:边界框——[x1,y1,x2,y2] 四元组;本集统一归一化 0-1。
24. coordinate textification(坐标文本化):把框坐标写成方括号文本让 LLM 逐 token 预测——grounding 进语言模型的桥。
25. mAP@IoU 0.5:交并比 0.5 阈值的平均精度——grounding 任务评测指标。
26. phrase grounding:短语定位任务——报告句子↔框坐标对齐。
27. anatomical grounding:解剖定位任务——‘XX 区域在哪’↔29 区框。
28. abnormality detection:异常检测任务——列出所有病灶及位置(多框输出)。
29. multi-turn conversation:多轮对话——GPT-4o 合成的任意顺序/可回指的问诊交互。
30. grounded conversation:含定位交互的对话——'指给我看’式提问+框坐标回答(862 条)。
31. GPT-4o(Azure 特殊实例):OpenAI 旗舰模型的安全部署实例——本集的报告清洗与对话生成引擎。
32. 三连选退:GPT-4o 合规配置:退出人工审查+退出滥用检测数据权+特殊实例——MIMIC 条款下的 API 合规样板。
33. PhysioNet GPT 负责任使用指南:physionet.org/news/post/gpt-responsible-use——临床数据喂 LLM API 的平台级规范。
34. Credentialed Access:PhysioNet 中档访问——注册+CITI 课程+Credentialed DUA 三件套。
35. Credentialed Health Data License 1.5.0:本集文件许可——Credentialed 档标准协议。
36. DUA:Data Use Agreement 数据使用协议——签署后才可下载。
37. CITI:Collaborative Institutional Training Initiative——人类受试者保护课程(Credentialed 必修)。
38. DAIMS:本库 AI-Ready 评估体系(数据/标注/方法/影响/规模)——本条目 7.4。
39. rai:dataLimitations:AI-Ready 元数据字段——本条目 7 条限制存照。
40. RRID:SCR_007345:PhysioNet 平台通用研究资源标识符。
41. Alps / CSCS:瑞士国家超算 Alps(CSCS 运营)——RadVLM 训练算力(project a02)。
42. Swiss AI Initiative:瑞士 AI 计划——本集首要资助方(算力资助)。
43. LOOP Zurich:苏黎世医学研究联盟——BMIP 平台应用驱动项目资助。
44. DIZH / TRUST-RAD:苏黎世高校数字化计划/可信放射 AI 项目——一作与 Nooralahzadeh 的资助线。
45. JSPS KAKENHI:日本学术振兴会科研费——日本三人组的资助线(23KK0148)。
46. Krauthammer Lab:UZH 定量生物医学系实验室——HuggingFace org 同名,数据集 PI 单位。
47. MDS Lab:ETH Machine Learning for Digital Health 实验室(Sutter/Vogt)——ETH 方核心。
48. RadGraph F1 / GREEN:报告生成两指标——结构化 F1(RadGraph 图匹配)/ GPT 评估的 GREEN。
49. auto-regressive loss:自回归损失——仅计 assistant tokens,用户轮不计损失。
50. 指令变体数(×1-×4):表 1 的乘数——同一样本的指令模板倍数;多模板防模板过拟合。
术语表共 50 条——覆盖任务/方法/模型/许可/人物五域,交叉引用见附录 C 术语索引。
附录 A:数据集速查卡(一屏版)
| 属性 | 值 |
|---|---|
| 名称 | RadVLM Instruction Dataset |
| slug | radvlm-instruction-dataset |
| 版本 | v1.0.0(2025-09-25,单版本) |
| DOI | 10.13026/et5g-h222(RRID:SCR_007345) |
| 访问 | Credentialed(License 1.5.0 + Credentialed DUA + CITI) |
| 类型 | 多任务视觉指令微调数据(非图像 payload——图像四源自取) |
| 论文口径规模 | 1,115,021 image-instruction pairs |
| PhysioNet 实发 | 719,675 instances(CheXpert/PadChest 派生 395,346 条未随发) |
| 任务族 | 报告生成 / 14 类异常分类 / 解剖 grounding / 异常 grounding+检测 / 短语 grounding |
| 对话 | 87,017 入表(86,155 standard + 862 grounded;生成口径 ~89k) |
| 源库 | MIMIC-CXR-JPG v2.1.0 / Chest Imagenome v1.0.0 / MS-CXR v1.1.0 / VinDr-CXR v1.0.0 |
| 未随发源 | CheXpert + PadChest(+PadChest-GR) 派生数据点 |
| 格式 | LLaVA dataset format 单 json(image 路径 + conversations) |
| 标签引擎 | CheXbert(分类)+ WBF(VinDr 融合)+ GPT-4o(过滤/对话) |
| 基座 | LLaVA-OneVision-7B(SigLIP + 2-layer MLP + Qwen-2) |
| 训练 | 全参微调 1 epoch;enc lr 2e-6 / MLP+LLM lr 1e-5;loss 仅 assistant tokens |
| 评测 | RadGraph F1 + GREEN / mAP@IoU 0.5 / GPT-4o 0-10 打分 |
| 姊妹条目 | RadVLM model(radvlm-model v1.0.0,2025-10-08,DOI 10.13026/50kn-p490) |
| 语言 | 英语 |
| 团队 | UZH + ETH Zurich 双核 15 人 + 神户/京都 3 人 |
| 论文 | arXiv:2502.03333(v1 2025-02-05 / v2 2025-10-10,21 pages 15 figures) |
附录 B:关键时间线
| 时间 | 事件 |
|---|---|
| 2022 | MS-CXR(Boecking et al.)发布——短语 grounding 源就位 |
| 2023 | LLaVA / LLaVA-Med 发表——视觉指令调优范式确立 |
| 2023-2024 | CheXagent / RaDialog / MAIRA-2 陆续发布——专科模型时代,任务碎片化暴露 |
| 2024 | LLaVA-OneVision 发布——RadVLM 的基座就位 |
| 2025-02-05 | arXiv 2502.03333 v1 提交——RadVLM 论文首秀(含 1.11M 指令集描述) |
| 2025-09-25 | RadVLM Instruction Dataset v1.0.0 挂牌 PhysioNet(Credentialed) |
| 2025-10-08 | RadVLM model v1.0.0 挂牌——双实体发布完成(相隔 13 天) |
| 2025-10-10 | 论文 v2 修订(30,108 KB) |
| 2026-09 | 本条目核查快照(页面 70,431 B + arXiv HTML 463,721 B) |
附录 C:术语交叉索引(按字母序)
| 术语 | 首现节 | 关联术语 |
|---|---|---|
| 1,115,021 vs 719,675 | §4.4 | 坑点1 / 未随发差额 |
| Abnormality detection | §3.4 | VinDr-CXR ×2 |
| Abnormality grounding | §3.4 | VinDr-CXR ×3 |
| Alps / CSCS | §5.3 | Swiss AI Initiative |
| anatomical grounding | §3.3 | Chest Imagenome |
| assistant tokens | §5.2 | auto-regressive loss |
| Azure 特殊实例 | §4.4 | 三连选退 |
| CheXbert | §3.2 | 14 labels / uncertain |
| conversations | §4.1 | LLaVA format |
| coordinate textification | §4.2 | 0-1 归一化 |
| Credentialed Access | §2 | CITI / DUA 1.5.0 |
| grounded conversation | §3.6 | MS-CXR 862 |
| GREEN | §5.4 | RadGraph F1 |
| LLaVA-OneVision-7B | §5.1 | SigLIP / Qwen-2 |
| mAP@IoU 0.5 | §5.4 | grounding 评测 |
| MIMIC-CXR-JPG v2.1.0 | §3.1 | 377,110 → 230,980 |
| MS-CXR | §3.5 | phrase grounding |
| PadChest-GR | §3.6 | 未随发 |
| phrase grounding | §3.5 | 971×3 |
| prior-study 引用 | §3.1 | GPT-4o 清洗 |
| RadVLM model(姊妹条目) | §5.1 | radvlm-model |
| uncertain→absent | §3.2 | 坑点5 |
| VinDr-CXR | §3.4 | WBF / 3 读片者 |
| WBF | §3.4 | weighted box fusion |
| 差异化学习率 | §5.3 | 2e-6 / 1e-5 |
| 指令变体数 | 附录 E | ×1-×4 |
| 双实体策略 | §5.1 | 数据/模型分立 |
| 多轮对话 | §3.6 | GPT-4o 合成 |
| 未随发差额 | §4.4 | 395,346 推算 |
| 全参微调 | §5.2 | 1 epoch |
附录 D:文件清单与读取顺序(推荐入门路径)
- 先读页面:PhysioNet v1.0.0 页面的 Abstract + Methods(五任务配方)+ Descriptive Statistics(表 1 口径)——十分钟建立全局
- 再看论文:arXiv 2502.03333 v2 的 §3(数据构建)+ §4(训练与评测协议)+ 消融表——复现的全部细节
- 对照源库:MIMIC-CXR-JPG(617)/ Chest Imagenome(330)/ MS-CXR / VinDr-CXR 四条目——理解原料层
- 申请访问:PhysioNet Credentialed 三件套(注册+CITI+DUA)→ 下载 radvlm_instruction_dataset.json
- 组装图像树:下载四源库 → 按 json 的 image 路径组织 → 全量 os.path.exists 校验
- 解析校验:§9.1-9.4 的四段脚本依次跑通——坐标解析、对话展开、损失掩码、分布核对
- 训练对表:LLaVA 官方脚本 + 1 epoch + 双学习率;评测对表 RadGraph F1 / GREEN / mAP@IoU 0.5
- 补全口径(可选):需要 CheXpert/PadChest 数据点时,按论文管线 [36] 自建——注意各源许可链
附录 E:表 1 完整明细与复现基准
E.1 八行明细(PhysioNet 实发 719,675 的构成)
| 任务 | 源库 | 基数 × 变体数 | 实例数 | 输出形态 |
|---|---|---|---|---|
| Report Generation | MIMIC-CXR | 230,980 × 1 | 230,980 | 过滤后报告全文 |
| Abnormality classification | MIMIC-CXR | 237,912 × 1 | 237,912 | 异常列表(14 类内) |
| Anatomical grounding | Chest Imagenome | 80,000 × 1 | 80,000 | 单框(29 区随机选一) |
| Abnormality grounding | VinDr-CXR | 16,089 × 3 | 48,267 | 单框(WBF 融合后) |
| Abnormality detection | VinDr-CXR | 15,000 × 2 | 30,000 | 多框(全部病灶) |
| Phrase grounding | MS-CXR | 971 × 3 | 2,913 | 单框(句子级) |
| Conversation | MIMIC-CXR | 86,155 × 1 | 86,155 | 多轮文本(无框) |
| Conversation (grounded) | MS-CXR | 862 × 4 | 3,448 | 多轮文本+框交互 |
| 合计 | — | — | 719,675 | — |
E.2 变体数设计(×1-×4)
同一样本的指令模板倍数:报告/分类/standard 对话单模板(×1),异常 grounding 三模板(×3——同一框的三种问法),检测双模板(×2),短语 grounding 三模板(×3),grounded 对话四模板(×4)。多模板防"模板过拟合"——模型记住问句句式而非学会看图。
E.3 训练复现基准(论文实录)
| 超参 | 值 |
|---|---|
| 基座 | LLaVA-OneVision-7B |
| 组件状态 | vision encoder / MLP / LLM 全解冻 |
| epoch | 1 |
| 学习率(vision encoder) | 2e-6 |
| 学习率(MLP + LLM) | 1e-5 |
| 损失 | auto-regressive(仅 assistant tokens) |
| 算力 | CSCS Alps(Swiss AI Initiative,project a02) |
E.4 评测协议
| 方向 | 指标 | 说明 |
|---|---|---|
| 报告生成 | RadGraph F1 + GREEN | 结构化图匹配 + GPT 评估 |
| 解剖/异常/短语 grounding | mAP@IoU 0.5 | 预测框与金标重叠 ≥50% 记命中 |
| 对话质量 | GPT-4o 打分 0-10 | grounded / standard 两套(附录 1-Figure 2 prompt) |
| 分类 | 常规准确率 | 14 类 |
| 论文结论 | — | 对话+grounding SOTA;联合训练在小标注场景收益最大 |
附录 F:AI-Ready 评估细目(十维打分)
| 维度 | 分 | 依据 |
|---|---|---|
| 数据可得性 | 6 | Credentialed 中间档;json 本体直接可得;图像须四库对齐(组装成本在用户侧) |
| 格式标准化 | 9 | LLaVA format 是 VLM 指令数据的事实标准——零适配接官方脚本 |
| 标注质量 | 7 | CheXbert 自动 + WBF 人工融合 + LLM 合成三层;缺专家抽检与逐类一致率 |
| 文档完备 | 9 | 页面 Methods 分任务给配方;论文 21 页全披露;Usage Notes/Limitations 明确 |
| 可复现性 | 8 | 配方+超参全公开;HuggingFace 项目页;模型可对表;扣分项:CheXpert/PadChest 需自建 |
| 伦理完备 | 10 | LLM API 合规声明三连选退——行业标杆级 |
| 规模 | 9 | 实发 72 万/论文口径 111 万——胸片指令集最大公开口径 |
| 任务覆盖 | 9 | 5 任务族+多轮对话——同代最全 |
| 生态整合 | 8 | 四 Parent 全在 PhysioNet;LLaVA 脚本直通;HuggingFace 托管 |
| 长期维护 | 7 | 单版本初发布;团队活跃(2025-10 还在修论文);模型条目联动 |
DAIMS 综合:7.4(数据 6 / 标注 7 / 方法 8 / 影响 7 / 规模 9 的加权口径——详见 §7)。
附录 G:与近邻条目的差异表(胸片 VLM 全栈家族)
| 条目 | 层位 | 内容 | 关系 |
|---|---|---|---|
| MIMIC-CXR-JPG(617) | 原料层 | 377,110 图+报告 | 本集最大源(报告/分类/对话) |
| Chest Imagenome(330) | 标注增强 | 29 解剖区框 | 解剖 grounding 源 |
| MS-CXR(520 同族) | 标注增强 | 句-框对齐 | 短语 grounding + grounded 对话源 |
| MS-CXR-T(619) | 时序对齐 | 模板化时序对 | MS-CXR 的姊妹扩展(同 Microsoft 系) |
| VinDr-CXR | 人工标注 | 3 读片者框 | 异常 grounding/检测源(本库候选条目) |
| RadVLM Instruction Dataset(本条) | 指令化层 | 五任务+对话统一 json | 全栈的"菜谱"环节 |
| RadVLM model | 模型层 | 权重 | 训练产物(姊妹条目) |
| RadGraph2(622) | 评测层 | 报告结构化金标 | RadGraph F1 评测的语义基础 |
| RadCoref(621) | 评测层 | 共指消解 | 报告文本细粒度理解 |
| REFLACX(623) | 过程数据 | 眼动+口述 | 医生视角的补充模态(非直接血缘) |
全栈叙事:原料(617)→ 标注增强(330/MS-CXR/VinDr)→ 指令化(本条) → 模型(radvlm-model)→ 评测(622/621)——胸片 VLM 从数据到模型到评测的完整闭环在本库内可走通。
附录 H:引用与致谢模板
H.1 数据集引用(PhysioNet 官方 BibTeX)
@article{PhysioNet-radvlm-instruction-dataset-1.0.0,
  author = {Deperrois, Nicolas and Matsuo, Hidetoshi and Ruiperez-Campillo, Samuel and
            Vandenhirtz, Moritz and Laguna, Sonia and Ryser, Alain and Fujimoto, Koji and
            Nishio, Mizuho and Sutter, Thomas and Vogt, Julia and Kluckert, Jonas and
            Frauenfelder, Thomas and Bluethgen, Christian and Nooralahzadeh, Farhad and
            Krauthammer, Michael},
  title = {{RadVLM Instruction Dataset}},
  journal = {{PhysioNet}},
  year = {2025},
  month = sep,
  note = {Version 1.0.0},
  doi = {10.13026/et5g-h222},
  url = {https://doi.org/10.13026/et5g-h222}
}
H.2 原始论文引用(页面要求同时引)
@article{deperrois2025radvlm,
  title = {{RadVLM}: A Multitask Conversational Vision-Language Model for Radiology},
  author = {Deperrois, Nicolas and Matsuo, Hidetoshi and Ruip{\'e}rez-Campillo, Samuel and
            Vandenhirtz, Moritz and Laguna, Sonia and Ryser, Alain and others},
  journal = {arXiv preprint arXiv:2502.03333},
  year = {2025}
}
H.3 平台引用(PhysioNet 标准义务)
Pollard, T., Moody, B. E., Lehman, L., Gow, B., Fernandes, C., Xie, C., Johnson, A., Mark, R. G., & Heldt, T. (2026). PhysioNet as a global platform for biomedical research. Nature Health, 1(8), 792-795. https://doi.org/10.1038/s44360-026-00096-z
H.4 四 Parent Projects 引用义务(‘Please cite them when using this project’)
| 源库 | 版本 | 要点 |
|---|---|---|
| MIMIC-CXR-JPG | v2.1.0 | 报告生成/分类/standard 对话源 |
| Chest ImaGenome | v1.0.0 | 29 解剖区框源 |
| MS-CXR | v1.1.0 | 短语 grounding + grounded 对话源 |
| VinDr-CXR | v1.0.0 | 人工异常框源 |
H.5 致谢链(页面 Acknowledgements 完整转录)
Swiss AI Initiative(CSCS Alps project a02)|LOOP Zurich(BMIP application driver project)|DIZH Rapid Action Call(TRUST-RAD:ND、FN)|Promedica Foundation, Chur(CB)|ETH Domain PHRT #2021-911(TS)|JSPS KAKENHI 23KK0148(HM、MN、KF)|StimuLoop #1-007811-002 + Vontobel Foundation(AR)|SERI MB22.00047(MV、SL)|UZH Global Strategy and Partnerships + RPG 072023 18(MK)。COI:无。
附录 I:条目读法指南(三分钟版)
你是要训练胸片助手的工程师? 直达 §3.6(对话构建)+ §4.5(图像树组装)+ §9(四段脚本)——先跑通 §9.4 的分布核对再谈训练。
你是多模态学习研究者? §5.2-5.4(基座/训练/评测)+ 附录 E.3-E.4——双学习率与 mAP@IoU 0.5 协议是对表基准。
你是做数据合规的法务/治理岗? §4.4(GPT-4o 三连选退)+ 附录 H——这是"临床数据喂 LLM API"的完整合规样板,抄作业连出处一起抄。
你是评审或调研者? §4.4(双口径)+ §8(十四误解)+ §11 事实清单第 12-16 条——1,115,021 vs 719,675 的口径辨析是本集最大认知陷阱。
你是找数据的学生? INFOBOX + 附录 A 速查卡——五分钟知道这集是"json 菜谱+四源图像"的组装游戏,不是下完就能跑的自足数据集。
附录 J:高频问题快答表(十连发)
| 问题 | 一句话答案 | 详处 |
|---|---|---|
| 实发到底多少条? | 719,675(论文口径 1,115,021 含未随发的 CheXpert/PadChest 部分) | §4.4 / 坑点1 |
| 图像在哪? | 不随发——四源库自取后按 json 的 image 路径组装 | §4.5 / 坑点2 |
| 和 radvlm-model 怎么区分? | et5g-h222=数据(09-25);50kn-p490=权重(10-08) | §5.1 / 坑点3 |
| 坐标是什么单位? | 0-1 归一化浮点,方括号文本化在对话里 | §4.2 / 坑点4 |
| uncertain 标签哪去了? | 全部折叠为 absent——要三态回 CheXbert 原始输出 | §3.2 / 坑点5 |
| 要考 CITI 吗? | 要——Credentialed 档三件套(注册+DUA+CITI) | §7 四问 / 坑点6 |
| 对话是人写的吗? | GPT-4o 生成(86,155+862),零人工抽检 | §4.3 / 坑点7 |
| 对话到底几条? | 生成 ~89k,入表 87,017 | §3.6 / 坑点8 |
| 复现官方模型性能要什么? | 四库图像树+LLaVA 脚本+1 epoch 双学习率;CheXpert/PadChest 部分需自建 | §5.3 / 附录 E |
| 最大方法论遗产? | 三连选退合规 + WBF 融合 + 坐标文本化 + prior 清洗四件套 | §6.3 |
附录 K:与同代指令数据集的横向对照
| 维度 | RadVLM Instruction(本集) | RaDialog Instruct(523 待入库) | MAIRA-2 配套数据 | LLaVA-Med |
|---|---|---|---|---|
| 发布平台 | PhysioNet(Credentialed) | HuggingFace | 内部/部分公开 | HuggingFace |
| 领域 | 胸片五任务+对话 | 胸片对话为主 | 报告生成+grounding | 泛医学图文 |
| 规模 | 719,675 实发 | 十万级 | 万级 grounding | 158k |
| 多轮对话 | 87,017(含 862 grounded) | 有 | 有限 | 有 |
| 图像 payload | 不随发(四源自取) | 依源库 | 不随发 | PubMed 图开放 |
| 临床数据链 | MIMIC 全审计链 | MIMIC 依赖 | MIMIC 依赖 | 非 PHI |
| 许可清晰度 | 三连选退+四源引用义务 | 依源 | 复杂 | 宽松 |
读表要点:本集的差异化在"PhysioNet 合规链+任务最全+grounded 对话";代价是图像组装成本最高(四库对齐)。若只做对话研究,RaDialog 更轻;若要 grounding+报告+分类的全能配方,本集是唯一走完临床审计链的选择。
三分钟版总结:RadVLM Instruction Dataset 把四个公开胸片库重组为五任务+多轮对话的统一指令菜谱(论文 111 万对/实发 72 万),GPT-4o 干了清洗与对话两活,合规上给全行业打了三连选退的样——它是胸片 VLM 全栈的"指令化层",上承四源原料、下启 RadVLM 模型,复现成本主要在图像树组装而非数据本身。
附录 L:组装与训练检查清单(Checklist)
下载前(Credentialed 三件套)
- [ ] PhysioNet 账号完成 CITI 课程提交(Credentialed 档必修——别按 Restricted 档准备)
- [ ] 签署 Credentialed Health Data Use Agreement
- [ ] 目标确认:本集 json + 四源库(MIMIC-CXR-JPG / Chest Imagenome / MS-CXR / VinDr-CXR)共五个下载任务
json 落地后(结构核对)
- [ ] 统计 image 路径第一段分布——四源点数合计应为 719,675
- [ ] 抽样 10 条:conversations 的 from 交替是否合法、<image> 占位是否在 human 首轮
- [ ] grounding 样本:方括号坐标是否为 0-1 浮点(发现 >1 的值立即停下核对格式)
图像树组装后(对齐校验)
- [ ] 全量 os.path.exists 校验——任何 FileNotFoundError 先修路径再训练
- [ ] 随机抽 20 张图开框可视化(§9.2 的 to_pixels)——肉眼确认框落在解剖结构上
- [ ] 若做异常分类:核对标签数 ≤14 且无 uncertain 残留
训练中(对表论文)
- [ ] 基座 LLaVA-OneVision-7B;1 epoch;enc lr 2e-6 / MLP+LLM lr 1e-5
- [ ] 损失掩码只算 assistant tokens
- [ ] 显存预算:7B 全参微调需多卡(约 8×A100 量级)——单卡改 LoRA 并在论文引用里注明口径差异
训练后(评测收口)
- [ ] grounding:mAP@IoU 0.5(三项 grounding 分别报告)
- [ ] 报告生成:RadGraph F1 + GREEN
- [ ] 对话:GPT-4o 打分时声明自己用的是哪个评分实例(与论文不可精确对表,注明即可)
- [ ] 复现差异归因:优先查 CheXpert/PadChest 缺口(35% 数据点缺失的影响)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- reflacx-xray-localization — 共享标签:医学影像 / 医疗NLP / 多模态 / X光影像
- radialog-instruct-dataset — 共享标签:医学影像 / 医疗NLP / 多模态 / X光影像
- mimic-cxr — 共享标签:医学影像 / 多模态 / X光影像
- latte-cxr — 共享标签:医学影像 / 多模态 / X光影像
- ms-cxr-t — 共享标签:医学影像 / 医疗NLP / 多模态 / X光影像
- rsna-series — 共享标签:医学影像 / 多模态 / X光影像
- mimic-iv-note — 共享标签:医学影像 / 医疗NLP / X光影像
- ms-cxr — 共享标签:医学影像 / 多模态 / X光影像
- gmai-mmbench — 共享标签:医学影像 / 医疗NLP / 多模态
- chexpert-plus — 共享标签:医学影像 / 医疗NLP / X光影像
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
