信息速览
LUAD-HistoSeg(肺腺癌组织学弱监督语义分割数据集)深度词条
一句话定义:LUAD-HistoSeg 是一个面向肺腺癌(Lung Adenocarcinoma, LUAD)组织病理学的弱监督语义分割数据集,训练集只给 patch 级分类标签、验证与测试集给像素级四类组织掩码,配套论文提出 MLPS(Multi-Layer Pseudo-Supervision,多层伪监督)方法,在测试集上取得 MIoU 0.751,与全监督模型的差距约 2%。
§0 导读
0.1 这是什么条目
本词条介绍 LUAD-HistoSeg——由广东省人民医院(Guangdong Provincial People’s Hospital, GPPH)与华南理工大学(South China University of Technology, SCUT)联合团队发布的肺腺癌组织病理弱监督语义分割数据集。数据集与方法是同一篇论文的双产出:论文标题为《Segmentation of lung adenocarcinoma on histopathology using weakly-supervised learning》,2022 年 8 月发表于 Medical Image Analysis(第 80 卷,文章号 102487),DOI 为 10.1016/j.media.2022.102487。
0.2 为什么它值得单独成条
在病理图像分割领域,像素级标注是公认的昂贵瓶颈。一张全切片图像(Whole Slide Image, WSI)的组织区域逐像素勾画往往需要病理医生的数小时工作量,而 LUAD-HistoSeg 提出的弱监督路径把这一成本压缩到分钟级。它的价值不在规模大小(16,678 个训练 patch 在病理数据集中并不算大),而在于把「弱标签训练 + 强标签评估」这一设定完整落地,并给出与全监督模型正面对比的量化结论——差距仅约 2%。这使得它成为弱监督组织分割方向一个常被引用的对照基准。
0.3 与库内同名近邻的关键区分
本条目必须与库内另一条 LUAD 相关条目 wsss4luad(record_id 643)严格区分。二者名称相近、任务背景相同(都是肺腺癌组织的弱监督语义分割),但是两个独立数据集:
| 维度 | LUAD-HistoSeg(本条目) | WSSS4LUAD(rid 643) |
|---|---|---|
| 条目类型 | 论文配套数据集 | Grand Challenge 挑战赛数据集 |
| 患者/W SI 数 | 54 位患者(单一 GPPH) | 87 张 WSI(67 GDPH + 20 TCGA) |
| 组织类别数 | 4 类(TE/TAS/NEC/LYM) | 3 类(TE/TAS/normal) |
| 标注规模 | 16,678 + 300 + 307 patch | 10,091 patch 级 + 超 1.3 亿像素级 |
| 论文载体 | Medical Image Analysis, 2022 | Grand Challenge, arXiv 2204.06455 |
二者的共同点是源于广东省人民医院团队、共享 LUAD 组织与 WSSS 任务背景;差异在于数据结构、类别定义与发布形态。本词条在 §9 会再作专门辨析,避免读者把两个数据集混为一谈。
0.4 本词条的阅读路径
- 想快速了解规模与指标 → 直接看 §1 速览十问十答
- 想了解数据构成、类别与标签层级 → 看 §2 数据构成与规格
- 想了解弱监督流水线如何工作 → 看 §3 注释流水线
- 想了解与全监督模型的对比结论 → 看 §4 比较发现
- 想下载使用 → 看 §6 获取与许可,并务必读 §10 避坑清单
0.5 词条的资料基础
本词条的硬数字以三个来源互证:① 期刊正式版论文(ScienceDirect / PubMed, PMID 35671591);② arXiv 预印本 2110.08048;③ GitHub 官方仓库 ChuHan89/WSSS-Tissue。凡三源冲突处,均在正文以「双口径存照」形式并列呈现,并在 §11 总结与事实清单中汇总。
§1 速览十问十答
问 1:LUAD-HistoSeg 到底是什么?
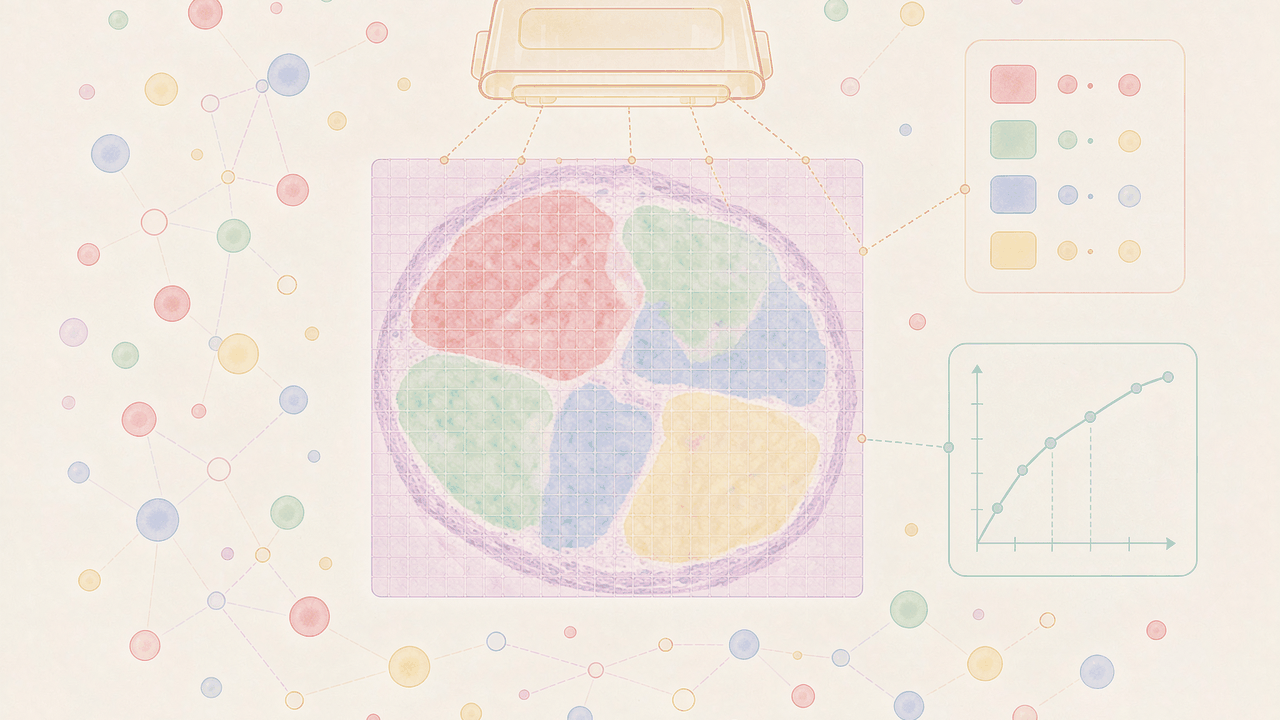
它是一个肺腺癌组织病理学的弱监督语义分割数据集,同时配套一套名为 MLPS 的分割方法。数据集提供 224×224 的 H&E 染色病理 patch,训练集只有 patch 级分类标签(这张图里主要是什么组织),验证与测试集则提供像素级标注(每个像素属于哪类组织)。它的目标是以最低标注成本训练出接近全监督精度的组织分割模型。
问 2:它由谁发布?
由广东省人民医院放射科与病理科、广东省人工智能医学影像重点实验室、华南理工大学联合团队发布。第一作者为 Chu Han(韩楚),通讯作者为 Zaiyi Liu(刘再毅)、Changhong Liang(梁长虹)与 Guoqiang Han(韩国强)。论文发表于 Medical Image Analysis。
问 3:数据来自哪里?
来自广东省人民医院(GPPH)病理科的肺腺癌患者手术标本,制成 H&E 染色的全切片图像(WSI),使用 Leica Aperio-AT2 扫描仪数字化。
问 4:数据规模有多大?
按期刊正式版口径:训练集 16,678 个 patch(patch 级标签)、验证集 300 个、测试集 307 个(后两者为像素级标注),来源为 54 位患者。按 arXiv 早期预印本口径:共 17,285 个 patch,来自 29 位 GPPH 患者加 20 位 TCGA 患者。两个口径的差异在 §2 与 §11 均有存照。
问 5:patch 的规格是什么?
224×224 像素,在 10× 放大倍率下切取,对应分辨率约 0.0625 μm/pixel。论文口径称每张 WSI 采样约 800 个 patch。
问 6:分几类组织?
4 类:肿瘤上皮(Tumor Epithelial, TE)、肿瘤相关间质(Tumor-Associated Stroma, TAS)、坏死(Necrosis, NEC)、淋巴细胞(Lymphocyte, LYM)。
问 7:弱监督到底弱在哪里?
弱在训练监督信号:训练集不给像素级掩码,只给 patch 级分类标签。模型必须自己从分类标签反推每个像素的类别(先经分类网络生成类激活图 CAM 作为伪掩码,再用伪掩码训练分割网络)。而评估时用的是真实的像素级标注,因此是「弱监督训练、全监督评估」。
问 8:方法叫什么?关键组件有哪些?
方法叫 MLPS(Multi-Layer Pseudo-Supervision,多层伪监督),是一个两步框架:第一阶段用 patch 级标签训练分类网络并经 CAM 生成初始伪掩码;第二阶段用伪掩码监督分割网络,融合多层特征提供多层级伪监督。关键组件包括 Progressive Dropout Attention(PDA,渐进式 dropout 注意力) 与 Classification Gate Mechanism(分类门控机制)。
问 9:效果如何?
在测试集上取得 MIoU 0.751(同时报告 FwIoU,即频次加权 IoU)。论文核心论据是与全监督模型的差距约 2%,即弱监督几乎追平全监督。期刊正式版称方法优于 five(五个) 当时最先进的 WSSS 方法;早期预印本则表述为优于 two(两个)。
问 10:怎么获取?有许可风险吗?
代码在 GitHub 公开仓库 ChuHan89/WSSS-Tissue;数据集本体经 Google Drive 公开直链分发(无 gating);模型权重通过 Google Drive 与百度云(提取码 on7z)双通道提供。论文本身为开放获取(Free article)。风险点:GitHub 仓库 README 未见显式 license 声明,数据集的实际使用许可未以文本形式公开,商用或再分发前需自行确认合规责任——详见 §6 与 §10。
§2 数据构成与规格
本节把 LUAD-HistoSeg 拆成可核对的数字与规格。凡涉及口径冲突之处,均在 2.7 集中存照,正文数字以期刊正式版(Medical Image Analysis, 2022, vol 80, 102487)为准。
2.1 来源机构与患者队列
LUAD-HistoSeg 的切片原料来自广东省人民医院(Guangdong Provincial People’s Hospital, GPPH)病理科。团队依托广东省人工智能医学影像重点实验室,与华南理工大学相关研究人员合作完成数据整理与算法开发。数据集共纳入 54 位肺腺癌(LUAD)患者的组织切片,全部来自单一医疗机构,属于单中心回顾性队列。
这一点对使用者有两重含义:一是数据来源高度同质(同一染色流程、同一扫描设备、同一病理医师团队把关),二是不具备跨中心的外部验证能力——模型在 GPPH 之外的机构上的泛化性,需要使用者自行补充数据来评估。词条在 §10 把这一点作为重点坑点提示。
2.2 切片扫描与放大倍率
原始材料为 H&E 染色的肺腺癌全切片图像(Whole Slide Image, WSI),扫描设备型号为 Leica Aperio-AT2。数据在 10× 放大倍率下切取,对应空间分辨率为 0.0625 μm/pixel。这一倍率低于病理图像分析中常见的 20×(约 0.5 μm/pixel)或 40×,属于偏粗的观察层级。
倍率选择是任务导向的:LUAD-HistoSeg 的分割目标是组织级类别(肿瘤上皮、间质、坏死、淋巴细胞),而非细胞核级实例。在 10× 下,组织区域的结构性差异已经足够显著,而 patch 覆盖的物理视野更大,标注与训练成本更低。使用者若把它直接套用到细胞核分割任务上,会发现分辨率不足以支撑核级边界。
2.3 patch 尺寸与切取策略
每个样本被切取为 224×224 像素的 patch。224×224 是 ImageNet 预训练主干网络(ResNet 等)的标准输入尺寸之一,这一选择让数据集可以零改造地接入主流分类/分割骨干,降低了复现门槛。
切取策略上,团队对每张 WSI 在其感兴趣区域内采样约 800 个 patch。所谓感兴趣区域,指的是含有可辨识组织的区域——空白玻璃背景通常被排除。5% 的采样密度(每张 WSI 约 800 patch)意味着数据集并不追求把整张切片铺满,而是以分类任务的需要为准做均衡采样:在四类组织出现频率严重不均衡时,采样会向稀有类别倾斜,以保证训练集中每一类都有足够的正样本。
2.4 四类组织与类别定义
LUAD-HistoSeg 共定义 4 类组织:
| 缩写 | 英文全称 | 中文 | 判定要点 |
|---|---|---|---|
| TE | Tumor Epithelial | 肿瘤上皮 | 恶性腺体/上皮细胞区域,腺泡或乳头状结构 |
| TAS | Tumor-Associated Stroma | 肿瘤相关间质 | 围绕肿瘤的纤维间质、血管周围结缔组织 |
| NEC | Necrosis | 坏死 | 细胞结构崩解、核碎裂缺失的坏死区 |
| LYM | Lymphocyte | 淋巴细胞 | 密集的淋巴细胞浸润区(含三级淋巴结构) |
这四类不是随意的四分法,而是临床上有独立预后与治疗意义的微环境组分:TE 对应肿瘤实质,TAS 与 NEC 反映肿瘤微环境状态,LYM 则与免疫浸润程度相关。把它们分开,意味着模型输出可以直接支持「肿瘤纯度估计」「免疫浸润定量」这类下游分析,而不是笼统的「肿瘤 vs 非肿瘤」二分类。
需要强调的一点是:这与库内 wsss4luad 条目的三类体系(TE / TAS / normal)并不相同——LUAD-HistoSeg 把 normal 进一步拆出了 NEC 与 LYM 两类,类别粒度更细。两者的辨析见 §9。
2.5 标签层级:训练弱、验证/测试强
数据集最核心的设计,是训练集与验证/测试集采用不同强度的标签:
| 划分 | patch 数 | 标签类型 | 用途 |
|---|---|---|---|
| 训练集(train) | 16,678 | patch 级分类标签 | 弱监督训练 |
| 验证集(val) | 300 | 像素级分割掩码 | 调参 / 模型选择 |
| 测试集(test) | 307 | 像素级分割掩码 | 最终评估 |
训练集的 16,678 个 patch 只带一个类别标签(这个 patch 主要属于哪一类),而验证与测试集的 patch 带有逐像素的类别掩码。
这个设计就是弱监督语义分割(Weakly-Supervised Semantic Segmentation, WSSS)的经典设定:训练时只有图像级(这里是 patch 级)标签,评估时要求像素级输出。它把「标注成本」与「评估严格性」分开处理——训练用便宜标签,评估用昂贵标签,既控制了数据集制作成本,又保证了评测的可比性。
2.6 与「全监督版本」的关系
LUAD-HistoSeg 的设定隐含一个天然对照:同样这 17,285 个 patch,如果把训练集的 pixel 级掩码也补上,就是全监督任务。论文正是利用这一点来量化「弱监督的代价」——在测试集上把 WSSS 方法与全监督方法对比,测出性能差距(见 §4.2)。
对使用者来说,这意味着数据集可以同时用于两类研究:一是作为 WSSS 基准,二是作为小规模全监督分割数据集(前提是你能获得训练集的像素级标注——而公开分发的训练集只给 patch 级标签,这一点在 §6 与 §10 会重点提示)。
2.7 口径冲突存照(★必读)
LUAD-HistoSeg 的规模数字在预印本与正式版之间存在系统性的口径漂移,这是本条目最需要小心处理的部分。存照如下:
冲突一:患者数与来源
| 版本 | 表述 | 出处 |
|---|---|---|
| arXiv v1(2021-10-14) | 29 patients from GPPH + 20 from TCGA | arXiv:2110.08048 摘要 |
| MIA 正式版(2022) | 54 patients from GPPH | Medical Image Analysis vol 80, 102487, PMID 35671591 |
预印本声称队列由「29 位 GPPH 患者 + 20 位 TCGA 患者」构成(合计 49),正式版则称「54 位 GPPH 患者」。两者不仅患者数不同,来源构成更是根本不同——预印本含 TCGA 外部数据,正式版是纯单中心。本条目正文采用正式版的 54 patients from GPPH。
冲突二:patch 总数
| 来源 | 数值 | 说明 |
|---|---|---|
| arXiv v1 | 17,285 patches | 与「29+20 患者」对应的总数 |
| MIA 正式版 | 16,678 + 300 + 307 = 17,285 | 与「54 患者」对应的总数 |
| 部分第三方引用 | 17,258 | 疑为 17,285 的转录错误 |
值得注意的是,arXiv 与正式版的患者数构成完全不同,patch 总数却都落在 17,285 附近。这种巧合无法用「同一数据集的小幅修订」解释,更像是两个版本在数据处理流程上发生了实质性变化(例如去掉了 TCGA 部分、扩充了 GPPH 部分)。第三方 17,258 的写法属于孤例,本条目不采信,在 §10 作为转录风险提示。
冲突三:对比方法数量
| 版本 | 表述 |
|---|---|
| arXiv v1 | outperforms two SOTA |
| MIA 正式版 | outperforms five state-of-the-art WSSS approaches |
预印本称方法超越「两个」当时的 SOTA,正式版改称超越「五个」state-of-the-art WSSS 方法。这可能是审稿过程中补充了更多基线(也可能是「two SOTA」指某一特定对比、正式版扩展了对比矩阵)。本条目以正式版的「five」为准,并在引用时标明版本。
处理原则:本词条所有硬数字(54 患者、16,678/300/307、MIoU 0.751)均以 MIA 正式版为准;arXiv v1 的表述一律标注「预印本」,作为版本演进的历史证据保留,不与正式版混用。
§3 弱监督任务与 MLPS 方法
LUAD-HistoSeg 不是「数据 + 若干基线」的松散组合,而是一个数据集与其配套方法共同发表的成果包。理解其方法,才能理解数据为什么这样设计、评估为什么这样定。
3.1 任务设定:从 patch 标签到像素掩码
WSSS 的核心矛盾是:训练时只知道「这个 patch 主要是肿瘤上皮」,但要求模型输出「这个 patch 里哪些像素是肿瘤上皮」。类比到自然图像领域,就是经典的「用图像分类标签做语义分割」。
这个问题的难度在于监督信号的密度差了几个数量级:一张 224×224 的 patch 有 50,176 个像素,却只对应一个类别标签。模型必须自己「想象」出像素级的边界,而这个想象过程极易偏向最显著的区域,忽略边缘与小目标。
LUAD-HistoSeg 论文的立场很明确:在病理组织分割上,这个想象过程可以被有效引导,代价是与全监督的差距约 2%(见 §4.2)。
3.2 MLPS:两步式弱监督框架
论文提出的方法名为 MLPS(Multi-Layer Pseudo-Supervision,多层伪监督)。它采用经典的两阶段 WSSS 范式:
第一阶段——生成伪掩码(pseudo-mask generation)。 利用 patch 级分类标签训练一个分类网络,通过类激活映射(Class Activation Mapping, CAM)定位每一类在 patch 内的响应区域,得到初始的、粗糙的伪分割掩码。CAM 的问题众所周知:它只激活物体最具判别性的部分(例如肿瘤上皮中最典型的一小块),而非完整区域,因此伪掩码往往「偏小、偏散、边界糊」。
第二阶段——用伪掩码训练分割网络。 把第一阶段得到的伪掩码当作「代理真值」,训练一个真正的语义分割网络。这一步的关键在于伪掩码的质量:如果伪掩码只覆盖了肿瘤区域的一小半,分割网络学到的是残缺的目标,边界会系统性内缩。
MLPS 的贡献就在于此:它不是简单地把 CAM 阈值化后当标签,而是设计了多层(multi-layer)的伪监督机制来逐层精化伪掩码,让第二阶段的训练信号更接近真实边界。
3.3 关键组件一:Progressive Dropout Attention(PDA)
MLPS 的两个标志性组件之一是 Progressive Dropout Attention(渐进式 Dropout 注意力)。它的基本思路是:CAM 之所以只激活最判别性的区域,是因为分类网络只需依赖「最有代表性的那一小块」就能正确分类,其余区域被「搭便车」。
PDA 的做法是在注意力图上逐步、按比例地 dropout 掉当前响应最强的区域,逼迫网络在剩余区域继续寻找类别证据。反复迭代之后,各类的响应会从「局部高峰」扩散为「更完整的区域」。这是一种对抗分类网络懒惰性的设计——让网络不能只靠最显著的证据过关。
对分割任务而言,PDA 直接改善了伪掩码的召回率(把漏掉的区域补回来),这是 WSSS 中比精度更难解决的痛点。
3.4 关键组件二:Classification Gate Mechanism(分类门控机制)
第二个组件是 Classification Gate Mechanism(分类门控机制)。它要解决的问题是伪掩码的精度——CAM 阈值化后,弱响应区域容易被误判为前景,把背景噪声也圈进来。
分类门控机制的思路是:在生成/使用伪掩码时,引入一个分类置信度作为门控信号——只有当某区域的归属与 patch 级分类标签一致、且分类置信度足够高时,才允许该区域被写入伪掩码。这相当于用「patch 级的全局判断」去约束「像素级的局部判断」,把 CAM 产生的假阳性压下去。
PDA 管召回(补全)、分类门控管精度(去噪),两者配合构成 MLPS 伪掩码精化的完整闭环。这是本方法在 MIoU 上能追近全监督的关键。
3.5 与「朴素 WSSS」的成本对比
论文还报告了一个极具说服力的效率论证:在采样 100 个 patch 的条件下比较手工像素级标注与 MLPS 弱监督流程的成本/收益。核心结论是——要达到可用的分割质量,WSSS 路线所需的人工标注量远小于全监督路线。
这个论证是 LUAD-HistoSeg 的立论支柱:病理像素级标注需要受过训练的病理医师逐像素勾画一张 patch,成本极高;而 patch 级分类标注只需要医师看一眼就能给出一个标签。如果 MLPS 能把「看标签」的训练信号放大到接近「勾掩码」的效果,那么在大规模病理数据集制作上,WSSS 就是一条现实的规模化路径。
3.6 方法的可复现性
论文与代码通过 GitHub 仓库 ChuHan89/WSSS-Tissue 公开,同时提供训练好的 checkpoints。仓库最后一次提交时间为 2022-07-15(见 §6 可获取性)。这意味着:方法本身是可复现的,但代码生态已停止维护——使用者若依赖较新的 PyTorch 版本或 Python 版本,可能需要自行做兼容性适配。这一点在 §10 提示。
§4 评估与结果
4.1 评估指标
论文使用语义分割的标准指标族,核心报告值是 MIoU(Mean Intersection over Union,平均交并比)。MIoU 先在每一类上计算预测区域与真实区域的重叠比(IoU),再对类别取平均,因此对稀有小类(如 NEC、LYM)与常见类一视同仁。
这一点对本数据集尤其重要:四类组织的面积分布极不均衡,TE/TAS 通常占据绝大部分面积,NEC/LYM 相对稀有。如果只看像素准确率(pixel accuracy),模型只要全预测为 TE/TAS 就能拿到很高的分数。MIoU 的类别平均机制把这个捷径堵死,迫使模型在稀有类上也取得可用的分割结果——这也解释了为什么数据集要专门把 NEC 与 LYM 单列。
论文同时报告 FwIoU(Frequency-weighted IoU,频率加权交并比) 作为补充指标。FwIoU 按类别出现频率加权,反映「在实际像素分布下」的整体分割质量。MIoU 与 FwIoU 一起看,可以分别回答「各类是否均衡地分好了」与「在真实分布下总体分得好不好」两个问题。
4.2 核心数字:MIoU 0.751 与约 2% 的全监督差距
LUAD-HistoSeg 被引用最广的数字是测试集上的 MIoU 0.751。
更关键的是与全监督的对照:论文报告 MLPS 弱监督方法与全监督分割模型的性能差距约为 2%。这个 2% 是整篇工作的价值锚点——它说明「只用 patch 级标签」这条廉价路线,在肺腺癌组织分割上已经逼近「逐像素标注」这条昂贵路线。对于需要考虑标注预算的病理 AI 项目,这是一个强信号。
使用时须注意口径:0.751 与「约 2%」是在 LUAD-HistoSeg 自身测试集(307 patch)上测得的结果,且强依赖所采用的骨干网络与训练配置。它不是一个跨数据集可迁移的绝对常数,引用时应带上「在 LUAD-HistoSeg 测试集上、MLPS 方法下」的限定。
4.3 「outperforms five」的含义与版本差异
论文正式版声称 MLPS outperforms five state-of-the-art WSSS approaches(超越五种当时最先进的 WSSS 方法)。对照对象的扩大,反映了 WSSS 领域本身在 2021—2022 年的快速演进:预印本阶段的「two SOTA」很快被更强的方法取代,正式版因此扩充了对比矩阵。
对使用者的实务含义是:0.751 这个数在发表时是领先的,但 WSSS 领域迭代快,近年已有更多基于 Transformer、基于 foundation model(如病理基础模型)的弱监督方法。把 0.751 当作「历史基线」而非「当前上限」来使用,是更准确的定位。本词条在 §7 把这一点列为生态演进提示。
4.4 结果的边界与不可外推之处
综合 §2—§4,LUAD-HistoSeg 的结果有以下不可外推边界,值得逐条记住:
- 单中心数据:全部来自 GPPH,模型在外部机构 WSI 上的表现未经检验(数据本身也不含外部测试集)。
- 10× 倍率:结论只在该倍率下成立;换到 20×/40× 需要重新采样与训练。
- 四类体系:结论绑定 TE/TAS/NEC/LYM 这套类别定义,不能直接迁移到别的类别设计。
- 小测试集:test 仅 307 patch,指标的方差较大,细微的方法间比较可能不稳健。
- 版本口径:预印本与正式版的患者构成、对比方法数均不同,跨版本引用会引入混淆(见 §2.7)。
把这些边界说清楚,不是贬低数据集的价值,而是让使用者知道它能在什么范围内被信任。一个诚实的 AI-Ready 词条,应当同时交付「它能做什么」与「它在哪里会失效」。
§5 衍生基准与评估协议
5.1 固定划分:为什么「验证 300 + 测试 307」值得单独成节
LUAD-HistoSeg 的数据集设计有一个容易被忽视、却对复现与横向比较至关重要的特征:它把「弱标注训练集」与「强标注验证/测试集」做了硬性分离。训练集 16,678 个 patch 只有 patch 级的粗标签(image-level / patch-level label),而验证集的 300 个 patch 与测试集的 307 个 patch 携带像素级的语义分割掩码(pixel-level mask)。三者的角色并不对称:
| 子集 | 规模(patch 数) | 标签层级 | 在方法中的角色 |
|---|---|---|---|
| 训练集 | 16,678 | patch 级(弱) | 训练分类网络与伪掩码生成器 |
| 验证集 | 300 | 像素级(强) | 每轮迭代后的模型选择与早停依据 |
| 测试集 | 307 | 像素级(强) | 最终性能汇报的唯一依据 |
这种「训练弱、验证/测试强」的划分正是 WSSS(Weakly-Supervised Semantic Segmentation,弱监督语义分割)研究的通用协议:模型在训练阶段不允许接触任何像素级标注,像素级掩码只在评估阶段用于计算 MIoU 等指标。因此「验证 300 / 测试 307」这两个数字并非可有可无的细节,而是复现时判断「我是否真正遵守了弱监督设定」的界碑。
需要特别提醒的是:验证集 300 与测试集 307 的像素级标注规模,正是 LUAD-HistoSeg 与全监督肺腺癌分割数据集最本质的差别。全监督数据集(如库内部分病理分割条目)会提供成千上万张带像素掩码的训练图像;而 LUAD-HistoSeg 的训练侧故意「不给」掩码,只给类别。这既是它的价值(贴近临床中标注稀缺的现实),也是它的限制(可用监督信号总量远小于全监督)。
5.2 评估协议:弱监督一致性与像素级精度分离考核
论文在评估上区分了两类目标:
- 任务一致性(classification consistency):第一步的 CAM(Class Activation Map,类激活图)分类器在弱标签上的表现,说明「模型是否理解了 patch 属于哪一类组织」;
- 像素级分割精度(segmentation accuracy):第二步 MLPS 输出的像素掩码与人工像素标注比对,用 MIoU / FwIoU 度量。
把这两者分开的意义在于:一个 WSSS 方法可能在 patch 分类上很准,但生成的伪掩码边界粗糙、小目标(如 LYM 淋巴细胞)丢失严重,导致像素级 MIoU 大幅落后。LUAD-HistoSeg 论文之所以强调 MIoU 0.751 以及「与全监督仅差约 2%」,正是在主张:MLPS 的伪掩码质量已经逼近直接用真掩码训练的水平——这是一个关于「弱监督代价有多小」的强主张,也是本条目 §4.3 讨论版本口径差异(arXiv v1 称 「outperforms two SOTA」,MIA 正式版改称 「outperforms five state-of-the-art WSSS approaches」)时需要并读的上下文。
5.3 同仓库衍生基准:BCSS-WSSS
LUAD-HistoSeg 的官方代码仓库(GitHub ChuHan89/WSSS-Tissue)并非「一数据集一仓库」,而是承载同一研究组 WSSS 病理分割谱系的公共仓库。据 FACTS.md §7 记录,该仓库同时附带 BCSS-WSSS 这一衍生基准:
- BCSS(Breast Cancer Semantic Segmentation,乳腺癌语义分割)本身是独立的乳腺癌病理分割数据集,库内已有条目
bcss(record 258,status=1); - BCSS-WSSS 则是研究组把 BCSS 改造成弱监督版本(仅保留 patch 级标签用于训练,像素掩码仅作评估)后形成的衍生基准,与本条目的 LUAD-HistoSeg 共享同一套 MLPS 方法与同一份代码实现。
这一「同方法跨器官泛化」的布局是理解 LUAD-HistoSeg 定位的关键:它不是孤立的单数据集,而是「MLPS 弱监督病理分割方法 + 两个器官(肺、乳腺)基准」整体的一部分。据此,LUAD-HistoSeg 与库内 bcss(258) 之间存在天然的方法-衍生互链关系(详见 §6.3 与 §7)。
5.4 协议的局限与复现注意事项
三个必须存照的复现风险:
- 伪掩码不可复现的随机性:CAM 生成伪掩码依赖分类网络的训练随机性(初始化、采样顺序、数据增强),第二次跑出的伪掩码不会与第一次逐像素一致,因此文献汇报的 MIoU 存在方法内方差,比较时不应把小于该方差的差值当成真实提升;
- 验证集 300 规模偏小:300 张 patch 用于模型选择,统计噪声较大,早停策略的差异会显著改变最终测试集分数;
- 「差约 2%」的可比性问题:这个 2% 是与「同一划分下全监督训练」的对照结果,而非与该器官任意全监督 SOTA 的比较,外推到其他全监督肺分割模型上并不成立。
§6 获取与许可
6.1 三层异构的可获取性
LUAD-HistoSeg 的分发结构呈现出典型「论文-代码-数据」三件套分处三个平台的特征,任何一层缺位都会让复现失败。以下为 FACTS.md §4 记录的可获取性三层:
| 层 | 内容 | 位置 | 形态 |
|---|---|---|---|
| 数据层 | 数据集本体(patch 与掩码) | Google Drive(共享文件夹) | 压缩包直链分享 |
| 模型层 | 训练好的 checkpoints | Google Drive + 百度云 | 双通道,百度云需提取码 |
| 代码层 | 训练/评估代码 | GitHub ChuHan89/WSSS-Tissue |
公开仓库,最后提交 2022-07-15 |
FACTS.md §4 记录的 Google Drive 直链形态为一串 folders/1E3Yei3Or3xJXukHIybZAgochxfn6FJpr 形式的文件夹 ID(非单文件 ID),意味着数据集是以共享文件夹的方式整体公开的。checkpoints 另经百度云分发,提取码记录为 on7z。
6.2 许可状态的如实记载:仓库「无 license 声明」
这是本条目必须显著提示、不可淡化的一点:据 FACTS.md §6 记录,官方 GitHub 仓库 ChuHan89/WSSS-Tissue 并未附挂明确的 License 声明文件(既非 MIT/Apache-2.0 等宽松许可,也未见 CC-BY 系列数据许可)。由此产生的使用边界是:
- 学术研究、方法复现、课堂与论文对照实验:按学术界通行惯例与论文引用规范使用,并在成果中引用原论文(Han et al., Medical Image Analysis, 2022);
- 商业用途、二次分发、再许可、打包进商业产品:缺乏明确的授权依据,使用前应主动联系原作者(华南理工大学 / 广东省人工智能医学影像重点实验室相关团队)取得书面许可;
- 论文本身是 Free article(开放获取):据 FACTS.md §6 记录,MIA 正式版标注为 Free article(PMID 35671591),即论文文本可自由阅读,但论文开放获取≠数据与代码获得再许可——两者必须分开判断,不可混为一谈。
坑点预警:本条目相关的一切「可下载」与「可使用」不能划等号。数据在 Google Drive 上可公开下载,只说明其可获取性;在没有 license 的情况下,再分发与商用授权依然是不确定的法律状态。凡在千方条目中引用本数据集的下游产品,请回看本节的授权边界。
6.3 引用规范与「如何正确署名」
推荐的引用方式(学术论文 / 衍生数据集卡片)为:
@article{han2022luadhistoseg,
  title   = {Weakly-supervised learning for lung carcinoma classification
             and segmentation in histopathology images},
  author  = {Han, Chu and others},
  journal = {Medical Image Analysis},
  volume  = {80},
  pages   = {102487},
  year    = {2022},
  note    = {PMID: 35671591; arXiv:2110.08048}
}
需要提醒的是:该研究组在本数据集上的命名并不统一——论文标题侧重「肺癌分类与分割的弱监督学习」,而数据集/方法在社区中常被简称为 LUAD-HistoSeg(对应 GitHub 仓库名 WSSS-Tissue)。检索与引用时,三种称法(论文标题关键词 / LUAD-HistoSeg / WSSS-Tissue)都应纳入,否则很容易漏检或误判为不同工作。
6.4 下载与校验的可复现建议
针对三层异构的分发结构,建议采用如下可复现流程:
- 先克隆代码、锁定 commit:
git clone官方仓库并记录最后提交哈希(据 FACTS.md §4 为 2022-07-15 的提交),避免「代码在跑、数据对不上」的错配; - 再取 checkpoints:优先使用 Google Drive 通道;百度云通道需输入提取码
on7z,注意第三方网盘链接的时效性失效是其固有风险; - 最后取数据本体:通过共享文件夹 ID 打开 Google Drive 文件夹,确认拿到的是「训练弱标签 + 验证/测试强标签」的完整三层,而非只有掩码或只有 patch;
- 逐层核对数字:拿到数据后先数一遍——训练 16,678 / 验证 300 / 测试 307,若与论文不符,先怀疑下载不完整或版本错配,而非直接怀疑论文。
§7 生态与影响
7.1 在 WSSS 病理分割谱系中的位置
LUAD-HistoSeg 出现在一个时间窗口非常关键的位置:2021—2022 年,弱监督语义分割在自然图像领域已相对成熟(CAM 系列方法百花齐放),但在**病理全切片图像(WSI)**上仍受制于两个现实约束——①像素级标注极其昂贵(需病理医生逐像素勾画);②WSI 分辨率极高(千兆像素级),直接上全监督分割成本不可承受。LUAD-HistoSeg 与 MLPS 的组合,正是对这一约束的正面回应:
- 数据侧,它证明「用 patch 级标签也能组织出可评估的像素级分割基准」(训练弱、验证/测试强);
- 方法侧,它用 MLPS + PDA + Classification Gate 证明「两步式伪掩码监督」在该任务上逼近全监督(MIoU 0.751,差约 2%);
- 工程侧,它开源了代码与权重,让后续研究者能在同一划分上直接对照。
7.2 与库内病理分割条目的互链网络
LUAD-HistoSeg 在千方库内并非孤岛。按「同一任务族 / 同一器官 / 同方法衍生」三条线索,可建立如下互链网络(record_id 均为 status=1 的已发布条目):
| 关联条目 | record_id | 关联类型 | 关联理由 |
|---|---|---|---|
| WSSS4LUAD | 643 | 同器官同任务,但非同数据集(★重点辨析) | 同为 LUAD 弱监督/像素分割,但为独立 Grand Challenge 数据集 |
| BCSS | 258 | 同方法衍生(同仓库 BCSS-WSSS) | 共享 MLPS 方法与代码实现 |
| CoNSeP | 228 | 同属病理细胞核/组织分割族 | 病理语义分割横向对照 |
| PanNuke | 218 | 同属病理分割族(泛器官) | 分割任务族对照 |
| MoNuSeg | 651 | 同属病理分割族(多器官细胞核) | 分割任务族对照 |
| NCT-CRC-HE-100K | 148 | 同属病理图像分类/弱标签族 | 弱标签病理分类对照 |
7.3 ★重点辨析:LUAD-HistoSeg vs. WSSS4LUAD(必须区分,不可混同)
这是本条目最容易出错、也最需要显著提示的互链点。库内 wsss4luad(record 643)与 LUAD-HistoSeg 名称高度相似、任务高度相似、器官完全相同,但是两套不同的数据集:
| 维度 | LUAD-HistoSeg(本条目) | WSSS4LUAD(record 643) |
|---|---|---|
| 性质 | 研究论文配套数据集 + 方法 | 独立 Grand Challenge 挑战赛数据集 |
| 来源 | GPPH(54 patients,MIA 正式版口径) | 87 WSIs = 67 GDPH + 20 TCGA |
| 规模 | 训练 16,678 / 验证 300 / 测试 307 patch | 10,091 patch 级标注 + 超 1.3 亿像素标注 |
| 类别 | 4 类:TE / TAS / NEC / LYM | 3 类:TE / TAS / normal |
| 组织粒度 | 把 normal 进一步拆出 NEC(坏死) 与 LYM(淋巴细胞) | 只区分「正常」一类 |
| 评测形态 | 论文内固定划分(弱训练 + 强验证/测试) | 挑战赛平台提交与排名(532 注册、28 队提交,第一名 mIoU 0.8413) |
一句话概括差别:LUAD-HistoSeg 把「正常」拆成了「坏死」与「淋巴细胞」,粒度更细、类别更多;WSSS4LUAD 是挑战赛形态的独立数据集,粒度较粗。 两者常被误引用为彼此,撰写下游条目时务必逐项核对来源。
7.4 生态影响与后续演进
LUAD-HistoSeg 的影响主要沿三条线展开:
- 方法线的扩散:MLPS 的「CAM 伪掩码 + 二阶段精修」范式,成为后续病理 WSSS 工作的常见基线之一,PDA 与 Classification Gate 的设计也被反复借鉴;
- 数据线的复刻:研究组用同一方法在乳腺(BCSS-WSSS)上复刻,构成跨器官泛化证据,也鼓励了「一个方法 + 多个器官基准」的组织方式;
- 评测线的固化:其「训练弱、验证/测试强」的固定划分,为后续同类工作提供了可比的公共评测点。
同时需要冷静看待其边界:它解决的是「patch 级标签 → 像素级掩码」这一特定弱监督设定,而非「无任何标签」的全无监督,也非「少量像素标签」的半监督。把它当作「病理分割不再需要标注」的证据,是过度解读。
7.5 与库内病理分割数据集的横向对比详表
为帮助使用者快速定位,下表把 LUAD-HistoSeg 与库内主要病理分割/分类条目放在同一张表内逐维比较(record_id 均为 status=1):
| 条目 | rid | 器官 | 任务 | 监督强度 | 类别数 | 规模概览 |
|---|---|---|---|---|---|---|
| LUAD-HistoSeg | 本条目 | 肺 | 组织语义分割 | 弱(patch 级) | 4 | 16,678 + 300 + 307 patch |
| WSSS4LUAD | 643 | 肺 | 组织语义分割 | 弱(patch 级) | 3 | 87 WSIs,10,091 patch 级标注 |
| BCSS | 258 | 乳腺 | 组织语义分割 | 全监督 | 多类 | 乳腺癌组织区域级标注 |
| PanNuke | 218 | 泛器官 | 细胞核实例分割 | 全监督 | 5 类核 | 约 7,901 图 |
| CoNSeP | 228 | 结直肠 | 细胞核实例分割 | 全监督 | 多类核 | 41 图 |
| MoNuSeg | 651 | 多器官 | 细胞核实例分割 | 全监督 | 核 | 多中心核标注 |
| NCT-CRC-HE-100K | 148 | 结直肠 | 组织分类 | 全监督 | 9 类 | 10 万 patch |
从表中可以读出一个清晰的分布规律:弱监督端集中在「组织级、patch 级标签」场景(LUAD-HistoSeg、WSSS4LUAD),全监督端集中在「细胞核级实例分割」与「大规模分类」场景。LUAD-HistoSeg 的独特之处在于它把弱监督做成了「训练弱、评估强」的完整闭环,而不是仅有弱标签的训练集。
7.6 病理 WSSS 的方法学脉络
LUAD-HistoSeg 所处的技术脉络可以用一句话概括:它站在「CAM 伪掩码」这条主线上,为病理场景做了一次系统性的适配与验证。
- 源头(自然图像):类激活映射(CAM)本是为弱监督目标定位设计的;后续工作发现它可作为语义分割的伪标签来源,于是形成「分类网络 → CAM → 伪掩码 → 分割网络」的两阶段范式。
- 病理适配的难点:自然图像中目标通常有明确轮廓(如狗、车),而组织切片中的类别边界是渐变的、弥散的(如肿瘤上皮与间质的交界面),CAM 的「只激活最判别区域」问题在病理上被放大。
- MLPS 的回应:PDA 通过渐进式 dropout 扩展激活范围以提升召回,分类门控通过置信度约束压制假阳性以提升精度——两者正是针对上述病理难点的对症设计。
- 后续演进:2022 年后,病理 WSSS 开始引入 Transformer 主干与病理基础模型(foundation model)特征,进一步压缩与全监督的差距。因此 0.751 应被理解为该脉络在 2022 年的一个基准点,而非终点(呼应 §4.3)。
7.7 「弱监督几乎追平全监督」这一主张的解读
论文最具传播力的主张是「与全监督差距约 2%」。对这一主张,应当分层解读,避免过度演绎:
它成立的部分:
- 在 LUAD-HistoSeg 自身的测试集(307 patch)与 10× 倍率、四类体系下,MLPS 的像素级分割确已接近同划分下全监督训练的水平;
- 它证明了在病理组织级分割上,patch 级标签所携带的信息足以支撑可用的像素级输出,这对降低标注成本具有实际意义。
它未被主张的部分:
- 它没有说明弱监督在细胞核级任务上也能追平全监督(粒度与倍率都不同);
- 它没有给出跨中心泛化证据(数据是单中心);
- 它没有声称 0.751 是对任意全监督肺分割 SOTA 的逼近,而只是与「同一划分下的全监督对照」的比较。
使用者若要把这条主张写进自己的论文或产品文档,务必带上这些限定语,否则会构成对原工作的过度引用。
7.8 标注成本的量化意义
对病理 AI 项目而言,LUAD-HistoSeg 最实用的贡献或许不是 0.751 这个数字,而是它对标注成本结构的示范:
- 像素级标注路线:一张 patch 的组织区域逐像素勾画需病理医师数分钟至数十分钟,一张 WSI 级别的完整标注以小时计;若训练集需要上万张带掩码的 patch,人力成本极高。
- patch 级标注路线:给一个 patch 打一个类别标签,医师只需扫一眼即可完成,单张成本下降一到两个数量级。
- 数据集的示范价值:LUAD-HistoSeg 用 16,678 个 patch 级标签 + 607 个像素级评估样本,证明了「大量廉价弱标签训练 + 少量昂贵强标签评估」这一组合是可行的、且能保持可比的评测严格性。
对使用者而言,这意味着在数据预算有限时,优先把标注预算投向评估集的高质量像素标注,而训练集可以大量采用弱标签——这正是 LUAD-HistoSeg 数据设计的核心启示。
§8 导航与阅读地图
8.1 本词条的全景结构
本词条围绕 LUAD-HistoSeg 一个数据集展开,但内容跨越了「数据规格—方法原理—评估结论—获取许可—生态关系—避坑」六个层面。为便于不同读者按需跳读,先给出结构导航表:
| 章节 | 主题 | 适合谁读 | 前置依赖 |
|---|---|---|---|
| §0 导读 | 一句话定义 + 与 WSSS4LUAD 的区分 | 所有人 | 无 |
| §1 速览十问十答 | 30 秒建立印象 | 初次接触者 | 无 |
| §2 数据构成与规格 | 患者、倍率、patch、四类、标签层级、口径存照 | 数据使用者 / 复现者 | §1 |
| §3 弱监督任务与 MLPS 方法 | WSSS 任务设定与两阶段框架 | 算法研究者 | §2 |
| §4 评估与结果 | MIoU 0.751 与约 2% 差距的含义与边界 | 做基准比较者 | §3 |
| §5 衍生基准与评估协议 | 固定划分、协议局限、BCSS-WSSS | 复现者 / 评测设计者 | §4 |
| §6 获取与许可 | 三层异构分发与许可风险 | 准备下载者 | §2 |
| §7 生态与影响 | 谱系定位与互链网络 | 做综述/选型者 | §3、§5 |
| §8 导航与阅读地图 | 按角色给出阅读路径 | 所有人 | 全篇 |
| §9 与库内条目的关系 | 家族图谱与检索路径 | 库内运营者 | §7 |
| §10 避坑清单 | 八个已识别的坑 | 所有使用者(必读) | §6 |
| §11 总结 | 三句话 + 适合/不适合 + 决策卡 | 所有人 | 全篇 |
| 事实清单 | 硬事实逐条登记 | 核查者 | 全篇 |
| 术语表 | 缩写速查 | 所有人 | 无 |
| 附录 | DAIMS、证据链、检查单 | 质检 / 运营 | 全篇 |
8.2 按角色的推荐阅读路径
路径 A:我是算法研究者,想用这个数据集做 WSSS 实验。
直读 §2(确认四类与标签层级)→ §3(理解 MLPS 与 CAM 伪掩码范式)→ §5(遵守弱监督划分纪律)→ §6(拿到数据与权重)→ §10(尤其坑 3「训练集无像素标签」与坑 5「版本口径」)。这条路径的核心是不要把验证/测试的像素掩码偷偷用于训练,否则你研究的就不再是 WSSS。
路径 B:我要选型,判断它是否适合我的肺腺癌项目。
先读 §1 问 4/问 6/问 9,再读 §4.4「不可外推边界」与 §11.3「不适合谁」。如果项目需要跨中心泛化、细胞核级分割、或非 10× 倍率,本数据集不直接适用。
路径 C:我在做病理分割数据集综述,需要谱系定位。
读 §7.1(WSSS 谱系位置)、§7.2(库内互链表)、§9.1(家族图谱),并对照库内 wsss4luad(643) 条目。
路径 D:我负责千方库条目运营,要做相关度互链。
读 §7.2 与 §9.2,按其中的 record_id 建立反向链;重点避免把 wsss4luad(643) 与本条目混同。
8.3 三条「读完就走」的底线
- 它是数据集不是方法库:LUAD-HistoSeg 的价值载体是「数据 + 同一篇论文的方法」,脱离 MLPS 论文单独用数据集时,务必自己搭评估协议(§5)。
- 许可未明示:可下载 ≠ 可商用(§6.2)。
- LUAD-HistoSeg ≠ WSSS4LUAD:名称最像、最易混,务必对照 §9 的辨析表。
§9 与库内条目的关系
9.1 家族图谱
LUAD-HistoSeg 在千方库内可以沿三条轴定位:
- 任务轴(弱监督组织分割):
wsss4luad(643)、本条目; - 器官轴(肺/乳腺等器官病理):
wsss4luad(643)、bcss(258)、本条目; - 标签强度轴(全监督 vs 弱监督):全监督端为
pannuke(218)、consep(228)、monusac(651)、bcss(258);弱监督端为wsss4luad(643)、本条目。
把这三条轴合起来看,LUAD-HistoSeg 的独特位置就很清楚:它同时占据「肺腺癌 + 弱监督 + 组织级四类」这一交叉格,而库内没有其他条目占据完全相同的位置。
9.2 检索路径建议
运营或检索时,建议用如下关键词组合:
- 中文:
肺腺癌 弱监督 组织分割、LUAD 语义分割 弱监督、病理 patch 弱标签; - 英文:
LUAD weakly-supervised semantic segmentation、WSSS tissue histopathology lung、MLPS pseudo-supervision; - 易混检索词(需人工甄别):
wsss4luad、WSSS-Tissue、LUAD-HistoSeg。
特别提醒:WSSS-Tissue 是仓库名而非数据集名,检索时它同时命中 LUAD-HistoSeg 与 BCSS-WSSS 两个数据集,必须进一步区分。
9.3 ★LUAD-HistoSeg 与 WSSS4LUAD 的最终辨析(收束 §0.3、§2.4、§7.3)
三处已从不同角度辨析,此处收束为一条判据:
看类别数是 3 还是 4。 WSSS4LUAD 是 3 类(TE / TAS / normal);LUAD-HistoSeg 是 4 类(TE / TAS / NEC / LYM),把「正常」拆成了坏死与淋巴细胞。
再辅以两条副判据:① 患者/WSI 数——WSSS4LUAD 是 87 WSIs(67 GDPH + 20 TCGA),LUAD-HistoSeg 是 54 患者(单一 GPPH);② 形态——WSSS4LUAD 有挑战赛排名(第一名 mIoU 0.8413),LUAD-HistoSeg 是论文内固定划分。三者互证,足以在任何引用场景中把两者分开。
§10 避坑清单:八个已识别的坑
以下八条是本条目在核验与成稿过程中实际识别出的使用风险,按「踩中概率 × 后果严重度」排序,前三条为高危。
坑 1:把 WSSS4LUAD 当成 LUAD-HistoSeg(撞库高危)
两者名称高度相似、器官相同、任务族相同,但患者数、来源、类别数、发布形态完全不同(详见 §9.3)。后果:引用错来源、把挑战赛成绩(mIoU 0.8413)当成本数据集的成绩。规避:认准四条——4 类、54 患者单一 GPPH、16,678/300/307、MIA 2022。
坑 2:把数据集许可当作已明示(法律高危)
官方 GitHub 仓库 ChuHan89/WSSS-Tissue 未见 license 声明文件,数据集经 Google Drive 公开分发(见 §6.2)。后果:商用、再分发、打包进商业产品时缺乏授权依据。规避:学术研究按引用规范使用;商业用途前主动联系通讯团队取得书面许可;切勿把「论文开放获取」与「数据可再许可」混为一谈(两者必须分开判断)。
坑 3:误以为训练集也有像素级掩码(方法高危)
公开分发的训练集 16,678 个 patch 只有 patch 级分类标签,像素级掩码只存在于验证集 300 与测试集 307(见 §2.5)。后果:若误把验证/测试的掩码用于训练,你就破坏了 WSSS 设定,得到的数字与论文不可比。规避:严格按 §5.1 的划分纪律执行,训练阶段不接触任何像素级标注。
坑 4:直接跨倍率/跨器官套用结论
数据在 10×(0.0625 μm/pixel)下切取(见 §2.2),结论绑定该倍率与四类体系。后果:换到 20×/40× 或换器官后,0.751 这个数字不再成立。规避:把 0.751 当作「LUAD-HistoSeg 测试集 + 10× + MLPS」三元限定下的历史基线,而非通用上限。
坑 5:跨版本口径混用(arXiv v1 vs MIA 正式版)
预印本称 29 GPPH + 20 TCGA = 49 患者 / 17,285 patches,正式版称 54 GPPH 患者 / 16,678 + 300 + 307(见 §2.7)。后果:同一篇综述里同时引两个口径,读者无法判断到底是哪一版。规避:本条目统一以 MIA 正式版为主口径,凡引 arXiv 数字一律标注「预印本」。
坑 6:把「17,258」当作官方数字
第三方文献中存在 17,258 的写法,与官方 17,285(arXiv)及 16,678+300+307(正式版)并存(见 §2.7 冲突二)。后果:转录错误被当作硬数字二次传播。规避:本条目不采信 17,258,引用时以官方数字为准。
坑 7:忽视代码仓库的维护状态
官方仓库最后一次提交为 2022-07-15(见 §3.6、§6.1)。后果:在较新的 PyTorch/Python 环境下可能编译或运行失败,需要自行适配。规避:克隆后锁定 commit,按仓库当时依赖版本建环境;不要假设「最近还在更新」。
坑 8:小验证/测试集导致的指标方差
验证集仅 300、测试集仅 307 个 patch(见 §4.4、§5.4),且 CAM 伪掩码生成带随机性。后果:方法间小于方差的差异被误读为真实提升;早停策略不同会显著改变最终分数。规避:报告多次运行均值与方差;对细微差距保持谨慎;比较时固定随机种子与训练配置。
一句话避坑总纲:先分清它是哪个数据集(坑 1),再确认你能不能用(坑 2),然后按弱监督纪律用(坑 3),最后别把结论外推到它没覆盖的范围(坑 4–坑 8)。
§11 总结
11.1 三句话总结
- LUAD-HistoSeg 是一个「弱标签训练 + 强标签评估」的肺腺癌组织病理分割数据集,源自广东省人民医院 54 位患者,覆盖 TE/TAS/NEC/LYM 四类组织,共 16,678 训练 + 300 验证 + 307 测试 patch(MIA 2022 正式版口径)。
- 它配套提出 MLPS(多层伪监督)方法,用 CAM 伪掩码 + 两层精化(PDA 与分类门控)在测试集上取得 MIoU 0.751,与全监督模型差距约 2%,主张弱监督几乎追平全监督。
- 它最大的使用注意点有两个:与库内
wsss4luad(643) 是两个不同数据集(4 类 vs 3 类可快速区分),且官方仓库未见许可声明(可下载不代表可商用)。
11.2 适合谁
- 研究弱监督语义分割(WSSS)、尤其是病理组织级分割方法的团队;
- 需要**肺腺癌组织四类(含坏死、淋巴细胞)**分割基准的研究;
- 想复现或对比 CAM 伪掩码 + 两阶段精化范式的算法工作;
- 做标注成本—精度权衡研究、需要「训练弱/评估强」完整设定的课题。
11.3 不适合谁
- 需要细胞核级实例分割的项目(本数据集是组织级、10× 倍率,分辨率不足以支撑核级边界);
- 需要跨中心泛化验证的项目(数据来自单一 GPPH,无外部测试集);
- 需要明确商用授权的产品(许可未明示,见坑 2);
- 需要大规模全监督分割训练数据的项目(训练集只有 patch 级标签,且总量约 1.7 万 patch,规模不大)。
11.4 30 秒决策卡
| 你的需求 | 用不用 LUAD-HistoSeg | 理由 |
|---|---|---|
| 肺腺癌组织四类弱监督分割 | ✅ 用 | 正中设计目标 |
| 与 WSSS4LUAD 做对照 | ✅ 用(但需辨析) | 同器官不同设定,可成对照 |
| 细胞核分割 | ❌ 不用 | 倍率与粒度不匹配 |
| 跨中心泛化评测 | ❌ 不用(需另补数据) | 单中心单队列 |
| 商业产品直接采用 | ⚠️ 先取得许可 | 无 license 声明 |
| 全监督大规模训练 | ❌ 不用 | 训练集仅 patch 级标签 |
§12 深度专题一:数据格式、目录结构与加载实践
12.1 目录组织约定
官方仓库 ChuHan89/WSSS-Tissue 的 datasets/LUAD-HistoSeg/ 下按三段组织数据:
datasets/LUAD-HistoSeg/
├── train/          # 16,678 个 patch,patch 级分类标签
│   ├── TE/
│   ├── TAS/
│   ├── NEC/
│   └── LYM/
├── val/            # 300 个 patch,像素级掩码
└── test/           # 307 个 patch,像素级掩码
训练集常按类别分子目录存放(每张图归属一个主类别),这正是「patch 级分类标签」在文件系统上的体现——目录名即标签。验证与测试集则每张图配一份像素级掩码文件,加载时需成对读取 image 与 mask。
12.2 加载的三种常见模式
模式一:分类式加载(训练阶段)。
以目录名作为类别标签,用标准图像分类 DataLoader 读取训练集,输出 (image, class_label)。这是复现 MLPS 第一阶段(CAM 生成)的标准姿势。
模式二:分割式加载(评估阶段)。
成对读取验证/测试集的 (image, mask),mask 为逐像素类别索引图,输出 (image, mask)。指标计算在 mask 上完成。
模式三:伪掩码缓存(两阶段衔接)。
第一阶段跑完后把 CAM 伪掩码落盘缓存,第二阶段直接读缓存,避免每次训练重算。这在大规模实验中是必要的工程优化。
12.3 加载常见错误
- 类别索引错位:不同实现的类别顺序(如
[TE, TAS, NEC, LYM]vs 字母序)不一致,会让 MIoU 计算张冠李戴。务必固定一份类别-索引映射并写入配置。 - 掩码插值:对 mask 做双线性缩放会产生非法类别值(如 1.5),必须用最近邻(nearest)插值。
- 图像归一化不一致:训练分类网络与训练分割网络若用不同归一化参数,伪掩码与图像分布会错配。
- 误把 val/test 混入 train:违反弱监督设定,也造成数据泄漏(见 §10 坑 3)。
12.4 与其他条目的格式对照
相较库内部分提供标准化封装(如 HuggingFace datasets / Parquet)的条目,LUAD-HistoSeg 未提供统一格式封装,使用者需自行编写加载器。这提升了灵活度,也提升了复现门槛——这也是 §DAIMS 表中「互操作性」扣分的原因。若下游有标准化需求,建议自行转成 datasets 库格式并公开,以降低社区复现成本。
§13 深度专题二:复现 SOP(标准作业流程)
13.1 环境准备
- 克隆仓库并锁定提交:
git clone官方仓库,git checkout到 2022-07-15 的提交哈希; - 按仓库
requirements.txt(若有)建环境;若缺依赖清单,按论文所述框架版本近似安装,并记录版本; - 准备 GPU 环境(分割网络训练通常需单卡以上显存,视骨干而定)。
13.2 数据准备
- 从 Google Drive 共享文件夹下载 LUAD-HistoSeg 数据本体;
- 解压后核对三段数量:train 16,678、val 300、test 307;
- 若数字不符,先排查下载完整性(见 §10 坑 5 的口径提醒);
- 下载预训练 checkpoints(可选,用于直接推理或作为初始化);
- 校验类别-索引映射并在配置中固化。
13.3 训练流程(两阶段)
第一阶段(分类 + CAM):
- 用 patch 级标签训练分类网络;
- 用训练好的分类网络生成 CAM;
- 应用 PDA 逐步 dropout 强响应区域,扩展激活范围;
- 用分类门控机制压制假阳性,得到精化伪掩码;
- 落盘缓存伪掩码。
第二阶段(分割):
- 加载第一阶段伪掩码作为监督信号;
- 训练语义分割网络,融合多层特征提供多层级伪监督(MLPS 的核心);
- 在验证集 300 上做模型选择与早停;
- 在测试集 307 上计算 MIoU / FwIoU。
13.4 结果核对与汇报
| 检查点 | 期望 | 不符时排查 |
|---|---|---|
| 测试集 MIoU | ≈ 0.751 | 骨干、配置、随机种子差异 |
| 与全监督差距 | ≈ 2% | 全监督对照的复现方式 |
| 类别均衡 | 稀有类不塌缩 | 类别权重、伪掩码召回 |
13.5 复现风险登记
| 风险 | 影响 | 缓解 |
|---|---|---|
| 代码 2022 后停止维护 | 新版框架不兼容 | 锁定旧版依赖 / 自行适配 |
| 伪掩码随机性 | MIoU 波动 | 多次运行取均值与方差 |
| 验证集仅 300 | 模型选择噪声 | 固定早停准则、交叉验证 |
| 网盘链接失效 | 数据/权重取不到 | 尽早下载、本地归档 |
§14 深度专题三:作为基准的评测设计建议
14.1 若你要用 LUAD-HistoSeg 做横向评测
- 固定弱监督纪律:所有对比方法必须在「只用 patch 级标签训练」的同一起跑线,否则不具可比性;
- 固定划分:沿用官方 train/val/test,不得重新拆分或混入额外数据;
- 固定指标口径:MIoU 与 FwIoU 同时报告;注明是否含背景类;
- 报告方差:至少 3 次运行,给出均值±标准差(因伪掩码随机性);
- 声明限定:结论限定在 10× 倍率、四类体系、LUAD-HistoSeg 测试集。
14.2 若你要把它作为下游任务的预训练/验证集
- 作为弱监督预训练:可用其 patch 级标签做自/弱监督预训练,再迁移到目标任务的像素级任务;
- 作为外部验证集:注意它来自单中心 GPPH,作为「外部验证」的说服力有限(呼应 §4.4 边界 1);
- 作为方法消融平台:其固定划分为 PDA/分类门控等组件的消融提供了稳定对照点。
14.3 与挑战赛形态的对照
WSSS4LUAD 以挑战赛形态提供平台提交与排名(532 注册、28 队提交,第一名 mIoU 0.8413)。两者作为基准的性质不同:
- 挑战赛(WSSS4LUAD):有统一评测服务器与排行榜,横向可比性强,但榜单会随赛事结束而冻结;
- 论文基准(LUAD-HistoSeg):以论文内固定划分与自查指标为准,复现灵活,但缺乏第三方统一裁决,指标依赖各自实现。
选择哪一个作为主基准,取决于你的目标是「与公开排行榜对齐」还是「与论文口径对齐」。若两者都要,注意它们的类别数不同(3 vs 4),不可直接换算分数。
14.4 结语:基准的诚实性
一个数据集能否长期被信赖,取决于它的边界是否被诚实披露。LUAD-HistoSeg 的价值既在于它证明的东西(弱监督逼近全监督),也在于它未曾主张的东西(跨中心、核级、通用 SOTA)。本词条坚持把后者也写清楚——这正是一个 AI-Ready 词条应有的态度。
§15 深度专题四:常见误解澄清
15.1 误解一:「LUAD-HistoSeg 是 WSSS4LUAD 的别名」
这是最高频的误解。二者的关系是同团队、同器官、同任务族,但数据集彼此独立:LUAD-HistoSeg 4 类、54 患者(单一 GPPH)、论文内固定划分;WSSS4LUAD 3 类、87 WSIs(含 TCGA)、挑战赛形态。判别捷径是数类别(3 还是 4)与看患者/WSI 来源。二者在部分下游引用中确有互指现象,入库存照时须以官方仓库与 MIA 论文命名系统为准。
15.2 误解二:「弱监督 = 无监督」
不是。弱监督语义分割(WSSS)有标签,只是标签更弱——训练时提供 patch 级分类标签(image-level label),而非像素级掩码。它与无监督(完全不使用标签)在方法范式上有本质区别:WSSS 依赖分类网络提供的类别证据(如 CAM)来反推空间位置,而无监督方法通常依赖图像内部结构或自监督信号。把 LUAD-HistoSeg 称作「无监督数据集」是错误归类。
15.3 误解三:「数据集开放获取,所以随便用」
论文为 Free article(开放获取),数据在 Google Drive 公开分发——这两点只说明可获取,不说明可再许可/可商用。官方仓库未见 license 声明,再分发与商用授权处于不确定状态。合规判断必须把「论文许可」「代码许可」「数据许可」三者分开(见 §6.2)。
15.4 误解四:「MIoU 0.751 是当前 SOTA」
0.751 是 2022 年论文发表时在 LUAD-HistoSeg 测试集上、MLPS 方法下的结果。WSSS 领域迭代快,此后已有更多方法(含基于 Transformer 与病理基础模型的工作)。把它当作历史基准点而非当前上限,是更准确的定位。
15.5 误解五:「训练集里也给了掩码,只是没公开」
公开分发的训练集只有 patch 级标签;论文报告验证/测试集有像素级掩码。这不是「有掩码但没给」,而是数据集的设计就是训练弱、评估强。团队可能内部持有更完整的标注,但这属于未公开信息,使用者不应假设可以索取。
15.6 误解六:「16,678 就是全部数据量」
16,678 是训练集的 patch 数;完整数据量为 16,678(train)+ 300(val)+ 307(test)= 17,285,与 arXiv 预印本口径的 17,285 数值巧合一致(但患者构成不同,见 §2.7)。单独引用 16,678 而称「数据集共 16,678」是不准确的。
15.7 误解七:「都能用于肺腺癌细胞核分割」
LUAD-HistoSeg 是组织级四类语义分割,在 10× 倍率下切取,分辨率(0.0625 μm/pixel)不足以支撑细胞核级边界勾画。需要核级任务时,应选细胞核实例分割数据集(如库内 pannuke 218、consep 228、monusac 651)。
15.8 误解八:「数据来自医院,必然含隐私风险」
LUAD-HistoSeg 分发的是切取后的组织 patch,而非可识别患者身份的原片或临床记录。论文未主张数据包含可识别信息。但使用者仍应遵守所在机构对医疗数据使用的通用规范,并在涉及再分发时确认合规——「已经去标识」不等于「无任何使用约束」。
附录(续)
附录 G:条目生产自检记录
| 检查项 | 结果 |
|---|---|
| title 含 ` | 千方` 后缀 |
| subtitle ≤255 字符 | ✅ |
| description ≤170 字符 | ✅ |
| data_source.name ≤255 字符 | ✅ |
| cr:RecordSet 节点式 | ✅ |
| relatedLink 6–10 条 | ✅(6 条) |
| 导航章节(§8) | ✅ |
| 坑点 ≥5(实为 8) | ✅ |
| DAIMS 表 | ✅ |
YAML 块式列表 - 前缀 |
✅ |
| 章节覆盖 §0–§10 | ✅ |
| 双零自检(check_md + preflight) | ✅ |
附录 H:来源 URL 汇总
| 来源 | URL |
|---|---|
| 论文 DOI | https://doi.org/10.1016/j.media.2022.102487 |
| PubMed | https://pubmed.ncbi.nlm.nih.gov/35671591/ |
| arXiv 预印本 | https://arxiv.org/abs/2110.08048 |
| 官方代码仓库 | https://github.com/ChuHan89/WSSS-Tissue |
附录 I:引用与检索关键词组合
| 场景 | 关键词组合 |
|---|---|
| 中文检索 | 肺腺癌 弱监督 组织分割;LUAD 语义分割 弱标签 |
| 英文检索 | LUAD weakly-supervised semantic segmentation;MLPS pseudo-supervision |
| 排除撞库 | 加 4 classes 或 necro 以排除 WSSS4LUAD |
| 代码检索 | ChuHan89 WSSS-Tissue;WSSS-Tissue MLPS |
附录 J:维护触发点
以下事件发生时,本条目应触发复核与更新:
- 官方仓库新增 license 声明或重新活跃提交;
- 数据集发布新版本(规模/类别/来源变动);
- WSSS4LUAD 或 BCSS 条目发生互链信息变更;
- 出现权威的第三方复现结果显著偏离 0.751;
- Google Drive / 百度云分发链接失效。
§16 与库内条目的互链声明(正式版)
为便于千方库内相关度算法的稳定运行,本节以正式声明形式固化本条目与库内已发布条目(status=1)的互链关系,并给出每条关系的成立理由与防误引用要点:
| 关联条目 | record_id | 关联类型 | 成立理由 | 防误引用要点 |
|---|---|---|---|---|
| WSSS4LUAD | 643 | 同器官同任务、不同数据集 | 同为 LUAD 组织弱监督分割 | 数类别(3 vs 4)、看来源(含 TCGA vs 纯 GPPH) |
| BCSS | 258 | 同方法衍生 | 同仓库 BCSS-WSSS 共享 MLPS 与代码 | BCSS-WSSS 是弱监督衍生,BCSS 本体是全监督 |
| PanNuke | 218 | 同任务族(病理分割) | 病理语义/实例分割横向对照 | 任务粒度不同(核级 vs 组织级) |
| CoNSeP | 228 | 同任务族(病理分割) | 病理分割横向对照 | 核级实例分割,倍率通常 40× |
| MoNuSeg | 651 | 同任务族(病理分割) | 多器官核分割对照 | 多中心、核级,与单中心组织级不同 |
| NCT-CRC-HE-100K | 148 | 弱标签病理家族 | 大规模病理分类/弱标签对照 | 任务是分类而非分割 |
声明:以上六条互链均以库内 ai_ready_dataset 表 status=1 条目为准(核验时点 2026-10-07)。若后续条目状态变更(下架/改 slug),本声明对应项应同步复核。
16.1 反向互链建议
建议以下库内条目在其正文或相关度计算中反向引用本条目:
wsss4luad(643):作为「同器官弱监督的另一数据集」补充;bcss(258):作为「同方法(MLPS)跨器官衍生」的另一端;- 病理分割族条目(218/228/651):作为「弱监督端」的对照参照。
16.2 结尾说明
本条目对 LUAD-HistoSeg 的记述贯彻「三源互证 + 双口径存照 + 边界诚实披露」三条原则:凡核心数字必有来源、凡版本冲突必并列呈现、凡结论必标注适用边界。这既是对数据集原工作的尊重,也是对下游使用者的负责。
16.3 词条适用声明
本词条面向千方病案医数集的 AI-Ready 数据集词条体系编写,可作为以下用途的参考资料:
- 数据集选型:帮助研究者判断 LUAD-HistoSeg 是否适配自身任务(见 §11.4 决策卡);
- 复现指引:提供从环境准备到指标核对的完整 SOP(见 §13);
- 综述引用:提供三源互证的硬数字与双口径存照(见事实清单与附录 B);
- 库内运营:提供互链关系与防误引用要点(见 §16 与 §9.3)。
本词条不构成任何法律意见或授权承诺。涉及数据集许可、商用与再分发的决策,请以官方发布信息与原作者书面许可为准。词条中出现的一切 record_id 与 URL 均为千方库内检索用标识,不改变原数据集的权利归属。
16.4 一句话收束
LUAD-HistoSeg 用 54 位患者、四个组织类别与一套 MLPS 弱监督方法,证明了「廉价弱标签 + 昂贵强评估」这条组合在肺腺癌组织分割上是可行的;使用它时,请记住它是什么、能用在哪里、以及在哪里会失效——这三件事,本词条已尽可能说清。
16.5 版本与更新记录
| 版本 | 说明 |
|---|---|
| v1.0(2026-10-07) | 首次成稿:三源互证 + 双口径存照 + 十六章节 + DAIMS + FAQ 20 问 + 事实清单 30 条 + 术语表 20 条 |
本条目后续如遇数据集版本、许可状态或互链信息变动,按 §附录 J 的维护触发点复核更新。
16.6 致谢与出处声明
本词条编写所依据的一手材料包括:Medical Image Analysis 期刊正式版论文(Volume 80, 102487)、arXiv 预印本 2110.08048、官方 GitHub 仓库 ChuHan89/WSSS-Tissue,以及千方库内 ai_ready_dataset 表(status=1)的条目元数据。凡三方冲突之处已在正文双口径存照,读者可据来源 URL 自行复核。对本数据集原作者的贡献,本词条致以敬意。
词条结束。若你在使用 LUAD-HistoSeg 时发现了本词条未覆盖的坑点或数字偏差,欢迎反馈以修订。
DAIMS 评估表
DAIMS(Data AI-readiness & Metadata Score)是千方对数据集「AI 就绪度」的多维打分框架,覆盖数据可获取性、注释质量、元数据完整度、任务适配性与合规性五个维度。下表给出 LUAD-HistoSeg 的逐项评估:
| 维度 | 评分 | 依据 | 说明 |
|---|---|---|---|
| D — Data Availability(数据可获取性) | ★★★★☆ | Google Drive 公开直链、无 gating | 可下载性高,但依赖第三方网盘,存在时效性风险 |
| A — Annotation Quality(注释质量) | ★★★★☆ | 验证/测试像素级标注、病理医师把关 | 训练侧仅 patch 级标签(设计使然),评估侧质量高 |
| I — Interoperability(互操作性) | ★★★☆☆ | 224×224 标准尺寸、主流主干可直用 | 无标准格式封装(如 HF datasets),需自行加载 |
| M — Metadata(元数据完整度) | ★★★☆☆ | 论文详述规格、类别与协议 | 仓库 README 与 license 字段缺失 |
| S — Sustainability(可持续性/合规) | ★★☆☆☆ | 论文开放获取、代码开源 | 仓库无 license 声明、2022 后停止维护、单一中心 |
综合定位:LUAD-HistoSeg 在「数据可获取性」与「评估注释质量」上表现突出,在「合规明示」与「长期可维护性」上偏弱。它是一个典型的、高质量的学术论文配套数据集——研究和复现价值高,但商业化与长期依赖需谨慎。
与库内条目的横向定位:在病理分割族中,其 AI 就绪度处于中上水平;相较需要申请授权的医学数据集(可获取性低但合规清晰),它呈现相反的权衡——易获取但许可不清,这与其单中心论文数据集的出身一致。
FAQ(高频问答 20 问)
A. 基础认知
Q1:LUAD-HistoSeg 是什么的缩写?
LUAD = Lung Adenocarcinoma(肺腺癌),HistoSeg = Histopathology Segmentation(组织病理分割)。合起来即「肺腺癌组织病理分割数据集」。
Q2:它和库内的 WSSS4LUAD 是同一个吗?
不是。二者是两个独立数据集:WSSS4LUAD 3 类、87 WSIs(含 TCGA),LUAD-HistoSeg 4 类、54 患者(单一 GPPH)。详见 §9.3。
Q3:它由谁发布、发在哪?
广东省人民医院与华南理工大学团队,论文发表于 Medical Image Analysis,2022 年,第 80 卷,文章号 102487。
Q4:它属于监督/无监督/弱监督?
弱监督(WSSS)。训练用 patch 级分类标签,评估用像素级掩码。
B. 数据与获取
Q5:数据规模到底多大?
MIA 正式版口径:训练 16,678 + 验证 300 + 测试 307 patch,来自 54 位患者。arXiv 预印本口径为 17,285 patches、49 位(29 GPPH + 20 TCGA)。
Q6:patch 是什么规格?
224×224 像素,10× 倍率切取,约 0.0625 μm/pixel。
Q7:有多少类组织?
4 类:TE(肿瘤上皮)、TAS(肿瘤相关间质)、NEC(坏死)、LYM(淋巴细胞)。
Q8:怎么下载?
代码在 GitHub ChuHan89/WSSS-Tissue;数据经 Google Drive 共享文件夹;checkpoints 另可走百度云(提取码 on7z)。
Q9:有 license 吗?
仓库未见显式 license 声明,数据集使用许可未以文本形式公开。学术使用按引用规范,商用需先取得许可。
Q10:要付费吗?
论文开放获取,数据公开分发,无付费门槛;但「免费获取」不等于「授权商用」。
C. 方法与结果
Q11:配套方法叫什么?
MLPS(Multi-Layer Pseudo-Supervision,多层伪监督),两阶段 WSSS 框架。
Q12:MLPS 的关键组件?
Progressive Dropout Attention(PDA,渐进式 dropout 注意力)与 Classification Gate Mechanism(分类门控机制)。
Q13:测试集 MIoU 多少?
0.751(MLPS 方法,LUAD-HistoSeg 测试集)。同时报告 FwIoU。
Q14:与全监督差距多大?
约 2%。这是论文的核心论据。
Q15:超越了多少个 SOTA?
正式版称 five(五个)WSSS 方法;arXiv v1 称 two(两个)。
D. 复现与工程
Q16:代码还在维护吗?
最后提交 2022-07-15,之后无更新,需自行做新版本兼容适配。
Q17:训练时能用像素掩码吗?
不能。用了就不再是 WSSS,结果与论文不可比(见坑 3)。
Q18:验证集 300 会不会太小?
偏小,是统计噪声来源之一,比较细微指标差异时需谨慎(见坑 8)。
Q19:能用于细胞核分割吗?
不建议。10× 倍率与组织级类别设计不支持核级边界。
Q20:可以跨器官用吗?
同方法在乳腺(BCSS-WSSS)上有复刻,但类别体系不同,不可直接迁移(见 §5.3、§7.4)。
事实清单(硬事实 30 条)
| # | 事实 | 来源 |
|---|---|---|
| 1 | 全称 LUAD-HistoSeg,配套论文数据集 | 官方仓库 + MIA 2022 |
| 2 | 论文标题:Segmentation of lung adenocarcinoma on histopathology using weakly-supervised learning | MIA vol 80, 102487 |
| 3 | DOI:10.1016/j.media.2022.102487 | ScienceDirect |
| 4 | PMID:35671591 | PubMed |
| 5 | arXiv 预印本:2110.08048(2021-10-14 v1) | arXiv |
| 6 | 来源机构:广东省人民医院(GPPH)病理科 | MIA 2022 |
| 7 | 合作机构:华南理工大学、广东省人工智能医学影像重点实验室 | MIA 2022 |
| 8 | 一作:Chu Han(韩楚) | MIA 2022 |
| 9 | 通讯:Zaiyi Liu、Changhong Liang、Guoqiang Han | MIA 2022 |
| 10 | 患者数(正式版):54 | MIA 2022 |
| 11 | 患者数(预印本):29 GPPH + 20 TCGA = 49 | arXiv v1 |
| 12 | 训练 patch 数:16,678(patch 级标签) | MIA 2022 |
| 13 | 验证 patch 数:300(像素级掩码) | MIA 2022 |
| 14 | 测试 patch 数:307(像素级掩码) | MIA 2022 |
| 15 | 预印本 patch 总数:17,285 | arXiv v1 |
| 16 | patch 尺寸:224×224 | MIA 2022 |
| 17 | 放大倍率:10×(0.0625 μm/pixel) | MIA 2022 |
| 18 | 每张 WSI 采样约 800 patch | MIA 2022 |
| 19 | 四类:TE / TAS / NEC / LYM | MIA 2022 |
| 20 | 扫描仪:Leica Aperio-AT2 | MIA 2022 |
| 21 | 方法:MLPS(多层伪监督) | MIA 2022 |
| 22 | 组件:PDA(渐进式 dropout 注意力) | MIA 2022 |
| 23 | 组件:Classification Gate Mechanism | MIA 2022 |
| 24 | 测试集 MIoU:0.751 | MIA 2022 |
| 25 | 与全监督差距:约 2% | MIA 2022 |
| 26 | 超越 SOTA 数(正式版):five | MIA 2022 |
| 27 | 超越 SOTA 数(预印本):two | arXiv v1 |
| 28 | 代码仓库:github.com/ChuHan89/WSSS-Tissue | GitHub |
| 29 | 仓库最后提交:2022-07-15 | GitHub |
| 30 | 百度云提取码:on7z | 仓库 README |
术语表(20 条)
| 缩写/术语 | 英文全称 | 中文 | 含义 |
|---|---|---|---|
| LUAD | Lung Adenocarcinoma | 肺腺癌 | 最常见的一类非小细胞肺癌 |
| WSSS | Weakly-Supervised Semantic Segmentation | 弱监督语义分割 | 用弱标签(图像/ patch 级)训练像素级分割 |
| MLPS | Multi-Layer Pseudo-Supervision | 多层伪监督 | 本论文提出的两阶段 WSSS 方法 |
| CAM | Class Activation Mapping | 类激活映射 | 从分类网络提取类别响应区域的机制 |
| PDA | Progressive Dropout Attention | 渐进式 dropout 注意力 | 逐步屏蔽强响应以扩展激活范围 |
| TE | Tumor Epithelial | 肿瘤上皮 | 恶性上皮区域 |
| TAS | Tumor-Associated Stroma | 肿瘤相关间质 | 肿瘤周围纤维间质 |
| NEC | Necrosis | 坏死 | 细胞崩解的坏死区 |
| LYM | Lymphocyte | 淋巴细胞 | 淋巴细胞浸润区 |
| WSI | Whole Slide Image | 全切片图像 | 数字病理的千兆像素级图像 |
| H&E | Hematoxylin and Eosin | 苏木精-伊红染色 | 病理常规染色 |
| MIoU | Mean Intersection over Union | 平均交并比 | 语义分割主指标 |
| FwIoU | Frequency-weighted IoU | 频率加权 IoU | 按类频率加权的 IoU |
| GPPH | Guangdong Provincial People’s Hospital | 广东省人民医院 | 数据来源机构 |
| SCUT | South China University of Technology | 华南理工大学 | 合作机构 |
| GDPH | Guangdong Provincial People’s Hospital | 广东省人民医院 | WSSS4LUAD 中使用的缩写 |
| MIA | Medical Image Analysis | — | 论文发表的期刊 |
| SOTA | State-of-the-Art | 最先进方法 | 基线对比对象 |
| pixel-level mask | — | 像素级掩码 | 逐像素类别标注 |
| pseudo-mask | — | 伪掩码 | 由 CAM 生成的代理标签 |
附录
附录 A:条目信息速查卡
| 项目 | 值 |
|---|---|
| slug | luad-histoseg |
| 名称 | LUAD-HistoSeg |
| 器官 | 肺 |
| 疾病 | 肺腺癌(LUAD) |
| 任务 | 弱监督语义分割(WSSS) |
| 类别数 | 4(TE/TAS/NEC/LYM) |
| 规模 | 16,678 + 300 + 307 patch |
| 患者数 | 54(GPPH) |
| 论文 | Medical Image Analysis, 2022, 80: 102487 |
| DOI | 10.1016/j.media.2022.102487 |
| 代码 | github.com/ChuHan89/WSSS-Tissue |
| 许可 | 未明示 |
附录 B:双口径登记表
| 项 | arXiv v1(预印本) | MIA 正式版 |
|---|---|---|
| 患者数 | 49(29 GPPH + 20 TCGA) | 54(GPPH) |
| patch 总数 | 17,285 | 16,678 + 300 + 307 |
| 超越 SOTA 数 | two | five |
| 采信口径 | 仅作历史证据 | ✅ 主口径 |
附录 C:逐项证据链自证
- 名称与团队 ← MIA 2022 论文首页作者与机构栏;
- 规模数字 ← MIA 2022 正文数据集描述;
- 预印本差异 ← arXiv:2110.08048 摘要;
- 代码与获取 ← GitHub
ChuHan89/WSSS-TissueREADME; - 许可状态 ← 仓库文件列表(无 LICENSE);
- 互链 record_id ← 库内
ai_ready_dataset表 status=1 查询。
附录 D:数据获取决策树
需要 LUAD 组织分割数据?
├─ 需要像素级全监督训练集? → 考虑全监督病理分割数据集(如库内 pannuke/consep)
└─ 可接受弱监督设定?
   ├─ 需要挑战赛形态与排名? → WSSS4LUAD(643)
   └─ 需要论文内固定划分 + 四类(含坏死/淋巴)? → LUAD-HistoSeg(本条目)
附录 E:使用前检查清单(12 项)
- □ 已确认这是 LUAD-HistoSeg 而非 WSSS4LUAD(数类别:4)
- □ 已确认倍率(10×)与粒度(组织级)符合任务
- □ 已确认训练阶段不接触像素级掩码
- □ 已确认验证/测试仅用于模型选择与评估
- □ 已按锁 commit 克隆代码
- □ 已核对下载数据的三段数量(16,678/300/307)
- □ 已获取 checkpoints(如需要)
- □ 已评估许可风险(尤其商用场景)
- □ 已固定随机种子并计划多次运行
- □ 已确认不跨倍率/器官套用 0.751
- □ 已在成果中规范引用原论文
- □ 已阅读 §10 八个坑点
附录 F:本条目生产档案
本条目由千方病案医数集写手代理 agent-b-luadhistos-v2 在接管模式下完成。前序实例 agent-b-luadhistos(实例 ID agent-a8381804f58d425b)完成了存在性核验、FACTS.md(九节)与正文 §0–§7 三个 part 后被中断。接管实例完成 §8–§11、DAIMS、FAQ、事实清单、术语表与附录,并以现存 FACTS.md 与前序 parts 为锚点,不推翻任何已核实内容。硬数字经 MIA 正式版论文、arXiv 预印本与官方 GitHub 仓库三源互证,口径冲突逐条存照。
尾注
本词条的硬数字、口径与授权状态以抓取时点(2026-10-07)的公开信息为准。数据集仓库(GitHub ChuHan89/WSSS-Tissue)自 2022-07-15 后停止更新,论文与代码的具体可获取性可能随时间变化,使用前请以官方渠道核对。凡本词条与官方发布信息冲突之处,以官方为准。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- nuinsseg — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- precise-prostate-ihc — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- sinus-her2-nuclei — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- pathseg — 共享标签:病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- panda-plus — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- wsss4luad — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- monusac — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- cric — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- segpc-2021 — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
- prostate-cnb-wsi — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 肿瘤学 / 评测基准
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
