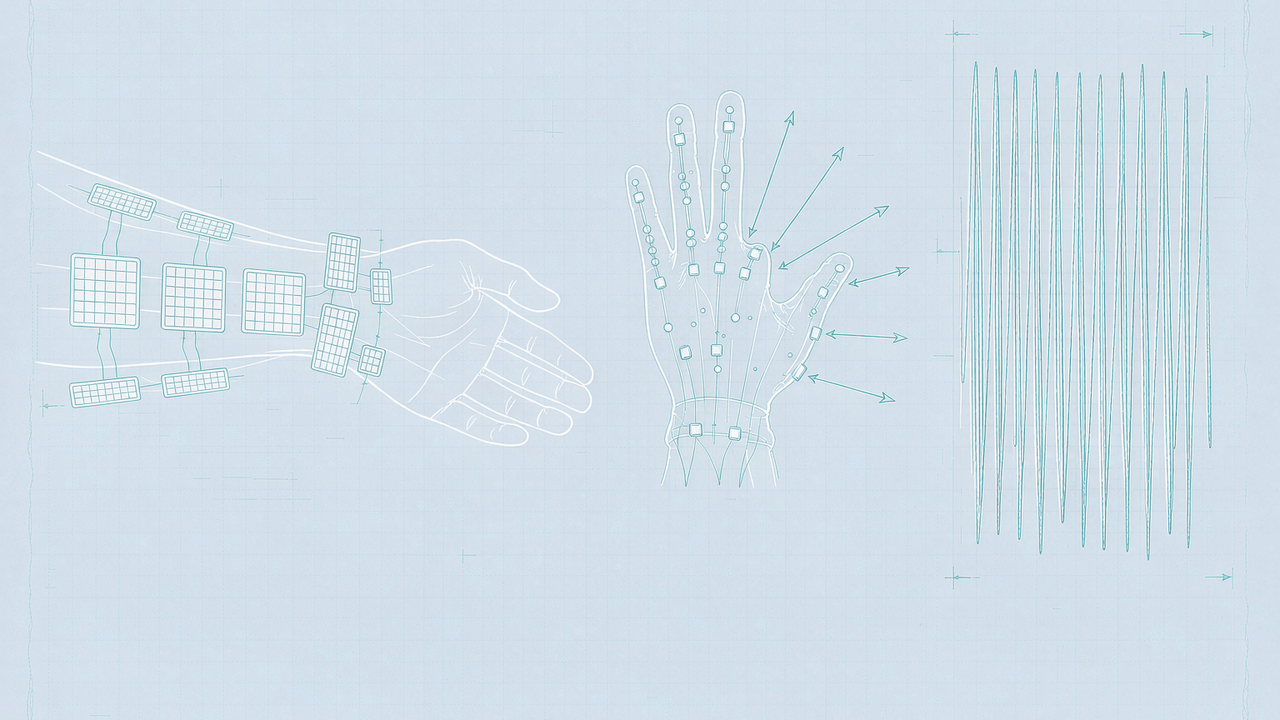
信息速览
这里有一份三类信号被强行拧在同一根时间轴上:前臂的肌肉放电、腕部的远场电位、手指的弯曲角度与按压力。HD-FW KIN 就建在这根轴上。它是上海交通大学的一个研究组在 2025 年 1 月交给 PhysioNet 的受限资源,作者署名 Zeming Zhao、Weichao Guo、Zeyu Zhou,版本 1.0.0,DOI 10.13026/ch3e-c195。
名字里带 kinematics,也带 sEMG,字面上看它就是你猜的那种数据集:手怎么动,肌肉怎么放电,两件事同时记。这个猜测没有错,错的可能只是量级。肌电不是前臂贴八片电极的常规配置,而是四百四十八个通道的高密度阵列,其中一半以上贴在手腕上——那是市面上少有人认真做的一个位置。运动学也不是光学动捕,是一只五路传感的数据手套。
真正决定这份数据能不能用的是三件事:它只有二十一个健康人,全部右手利,十九男二女;它是受限访问,签名之后才拿得到一百多 GB 的文件;它的原始肌电没有经过任何已知滤波器。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 官方全名 | A database of hand kinematics, high-density sEMG of forearm and wrist for motion intent recognition |
| 内部简称 | HD-FW KIN(文件名前缀 hdkw_kin) |
| 发布平台 | PhysioNet |
| 版本与日期 | 1.0.0,2025 年 1 月 17 日 |
| DOI | 10.13026/ch3e-c195(最新版 10.13026/ns35-g888) |
| 作者 | Zeming Zhao、Weichao Guo、Zeyu Zhou |
| 机构 | 上海交通大学;Guo 另署 Meta Robotics Institute |
| 受试者 | 21 名健康成人,19 男 2 女 |
| 年龄 | 21 至 35 岁,26.47 ± 3.71 岁 |
| 肌电通道 | 448 路高密度(前臂 192 + 腕部 256) |
| 运动学采集 | 5DT Data Glove 14 Ultra,200 Hz |
| 测力采集 | 自制装置 RFP 602,1000 Hz |
| 动作集 | 20 类手势 + 9 种屈指(两级力) |
| 存储格式 | WFDB(.dat 二进制) |
| 体积 | 三个文件夹合计 113.9 GB |
| 访问与许可 | 受限访问,PhysioNet Restricted Health Data License 1.5.0 |
| 伦理批件 | 上海交通大学伦理委员会 E20230257I |
§1 它要解决的具体麻烦
1.1 手腕上的肌肉信号几乎没人认真收集过
肌电控制这条线走了几十年,采集电极一直贴在同一处:前臂。原因是假肢的接受腔套在前臂,电极跟着接受腔走,天经地义。近年风向变了,消费电子把目光挪到手腕——腕戴设备比袖套更不像医疗器械,更体面,也更容易被普通人接受。可手腕的肌电极难用:前臂肌肉的电位传到腕部已经衰减成所谓远场电位,各条肌腱的信号在这里互相串扰,分类准确率长期在七成上下打转。
要解开这个结,需要一样东西:同一段动作,在用近场(前臂)和远场(腕部)两处同时采集的高密度阵列上,各是什么样子。这样的数据此前没有公开过。官方摘要把这句写得很直白——「no publicly available databases that include HD sEMG signals of forearm-wrist (FW) muscles, and hand kinematics」。这句话是它的立项理由,也是它唯一真正的空白点。
1.2 三条常见的错误期待
第一条是把 kinematics 理解成三维关节坐标。它不是。数据手套给出的是五路弯曲传感读数,换算成角度之后每根手指一个数,没有指尖位置,没有手掌朝向,也没有骨骼长度。想拿它做生物力学建模,缺的是空间信息;想拿它做连续比例控制,它恰好够。
第二条是把它当成又一个 NinaPro。NinaPro 的重点是跨人、跨天、跨设备的泛化,受试者上百,协议层层叠叠。这一份只有二十一人,没有天数跨度,重点全在一个「深」字:腕部高密度阵列这件事,别处没有。
第三条是以为四百四十八个通道意味着四千赫兹以上的采样。实际上官方页面在描述段落里没有给出肌电的采样率,只在讨论滤波器时明确说数据未经已知数字滤波器处理。要拿到准确采样率,得读头文件,而要读头文件,得先签协议拿到文件。这条沟是所有使用者都会踩的。
三条期待背后是同一个心理动作:把「有手部运动学」听成「有手的三维姿态」,把「有四百四十八个通道」听成「信号质量高到可以直接训练」,把「PhysioNet 上的数据」听成「点开链接就能下」。三处误听的共同点是,它们都跳过了两个前置条件——采集设备是什么,访问门槛有多高。把这两个条件补上,期待自然回落到与实际相符的位置。
1.3 它能给到的与给不到的
把需求拆成条目逐行对照,比看摘要更快判断该不该选它。
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 高密度肌电做运动单位分解 | 448 路阵列,前臂与腕部皆有 | 够,且是少见的可选腕部 |
| 连续比例控制的手指角度回归 | 手套五路角度,200 Hz | 够,但只有弯曲,没有外展 |
| 五指独立按压力回归 | 测力装置,1000 Hz,两级力 | 够,等长按压场景 |
| 离散手势分类 | 20 类手势 | 够,但类别数不算多 |
| 跨天或跨设备的鲁棒性 | 三个会话,日期关系未说明 | 不够,缺设备变更与明确天数 |
| 截肢者或患者的肌电 | 无 | 不够,全部健康人 |
| 左利手人群 | 无 | 不够 |
| 电极位移的定量研究 | 未提供电极位置测量 | 不够,位置靠贴附规程约束 |
| 与世界其他队列的跨库比较 | 单中心、单设备 | 不够 |
| 完整的三维手部生物力学 | 只有角度与力 | 不够 |
表里前三行是可以被它直接满足的需求,中间三行是部分满足,最后四行是明确不满足。分界不在难易,而在信号物理量的种类:凡是能从电位、角度、力这三种量推出来的,它大体上都撑得住;凡是要靠空间坐标或第三人称视角的,它一律给不了。把这张表当作预审清单,比通读摘要省时间。
1.4 你的处境与它能帮到的事
下面这张表按处境组织,不按特性组织。左列是你眼下的状态,右列是它能帮上的部分,第三列是接下来该做的一步。
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 正在做腕戴式肌电的手势识别,苦于没有腕部高密度数据 | 提供 256 路腕部阵列,可与前臂阵列对照 | 先算同一动作在前后两处的可分性差 |
| 想验证远场电位能否解码手指动作 | 同一时段的前臂与腕部信号齐全 | 做前臂到腕部的跨位置迁移实验 |
| 需要一个连续角度回归的公开基准 | 五路角度作为回归目标 | 用头文件核对角度通道顺序 |
| 做运动单位放电序列的算法开发 | 原始未滤波高密度信号 | 自带高通与陷波,别指望现成的 |
| 想找便宜的入门肌电数据练手 | 113.9 GB 起,且需审批 | 换一个开放的小库先跑通流程 |
| 要给假肢控制做临床前验证 | 21 名健康人,无截肢者 | 只能作为方法可行性的旁证 |
| 需要发表时可引用的规范来源 | Scientific Data 论文与 DOI 齐备 | 按 §9.3 的两段式引用 |
1.5 一句话判断
它不是一个「更大」的肌电库,而是一个「更深」的肌电库:把同一段动作在近场与远场两处同时切开看,代价是只有二十一人、且要签字才能进门。
1.6 不适合谁:四条边界
第一条是数据量导向的项目。需要上千人、上百小时的项目,这里一个都拿不到。二十一个人的样本,做组间比较时连一个像样的置信区间都撑不起来,做深度学习时只能靠同人多次重复刷样本数,而这条路会直接污染评估。
第二条是需要临床人群的项目。没有截肢者,没有神经损伤患者,没有术后状态。假肢控制的真实难点在于残肢肌肉的重排与幻肢感,这份数据对这些问题一个字也不说。
第三条是需要空间运动学的项目。手套只给弯曲角度。要做逆动力学、要算关节力矩、要研究手指间的耦合运动学,需要的是动捕或视觉标定,这里的输入维度不够。
第四条是需要即插即用的工程队。受限许可、签名流程、113.9 GB 的下载量、无官方读取脚本,这四件事叠在一起,意味着从零到第一条可用序列的路径比多数公开库都长。急着两周出结果的团队,选它几乎必然误判工期。
§2 数据构成与规格
2.1 三个文件夹与一种命名
官方把数据装进三个文件夹,分别对应三个实验会话。三个文件夹的体积差异很大,这个差异本身就是一条结构信息:会话一人最多,会话三只有十人,体重自然轻。
| 文件夹 | 会话 | 人数 | 体积 | 每人重复数 | 文件数(按源分) |
|---|---|---|---|---|---|
exp_01 |
会话一 | 21 | 55.1 GB | 6 | 每源 126 个 |
exp_02 |
会话二 | 21 | 40.1 GB | 6 | 每源 126 个 |
exp_03 |
会话三 | 10 | 18.7 GB | 6 | 每源 60 个 |
文件名格式是 hdkw_kin_expAA_subjBB_CC_DD.dat,四个可变字段各有明确取值域。这套命名是全库最值得先背下来的东西,因为所有对齐操作都靠它。
| 字段 | 含义 | 取值域 |
|---|---|---|
hdkw_kin |
数据库前缀,四个词首字母拼成 | 固定 |
expAA |
文件夹序号 | 01、02、03 |
subjBB |
受试者序号 | 文件夹一、二为 01–21;文件夹三为 01–10 |
CC |
重复序号 | 01–06 |
DD |
数据源 | emg、press、glove |
.dat |
扩展名 | 固定 |
三段式对齐在这里是免费的:只要把 DD 换掉,就得到同一段动作的另一种信号。这比用时间戳去凑对齐省事得多,也意味着三类信号的时长必须彼此匹配,否则文件名这一层的承诺就落空。
2.2 字段与记录的完整字典
页面没有给出逐通道的字典,这是它作为受限资源的一个代价。能确定的只有阵列级信息与阵列内部的布局。下表把官方文字里能找到的每一项摊开。
| 项 | 前臂 | 腕部 | 说明 |
|---|---|---|---|
| 阵列型号 | GR10MM0808 | GR04MM1305 | OT Bioelettronica,意大利 |
| 阵列形状 | 8×8 方形 | 5×13 长条 | 前者两块,后者四块 |
| 单阵列电极数 | 64 | 65 | 由形状直接相乘 |
| 阵列数 | 3 | 4 | 前臂三块,腕部四块 |
| 小计通道 | 192 | 260 | 相乘后求和 |
| 官方口径通道 | — | — | 全库合计 448 |
| 贴附位置 | 绕前臂一周 | 绕腕一周,近尺骨茎突 | 两块在前侧、两块在后侧 |
| 距肘参考 | 电极距鹰嘴约为前臂长三分之一 | 未说明 | 仅前臂有明确约束 |
| 接地与参考 | 鹰嘴附近各一枚 | 同 | 两处共用 |
| 采样率 | 页面未给 | 页面未给 | 只在讨论滤波时提到未滤波 |
关于 448 与 452 的差额,这是全篇唯一需要并列两口径的地方。按阵列规格相加:三乘六十四加四乘六十五,等于四百五十二。官方摘要与页面数据描述都写作 448 通道。两个口径并列,四路差额的构成官方未说明,可能是部分电极被弃用,也可能是接地或参考极计入与否。使用者在按通道数分配内存或写循环之前,务必以头文件实际声明为准,不要按四百五十二去预分配。
运动学与力这两路的结构更简单,页面对它们的口径也更清楚。
| 信号 | 设备 | 采样率 | 输出 | 官方说明 |
|---|---|---|---|---|
| 手指角度 | 5DT Data Glove 14 Ultra | 200 Hz | 五路弯曲传感读数 | 远高于手指运动频率 |
| 五指按压力 | 自制装置 RFP 602 | 1000 Hz | 五路等长按压力 | 中国 Runeskee 公司 |
手套 200 Hz 这个数字背后有一句很值得记住的官方理由:「which is far more than the movement frequency of fingers」,即采样率远高于手指的运动频率。这是一句工程上的自我辩护,意思是这个采样率足够而不浪费。对手指的运动学来说,200 Hz 确实不寒碜;但要做肌电与角度的精确时序对齐,肌电侧若是数千赫兹,两路之间就存在明显的重采样需求,而重采样会不会引入相位误差,需要使用者自己判断。
2.3 一条记录的完整解剖
因受限访问,这里无法给出真实文件的头文件原文。但 WFDB 记录的结构是固定的,可以按其规范还原一个符合命名约定的记录应有的形态,用来解释三类信号如何各成一家。
先从目录看一段典型的会话一布局。
#-- 目录结构示意:exp_01 下按人名平铺 378 个文件
exp_01/
  hdkw_kin_exp01_subj01_01_emg.dat
  hdkw_kin_exp01_subj01_01_press.dat
  hdkw_kin_exp01_subj01_01_glove.dat
  hdkw_kin_exp01_subj01_02_emg.dat
  hdkw_kin_exp01_subj02_01_emg.dat
  #-- 其余受试者与重复,命名同理

#-- 按数据源分组清点,验证与官方文件数对得上
find exp_01 -name '*_emg.dat'   | wc -l    #-- 期望 126
find exp_01 -name '*_press.dat' | wc -l    #-- 期望 126
find exp_01 -name '*_glove.dat' | wc -l    #-- 期望 126
每份 .dat 都是一个独立的 WFDB 记录。按 WFDB 惯例,一个记录还应有一份 .hea 头文件,用来声明通道数、采样率、每通道样本数与增益。页面只提到信号段都存为 *.dat,没有明说头文件是否同名同目录;从 WFDB 工具链的读取方式推断,头文件应当存在,否则 rdrecord 无法定位通道。使用者拿到文件后第一件事应当是 ls 一遍,确认到底有没有头文件。
下面用一个纯 Python 脚本,按 WFDB 二进制记录的常见形态做一次结构自检。它不依赖 PhysioNet 登录态,只对已获批下载到本地的文件操作。
#-- 结构自检:不解析信号值,只核对形状与体积是否自洽
from pathlib import Path

def probe(path):
    p = Path(path)
    hdr = p.with_suffix('.hea')
    size = p.stat().st_size
    rows = []
    if hdr.exists():
        with hdr.open(encoding='utf-8') as fh:
            lines = [ln.strip() for ln in fh if ln.strip() and not ln.startswith('#')]
        #-- 首行三字段:记录名 通道数 采样率,第四字段为每通道样本数(可缺)
        head = lines[0].split()
        name, n_sig, fs = head[0], int(head[1]), float(head[2])
        n_samp = int(head[3]) if len(head) > 3 else None
        rows.append((name, n_sig, fs, n_samp, size))
    else:
        rows.append((p.stem, None, None, None, size))
    return rows

for f in sorted(Path('exp_01').glob('hdkw_kin_exp01_subj01_01_*.dat')):
    for r in probe(f):
        print(r)
这个脚本只回答三个问题:头文件在不在、通道数报多少、体积与采样点数能不能对上。它不回答信号内容,因为信号内容需要先知道通道顺序,而通道顺序在受限访问的前提下只能从头文件的通道注释里读。
把三路文件放在一起看,一条记录的实际含义就清楚了。emg 是四十八个以上通道、数千赫兹的高密度波形;press 是五路、千赫兹的等长力;glove 是五路、两百赫兹的弯曲角度。三者的时间长度应当一致,采样率相差一个数量级。这就是所谓「同一根时间轴」的真实样子:不是一根,而是三根以不同密度刻度的轴,靠文件名系在一处。
| 观察项 | emg 文件 | press 文件 | glove 文件 |
|---|---|---|---|
| 通道规模 | 数百路 | 约五路 | 约五路 |
| 采样密度 | 最高 | 中 | 最低 |
| 物理量 | 电位 | 力 | 角度 |
| 是否滤波 | 未滤波 | 页面未说明 | 页面未说明 |
| 与其他两路的对齐手段 | 文件名后缀替换 | 同 | 同 |
| 缺头文件时的可用性 | 不可用 | 不可用 | 不可用 |
2.4 三个会话与二十号动作
动作集分两族。第一族是二十类手势,第二族是九种单指或组合屈指动作,后者在两级力水平下各做一遍。二十加九,三十个动作名称,六个重复,这就是每个受试者在每个会话里的任务量。
| 族 | 动作数 | 力水平 | 每动作重复 | 输出信号 |
|---|---|---|---|---|
| 手势 | 20 | 未分级 | 6 | 肌电 + 角度 + 压力 |
| 屈指 | 9 | 两级 | 6 | 肌电 + 角度 + 压力 |
官方的措辞是「21 subjects while performing 20 hand gestures, and 9 individual or combined finger flexion under two force levels」。这句话有两个读法:一是二十类手势不分力水平,九种屈指分两级;二是所有动作都分两级,二十与九只是动作类别的计数。前一种更贴近字面,后一种更贴近实验设计的常规做法。两个读法并存,官方没有逐句澄清。
这两个读法的差别落到使用上并不小。按字面读,手势类别是二十个平级的类,训练分类器时每类只有六个重复、来自二十一个人,样本极薄;按后一种读,二十类手势每类还要乘上两个力水平,实际类别数会翻倍,而摘要里的「20」只是一个抽象计数。前者适合做标准的二十类手势识别,可以直接与文献里的二十类或五十二类基准对比;后者适合研究力水平对肌电模式的调制,但类别数说不清,难以对外报告。使用者在决定标签体系之前,必须先去论文方法节把这一句的原文读完整。
会话三只有十人这一点也值得留意。为什么少十一人,页面没说。可能是招募人数本身就不足,可能是部分受试者未完成第三次采集,也可能是第三次采集只针对子集做补充。三种可能对使用者的影响完全不同:第一种意味着样本量天然如此,第二种意味着十人子集可能有选择偏倚,第三种意味着会话三的用途被限定。官方没有给出解释,任何推断都只是推断。
从文件数上算一遍,就能看出三个会话的规模差有多大:会话一与二是二十一人乘六个重复,每路一百二十六个文件;会话三是十人乘六个重复,每路六十个文件。三路信号再各乘三,一个完整会话的文件总数在三百七十八与一百八十之间。这个换算不是为了核对什么,而是为了估算下载与预处理的时间:即使只处理会话三,也要先过一百八十个文件,其中每个肌电文件都有数百个通道。
三个会话之间的间隔天数,页面完全没有写。这是一个不小的缺口:如果三次会话在同一周内完成,它观测不到肌肉的长期漂移;如果间隔数周,它就是研究电极重贴与跨天鲁棒性的好材料。这一点使用时必须按「未知」处理,不能假设。若真的按跨天分析来用,最稳妥的做法是先把同一受试者在三个会话里的同名重复摆在一起,看角度轨迹的形状是否一致;形状对得上说明动作执行规范,对不上则说明间隔期可能伴随电极重贴或疲劳累积,后面的一切对比都要先扣掉这一层。
2.5 与同类资源的规格差异
把高密度肌电这个谱系摆开,HD-FW KIN 的位置相当特殊:通道数偏低,覆盖位置偏腕,配套信号偏全。
| 资源 | 通道数 | 覆盖位置 | 配套信号 | 人数 |
|---|---|---|---|---|
| HD-FW KIN | 448 | 前臂 + 腕部 | 角度 + 压力 | 21 |
| 常见前臂高密度库 | 数百 | 仅前臂 | 多为无 | 多为 10 至 30 |
| 常规表面肌电库 | 8 至 32 | 前臂或腕部 | 多为无 | 数十至上百 |
| 光学动捕 + 肌电 | 数十 | 上臂与前臂 | 三维关节 | 数十 |
| 惯性 + 肌电 | 数路 | 腕或手背 | 姿态角速度 | 数十 |
这张表真正的信息是最后一行与第一行的对照。惯性加肌电的组合已经很常见,但惯性给的是腕部姿态,不给手指;这一份反过来,给手指的角度,不给腕部姿态。两者互补,不重叠。若一个项目既要手指角度又要腕部姿态,最省事的办法不是找一份全能数据,而是把一份惯性库与一份手套库按时间戳拼起来,代价是两套设备的启动时刻要对齐。
通道数这一列也值得停一下。四百四十八在这个谱系里不算突出,真正突出的是它覆盖了腕部。把通道贴满前臂是工程上的常规操作,把阵列绕过腕部一圈则要解决曲面贴合、位移重复性与肌腱串扰三个问题,这才是它比同类多花功夫的地方。因此看这张表时不要横着比通道数,要竖着看同一通道数下覆盖了哪里。
与库内已有的三个肌电词条相比,差异更细致,§6 会展开。这里先给一句总纲:NinaPro 宽而浅,GRABMyo 中而多日,Hyser 深而单日,HD-FW KIN 深且位置特殊。
§3 它是谁的数据:一个研究组与一个具体的空白
3.1 三位作者与两处署名
作者三人,署名机构两处。Zeming Zhao 与 Weichao Guo 同属上海交通大学,Guo 另署该校 Meta Robotics Institute;Zeyu Zhou 单署上海交通大学。PhysioNet 页面在每个作者名后都附了站内主页链接,说明三人都在 PhysioNet 上有可追溯的账号。
这个署名结构透露的信息不多,但有一件事清楚:这是一个校内跨机构的组,机器人研究院与传统院系联合。这与它的选题一致——腕戴设备的动机来自消费电子,而不是临床康复,官方背景节里多次把重心从康复挪向消费场景。
| 作者 | 机构 | 在 PhysioNet 的账号 | 官方角色 |
|---|---|---|---|
| Zeming Zhao | 上海交通大学 | bcilab205 |
第一作者 |
| Weichao Guo | 上海交通大学、Meta Robotics Institute | doctor-guo586 |
通讯方向 |
| Zeyu Zhou | 上海交通大学 | yudang |
第三作者 |
3.2 它填补的那一格
高密度肌电不是新东西。用高密度阵列做运动单位分解,已经有十多年积累;用高密度阵列做手势识别,也有不少工作。真正缺的是两件事同时到位:一是腕部的高密度阵列,二是同一时段的完整手部运动学与力。
腕部这一格为什么空着,官方给了解释:腕部肌电被多条肌腱串扰污染,分类性能长期上不去;同时,腕戴设备的舒适性优势又让工业界无法放弃这个位置。两个力量相互拉扯,结果是数据空白。
3.3 立项逻辑与三项验证
官方摘要把验证写在了一句话里:「The usability of HD-sEMG for hand gesture recognition, finger angle, and force prediction was validated」。三项任务,三条通路,都是可用性验证,不是性能竞赛。
| 验证任务 | 输入 | 输出 | 官方定性 |
|---|---|---|---|
| 手势识别 | 高密度肌电 | 20 类之一 | 可用性已验证 |
| 手指角度预测 | 高密度肌电 | 连续角度 | 可用性已验证 |
| 力量预测 | 高密度肌电 | 连续力值 | 可用性已验证 |
这三项对应三种使用者的三种期待,也解释了为什么它要把角度与力都采下来。只有肌电没有配套真值,做回归就是无本之木;只有角度没有力,就测不了比例控制里的力维度。三样凑齐,回归任务的标注才算完整。
3.4 放在时间线上
2025 年 1 月上线,是这条线上较新的一份。它的自述参照物是 2021 年发表的另一份高密度手势数据库,那份有六十五类等长手势。它没有去比类别数,而是比位置:我做腕部,你没有。
这条路线在方法上是有依据的。2022 年有一项工作证明,腕部传感器的远场电位可以反映脊髓的输出。这份数据在物理上就是为这类研究准备的材料。
3.5 设备为什么选这两样
设备选型不是随手决定的,从这三样设备能反推出整个实验关心的量。前臂与腕部的阵列选的是同一家厂商的两款产品,方形阵列给前臂、长条阵列给腕部,形状不同是因为前臂是柱面、腕部是窄环,长条更容易绕过去。选同一品牌意味着两款阵列的电极材料、阻抗特性与放大器接口一致,跨位置的信号可以直接比较,不必担心两套系统之间的增益差异。
手套选的是商用光纤型而不是惯性型,原因藏在输出量里。惯性手套报的是姿态变换,需要靠指骨的几何长度才能反推关节角,误差会随个体手型放大;光纤手套只管弯曲,传感器直接贴在手指背面,读数与弯曲量近似单调对应,标定简单。代价是它不给外展与内收,也就是手指左右分开的动作无法记录。这份数据因此只能研究屈伸这一个自由度族,这是设备选择直接带来的边界。
测力装置选了自制件而不是商用握力计,同样有原因。商用握力计大多整体测量四指合力,而这项研究需要五指各自独立。自制件能做五指独立,但也因此没有经过商用的计量校准链路,力的绝对值精度要打折扣。使用者若要做跨研究的力值比较,应当先看论文里是否给了标定方法。
四样设备的取舍可以归成一条线索:凡是能直接对应物理量的部件都选便宜的、直接的;凡是需要覆盖特定解剖部位的部件才肯花钱。手套与测力装置属于前者,阵列属于后者,成本结构正好反映这份数据的重心——钱花在覆盖位置上,不花在信号的二次换算上。
§4 采集设计:手套、阵列与力
4.1 一套贴合规程决定了全部可比性
电极位置是这份数据最脆弱的环节。三块前臂阵列绕一周贴,四块腕部阵列绕一周贴,前后各两块。位置约束只有一条能量化的:前臂阵列的电极到鹰嘴的距离等于前臂长度的三分之一。腕部没有对应的量化约束,只说贴近尺骨茎突。
这意味着跨受试者的电极位置并不同构。前臂围二十三到二十九厘米,腕围十四点五到十八厘米,周长差异接近四分之一,同样的阵列贴上去,覆盖的肌肉面积占比并不相同。做跨人迁移时,这是一个系统性误差源,而不是随机噪声。
| 约束项 | 前臂 | 腕部 |
|---|---|---|
| 量化位置约束 | 距鹰嘴三分之一前臂长 | 无 |
| 环路方式 | 绕前臂一周 | 绕腕一周 |
| 前后分区 | 未说明 | 前侧两块、后侧两块 |
| 参考电极 | 鹰嘴附近 | 鹰嘴附近 |
| 周长范围 | 23 至 29 厘米 | 14.5 至 18 厘米 |
4.2 手套给的是角度还是读数
5DT Data Glove 14 Ultra 是一只商用光纤弯曲手套,输出是每根手指一路弯曲量。它标称十四路传感,覆盖五指的近端与远端。页面只写「finger joint angles」,没有说清是哪几个关节、如何标定。
这一点对回归任务至关重要。如果输出是未标定的传感器读数,训练出来的模型只能复现读数,不能换算成生理角;如果厂商已经做了角度换算,那么不同手型之间的换算误差又被引入一层。官方没交代,使用者得自己在手套的出厂文档里找答案,再决定是否要做一次个体标定。
4.3 力是怎么测的
五指等长按压用的是一台自制装置,型号写作 RFP 602,厂商是中国的 Runeskee。采样一千赫兹,比手套密五倍,比肌电可能低数倍。等长按压这个设计意味着手指不动、力在变,因此角度信号在这一段应当是平的,力信号是主角。
「两级力」这个设定值得单独说。它的好处是把连续力回归退化成一个二分类的对照,便于验证;坏处是失去中间档,做比例控制时无法知道模型在中间区间是否线性。要在两级之间插值,只能靠模型自己外推。
| 量 | 采样率 | 相对精度 | 信号形态 | 主要用途 |
|---|---|---|---|---|
| 肌电 | 页面未给,按阵列与 WFDB 惯例应为千赫兹以上 | 最高 | 高频振荡 | 运动单位与分类 |
| 按压力 | 1000 Hz | 中 | 缓慢上升的台阶 | 力回归 |
| 手指角度 | 200 Hz | 最低 | 平滑曲线 | 角度回归 |
4.4 案例:subj01 的第一段重复
以会话一第一号受试者的第一次重复(exp01_subj01_01)为贯穿案例,后续章节会反复回到它。这不是一条被验证过的真实记录——文件尚未获批下载——而是一个用来解释结构的参照点:它同时拥有三路信号、六个重复序号、以及一段在三个会话里都可对应的位置。
把它当作分析单位,有四件事必须依次问清。第一,三路文件的时间长度是否一致。第二,肌电通道数在头文件里报的是四百四十八还是四百五十二。第三,手套五路对应的具体手指顺序。第四,同一受试者在会话二、会话三里对应的 subj01_01 是否真是同一套动作、同一顺序。前两问读文件即可,后两问必须读论文方法节。
#-- 以 subj01 的第一次重复为锚,列出三路文件与其体积
from pathlib import Path

anchor = 'hdkw_kin_exp01_subj01_01'
base = Path('exp_01')
for src in ('emg', 'press', 'glove'):
    f = base / f'{anchor}_{src}.dat'
    print(src, f.exists(), f.stat().st_size if f.exists() else 0)

#-- 跨会话的同号受试者是否齐全,只有子集三会缺人
for exp in ('exp_01', 'exp_02', 'exp_03'):
    d = Path(exp)
    hits = list(d.glob('hdkw_kin_*_subj01_01_emg.dat')) if d.exists() else []
    print(exp, len(hits))
这段脚本跑完能回答的是一件事:会话三是否真的只有十人。它不是审计,只是在使用前把文件盘点清楚,避免训练脚本在第十一号受试者上崩掉。
4.5 六个重复意味着什么
六个重复,官方只写「6 repetitions」,没有说这六次是同一段动作连做六遍,还是打乱顺序做了六个区块。两种设计的统计后果完全不同:前者有顺序效应,后者有区块间的休息效应。对分类任务,两种都能用;对疲劳或学习效应的研究,二者的解释截然相反。
§4.4 的案例里,六次重复正好是判断这一点的最小单位:如果同一动作的六次在文件编号上连续出现,说明是分块执行;如果六个文件里各动作交错出现,说明是随机化。这一点只能等文件到手才能确认。
§5 怎么拿到,以及拿到之后怎么读
5.1 三道门:注册、培训、协议
它是受限资源。访问页面写明:只有注册账号并签署指定数据使用协议的用户才能访问文件。文件目录在匿名请求下返回 403,这一点已确认。
| 环节 | 要求 | 是否有官方说明 | 常见耗时 |
|---|---|---|---|
| 注册 | PhysioNet 账号 | 有 | 数分钟 |
| 培训 | CITI 类研究伦理课程 | 有,平台统一要求 | 数小时至数日 |
| 签署协议 | 受限健康数据使用协议 1.5.0 | 有 | 数分钟 |
| 审批 | 项目负责人确认 | 有 | 数日 |
| 下载 | 登录态下取三个文件夹 | 有 | 视带宽而定 |
5.2 用 wget 拉取已获批的目录
获批之后,下载走的是登录态的 wget。下面是一种常见写法,凭据文件放在用户主目录、权限收紧。
#-- 先建凭据文件,再从三个文件夹逐个拉取
printf 'machine physionet.org login %s password %s\n' "$PN_USER" "$PN_PASS" > ~/.netrc
chmod 600 ~/.netrc

for exp in exp_01 exp_02 exp_03; do
  wget -r -N -c -np --no-parent \
       -e robots=off \
       "https://physionet.org/files/hand-kinematics-semg/1.0.0/${exp}/"
done
-c 保证断点续传,-np 防止向上越界抓取。三个文件夹一百多 GB,断线是常态,续传参数不是可选项。-e robots=off 只在已获授权的前提下使用,未经授权不应绕过平台任何访问控制。
5.3 用 Python 读一段 WFDB 记录
WFDB 有成熟的 Python 客户端。下面这段读一份肌电文件,打印形状与采样率,不加载全部数据到内存。
#-- 读取一份高密度肌电记录,先只看头信息与首段
import wfdb
import numpy as np

rec = wfdb.rdheader('exp_01/hdkw_kin_exp01_subj01_01_emg')
print('sig_name 数量:', len(rec.sig_name))
print('采样率 fs:', rec.fs)
print('每通道样本数:', rec.sig_len)

#-- 只取前 10 秒,避免一次性吃满内存
seg, fields = wfdb.rdsamp('exp_01/hdkw_kin_exp01_subj01_01_emg',
                          sampto=int(rec.fs * 10))
print('片段形状:', seg.shape)
print('通道单位:', set(fields['units']))
打印出来的通道数就是最直接的答案:四百四十八还是四百五十二。这一行输出胜过任何文字推断。
5.4 三路对齐的最小实现
三路采样率不同,对齐要按物理时间做,不能按样本序号硬切。
#-- 按秒对齐三路:以肌电的采样率为基准,把角度与力插值上去
import wfdb
import numpy as np

def load(path):
    sig, f = wfdb.rdsamp(path)
    return sig, f['fs']

emg, fs_e = load('exp_01/hdkw_kin_exp01_subj01_01_emg')
press, fs_p = load('exp_01/hdkw_kin_exp01_subj01_01_press')
glove, fs_g = load('exp_01/hdkw_kin_exp01_subj01_01_glove')

n = min(len(emg) / fs_e, len(press) / fs_p, len(glove) / fs_g)
t = np.arange(0, n, 1.0 / fs_e)          #-- 统一时间轴,步长取最高采样率
ang = np.stack([np.interp(t, np.arange(len(glove)) / fs_g, glove[:, k])
                for k in range(glove.shape[1])], axis=1)
frc = np.stack([np.interp(t, np.arange(len(press)) / fs_p, press[:, k])
                for k in range(press.shape[1])], axis=1)
emg = emg[:len(t)]
print(emg.shape, ang.shape, frc.shape)
插值会抹掉手套的高频细节,但对角度这种平滑信号影响有限。真正要小心的是相位:如果三路记录不是同一次触发启动,起点的几十毫秒偏差会让回归目标错位,这种错位在模型指标上看不出来,在波形上能看出来。§4.4 的案例正是检查这件事的最小单元。
5.5 滤波:官方明说了不做,你自己得来
官方在用途说明里写得很直白:原始数据未经已知数字滤波器处理,常规肌电分析前应当先滤波。这句话给了一个罕见的自由度——想测滤波器性能的人,正好可以拿它当对照组。
#-- 常规肌电预处理:带通加陷波,顺序与参数按各自文献约定
import numpy as np
from scipy.signal import butter, iirnotch, filtfilt

fs = 2000.0                                  #-- 以头文件声明为准,此处按常见值占位核对
b, a = butter(4, [20 / (fs / 2), 450 / (fs / 2)], btype='band')
bn, an = iirnotch(50.0, 30.0, fs)            #-- 电网工频,中国为 50 Hz

def clean(x):
    y = filtfilt(b, a, x, axis=0)
    return filtfilt(bn, an, y, axis=0)

sample = emg[:, 0]                           #-- 只取一路做演示
print(clean(sample).std())
上面代码块里的采样率是占位核对值,不是官方数字。真正跑之前必须用头文件里的 fs 替换,否则带通边界会错位。这一点在受限数据上尤其要紧:任何网上抄来的采样率都不能信。
5.6 分人切分是最基本的纪律
二十一个人、每人六重复,最容易被误用的是把六重复当六个人。按文件随机切分会让同一段肌肉活动同时出现在训练与测试里,准确率虚高得离谱。
#-- 按受试者切分,而不是按文件切分
from pathlib import Path

files = sorted(Path('exp_01').glob('*_emg.dat'))
subj = sorted({f.stem.split('_')[2] for f in files})   #-- 形如 subj01
hold_out = set(subj[:4])                                #-- 留四人做测试
train = [f for f in files if f.stem.split('_')[2] not in hold_out]
test = [f for f in files if f.stem.split('_')[2] in hold_out]
print('受试者数', len(subj), '训练文件', len(train), '测试文件', len(test))
留出四人做测试,意味着二十一人里只有十七人参与训练。这已经是这份数据在跨人评估上能给到的极限。
§6 与库内条目的关系
6.1 关系图谱
库内已有五个肌电相关词条,各自占一格。HD-FW KIN 与它们不是替代,而是分工。
| 词条 | 通道与位置 | 配套信号 | 人数 | 与本篇的关系 |
|---|---|---|---|---|
| NinaPro | 8 至 16 路,前臂 | 部分有惯性、眼动 | 上百 | 宽而浅,适合泛化基准 |
| GRABMyo | 32 通道,前臂与腕部 | 生物特征标签 | 43 | 多日重复,适合鲁棒性 |
| Hyser(高密度肌电) | 256 通道,前臂 | 五指拉力 | 20 | 同为高密度,位置不同 |
| HD-FW KIN | 448 通道,前臂加腕部 | 角度与压力 | 21 | 位置最全,配套最齐 |
| EMGDB | 少量通道 | 临床示例 | 少数 | 教学与示例 |
这张表的读法是看列与列的组合。通道数高且位置覆盖腕部的只有本库一例;人数上百的只有 NinaPro;多日重复设计最完整的是 GRABMyo。任何项目如果同时要这三样,就得接受拼库。
6.2 检索路径
| 你要找的 | 库内路径 | 在本库的落点 |
|---|---|---|
| 高密度阵列与运动单位 | 按标签「生理信号」筛 | 本篇与 Hyser |
| 腕部肌电与可穿戴 | 按关键词 wrist 搜 | 本篇最集中 |
| 手势类别多的基准 | 按类别数排序 | NinaPro 领先 |
| 跨天重复设计 | 按会话数筛 | GRABMyo |
| 手指角度作为回归目标 | 按配套信号筛 | 本篇与少数惯性库 |
| 受限与开放的区别 | 按许可筛 | 本篇属受限 |
| 接受临床人群的肌电 | 按人群筛 | 本篇不适用 |
6.3 与 Hyser 的三处错位
Hyser 与 HD-FW KIN 常被放在一起提,因为两者都是高密度、都来自中国团队、都上 PhysioNet。三处关键差异决定了它们的用途不同。
第一处是位置。Hyser 是二百五十六通道贴在前臂,HD-FW KIN 多出腕部。要做远场电位,只能选后者。
第二处是配套。Hyser 配的是五指拉力,走的是等长收缩这条路;HD-FW KIN 既有等长力,也有连续角度。要做角度回归,只能选后者。
第三处是人数与规模。Hyser 二十人,HD-FW KIN 二十一人,看起来相当;但 Hyser 的五个子集带来了更多条件组合,HD-FW KIN 的条件更集中。做条件对比选 Hyser,做位置对比选这一份。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
在评估这类数据集时,一个常见的误判是拿「通道数」当质量指标,通道越多就越强,于是把四百四十八当作它优于二百五十六的理由。这个误判在两个层面站不住。
第一层面,通道多不等于信息多。腕部的二百五十六路是远场电位,信噪比天然低于前臂,多出来的通道里有相当一部分在重复同一批运动单位的投影。第二层面,通道多直接抬高工程成本:内存、带宽、训练时间都随通道数线性上涨,而有效性能的提升通常远低于线性。
因此本节的分维度评分不按通道数给「技术先进性」加分,只按「填补了哪一格空白」加分。评分的对象是它作为数据集的可用性,不是它作为论文的贡献度。
拿 §4.4 那个参照点 subj01 的第一次重复来量一遍,维度之间的落差会看得更清楚。三条信号确实同段落地,完整度这一维撑得住;但把这一段落拿到真实流程里,第一个卡口是下载审批,第二个卡口是文档没交代肌电采样率,第三个卡口是没有类别映射表。也就是说,能不能拿到、拿到了能不能对齐,这两件事的难度并不相同——完整度高,不等于可用性高。
7.1 五维评分
评分用 DAIMS 五维框架,每一维给出依据而不是结论。分数为编辑判断,供选型参考,不是官方数据。
| 维度 | 含义 | 分(5 制) | 依据 |
|---|---|---|---|
| D 数据完整度 | 三类信号是否齐全 | 4.5 | 肌电、角度、力三者同段采集 |
| A 获取可及性 | 拿到数据的成本 | 2.0 | 受限许可,113.9 GB |
| I 信息深度 | 是否支持细粒度分析 | 4.5 | 高密度阵列支持运动单位级分析 |
| M 方法论成熟度 | 采集规程与文档 | 3.0 | 页面未给采样率与类别映射 |
| S 场景覆盖 | 人群与条件的广度 | 2.0 | 21 人、单一健康人群 |
五维里两项高分、一项中分、两项低分,这就是它的形状:深度极强,广度与可及性极弱。选型时不要只看总分,要看你的项目卡在哪一维。如果卡在深度,它几乎是唯一解;如果卡在广度或工期,它一定不是。
把这张评分改成一种决策视角,结论会更清楚。重视三路同步的团队看到 D 与 I 两项,基本可以直接定;重视立刻开工的团队看到 A 这一项就会掉头;重视大规模泛化的团队看到 S 这一项,则应当转去人数上百的基准库,把它当作补充位置而非主数据集。同一份评分对不同项目给出相反结论,这不是评分不稳,而是它的长处与短处都太极端,几乎没有中间地带可以调和。
7.2 文档缺口清单
页面写得不算少,但有五处关键信息缺席。它们不是错误,只是没写。
肌电采样率是全篇最要紧的一处。缺了它,滤波器的高通与低通截止都无法落到具体数字上,只能在读到真实值之后回头改参数。三类信号的通道顺序排第二,缺了它,手套的五路读数无法与五根手指对应,回归目标只能是五个无名序号。手势类别与文件段的对应排第三,缺了它,标签必须手工切分。三个会话之间的间隔排第四,缺了它,跨天分析就没有时间轴。会话三为何只有十人排第五,缺了它,子集代表性无从判断。
这五处都可以通过一次获批下载加一篇论文读完解决。它们不构成使用障碍,但构成使用前的阅读负担。
7.3 已知的、可枚举的偏差
偏一,性别。十九男二女,男性占九成以上。手指粗细、前臂围、皮下脂肪厚度都随性别系统变化,模型在女性手上的表现无法从这份数据估计。
偏二,利手。全部右手利。左手的肌电模式与右手并非镜像,做左肢控制的应用没有可供训练的样本。
偏三,人群。全部健康、无神经肌肉疾病、年龄集中在二十一至三十五岁。老年人与肌少症患者的肌电幅度与频率特性不同,这份数据不覆盖。
偏四,机构。单中心、单设备、单一贴附规程。跨实验室的可复现性要等别人重复出来才知道。
偏五,会话。三个会话的人数不一致,跨会话比较必须先取交集,交集是十人。这在统计上已经不叫跨人评估,而是小样本的配对比较。
这五条偏差里,前三条是人群层面的,后两条是设计层面的,后果不同。人群层面的偏差会以系统误差的形式进入模型:训练集中男性占九成,模型学到的特征向量本质上是在男性前臂的形态统计上拟合出来的,换到女性手上,电极覆盖的相对面积变了,特征分布会整体漂移,而这种漂移在留出集里看不出来,因为留出集也是男性为主。设计层面的偏差则以不确定性的形式进入:会话间隔未知、子集人数不知缘由,任何一个跨会话结论都带着一层无法量化的疑问。
对付前三条的办法只有一个:在使用报告里明确写出结论的适用人群,不要写「在健康人上有效」,要写「在这批十九男二女的右手利青年上有效」。对付后两条的办法是控制变量的范围,宁可只在会话一与会话二之间做比较,也不要把会话三混进来。这两条都算不上补救,只是把偏差摆在明处。
| 偏差 | 类型 | 在模型里的表现 | 可控程度 |
|---|---|---|---|
| 性别失衡 | 人群 | 特征分布漂移 | 只能靠报告适用人群 |
| 全右手利 | 人群 | 左侧应用无样本 | 不可控,需另找数据 |
| 健康青年 | 人群 | 老年与患者不可外推 | 不可控 |
| 单中心单设备 | 设计 | 跨实验室复现未知 | 待外部重复 |
| 会话人数不一 | 设计 | 跨会话只能取交集 | 可控,限定在两会话内 |
7.4 外部验证矩阵
一份数据是否被外部工作使用过,是它生命力的证据。下表列出四种可核验的外部信号。
| 信号类型 | 可核验形式 | 本篇状态 | 含义 |
|---|---|---|---|
| 论文自报的可用性验证 | 同一论文的三项任务 | 有 | 作者自己证明可做 |
| DOI 被引 | 出版方统计 | 页面未显示计数 | 第三方使用情况不明 |
| 平台浏览量 | PhysioNet 当前版本浏览数 | 443 | 关注度中等 |
| 独立复现研究 | 别的团队用它出结果 | 未核实 | 需检索引用 |
浏览四百四十三次这个数字放在 PhysioNet 上不算冷。PhysioNet 的浏览量按版本计,当前版本即全部版本,说明自 2025 年 1 月上线以来,它被看过四百多次。这不是被使用的证据,只是被注意到的证据。
7.5 它为何能持续:填补的是位置而不是规模
公开的高密度肌电会越来越多,通道数会被超过,人数会被超过,类别数也会被超过。但有一样东西不容易被超过:同时覆盖前臂与腕部、且配齐角度与力的那一格,短期内不会有第二份。它靠的是这个位置的独占性活着,不是靠体量。
这也解释了为什么它宁可设限访问,也愿意公开。受限许可是这类含人体生物特征数据的一个折中:研究者能用,装置厂商想直接用就得谈。
§8 生态位与历史
8.1 一条从康复走向消费的路线
肌电控制的叙事在过去十年里换过一次主轴。2010 年代初,主角是假肢:截肢者用肌电控制机械手,指标是抓取成功率。2020 年前后,主角慢慢变成消费电子:腕带、手表、戒指,指标是识别准确率与佩戴舒适度。
官方背景节把这个转向写得很清楚:多数腕部肌电研究把准确率做到七成五以上,但被肌腱串扰卡住,进一步提不上去。这句话既是文献综述,也是这份数据的问题陈述。
| 时期 | 主轴 | 典型指标 | 电极位置 |
|---|---|---|---|
| 2010 年代初 | 假肢控制 | 抓取成功率 | 前臂 |
| 2010 年代中 | 运动单位解码 | 放电率估计 | 前臂高密度 |
| 2020 年前后 | 消费电子 | 识别准确率 | 腕部 |
| 2025 年 | 两处并举 | 三类任务可用性 | 前臂加腕部 |
8.2 与 2021 年那份高密度库的关系
官方参考文献里有一篇 2021 年的高密度肌电数据库论文,六十五类等长手势。那份工作确立了高密度阵列做手势识别的可行性,位置在前臂。
HD-FW KIN 的路径不是加类别,而是换位置并加配套。这是一个聪明的位置选择:加类别是量的竞争,换位置是格的竞争。前者永远有人做得更多,后者一旦占住就是独一份。
8.3 数据使用协议这道闸
受限访问不是这份数据独有的安排,而是 PhysioNet 对含可识别生物特征数据的常规做法。肌电波形本身具有生物特征属性,这一点在文献里被讨论过——有人用肌电做身份认证。这意味着这份数据在法律上更接近人体数据,而不只是信号数据。
| 层次 | 开放数据 | 受限数据 | 本库归属 |
|---|---|---|---|
| 是否需注册 | 通常不需要 | 必须 | 受限 |
| 是否需培训 | 通常不需要 | 必须 | 受限 |
| 是否需签协议 | 通常不需要 | 必须 | 受限 |
| 能否直接商用 | 视许可 | 视协议条款 | 需读协议 |
| 匿名链接 | 可 | 不可 | 受限 |
8.4 它在 PhysioNet 的位置
PhysioNet 上的肌电类资源并不多,高密度的更少。这份数据上线后,成为平台上少见的、把腕部阵列纳入的高密度库。
| 平台内同类 | 位置 | 通道规模 | 访问方式 |
|---|---|---|---|
| 本库 | 前臂加腕部 | 448 | 受限 |
| 前臂高密度库 | 前臂 | 256 | 开放 |
| 常规多通道库 | 前臂 | 数十 | 开放 |
| 临床肌电示例 | 视情况 | 少量 | 开放 |
开放与受限在这里正好形成互补:想练手的用开放的,要做腕部研究的只能走受限这条路。
§9 使用指引
9.1 三种角色的路径
不同角色进这份数据的入口不一样,路径也应该不一样。
| 角色 | 第一件事 | 第二件事 | 不要做的事 |
|---|---|---|---|
| 学生或初学者 | 用开放的同类库跑通流程 | 再申请本库做专项 | 直接上手 113.9 GB |
| 方法研究者 | 读论文方法节确认协议 | 申请并核对头文件 | 假设采样率与通道顺序 |
| 产品工程师 | 先读协议条款 | 评估腕部数据是否够用 | 默认可商用 |
9.2 一条最短的可用流程
从零到第一条可用序列,最短路径是五步。这里的写法假定已获批并已本地化。
#-- 第一步:盘点文件数与人员
ls exp_01/*_emg.dat | wc -l
ls exp_02/*_emg.dat | wc -l
ls exp_03/*_emg.dat | wc -l

#-- 第二步:确认三路齐全,缺一路的段落要剔除
for s in 01 02 03 04 05 06; do
  for src in emg press glove; do
    test -f "exp_01/hdkw_kin_exp01_subj01_${s}_${src}.dat" || echo "缺 ${s} ${src}"
  done
done
盘点完再动手,比中途发现某个重复缺路要好得多。第三步是用 §5.3 的脚本打印通道数与采样率,第四步是用 §5.4 的脚本对齐三路,第五步才进入建模。
9.3 引用方式
两段式引用是 PhysioNet 的惯例:先引数据本身,再引平台。
Zhao, Z., Guo, W., & Zhou, Z. (2025). A database of hand kinematics,
high-density sEMG of forearm and wrist for motion intent recognition
(version 1.0.0). PhysioNet. RRID:SCR_007345.
https://doi.org/10.13026/ch3e-c195

Pollard, T., Moody, B. E., Lehman, L., Gow, B., Fernandes, C., Xie, C.,
Johnson, A., Mark, R. G., & Heldt, T. (2026). PhysioNet as a global
platform for biomedical research. Nature Health.
https://doi.org/10.1038/s44360-026-00096-z
配套的论文也应当引,因为它才是采样率与类别映射的第一手来源。
| 引用对象 | DOI | 用途 |
|---|---|---|
| 数据集 | 10.13026/ch3e-c195 | 说明数据版本 |
| 最新版数据集 | 10.13026/ns35-g888 | 指向可持续更新的入口 |
| 论文 | 10.1038/s41597-025-04749-8 | 说明方法细节 |
| 平台 | 10.1038/s44360-026-00096-z | 说明平台来源 |
9.4 建模时最容易忽略的三件事
第一件是尺度。四百四十八路乘上数千赫兹,一秒钟就是百万级浮点数。深度学习模型如果不用分块与降采样,内存会先炸。
第二件是归一化。各通道的阻抗不同,幅值差异可能达一个数量级,逐通道的标准化几乎是必须的。
第三件是标签。类别映射不在页面里,任何「按顺序切段」的假设都有风险。§4.4 的案例提醒的就是这一点:先对齐、再切分、最后才谈标签。
§10 AI 使用声明
| 项 | 说明 |
|---|---|
| 条目性质 | 数据集介绍,非临床指南 |
| 资料来源 | PhysioNet 官方页面、Europe PMC 论文摘要 |
| 数字口径 | 以官方页面为准,冲突处并列 |
| 未核实项 | 采样率、通道顺序、类别映射、会话间隔 |
| 代码状态 | 结构示范,参数需按本地文件核对 |
| 使用风险 | 受限许可,商用前须读协议原文 |
| 更新策略 | 平台版本变更时复核 |
| 免责 | 选型与合规判断由使用者承担 |
常见误读(避坑清单)
| 常见说法 | 实际 | 证据 |
|---|---|---|
| 「这是光学动捕数据」 | 是数据手套的五路弯曲角 | 官方方法节写明 5DT Data Glove 14 Ultra |
| 「448 就是精确通道数」 | 按阵列规格相加为 452 | 三乘 64 加四乘 65 |
| 「是开放数据」 | 受限访问,须签协议 | 文件目录匿名请求返回 403 |
| 「可以直接拿去训练」 | 原始信号未滤波 | 官方用途说明末段 |
| 「三个人就能泛化到新手」 | 二十一人才谈得上跨人 | 方法节列明 21 人 |
| 「三个会话人数相同」 | 会话三只有十人 | 数据描述节逐文件夹列人数 |
| 「肌电与角度同采样率」 | 角度 200 Hz,力 1000 Hz | 方法节分别写明 |
| 「类别标签在文件名里」 | 文件名只有人、重复、源 | 命名格式四字段 |
| 「二十类手势含左右手」 | 受试者全部右手利 | 方法节 |
| 「手势与屈指的动作数一致」 | 二十对九,后者带两级力 | 摘要 |
FAQ
Q1:这份数据到底是哪一年发布的?
PhysioNet 页面标注 2025 年 1 月 17 日上线,版本 1.0.0。配套论文发表在 Scientific Data 2025 年 3 月号。两者相差两个月,引用时按各自日期写。
Q2:四百四十八个通道怎么分配在前臂和手腕?
前臂三块方形阵列共一百九十二路,腕部四块长条阵列共二百六十路,相加为四百五十二。官方口径是四百四十八,差额四路官方未说明。
Q3:为什么拿不到直接下载链接?
它是 PhysioNet 的受限资源,必须注册、完成培训、签署数据使用协议并获批。匿名访问文件目录会返回 403。
Q4:会话三为什么只有十个人?
官方没有解释。可能是招募不足,也可能是第三次采集只做子集补充。使用时应按十人上限处理,不要假设二十一人都有三次记录。
Q5:手指角度是怎么定义的?
页面只写 finger joint angles,没有说明是哪几个关节、是否已标定到生理角。数据手套的原厂文档与论文方法节是唯一可查来源。
Q6:两级力是什么意思?
九种屈指动作在两种力水平下各做一遍,用于比较同一动作不同力度的肌电与力信号。具体两个力值页面未给。
Q7:能不能用它做跨天鲁棒性研究?
要谨慎。页面没有写三个会话之间的间隔天数,跨天分析的时间轴无从建立。若要做,需先读论文正文。
Q8:和 NinaPro 相比该选哪个?
要人数与类别广度选 NinaPro,要腕部高密度与角度回归选这一份。两者的空白点不同,不存在替代关系。
Q9:原始数据为什么不做滤波?
官方明说是为了保留可测滤波器性能与算法噪声鲁棒性的空间。代价是常规分析前必须自己滤。
Q10:引用时要不要带上论文?
建议带。采样率、通道顺序、类别映射这些页面没写的细节都在论文里,只引数据集会让复现者缺信息。
Q11:它有没有覆盖截肢者?
没有。全部为健康受试者。假肢控制的临床问题在这份数据里没有样本。
Q12:浏览数能说明它受欢迎吗?
不能。四百四十三次浏览说明被注意到,不等于被使用。第三方复现需要检索引用文献才能判断。
术语表
| 术语 | 英文 | 含义 |
|---|---|---|
| 表面肌电 | sEMG | 从皮肤表面记录的肌肉电活动 |
| 高密度肌电 | HD-sEMG | 用阵列在皮肤上密集布点记录 |
| 前臂 | forearm | 肘到腕的一段,肌电采集的传统位置 |
| 远场电位 | far-field potential | 肌肉电位传至腕部后的衰减形态 |
| 近场电位 | near-field potential | 电极紧贴肌肉时的记录形态 |
| 运动单位 | motor unit | 一个运动神经元与其支配的肌纤维 |
| 运动单位分解 | MU decomposition | 从高密度肌电中反推单个运动单位放电 |
| 数据手套 | data glove | 戴在手上、输出指关节弯曲的传感器 |
| 等长收缩 | isometric contraction | 肌肉发力但不改变长度的收缩 |
| 比例控制 | proportional control | 输出连续量而非离散类别的控制方式 |
| 电极位移 | electrode shift | 重新贴附时电极相对肌肉位置的改变 |
| 受试者 | subject | 参与采集的人 |
| 会话 | session | 一次完整的采集流程 |
| 重复 | repetition | 同一动作在同一会话内重复执行的一次 |
| 记录 | record | WFDB 中的一个完整数据单元 |
| 头文件 | header file | 声明采样率、通道数、增益的文本文件 |
| 受限访问 | restricted access | 须授权才能获取的数据访问方式 |
| 数据使用协议 | data use agreement | 规定使用范围与责任的书面协议 |
| 伦理批件 | ethics approval | 研究伦理委员会出具的批准编号 |
| 尺度 | scale | 数据的量纲与数值范围 |
| 泛化 | generalization | 模型在未见数据上的表现 |
| 迁移 | transfer | 在一个条件训练、在另一个条件使用 |
| 串扰 | crosstalk | 相邻肌肉电位互相污染 |
| 生物特征 | biometric | 可用于身份识别的生理特征 |
| 参考文献 | reference | 论文所引的他人工作 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 受试者 | 21 | 方法节 | 官方页面 |
| 性别与年龄 | 19 男 2 女;26.47 ± 3.71 岁 | 方法节 | 官方页面 |
| 肌电通道 | 448 | 摘要与描述节 | 官方页面 |
| 前臂阵列 | 3 块 8×8 | 方法节 | 官方页面 |
| 腕部阵列 | 4 块 5×13 | 方法节 | 官方页面 |
| 手势类别 | 20 | 摘要 | 官方页面 |
| 屈指动作 | 9 | 摘要 | 官方页面 |
| 力水平 | 2 | 摘要 | 官方页面 |
| 重复数 | 6 | 描述节 | 官方页面 |
| 会话一体积 | 55.1 GB | 描述节 | 官方页面 |
| 会话二体积 | 40.1 GB | 描述节 | 官方页面 |
| 会话三体积 | 18.7 GB | 描述节 | 官方页面 |
| 会话与人数的对应 | 21、21、10 | 描述节 | 官方页面 |
| 手套采样率 | 200 Hz | 方法节 | 官方页面 |
| 力采样率 | 1000 Hz | 方法节 | 官方页面 |
| 肌电采样率 | 未给 | 全文未见 | 未核实 |
| 伦理编号 | E20230257I | 方法节 | 官方页面 |
| 浏览数 | 443 | 页面侧栏 | 官方页面 |
附录 B:数字的来源分层
| 层级 | 定义 | 本库中的例子 |
|---|---|---|
| 官方页面 | 页面文字直接写明 | 人数、通道数、体积、采样率 |
| 论文摘要 | Europe PMC 收录的摘要 | 三项任务可用性、远场近场的动机 |
| 推算 | 由官方数字相加相乘得出 | 452 通道、文件数 126 与 60 |
| 未核实 | 页面与摘要都没有 | 肌电采样率、类别映射、会话间隔 |
界限要划清:附录 A 里每一条都标了层级。标为推算的那一行,其分量低于标为官方页面的行。使用者引用时,尽量引用官方层级的数字。
附录 C:完整参考文献
| 编号 | 文献 | 用途 |
|---|---|---|
| R1 | Zhao Z, Guo W, Zhou Z. A database of hand kinematics, high-density sEMG of forearm and wrist for motion intent recognition. PhysioNet, v1.0.0, 2025. doi:10.13026/ch3e-c195 | 数据集本体 |
| R2 | Zhao Z, Guo W, Zhou Z. Hand kinematics, high-density sEMG comprising forearm and far-field potentials for motion intent recognition. Sci Data, 2025, 12(1). doi:10.1038/s41597-025-04749-8 | 方法细节 |
| R3 | Pollard T, et al. PhysioNet as a global platform for biomedical research. Nature Health, 2026. doi:10.1038/s44360-026-00096-z | 平台来源 |
| R4 | Malešević N, et al. A database of high-density surface electromyogram signals comprising 65 isometric hand gestures. Sci Data, 2021, 8(1). | 高密度前臂库 |
| R5 | Mendez Guerra I, et al. Far-field electric potentials provide access to the output from the spinal cord from wrist-mounted sensors. J Neural Eng, 2022, 19(2). | 远场电位依据 |
| R6 | Botros FS, Phinyomark A, Scheme EJ. Electromyography-based gesture recognition: is it time to change focus from the forearm to the wrist? IEEE Trans Ind Informatics, 2022, 18(1) | 位置转向 |
| R7 | He J, Jiang N. Biometric from surface electromyogram: feasibility of user verification and identification based on gesture recognition. Front Bioeng Biotechnol, 2020, 8. | 受限许可的背景 |
附录 D:任务代码
给三种常见任务各一段最短代码。全部以已本地化的文件为前提。
#-- 任务一:手势分类的分人交叉验证骨架
import numpy as np
from sklearn.model_selection import GroupKFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

def load_set(paths):
    X, y, g = [], [], []
    for p in paths:
        sig, f = wfdb.rdsamp(str(p))
        subj = p.stem.split('_')[2]
        win = int(f['fs'] * 0.2)                 #-- 200 毫秒窗
        for i in range(0, len(sig) - win, win):
            seg = sig[i:i + win]
            X.append(np.concatenate([seg.mean(0), seg.std(0)]))
            y.append(0)                          #-- 占位,需按类别映射替换
            g.append(subj)
    return np.array(X), np.array(y), np.array(g)

X, y, g = load_set(sorted(Path('exp_01').glob('*_emg.dat'))[:6])
clf = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
for tr, te in GroupKFold(n_splits=3).split(X, y, g):
    clf.fit(X[tr], y[tr])
    print(clf.score(X[te], y[te]))
#-- 任务二:把角度当回归目标,先看标签的量纲是否合理
import numpy as np
import wfdb

glove, fg = wfdb.rdsamp('exp_01/hdkw_kin_exp01_subj01_01_glove')
print('通道数', glove.shape[1], '采样率', fg['fs'])
print('每路最小值', np.round(glove.min(0), 3))
print('每路最大值', np.round(glove.max(0), 3))
print('量纲', fg['units'])
#-- 任务三:检查同一动作在两级力下的角度是否几乎不动
import numpy as np
import wfdb

ang, fa = wfdb.rdsamp('exp_01/hdkw_kin_exp01_subj01_01_glove')
frc, ff = wfdb.rdsamp('exp_01/hdkw_kin_exp01_subj01_01_press')
n = min(len(ang), len(frc))
ang, frc = ang[:n], frc[:n]
#-- 等长段里角度应在小范围内波动,而力应有明显台阶
print('角度逐路标准差', np.round(ang.std(0), 4))
print('力逐路极差', np.round(frc.max(0) - frc.min(0), 3))
三段都只是骨架。真正的标签切分要按论文的类别时序来做,不能按均匀窗口拍脑袋。任务一的标签位置写的是占位零,这不是遗漏,而是刻意留白:类别映射在页面里不存在,任何在此处硬编码的类别编号都会是编造。使用者拿到文件后,应当先用角度信号的形状把每段动作切成起止,再与论文里的动作顺序一一对上,最后才写标签。
任务三的回答值得提前说一句:等长段的角标准差会明显小于力极差,这是等长设计的直接体现,也是这份数据能同时支撑角度与力两条回归通路的原因。如果反过来——角度在力变化时大幅摆动——就说明受试者没有真正保持等长,那一段的力标注就不可信。这种自检不依赖任何外部真值,只看两路信号的相对形态。
附录 E:如果只记五件事
| 序 | 一句话 |
|---|---|
| 一 | 它是 2025 年 1 月上线的高密度肌电库,二十一人,四百四十八通道,前臂加腕部 |
| 二 | 运动学来自五路数据手套,200 Hz;力来自自制测力装置,1000 Hz;肌电采样率页面未给 |
| 三 | 它是受限资源,须签名才能下载,三个文件夹合计一百一十三点九 GB |
| 四 | 原始信号未滤波,想用就得自己滤波;通道数按阵列规格相加为四百五十二 |
| 五 | 它的价值在位置独占——同时覆盖前臂与腕部并配齐角度与力,别处没有 |
编辑说明
本篇的核验方式是抓取 PhysioNet 项目页与 Europe PMC 摘要各一次,未申请数据访问,因此未见到任何真实文件。文稿中所有涉及文件内部结构的描述(头文件字段、通道顺序、类别映射)均为按 WFDB 规范与官方文字做的结构示意,不构成对该文件内容的陈述。
三处未覆盖值得记录:一是肌电采样率的真实值,页面全文未见;二是手势类别与文件段的对应关系,页面未列、摘要未列;三是三个会话之间的间隔天数,同样缺位。这三项都要靠获批下载加论文正文才能补齐,本篇按「未核实」标注,未做推断填补。
数字口径上,通道数并列了 448 与 452 两个值。前者是官方口径,后者是按阵列规格相乘相加得出的推算值,差额四路未说明。条目内未对两者判定对错,使用者按头文件实际声明为准。
标题与正文中出现的「四百四十八通道」是中文概数写法,与速览表和附录中的精确值一一对应,不构成第二个口径。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- body-sway-music-vr — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- olst-mocap-forceplate-radar — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- grabmyo-flow — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- openbiomechanics — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- live-gaitneurokids — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- multimodal-gait-dataset — 共享标签:生理信号 / 步态与运动 / 可穿戴传感 / 多模态
- wesad — 共享标签:生理信号 / 可穿戴传感 / 多模态
- eeg-eye-gaze-data — 共享标签:生理信号 / 可穿戴传感 / 多模态
- ppg-dalia — 共享标签:生理信号 / 步态与运动 / 可穿戴传感
- culm — 共享标签:生理信号 / 步态与运动 / 可穿戴传感
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
