信息速览
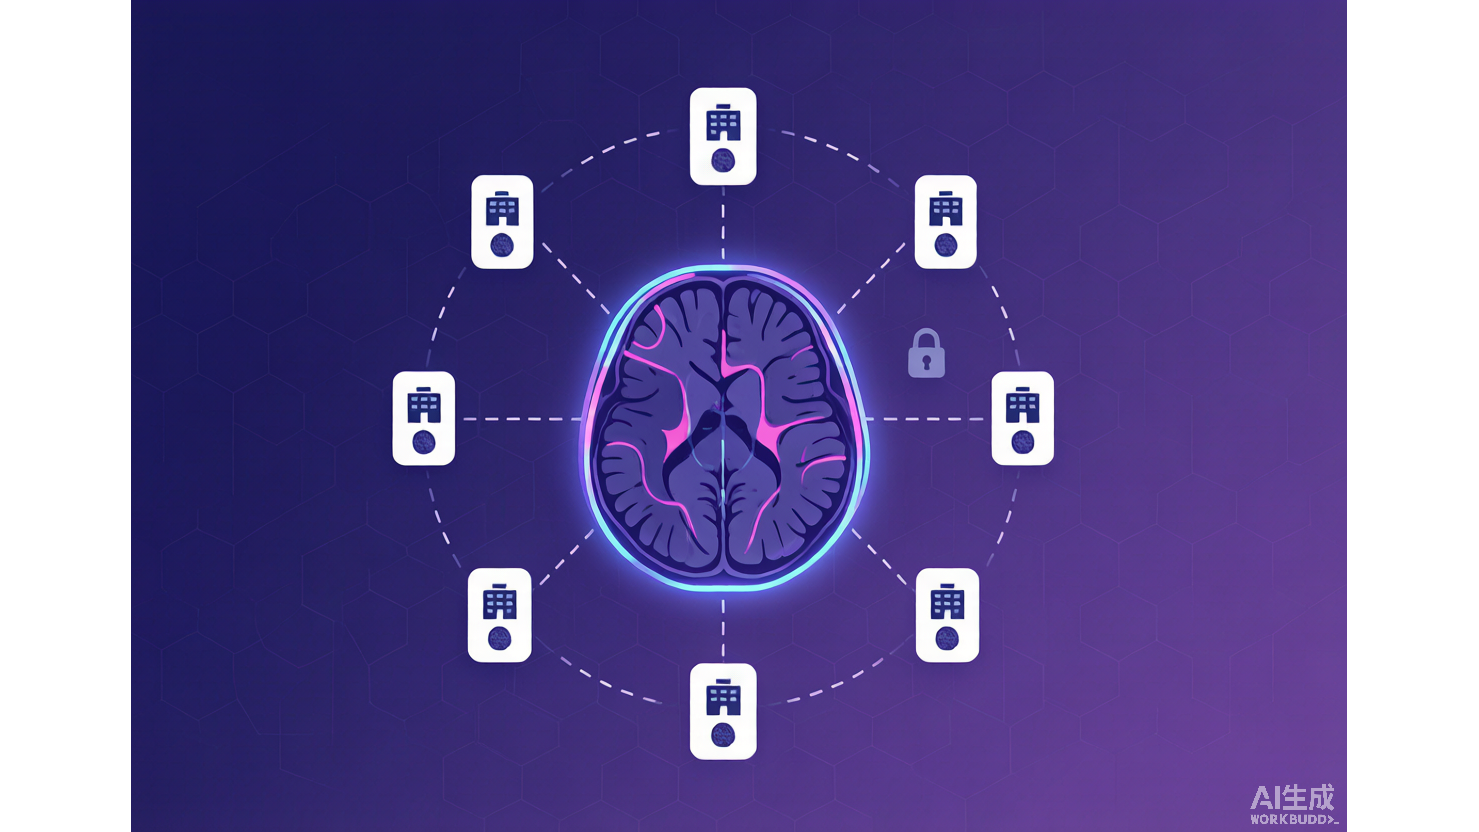
FeTS — 跨机构联邦脑肿瘤分割 MRI 数据集 AI-Ready Wikipedia
INFOBOX
| 字段 | 内容 |
|---|---|
| 数据集名称 | FeTS Initiative |
| 英文全称 | Federated Tumor Segmentation (FeTS) Initiative |
| 别名/简称 | FeTS;FeTS Challenge;FeTS-AI;FeTS 2.0(术后扩展) |
| 疾病分类(ICD-11) | 2A00.00 脑胶质母细胞瘤 |
| SNOMED CT | 39389007(Glioblastoma multiforme) |
| 数据模态 | 脑 MRI(T1 / T1Gd / T2 / T2-FLAIR 四模态) |
| AI 任务类型 | 医学图像分割(多类语义分割 / 联邦学习) |
| 样本总数 | 25,256 例 MRI 扫描 / 6,314 名患者(联邦全量);公开挑战数据 1,251 训练 + 219 验证 |
| 数据格式 | NIfTI(.nii.gz) |
| 许可证 | CC BY 4.0(论文与 TCIA 派生集合);挑战数据须遵循官方引用条款 |
| 访问级别 | 注册后开放(Synapse);Task1/Task2 测试集竞赛专用、不公开 |
| 语言 | 英语 |
| 首发日期 | 2021 年(FeTS Challenge 2021,医学影像领域首个联邦学习挑战赛) |
| 最后更新 | 2025 年 11 月(FeTS 2.0 / FL-PoST 术后扩展发表于 Neuro-Oncology) |
| 发布机构 | FeTS Initiative Consortium(宾夕法尼亚大学佩雷尔曼医学院发起,71 机构) |
| 官方主页 | https://www.fets.ai/ |
| 下载地址 | https://www.synapse.org/fets(Synapse syn29264504,注册后下载) |
| DOI | 10.1038/s41467-022-33407-5(核心论文);同源数据 TCIA DOI 10.7937/jc8x-9874 |
| 引用次数 | 461+(Google Scholar,截至 2026-09) |
| AI 就绪度评分 | ⭐⭐⭐⭐(4/5)— BraTS 协议预处理完备、双官方划分 CSV 齐备、标签协议清晰;联邦分区加载逻辑与 Dice/HD95 指标需自行实现,测试集不公开 |
| 页面状态 | published |
§0 E-E-A-T 审核声明
- 医学审核者:千方病案医学编辑部交叉审核:§2 医学背景(ICD-11 2A00.00 / SNOMED CT 39389007 映射、GBM 流行病学)、§7 偏倚分析。
- 数据工程审核者:千方病案医学编辑部交叉审核(医疗 AI 数据工程师),审核范围:§4 DAIMS 数据字典、§5 数据划分策略、§6 预处理 Pipeline 和坑点。
- 审核日期:2026-09-05
- 数字溯源声明:本页全部规模/性能/日期数字均回溯至官方论文、Zenodo 设计文档、TCIA 集合页或官方 FAQ(详见 §10.3 输入来源列表);检索无法核实的候选数字一律未采用。
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始许可协议。FeTS 挑战数据要求用户在 Synapse 平台注册后下载,且研究使用须引用官方指定的三篇文献(Pati et al. 2021 挑战论文、OpenFL 论文 arXiv:2105.06413、Bakas et al. 2017 Scientific Data);严禁使用额外的公开/私有数据或其预训练模型扩展训练数据。DUO 标签仅供参考,具体使用限制以数据集官方协议为准。
§1 数据集概览
§1.0 30 秒速览
这是什么? FeTS(Federated Tumor Segmentation,联邦肿瘤分割)是宾夕法尼亚大学发起、覆盖 71 家医疗机构和 6 大洲的脑胶质母细胞瘤 MRI 分割数据集联盟。截至 2022 年,它汇集了 25,256 例术前多参数 MRI 扫描,对应 6,314 名患者,是迄今全球规模最大的医学影像联邦学习研究。原始影像分散在各机构本地、从不集中汇集,各机构通过联邦学习只交换模型参数,最终聚合出一个"联邦共识模型"。
为什么重要? 胶质母细胞瘤是最致命的原发性脑肿瘤,但单个机构的病例量太少,训练出的 AI 分割模型泛化能力差。FeTS 用大规模真实世界数据证明了:联邦共识模型在增强肿瘤边界刻画上比单用公开数据训练的模型高出 33%(全肿瘤区域高出 23%),同时患者数据不出院门,为隐私敏感的医疗 AI 协作树立了范本。
我能用它做什么? 通过 Synapse 注册,你可以免费下载公开的挑战数据(1,251 例训练 + 219 例验证),用于脑肿瘤分割算法研发、non-IID 联邦学习实验、域泛化与测试时自适应研究;官方还提供两种联邦划分文件(partitioning_1.csv / partitioning_2.csv),让你在自己的机器上就能复现"机构间数据极度不均衡"这一真实联邦场景。
§1.1 技术摘要
FeTS 数据管线以 BraTS 生态为基座:每个参与机构按 BraTS 协议完成预处理——刚体配准至 SRI-24 模板(采用 Greedy 微分同胚配准算法)、重采样为 1mm³ 各向同性体素、以引入脑形状先验的深度学习算法去颅骨——随后仅上传承准后的 NIfTI 体数据与三层结构标注(坏死核心 NCR=1、瘤周水肿 ED=2、增强肿瘤 ET=4)。联盟层面由 OpenFL 负责联邦编排、GaNDLF 负责深度学习建模,训练出的共识模型经 71 机构独立验证集评估。2022 年起,联盟从公开 BraTS 2021 同源数据切出 1,251 例训练集(23 个站点、两种官方划分)与 219 例验证集,叠加组织方持有的 570 例(Task1)与 2,625 例(Task2,32 站点、数据留在数据所有方本地)测试集,构成医学影像领域首个联邦学习挑战赛的完整基准闭环。2025 年发表的 FeTS 2.0(FL-PoST)进一步将场景扩展到 53 机构的 10,208 个术后随访时间点。
工程上,FeTS 把"数据治理"与"模型训练"解耦成三层开源栈:底层 OpenFL 只负责联邦聚合与通信,中层 GaNDLF 封装分割网络、增强与指标,顶层 MedPerf(MLCommons)提供跨研究可复用的基准执行环境。这一架构让任何新机构可以在不改动训练代码的前提下接入联盟,也让外部研究者可以在单机上用同一套划分文件复现 non-IID 实验以及与官方论文直接可比的指标口径(Dice / HD95 / Sensitivity / Specificity 作用于 ET/TC/WT 三区域)。
§1.2 战略价值
隐私计算与医疗 AI 的交汇样本。FeTS 是第一个在真实多机构网络上跑通"数据不动模型动"全流程的公开研究:25,256 例扫描分属 71 个数据中心,联邦训练期间没有任何一例原始影像离开所属机构。对政策研究者与合规团队而言,它是"联邦学习能否真正提升临床级模型"这一问题的最强实证——共识模型相对公开数据模型在增强肿瘤(可手术切除靶区)上提升 33%,直接回答了"值得做"的问题。对工程团队而言,OpenFL + GaNDLF + MedPerf(MLCommons)三层开源栈构成了可复用的医疗联邦学习基础设施模板。
non-IID 研究的天然高压测试场。真实医疗数据的机构间差异远超学术想象:FeTS 2022 训练集中最大分区含 511 例与 382 例,其余每个分区不足 50 例。官方甚至提供两种划分文件——partitioning_1.csv 按来源机构自然划分、partitioning_2.csv 将 5 个最大机构按全肿瘤体积中位数再拆分——让研究者可以系统比较"机构划分"与"病量划分"对联邦收敛、公平性与泛化的影响。这是罕见地由官方背书、可直接下载的 non-IID 划分资产。
罕见病数据规模的破局范式。GBM 属于低发病率病种,任何单一中心十年积累的病例也难以支撑稳健的深度模型;FeTS 用 461+ 次引用(截至 2026-09)证明了"联盟化采集 + 隐私-preserving 训练"可以撬动原本不可达的数据规模。这一范式已被后续项目(儿科肿瘤联邦、术后队列 FL-PoST)复制,研究者在为本中心稀缺病种争取数据规模时,FeTS 是最有说服力的先例与蓝图。
§1.3 同类数据集横向对比
| 数据集 | 规模 | 模态 | 标注 | 与 FeTS 的差异化 |
|---|---|---|---|---|
| FeTS(联邦全量) | 25,256 扫描 / 6,314 患者 / 71 机构 | T1、T1Gd、T2、T2-FLAIR | 1-4 名标注者/例,认证神经放射科医师核准 | 联邦非池化,数据留本地;仅挑战子集公开 |
| BraTS 2021(同源公开数据) | 1,251 例(FeTS 挑战训练口径) | 同上,同协议 | 同上(60 名 ASNR 志愿医师参与) | 集中式池化版本;TCIA DOI 10.7937/jc8x-9874 免费获取 |
| MU-Glioma-Post(TCIA) | 203 受试者 / 2,978 studies / 11 GB | 术后多参数 MRI | 术后腔体与复发标注 | FeTS 2.0 术后方向的外部验证资源;CC BY 4.0 |
| FeTS 2.0 / FL-PoST | 53 机构 / 10,208 术后时间点 | 术后多参数 MRI | NE/TIE/ET/RC 四类标签 | 术后场景,联盟口径,测试集不公开 |
| Ivy GAP(TCIA) | 联盟参与队列之一 | T1、T1Gd、T2、T2-FLAIR + 组学 | 基因组注释关联 | 具名参与机构,适合机制研究补充 |
§1.4 版本时间轴
| 年份 | 版本/事件 | 关键内容 |
|---|---|---|
| 2020 | 可行性研究 | Sheller et al. 在 Scientific Reports 发表模拟联邦学习研究(DOI 10.1038/s41598-020-69250-1),验证联邦与集中式训练等效性 |
| 2021 | FeTS Challenge 2021 | 医学影像领域首个联邦学习挑战赛(arXiv:2105.05874);首个共识模型(23 机构 / 2,200 患者)在 55 机构参与的队列识别基础上完成 |
| 2022-10 | FeTS 工具论文 | 联邦工具链论文发表于 Physics in Medicine & Biology(DOI 10.1088/1361-6560/ac9449) |
| 2022-12 | 71 机构里程碑 | Pati et al. Nature Communications 13:7346:71 机构 / 25,256 扫描 / 6,314 患者,ET +33%、WT +23% |
| 2022 / 2024 | 挑战迭代 | 训练集扩至 1,251 例(较 2021 约 ×4)、验证 219 例、测试 570 + 2,625 例(Zenodo 设计文档 6622476) |
| 2025-11 | FeTS 2.0 / FL-PoST | 术后胶质母细胞瘤联邦分割:53 机构 / 10,208 个术后时间点,DSC:TIE 0.95 / ET 0.94 / RC 0.89 / NE 0.77 |
| 2025 | 挑战总结 | Nature Communications 发表 2022/2024 双年挑战总结(DOI 10.1038/s41467-025-60466-1):41 个被评估模型中仅 5 个为 Task2 原始提交 |
§1.5 典型应用场景
- 联邦学习算法研究:在官方两种划分文件上复现 non-IID 场景,测试 FedAvg、FedProx、Scaffold、测试时自适应(TTA)等算法的收敛与公平性表现。
- 官方 Task1 赛道将通信成本(字节数 × 轮数)纳入排名,天然适配通信高效算法研究。
- 脑肿瘤分割模型研发:以 1,251 例训练 + 219 例验证开发 U-Net 类分割网络,用 NCR/ED/ET 三层协议对齐临床关心的 WT/TC/ET 三区域指标。
- 与 BraTS 2021 同源,历史 BraTS 方案可作为起点基线,对比实验设计成本低。
- 域泛化与分布偏移研究:利用机构间极端体量不均(511 例 vs <50 例)模拟真实部署中的站点偏移,评估跨站点泛化缺口。
- 官方挑战总结将站点级 TTA 列为有效方向,社区已有获奖实践可对照。
- 医疗隐私计算教学:OpenFL + GaNDLF 全开源栈可直接部署,是联邦学习课程与隐私计算培训的理想实操素材。
- 数据全部 NIfTI 且预处理完备,学生可在数小时内跑通端到端联邦 demo。
- 术后复发分割预研:以 FeTS 2.0 协议(NE/TIE/ET/RC)为参照,结合 MU-Glioma-Post 公开集开展术后肿瘤腔与复发区域模型预研。
- MU-Glioma-Post(203 受试者 / 2,978 studies,CC BY 4.0)提供可下载的术后标注对照资源。
§2 医学背景
§2.1 ICD-11 编码映射
| 编码 | 层级 | 名称 | 与本数据集的关系 |
|---|---|---|---|
| 2A00.00 | ICD-11 有效码 | 脑胶质母细胞瘤(Glioblastoma of brain) | 全部 6,314 名患者的主要诊断,也是 FeTS 联盟的单一纳入病种 |
| 2A00.0 | ICD-11 节点码 | 脑胶质瘤(Gliomas of brain) | 2A00.00 的上级节点,涵盖弥漫性与局限性胶质瘤 |
| XH5571 | ICD-11 扩展码 | Glioblastoma, IDH-wild type | WHO CNS5 分子分型下的成人主导亚型,多数 FeTS 病例归属此型 |
| C71.x | ICD-10 对应码 | 脑恶性肿瘤 | 与 ICD-11 2A00 系列双向映射,便于历史病历数据对接 |
编码使用提示:写论文或做院内数据对接时,主诊断码用 ICD-11 2A00.00(或 ICD-10 C71.9 视系统而定);若需表达分子分型,叠加扩展码 XH5571(IDH-wild type)而不是把分型写进主码。FeTS 论文本身按 WHO CNS5 与临床语义使用"GBM"总称,公开数据不携带逐例 ICD 编码字段。
§2.1b SNOMED CT 映射
| 标签/概念 | ICD-11 | SNOMED CT 码 | 术语 |
|---|---|---|---|
| 整体诊断(纳入标准) | 2A00.00 | 39389007 | Glioblastoma multiforme |
| 坏死核心(NCR,标签 1) | — | 43101001 | Necrosis(形态学改变,对应肿瘤内坏死区域) |
| 瘤周水肿(ED,标签 2) | — | 79654002 | Edema(水肿,含浸润性瘤周区域) |
| 增强肿瘤(ET,标签 4) | — | 39389007(病灶活性组分) | Contrast-enhancing tumor,对应血脑屏障破坏的强化活性区 |
映射说明:SNOMED CT 中无与"分割标签"一一对应的独立概念码,NCR/ED/ET 三行分别映射到最贴近的形态学/病变概念,用于电子病历侧的术语对接;整体诊断行(39389007)是 FeTS 队列的唯一纳入病种码,可直接用于队列检索与注册库联动。临床系统中落地时,建议以"诊断码 39389007 + 分割标签枚举(NCR/ED/ET)"的组合表达完整语义,而非为标签虚构新的 SNOMED 码。
§2.2 疾病简介与流行病学
胶质母细胞瘤(GBM)是 WHO 中枢神经系统肿瘤分类(第五版,2021)下的 IV 级恶性星形细胞肿瘤,也是成人最常见的原发性恶性脑肿瘤。全球年发病率约 3.0/10 万(美国约 3.2/10 万),中位生存期在标准治疗(最大安全切除 + 放化疗 + 替莫唑胺)下仍仅约 15 个月上下。WHO CNS5 将成人弥漫性胶质瘤按 IDH 突变状态与 1p/19q 共缺失重新分型,IDH 野生型 GBM(ICD-11 扩展码 XH5571)是其中预后最差、占比最高的亚型,也是 FeTS 联盟病例的主体。由于发病率低、单中心年收治量有限,任何单一机构都难以积累足够多样性的 GBM 影像——这正是 FeTS 选择联邦学习架构的临床动因。
从治疗流程看,GBM 的临床决策链在多个环节依赖 MRI 定量:术前确定可切除范围与入路(依赖增强肿瘤 ET 边界)、术后放疗靶区勾画(依赖全肿瘤 WT 与瘤周水肿 ED 范围)、随访鉴别真性进展与假性进展(依赖 ET 体积的纵向变化)。分割精度在这三个环节上的误差会逐级放大——这也是 FeTS 把"增强肿瘤边界"作为核心指标(ET 区域提升 33%)的临床含义所在。
§2.3 临床任务定义
- 分割(本数据集核心任务):在术前多参数 MRI 上逐体素划分三类结构——坏死核心(NCR)、瘤周水肿(ED)、增强肿瘤(ET),并组合出三个临床区域:全肿瘤 WT = NCR+ED+ET、肿瘤核心 TC = NCR+ET、增强肿瘤 ET。WT 对应手术与放疗靶区外扩依据,ET 对应可手术切除靶区与治疗反应评估。
- 诊断与分级(衍生任务):分割结果可量化肿瘤体积、增强比例与水肿浸润范围,辅助 WHO 分级与 MDT 讨论,但不直接输出组织病理诊断。
- 预后与疗效评估(衍生任务):纵向随访中 ET 体积变化是假性进展与真性进展鉴别的重要影像学输入;FeTS 2.0 将此扩展为术后 NE/TIE/ET/RC 四类分割。
- 任务边界声明:本数据集不覆盖筛查场景(GBM 无有效早筛路径),也不提供组织病理切片;"分级"只能以 WHO CNS5 分子分型的文献背景呈现,公开数据不含逐例 IDH/1p19q 状态字段。
§2.4 患者人群画像
| 维度 | 联邦全量(71 机构) | 2022 挑战 Task2 测试人群(32 站点) |
|---|---|---|
| 病种 | 胶质母细胞瘤(ICD-11 2A00.00) | 同左 |
| 扫描时点 | 术前基线(FeTS 1.0) | 术前基线(Task2 含 BraTS 2021 + FeTS 联邦数据) |
| 样本量 | 25,256 扫描 / 6,314 患者 | 2,625 例测试扫描(数据留在 32 个数据所有方本地) |
| 年龄 | 各机构回顾性队列,覆盖成人为主 | 5–94 岁(均值 56.9 岁) |
| 性别 | 队列级统计不公开 | 女性占 39.7% |
| 地域 | 6 大洲 71 机构(北美、欧洲为主) | 站点/地理分布严重不均,欠代表地区性能偏低 |
| 就医类型 | 三级转诊与神经肿瘤专科中心 | 同左(学术医学中心为主) |
解读要点:上表两列分别是"联盟内不可下载的全量口径"与"挑战评测人群口径",两者不可混用;公开数据(1,251 + 219)的人群画像需以训练元数据为准,官方未发布逐例人口学字段,任何"公开数据的年龄/性别分布"表述均无出处,分析时应显式声明该局限。
§2.5 临床价值
精确的 GBM 分割是放疗靶区勾画、手术计划与治疗反应评估的共同上游。人工勾画一名患者全肿瘤通常需要临床医生 30 分钟以上的逐层操作,且不同医师间差异显著;稳定的三维自动分割可将这一流程压缩到秒级并提供可重复的体积基线。FeTS 的贡献在于证明:只有把几十家机构的病例在不动原始数据的前提下联合起来,模型才能在"增强肿瘤边界"这一最影响手术与疗效判断的区域上达到跨中心稳健(ET +33%)。对参与机构而言,联邦共识模型等价于"用全联盟的经验增强本中心的科室工具",同时满足 HIPAA/GDPR 类合规约束。
从研究价值看,FeTS 还提供了一个可复用的"联盟运营方法论":机构招募(55 机构参与队列识别 → 71 机构正式贡献)、协议统一(BraTS 协议 + 伪 ID 机制)、质量双审(标注者 + 认证医师核准)、以及把挑战赛作为外部质量控制环节(两届挑战赛 + 2025 年总结论文)。后续任何想做"多中心影像联盟"的团队,其数据治理章程几乎都可以从 FeTS 的公开文档出发裁剪。
§2.6 金标准对照
| 维度 | 本数据集(FeTS) | 说明 |
|---|---|---|
| 划分方式 | 联邦按机构划分(partitioning_1.csv 自然划分 / partitioning_2.csv 体量再拆分) | 官方两种 CSV 直接提供 subject→partition 映射 |
| 标注方式 | 人工多层标注 + 组合区域算法生成 | 0 背景 / 1 NCR / 2 ED / 4 ET;WT、TC 为组合派生 |
| 标注者 | 每例 1-4 名标注者,全部经资深认证神经放射科医师核准 | BraTS 2021 侧:60 名 ASNR 志愿医师标注,每例 ≥2 名且至少 1 名具 ≥13 年经验的认证医师核准 |
| 金标准性质 | 专家核准的体素级多层分割 | 与 BraTS 协议完全兼容,可与 BraTS 历史结果直接对话 |
对照解读:与常见的"队列型"临床数据集(如 EHR 登记)不同,FeTS 的金标准是体素级、多层、可复算的分割掩码,且核准人资质有明确数字锚点(≥13 年经验认证医师);这使它同时满足算法监督学习与临床靶区勾画两种金标准要求,代价是标注成本高、公开规模受限(1,470 例公开 vs 25,256 例联邦)。
§3 数据集规格
§3.0 版本抉择矩阵
| 你的需求 | 推荐版本 | 大小 | 理由 |
|---|---|---|---|
| 快速上手分割算法(无需联邦) | FeTS 2022 挑战训练+验证集(Synapse syn29264504) | 数 GB 量级 NIfTI 压缩包 | 1,251 训练 + 219 验证,集中式下载,与 BraTS 2021 协议兼容 |
| 与 BraTS 历史结果对话 | BraTS 2021 同源数据(TCIA DOI 10.7937/jc8x-9874) | 数 GB 量级 | 免费直接下载,可与 FeTS 挑战数据互相印证 |
| non-IID 联邦学习实验 | 上述训练集 + partitioning_1.csv / partitioning_2.csv | CSV 数十 KB | 官方背书的两种机构划分,最大分区 511 例、其余 <50 例 |
| 联邦全流程复现(含编排) | FETS-AI/Challenge 代码库 + OpenFL + GaNDLF | 代码仓库 | 官方训练/评估管线完整开源(BSD/Apache-2.0 混合许可) |
| 术后复发分割研究 | FeTS 2.0 / FL-PoST(联盟口径) | 测试集不公开 | 53 机构 / 10,208 术后时间点;公开替代资源为 MU-Glioma-Post |
| 长期外部验证 | MU-Glioma-Post(TCIA DOI 10.7937/7K9K-3C83) | 11 GB | 203 受试者 / 2,978 studies,CC BY 4.0,术后场景独立队列 |
§3.1 模态详情
| 序列 | 全称 | 作用 | 预处理后特性 |
|---|---|---|---|
| T1 | T1 加权像 | 解剖结构基准 | 1mm³ 各向同性、SRI-24 模板空间 |
| T1Gd | 钆对比增强 T1 加权像 | 勾画增强肿瘤(ET)与肿瘤核心(TC) | 同上;血脑屏障破坏区高信号 |
| T2 | T2 加权像 | 水肿与囊变成分区分 | 同上 |
| T2-FLAIR | T2 液体衰减反转恢复像 | 瘤周水肿(ED)敏感序列 | 同上;脑室信号被抑制 |
四序列共享同一 SRI-24 模板空间矩阵,任何一例的四个 NIfTI 文件几何信息完全对齐,可直接逐体素堆叠为 4 通道输入。注意:T1-FLAIR 序列被官方刻意排除在 FeTS 数据协议之外(与部分 BraTS 衍生集合不同),自建管线时不要按四模态之外的扩展预期设计输入维度。
预处理链的三项操作各有讲究:①Greedy 微分同胚配准是 SRI-24 实验室的官方工具,刚体(6 自由度)而非仿射,保证肿瘤解剖不被形变扭曲;②1mm³ 重采样统一了不同扫描仪的层厚/层间距差异,使所有例共享 (240, 155, 240) 量级的矩阵尺寸;③去颅骨采用引入脑形状先验的深度学习算法而非传统形态学,避免大体积肿瘤贴骨生长时被误切。这三步在数据发布前已经完成,使用者不应重复执行,也无需安装 Greedy 工具链。
§3.2 按子集样本数
| 子集 | 例数 | 站点数 | 可获取性 | 用途 |
|---|---|---|---|---|
| 挑战训练集(2022) | 1,251 | 23(partitioning 1) | Synapse 注册后下载(公开 img+seg) | 模型开发 |
| 挑战验证集(2022) | 219 | — | Synapse 注册后下载(公开 img,不含标注与站点伪 ID) | 在线评测提交 |
| Task1 测试集 | 570 | 组织方持有 | 不公开 | 挑战最终评测 |
| Task2 测试集 | 2,625 | 32(数据所有方本地) | 不公开(数据留各机构) | 联邦分布式评测 |
| 联邦全量(截至 2022) | 25,256 扫描 / 6,314 患者 | 71 / 6 大洲 | 联邦口径,从不池化 | 联邦共识模型训练 |
| 2024 挑战数据(syn54079892) | 2024 口径 | — | Synapse 注册后下载 | 2024 届挑战复现 |
口径提示:子集数字分属两套体系——联邦体系(25,256/6,314/71 机构)见 Nature Communications 2022;挑战体系(1,251/219/570/2,625)见 Zenodo 设计文档与 2025 挑战总结 Table 3。任何"训练集到底多大"的讨论都必须先声明用的是哪套体系。
§3.3 数据格式
| 项目 | 规格 |
|---|---|
| 体数据格式 | NIfTI-1(.nii.gz,gzip 压缩) |
| 划分文件 | CSV(partitioning_1.csv / partitioning_2.csv,subject→partition 映射) |
| 体素尺寸 | 1mm × 1mm × 1mm(各向同性,统一重采样) |
| 坐标空间 | SRI-24 模板空间(Greedy 微分同胚刚体配准) |
| 标签编码 | uint8:0 背景 / 1 NCR / 2 ED / 4 ET(无 3,见 §6.5 坑点 3) |
| 序列组合 | 每例 4 模态(T1、T1Gd、T2、T2-FLAIR)+ 1 标签体 |
| 文件命名 | {subject_id}_{modality}.nii.gz;subject_id 含时间点后缀(如 UPENN-GBM-00006_11) |
| 配套元数据 | partitioning_1.csv / partitioning_2.csv(subject → partition 映射) |
§3.4 存储大小
官方未发布统一的挑战数据压缩包字节数。可参考的量级锚点:同为术后队列的 MU-Glioma-Post 派生集合为 2,978 studies 共 11 GB;FeTS 挑战训练集(1,251 例 × 5 个体文件,1mm³ 去颅骨脑区)与 BraTS 2021 同源,典型压缩包为数 GB 量级。建议按磁盘剩余 50 GB 规划训练环境(解压副本 + 缓存 + 派生特征)。
工程建议:NIfTI 逐例小文件(每例 5 个 .nii.gz)在对象存储上逐文件拉取效率低,推荐整包下载后本地一次性解压;若团队共享,可在内网自建只读镜像并在 README 中登记版本(syn29264504 或 syn54079892),避免多版本混用导致的"幽灵指标"问题。
§3.5 标注方式
人工多层标注:每例由 1-4 名标注者逐体素勾画 NCR/ED/ET 三层结构,标注结果全部经资深认证神经放射科医师核准后进入数据集。WT 与 TC 两个临床区域不单独标注,由三层标签按位组合派生(WT = 1+2+4,TC = 1+4)。这一"三层原始 + 组合派生"的设计保证了一致性:任何方法学论文只需对齐三层原始标签即可复算所有官方区域指标。
对迁移使用者的一点提醒:从其他脑肿瘤数据集(如自建院内数据)迁移到 FeTS 时,若你的历史标注只区分"肿瘤/水肿"两类,需要先做标签映射审计(旧"肿瘤"是否包含坏死?旧"水肿"是否含增强区?),再决定映射到 WT 还是 TC——直接拿历史掩码当 WT 用是常见的语义错位来源。
§3.6 标注者资质与一致性
BraTS 2021 同源标注由 60 名美国神经放射学会(ASNR)志愿医师参与,每例由 ≥2 名医师标注,其中至少 1 名具备 ≥13 年经验的认证神经放射科医师负责核准。FeTS 联邦侧的 71 机构数据沿用同等资质要求(每例 1-4 名标注者 + 认证医师核准)。官方未发布跨标注者 Dice 一致性系数的公开统计,引用时不应臆造该数字。
跨库可比性方面:因 FeTS 与 BraTS 共享同一标注协议与核准流程,两库上的模型性能数字原则上同尺度可比——这也是官方把挑战数据从 BraTS 2021 切出的原因之一(保证"公开基线 ↔ 联邦前沿"对话在同一个标注坐标系内)。与非 BraTS 系数据集比较时,则必须声明标注协议差异。
§3.7 采集周期
联盟数据为多中心回顾性队列:各参与机构按自身临床路径回顾性收集术前基线 MRI,采集年度因机构而异,联盟版数据截至 2021 年完成组版,2022 年 12 月发表核心成果。挑战侧 2021→2022 训练集规模约 ×4 扩容(从 BraTS 2021 同源切分至 1,251 例),复现早期论文时须使用当年划分口径。这一"回顾性累积 + 年度切分"模式意味着:同一 subject 在不同年份的挑战数据中角色可能变化(训练/验证/测试),跨年对账时 subject_id 是唯一可靠锚点。
§3.8 地域覆盖
71 家机构横跨 6 大洲:北美与欧洲机构占主导(具名参与机构包括宾夕法尼亚大学、阿拉巴马大学伯明翰分校、海德堡大学、伯尔尼大学、德布勒森大学、Henry Ford 医院、MD Anderson、Mayo、Duke、UCSF、华盛顿大学、苏黎世大学等),同时包含印度 Tata Memorial、意大利 Besta 神经学研究所等非欧美中心。UCSF 单中心贡献约 400 例。站点/地理分布严重不均,官方挑战总结明确指出欠代表地区的分割性能偏低。
地域使用注意:具名机构列表仅用于描述联盟构成,公开数据不携带逐例机构字段——不要试图按文件名前缀(如 UPENN-)推断"这例来自哪国",UPENN- 前缀只表示该例沿用 UPENN-GBM 系列的受试者编号体系,不代表当前贡献站点。
§3.9 设备规格
数据由各参与机构的临床 1.5T/3T 磁共振扫描仪采集(多厂商多机型),官方协议未公开逐例设备字段。BraTS 协议的配准与重采样已在体数据层面统一了几何属性,因此厂商差异主要体现为对比度与噪声纹理的域偏移,而非分辨率差异——这正是 non-IID 偏倚的主要来源之一(见 §7.1)。做强度域自适应研究时,可以把分区(机构)当作"近似同机型簇"的代理变量使用,但须在论文中声明该代理的局限:同一机构内也可能存在跨年代的多台设备。
§3.10 深度溯源链
临床采集(71 机构,回顾性术前 MRI)
  → 各机构本地脱敏(HIPAA/GDPR 流程,站点以伪 ID 代称)
  → BraTS 协议预处理(Greedy 刚体配准至 SRI-24;1mm³ 重采样;深度学习去颅骨,含脑形状先验)
  → 标注(1-4 名标注者/例)→ 认证神经放射科医师核准
  → 联盟组版(FeTS 1.0 术前;FeTS 2.0 术后为独立协议 NE/TIE/ET/RC)
  → 挑战切分(训练 1,251 / 验证 219 / Task1 测试 570 / Task2 测试 2,625)
  → 公开发布(Synapse syn29264504 注册下载;同源数据经 TCIA DOI 10.7937/jc8x-9874)
溯源链上每个环节都有可查证的公开锚点:预处理协议见官方数据文档与 Nature Communications 2025 挑战总结的方法节;标注资质见 Zenodo 设计文档;分发渠道见 Synapse 与 TCIA。引用本数据集时,建议按"论文(DOI 10.1038/s41467-022-33407-5)+ 数据访问(Synapse syn29264504)+ 同源数据(TCIA DOI 10.7937/jc8x-9874)"三元组完整标注,可覆盖绝大多数期刊的数据可用性声明要求。
§4 数据结构
§4.0 目录树
以下为 Synapse 下载解压后的典型布局(文件名以官方发布实际为准,UPENN-GBM-* 为示例受试者编号,_11 表示术前基线时间点):
FeTS_2022A/
├── partitioning_1.csv              # 官方划分①:按来源机构自然划分
├── partitioning_2.csv              # 官方划分②:5 个最大机构按全肿瘤体积中位数再拆分
├── partition_1/                    # 训练分区 1(最大分区,511 例)
│   ├── UPENN-GBM-00006_11_t1.nii.gz
│   ├── UPENN-GBM-00006_11_t1ce.nii.gz      # T1Gd(注意是 t1ce,不是 t1gd)
│   ├── UPENN-GBM-00006_11_t2.nii.gz
│   ├── UPENN-GBM-00006_11_flair.nii.gz
│   └── UPENN-GBM-00006_11_seg.nii.gz       # 标签:0/1/2/4
├── partition_2/ ... partition_18/          # partition_18 为第二大分区(382 例)
│   └── ...(其余每分区 <50 例)
└── validation/
    ├── ABCD-XXXX_t1.nii.gz         # 验证集:仅影像,无 seg 文件、无站点伪 ID
    └── ...
目录树要点:①训练数据按分区目录组织(partition_1 至 partition_18+),分区数与所选划分文件对应;②_seg.nii.gz 仅存在于训练分区;③验证集文件名与训练集同构,但没有 seg 与站点信息;④一切以 Synapse 项目页随包发布的 README 为准,本树为结构示意。
§4.1 DAIMS 字段字典
| 字段名 | 类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 信息性缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
| subject_id | 文本 | 受试者唯一标识(含时间点后缀) | UPENN-GBM-00006_11 | 主键、患者级分组 | 无 | 无 | 全集唯一 |
| partition_id | 整数 | 联邦分区编号(1-33,两种划分各一套) | 1 | 联邦实验分组 | 无 | 无 | 1 ≤ x ≤ 33 |
| t1 / t1ce / t2 / flair 文件 | 路径 | 四模态 NIfTI 体数据路径 | …_t1ce.nii.gz | 模型输入 | — | — | 每例各 1 个 |
| seg | uint8 体数据 | 三层结构标注 | 0/1/2/4 | 训练目标 | 标注者间变异未公开量化 | 3 不存在(非缺失) | |
| WT | 派生区域 | 全肿瘤 = seg∈ | 二值掩码 | WT 指标计算 | — | — | |
| TC | 派生区域 | 肿瘤核心 = seg∈ | 二值掩码 | TC 指标计算 | — | — | |
| ET | 派生区域 | 增强肿瘤 = seg==4 | 二值掩码 | ET 指标计算 | — | — | |
| 站点伪 ID | 整数(受限) | 机构代称,仅训练元数据可见 | — | 机构级分析 | — | 验证集不含 | 由官方持有 |
| 时间点后缀 | 文本 | _11 为术前基线 |
_11 | 纵向研究分组 | 无 | 无 | 数据集口径内固定 |
字段字典使用提示:seg 的观测误差列留空不是遗漏——官方未公布标注者间一致性系数,任何误差量化都会是编造;同理"站点伪 ID"没有示例值,因为公开数据中该字段被官方持有。这两处留白本身就是 DAIMS 评估中 ⚠️ 项的依据。
§4.2 标签分布与组合规则
| 标签值 | 结构 | 临床含义 | 组合区域 |
|---|---|---|---|
| 0 | 背景 | 非病灶组织 | — |
| 1 | NCR(坏死核心) | 肿瘤内坏死区 | ∈ WT、∈ TC |
| 2 | ED(瘤周水肿/浸润) | T2/FLAIR 高信号瘤周区 | ∈ WT、∉ TC |
| 4 | ET(增强肿瘤) | 钆强化活性肿瘤区 | ∈ WT、∈ TC |
| 3 | (不存在) | 官方协议跳过该值 | — |
三个临床区域按 WT ⊃ TC ⊃ ET 严格嵌套:WT = NCR+ED+ET,TC = NCR+ET,ET 独立。任何预测后处理若破坏该嵌套关系(如 TC 越出 WT),会在官方评测中产生大量假阳性体素(见 §6.5 坑点 7)。
临床含义补充:ED 对应 T2/FLAIR 高信号的非增强浸润区,是放疗靶区外扩的主要依据;TC 覆盖坏死与活性核心,用于消融/活检规划;ET 是钆对比剂渗出的血脑屏障破坏区,对应"可手术切除靶区",也是 FeTS 联邦增益最显著(+33%)的区域。三区域的体积比(如 ET/WT)在临床上是肿瘤异质性的常用代理指标,可直接从 seg 体数据派生。
§4.3 关键统计
- 训练分区体量:partition_1 = 511 例、partition_18 = 382 例,其余每分区 <50 例(2022 训练集,23 站点两种官方划分)。
- 联邦全量:71 机构 / 25,256 扫描 / 6,314 患者,为史上最大规模的联邦学习医学影像研究(截至 2022-12 论文发表)。
- Task2 测试人群:年龄 5–94 岁(均值 56.9 岁),女性 39.7%。
- 标注投入:60 名 ASNR 志愿医师参与标注(BraTS 2021 侧),每例 1-4 名标注者 + 认证医师核准。
用一段代码即可自检你下载的数据是否符合上述统计口径:
# 对账脚本:核对训练分区体量与官方统计一致
import pandas as pd, os

data_root = "data/FeTS_2022A"
for scheme in ["partitioning_1.csv", "partitioning_2.csv"]:
    df = pd.read_csv(os.path.join(data_root, scheme))
    sizes = df.groupby("partition").size().sort_values(ascending=False)
    print(scheme, "->", dict(sizes.head(2)), "| 最小分区:", sizes.min())
    # 预期(partitioning_1):最大两区 511 与 382,其余 <50
    assert (sizes <= 511).all() and sizes.max() == 511, "分区体量与官方口径不符,请检查数据版本"
§4.4 数据层级
患者(6,314 名,联邦全量口径)
  └── MRI 检查(术前基线为主;FeTS 2.0 引入术后随访时间点,53 机构 10,208 个时间点)
        └── 序列(每检查 4 个:T1 / T1Gd / T2 / T2-FLAIR)
              └── 切片(每序列 155 层上下,1mm 各向同性,逐层构成 NIfTI 三维体)
                    └── 体素标签(seg:0/1/2/4)
注意 subject_id 的 _11 后缀标识术前基线时间点;同一患者若进入术后队列(FeTS 2.0 协议),标签体系切换为 NE/TIE/ET/RC,两代数据不可在同一标签空间混合训练。做患者级统计(如"每患者检查数")时,应以去掉时间点后缀的前缀(UPENN-GBM-00006)为分组键,而不是完整 subject_id——两者混淆会把同一患者的多时相检查误计为多名患者。
§4.5 缺失值与信息性缺失
| 情形 | 编码/表现 | 处理建议 |
|---|---|---|
| 标签值 3 | 不存在于任何 seg 体数据 | 属协议设计(0/1/2/4 跳号),非缺失;one-hot 时按 4 类槽位显式映射 |
| 验证集无 seg 文件 | validation/ 目录仅含影像 | 官方设计(防泄漏),在线评测提交而非本地自评 |
| 验证集无站点伪 ID | 元数据不提供机构归属 | 官方设计(防站点过拟合),勿按文件名猜测站点 |
| Task1/Task2 测试集 | 完全不公开 | 通过官方挑战评测通道访问,本地不可得 |
| 站点属性缺失(公开数据) | 无逐例人口学/设备字段 | 机构级分析仅限训练集元数据,跨库合并需自行声明局限 |
处理原则:FeTS 的"缺失"几乎全部是协议设计而非数据缺陷——验证集去标注、去站点 ID、测试集不公开,都是防泄漏的主动隔离。因此正确的应对是"接受隔离、改走官方通道",而不是绕过隔离(如从文件名推断站点、用测试集文件名做特征);后者既违反数据条款,也会让实验结论失真。
§5 数据划分与使用建议
§5.1 官方划分
FeTS 2022 提供两套机构级联邦划分(均为 33 个分区左右、对应 23 站点):
| 划分文件 | 划分逻辑 | 特点 | 适用场景 |
|---|---|---|---|
| partitioning_1.csv | 按来源机构自然划分 | 一机构一/多分区,最大 511 例、其余 <50 例 | 模拟真实联邦部署(站点即分区) |
| partitioning_2.csv | 将 5 个最大机构按全肿瘤体积中位数再拆分 | 削峰、体积双峰分布更均衡 | 研究划分策略对联邦收敛/公平性的影响 |
挑战级划分:训练 1,251(公开 img+seg)→ 验证 219(公开 img)→ Task1 测试 570(组织方持有)+ Task2 测试 2,625(32 站点数据所有方本地评测)。两套划分文件覆盖的均为训练池;验证与测试侧的站点归属不向参与者公开,这是"防站点过拟合"设计的一部分,自建切分时请勿尝试从文件名反推站点。
§5.2 社区惯例与建议
- 集中式基线:忽略分区文件,将 1,251 例训练集合并,按 80/10/10 或 5 折交叉验证切分,作为联邦实验的上界参照(须注意官方条款禁止引入额外数据,不限制内部重组)。
- 联邦实验:忠实使用 partitioning_1.csv 作为主实验(真实 non-IID),partitioning_2.csv 作为对照;报告每分区独立验证指标 + 聚合指标,避免仅报均值掩盖低资源分区劣势。
- 测试时自适应(TTA):2022 挑战总结了 TTA 方向的社区探索(如 Preferred Networks 站点级自适应工作),适合以分区为单位开展。
- 种子实验:单分区(如 partition_2,体量适中)最适合做管线调试与消融实验;调参完成后再扩展到全部分区与两套划分,避免在 1,251 例全量上盲目迭代。
- 指标基线登记:先用 nnU-Net 集中式跑通一次并把结果登记为团队基线,后续所有联邦实验的增益/损耗都相对这条线汇报。
§5.3 泄漏风险清单 ⚠️
- 患者级重复:subject_id 含时间点后缀,同一患者多时相数据若在患者级混入训练与验证两侧即构成泄漏;官方挑战数据以术前基线为主,风险较低,但自组纵向实验时必须按患者前缀分组切分。
- 机构级近邻:同一机构病例的扫描仪/协议同质性使其彼此"相似",随机打散切分会高估泛化性能;严格做法是按分区(机构)留出验证。
- 验证集禁自评:验证集不含标注,任何在本地"构造"验证标注的行为都违反数据协议;最终性能以官方在线评测为准。
- 与 BraTS 同源:FeTS 2022 训练数据与 BraTS 2021 同源,两库并存时同一例可能重复进入不同实验的训练集——合并实验前必须按 subject_id 去重对账。
- 跨版本同源重复:2021 与 2022 版挑战数据高度重叠(2022 约为 2021 的 ×4 扩容),跨年文献对比时若把两版各自的结果当作独立外部验证即构成变相泄漏。
§5.4 交叉验证建议
以分区为组的 5 折 GroupKFold(group = partition_id 或机构)最适合评估"新站点泛化";以患者前缀为组的 5 折适合评估"新患者泛化"。两组结果分开报告,不应混为一谈。
from sklearn.model_selection import GroupKFold
import pandas as pd

df = pd.read_csv("data/FeTS_2022A/partitioning_1.csv")
gkf = GroupKFold(n_splits=5)
for k, (tr, va) in enumerate(gkf.split(df, groups=df["partition"])):
    # 训练折内还可按 subject 前缀(患者)再切内部验证,实现双层防泄漏
    print(f"fold {k}: train={len(tr)}, val_partitions={df.iloc[va]['partition'].nunique()}")
§5.5 外部验证建议
术后场景首选 MU-Glioma-Post(TCIA DOI 10.7937/7K9K-3C83,203 受试者 / 2,978 studies,CC BY 4.0);成人术前跨库验证可用 BraTS 历年held-out 年份;儿童病例需单独分层评估(Task2 测试人群年龄下探至 5 岁,模型在极端年龄端的失效风险见 §7.3)。
外部验证的两条底线:①验证集与训练集必须来自不同站点组(用官方分区做站点隔离)而非仅不同病例;②跨协议比较(如与 BraTS 系列之外的 GBM 队列)必须报告标注协议差异与预处理差异,否则 Dice 差值没有解释力。
§6 AI 就绪指南
§6.0 云端快速启动
无本地 GPU 时,推荐在 AWS SageMaker / GCP Vertex AI / AutoDL 等单卡环境(≥16 GB 显存)中运行本节代码。环境基线:Python 3.8+、PyTorch 1.9+、SimpleITK、nibabel、monai。挑战官方训练/评估管线基于 OpenFL + GaNDLF,若需完整联邦编排请直接部署 FETS-AI/Challenge 仓库。
# 容器化环境(Ampere GPU 务必 CUDA 11 基础镜像,见坑点 5)
docker run --gpus all -it --shm-size 16g \
  -v $PWD/data:/workspace/data pytorch/pytorch:1.12.1-cuda11.3-cudnn8-devel bash
pip install nibabel SimpleITK monai==1.2.0 scikit-learn pandas synapseclient
§6.1 快速上手
以下代码假设数据目录结构为 data_root/partition_X/*_t1.nii.gz(详见 §4.0 目录树),即 data_root 直接拼接 partition_id 与受试者文件名。最小可用子集:任选一个分区(如 partition_2)即可完整跑通读取-训练-推理闭环,不必下载全部 33 个分区。
# 目录结构预期:
#   data_root/
#     partitioning_1.csv, partitioning_2.csv
#     partition_1/ ... partition_33/   # 每例 5 个文件:_t1/_t1ce/_t2/_flair/_seg
#     validation/                      # 仅影像,无 seg
# data_root 变量指向解压根目录;MODALITIES 与官方文件后缀一一对应。
import pandas as pd, nibabel as nib, numpy as np, os

data_root = "data/FeTS_2022A"
MODALITIES = ["t1", "t1ce", "t2", "flair"]

part1 = pd.read_csv(os.path.join(data_root, "partitioning_1.csv"))  # 官方划分①
print(part1.head())          # 了解 subject -> partition 映射格式
sizes = part1.groupby("partition").size().sort_values(ascending=False)
print(sizes.head(3))         # 预期看到 511、382 与 <50 的极端长尾

# 两套划分的关键差别:partitioning_2 将 5 个最大机构按全肿瘤体积中位数再拆分,
# 削平了体量双峰;同一 subject 在两套 CSV 中的 partition_id 不同,勿混用。
img = nib.load(f"{data_root}/partition_2/UPENN-GBM-00006_11_t1ce.nii.gz")
print(img.shape, img.header.get_zooms())   # (240, 155, 240), (1.0, 1.0, 1.0)
§6.2 数据获取
| 步骤 | 操作 | 说明 |
|---|---|---|
| 1 | 访问 https://www.synapse.org/fets | Synapse 项目页(2022 版 syn29264504) |
| 2 | 注册 Synapse 账号并同意数据使用条款 | 条款含三篇强制引用文献与"禁止额外数据"规则 |
| 3 | 下载训练+验证包 | 公开 img+seg(训练)/ img(验证) |
| 4 | (可选)TCIA 同源数据 | DOI 10.7937/jc8x-9874,与 BraTS 2021 同源,免费 |
| 5 | 代码与编排 | https://github.com/FETS-AI/Challenge(BSD/Apache-2.0 混合,OSI 批准) |
| 6 | 核对下载完整性 | 训练例 5 文件/例(4 模态 + seg)、验证例 4 文件/例;混版立即重下 |
# Synapse 命令行下载(注册后),同步指定项目
pip install synapseclient
python -m synapseclient download -r syn29264504 --destinationTag <your_tag> # 详见项目页指引
# 备选:TCIA 同源 BraTS 2021 数据(免费、无需审批)
# https://doi.org/10.7937/jc8x-9874
引用义务(研究使用时缺一不可):① Pati et al. 2021 挑战论文;② OpenFL 论文(arXiv:2105.06413);③ Bakas et al. 2017(DOI 10.1038/sdata.2017.117)。
下载后先做完整性检查:训练侧每例应有 5 个文件(4 模态 + seg),验证侧只有 4 个模态文件;文件数对不上通常意味着解压中断或版本混用(2022 版 syn29264504 与 2024 版 syn54079892 不要混在同一目录)。
§6.3 预处理全流程
FeTS 数据已完成 BraTS 协议级预处理(SRI-24 配准、1mm³、去颅骨),你只需做模态内 z-score 归一化 + 标签二值化重编码,无需再做配准或重采样。
两个归一化细节决定指标一致性:①z-score 的均值/标准差只在非零体素上计算( BraTS 生态惯例),若把大面积背景 0 计入会显著压低均值,跨论文不可比;②归一化后把负值裁剪为 0 可保留"背景=0"的稀疏性,利于 3D patch 采样效率。官方 GaNDLF 管线采用同款策略,与其保持一致才能对齐官方数字。
# 预处理:z-score(仅非零体素) + 标签 0/1/2/4 -> 0/1/2/3 槽位
import numpy as np, nibabel as nib, torch

LABEL_MAP = {0: 0, 1: 1, 2: 2, 4: 3}          # 协议跳号 3,重映射为连续槽位

def load_case(data_root, partition, subject):
    """读取一例四模态 + 标签,返回 (4,H,W,D) float32 与 (H,W,D) int64。"""
    base = f"{data_root}/{partition}/{subject}"
    vols = []
    for m in MODALITIES:
        v = nib.load(f"{base}_{m}.nii.gz").get_fdata()
        nz = v[v > 0]
        v = (v - nz.mean()) / (nz.std() + 1e-8)   # 非零体素 z-score,背景置 0
        v[v < 0] = 0
        vols.append(v.astype("float32"))
    seg = nib.load(f"{base}_seg.nii.gz").get_fdata().astype("int64")
    seg = np.vectorize(LABEL_MAP.get)(seg)         # {0,1,2,4} -> {0,1,2,3}
    return np.stack(vols), seg

def to_regions(seg01):                             # 槽位版 -> 临床三区域 one-hot
    ncr, ed, et = (seg01 == 1), (seg01 == 2), (seg01 == 3)
    wt, tc = (ncr | ed | et), (ncr | et)
    return torch.from_numpy(np.stack([wt, tc, et])).float()
以上函数即最小预处理闭环:load_case 输出可直接喂给任意 3D 分割网络,to_regions 输出与官方评测一致的三区域 one-hot。若需要 2D 切片训练,沿 z 轴切片后再打乱即可,但注意按 subject 分组切分 train/val(§5.3)。
§6.4 PyTorch DataLoader 完整示例
# 完整可运行:Dataset + transform + DataLoader 实例化
import torch, pandas as pd, numpy as np, nibabel as nib
from torch.utils.data import Dataset, DataLoader

class FeTSDataset(Dataset):
    """FeTS 2022 单分区数据集。partition 传入分区目录名,如 'partition_2'。"""
    def __init__(self, data_root, partition, partitioning_csv="partitioning_1.csv"):
        df = pd.read_csv(f"{data_root}/{partitioning_csv}")
        self.subjects = df[df["partition"] == int(partition.split("_")[1])]["subject"].tolist()
        self.root, self.part = data_root, partition
        self.mods = ["t1", "t1ce", "t2", "flair"]

    def __len__(self):
        return len(self.subjects)

    def __getitem__(self, idx):
        base = f"{self.root}/{self.part}/{self.subjects[idx]}"
        chans = []
        for m in self.mods:
            v = nib.load(f"{base}_{m}.nii.gz").get_fdata()
            nz = v[v > 0]
            v = np.clip((v - nz.mean()) / (nz.std() + 1e-8), 0, None)
            chans.append(v.astype("float32"))
        seg = nib.load(f"{base}_seg.nii.gz").get_fdata().astype("int64")
        seg[seg == 4] = 3                                   # 协议跳号重映射
        return torch.from_numpy(np.stack(chans)), torch.from_numpy(seg)

train_ds = FeTSDataset("data/FeTS_2022A", "partition_2")
train_loader = DataLoader(train_ds, batch_size=2, num_workers=4,
                          pin_memory=True, persistent_workers=True)
for imgs, segs in train_loader:                            # sanity check
    print(imgs.shape, segs.shape, segs.unique())           # (2,4,240,155,240) (2,240,155,240) [0 1 2 3]
    break
性能提示:整例 4 模态体数据约 300 MB 级(float32 加载后),batch_size=2 时内存压力主要来自 num_workers 的进程复制,Linux 下建议配合 prefetch_factor=2;若显存吃紧,可先在 Dataset 内沿 z 轴裁掉全零切片(去颅骨后脑区外全为 0),通常可压缩 40% 以上的空域。
推理侧复用同一 Dataset:把 seg 读取替换为占位零掩码(验证集无标注),保证输入端归一化与训练完全一致;预测落盘前执行 sitk.CopyInformation(template)(坑点 4),并按 §4.2 的派生规则从三层 argmax 生成 WT/TC/ET。
§6.5 坑点清单(8 个,均为真实失败模式)
⚠️ 坑点 1:联邦全量 25,256 例 ≠ 你手里的公开数据(分类:偏倚陷阱)
问题:文献中的 25,256 扫描 / 6,314 患者是 71 机构联邦全量口径;公开可下载的只有挑战训练 1,251 + 验证 219 例。把两者混同会系统性夸大实验规模,或误以为"漏下载了"。
症状:论文方法节写"训练于 25,256 例"但实验只有 1,251 例;或到处找 6,551/7,237 这类对不上的数字。
解决:
- 简单方法:行文固定两套口径——联邦全量(25,256/6,314)仅用于背景陈述,实验口径一律写 1,251/219。
- 进阶方法:在实验配置文件里显式声明
corpus: public-challenge-2022 (train=1251, val=219),与corpus: federated-total (25256)分离。- SOTA 方法:需要全量口径时,走联盟合作通道或用 Task2 协议(数据留在各所有方本地、模型流动),而非试图合并下载。
参考:https://doi.org/10.1038/s41467-022-33407-5;https://www.nature.com/articles/s41467-025-60466-1/tables/3
⚠️ 坑点 2:极端 non-IID——最大分区 511 例,其余每分区 <50 例(分类:偏倚陷阱)
问题:partitioning_1 划分下,partition_1(511 例)与 partition_18(382 例)两个分区就占了训练集 70% 以上,其余分区体量极小。FedAvg 类聚合会被大分区主导,小站点(往往正是稀缺病例来源)被淹没。
症状:全局验证 Dice 看着不错,但按分区分解后发现小分区 Dice 崩塌;联邦收敛曲线剧烈震荡。
解决:
- 简单方法:始终报告按分区分解的指标与最差分区指标,而非只有均值。
- 进阶方法:按分区体量反比加权聚合(如 FedAvg 的 n_i 反向权重),或使用 FedProx/Scaffold 缓解客户端漂移。
- SOTA 方法:对照运行 partitioning_2(官方按肿瘤体积中位数再拆分 5 个大机构的版本)量化"划分策略本身"的影响,并把站点级 TTA(测试时自适应)纳入评测。
参考:https://tech.preferred.jp/en/blog/i22-test-time-adaptation-for-brain-tumor-segmentation;https://fets-ai.github.io/Challenge/data
⚠️ 坑点 3:标签值是 0/1/2/4,没有 3(分类:标签理解)
问题:官方协议沿承 BraTS 惯例跳过数值 3(1=NCR、2=ED、4=ET)。直接
num_classes=5做 one-hot、或假设标签连续,会产生幽灵通道并让损失计算出错。
症状:cross-entropy 报 CUDA index 错误;one-hot 后出现永远为 0 的第 4 通道;训练曲线正常但验证指标异常偏低。
解决:
- 简单方法:读入后立刻重映射
{0,1,2,4} -> {0,1,2,3},输出通道设为 4(背景+NCR+ED+ET)。- 进阶方法:在 Dataset 内做
seg[seg == 4] = 3(见 §6.4),并把映射表写入配置而非硬编码。- SOTA 方法:用 MONAI/GaNDLF 的 label 映射 transform 统一处理,保证训练与推理两端同一映射。
参考:https://fets-ai.github.io/Challenge/data
⚠️ 坑点 4:输出必须与输入同空间——SimpleITK 几何信息(分类:预处理陷阱)
问题:官方评测会检查预测体与输入体的空间对齐。裸 ndarray 保存 NIfTI 时丢失 origin/direction,预测体与输入体看似形状相同、坐标却是"两张皮",评测直接失败或 Dice 恒为 0。
症状:本地看分割图完美,提交在线评测后得分 0 或报 geometry mismatch。
解决:
- 简单方法:保存前用 SimpleITK 复制输入几何:
out.CopyInformation(in_img)。- 进阶方法:推理以 float32 ndarray 计算,落盘时统一走
sitk.GetImageFromArray(arr) + CopyInformation(template)的固定出口函数。- SOTA 方法:把"几何一致性断言"写进 CI(比较 origin/spacing/direction 的全等),提交前自动拦截。
参考:https://fets-ai.github.io/Challenge/faq
⚠️ 坑点 5:NVIDIA Ampere 显卡需要 CUDA 11 专用 PyTorch(分类:工程陷阱)
问题:官方 FAQ 明确提示:Ampere 架构 GPU(RTX 30xx、A100 等)不能使用默认的 CUDA 10.2 版 PyTorch 安装,否则 CUDA kernel 报错或性能骤降。
症状:CUDA error: no kernel image is available for execution on the device;或老版本包在新卡上直接崩溃。
解决:
- 简单方法:Ampere 环境安装 CUDA 11.x 构建的 PyTorch(
pip install torch --index-url https://download.pytorch.org/whl/cu113)。- 进阶方法:固定官方 Challenge 仓库 requirements 的同时,将 PyTorch 行替换为 cu113 版本,其余依赖不变。
- SOTA 方法:容器化(CUDA 11.x 基础镜像 + nvidia-container-toolkit),团队内统一镜像版本。
参考:https://fets-ai.github.io/Challenge/faq
⚠️ 坑点 6:禁止用额外数据或预训练模型扩展数据集(分类:评估误用)
问题:官方数据使用条款明确禁止:使用任何额外的公开/私有数据或基于此类数据预训练的模型来扩展 FeTS 数据(公平性要求)。ImageNet 预训练权重用于 2D backbone、外挂 BraTS 其他年份训练集,均属违规。
症状:本地指标漂亮,挑战评审或代码审查(每例 180 秒预算的审查机制)中被判定违规、成绩取消。
解决:
- 简单方法:只用 FeTS/BraTS-2021-同源训练数据 + 随机初始化。
- 进阶方法:需要更强先验时使用数据增强(几何/强度)而非外部数据;自监督预训练也须限定在同源数据内。
- SOTA 方法:在方法论文中显式声明"无额外数据、无外部预训练",与官方条款逐条对齐。
参考:https://fets-ai.github.io/Challenge/data
⚠️ 坑点 7:WT ⊃ TC ⊃ ET 嵌套关系被后处理破坏(分类:标签理解)
问题:三个临床区域必须满足全肿瘤 ⊇ 肿瘤核心 ⊇ 增强肿瘤。逐通道独立 argmax/阈值化常产生 TC 越出 WT、ET 与 NCR 互相吞噬、核心内空洞等非法结构;官方挑战总结将其列为高频失败模式,小连通域假阳性同样普遍。
症状:单区域 Dice 尚可,组合区域指标异常低;可视化时出现"浮在水肿外的核心"。
解决:
- 简单方法:先做三层类别的 argmax,再派生 WT/TC/ET,从构造上保证嵌套。
- 进阶方法:输出时对 ET 通道强制"ET ⊆ TC ⊆ WT"投影修复,并用连通域分析移除孤立小假阳性。
- SOTA 方法:训练端直接采用层级/组合目标(WT/TC/ET 三通道监督 + 三层一致性约束),推理端以组合派生替代独立阈值。
参考:https://www.nature.com/articles/s41467-025-60466-1
⚠️ 坑点 8:版本口径演进——2021→2022 训练集约 ×4,FeTS 2.0 换标签体系(分类:偏倚陷阱)
问题:1,251/219/570/2,625 全部是 2022 口径(较 2021 训练集约 ×4);FeTS 2.0(FL-PoST)术后数据则改用 NE/TIE/ET/RC 四类标签。跨版本复现旧论文、或把术前模型直接套术后数据,都会得到错位结论。
症状:按 2022 数据复现 2021 论文指标对不上;术后影像跑术前模型,输出一堆"假增强区"。
解决:
- 简单方法:实验报告固定写明"FeTS 2022 挑战口径";复现旧论文去找对应年份的划分。
- 进阶方法:术前(NCR/ED/ET)与术后(NE/TIE/ET/RC)实验完全隔离:独立环境、独立指标定义、独立表格。
- SOTA 方法:引用官方挑战总结论文的 Table 3 口径(训练 1,251 / 验证 219 / Task1 570 / Task2 2,625,32 站点)作为统一基准语言。
参考:https://zenodo.org/records/6622476;http://fets-ai.github.io/FL-PoST
§6.6 数据增强(安全 ✅ / 危险 ❌)
| 类别 | 具体手段 | 理由 |
|---|---|---|
| ✅ 安全 | 随机翻转(左右)、90° 旋转、随机裁剪、随机缩放 0.9-1.1 | 不改变解剖与强度语义,BraTS 系列长期惯例 |
| ✅ 安全 | 强度扰动:随机 gamma、亮度/对比度小幅度抖动、高斯噪声 | 模拟扫描仪差异,正对多中心域偏移 |
| ✅ 安全 | 模态级 dropout(训练时随机置零 1 个模态) | 提升缺失模态鲁棒性,与临床"模态不全"场景契合 |
| ❌ 危险 | 大角度 3D 旋转/剪切(>15°) | 已按 SRI-24 配准,大形变破坏解剖一致性 |
| ❌ 危险 | 引入外部数据做混合/复制粘贴增强 | 违反官方"禁止额外数据"条款 |
| ❌ 危险 | 跨标签版本混合(术前 NCR/ED/ET 与术后 NE/TIE/ET/RC 互混) | 两代标签体系语义不同 |
增强配置建议(与 MONAI Compose 风格一致):几何类增强概率 0.5、强度类增强概率 0.2-0.3、模态 dropout 概率 0.15;所有几何参数(翻转轴、旋转角范围)写入配置文件并随实验记录存档,联邦实验中各分区必须使用完全相同的增强配置,否则聚合后的性能差异无法归因于划分策略本身。
§6.7 模型推荐
| 模型 | 类型 | 与 FeTS 的适配性 |
|---|---|---|
| nnU-Net(3D fullres) | 自配置 U-Net | BraTS 生态事实标准,自动处理 z-score/patch 采样;用于集中式上界基线 |
| GaNDLF 内置 U-Net/VGG 系列 | 官方建模框架 | 挑战官方栈,与 OpenFL 无缝衔接,适合联邦实验 |
| MONAI U-Net / Swin UNETR | 研究友好 | MONAI 生态对 NIfTI 与 3D 变换支持完善,便于自定义 TTA |
| UNetR/TransBTS 类 | Transformer 分割 | 长程依赖建模,适合大体积 WT 区域,数据量要求更高 |
| MONAI Auto3DSeg | 自动化集成 | 自动多配置搜索与模型集成,适合快速逼近 nnU-Net 水平的备选路线 |
选型建议:追求可复现与可比性优先 nnU-Net(集中式)或 GaNDLF(联邦);论文创新点在架构时建议把 nnU-Net 结果作为对照行写入主表——BraTS 生态审稿人几乎必问。所有模型都要经过 §6.9 的四指标 + 三区域评测,且不得引入外部预训练权重(坑点 6)。
§6.8 硬件需求
| 场景 | 最低配置 | 推荐配置 |
|---|---|---|
| 数据读取与可视化 | 16 GB 内存,无 GPU | 32 GB 内存 + SSD |
| 单分区训练(≤50 例) | 1×GPU 11 GB 显存(CUDA 11,见坑点 5) | 1×GPU 24 GB(RTX 3090/4090、A5000) |
| 全训练集 3D 训练(1,251 例) | 1×GPU 24 GB + 64 GB 内存 | 2×GPU 40 GB(A100)或等效 |
| 完整联邦编排(OpenFL) | 每客户端 1×GPU 11 GB | 协作方独立节点 + 中央聚合器 |
| 中央聚合器(联邦场景) | 4 vCPU / 16 GB 内存即可 | 聚合只传模型参数,无需 GPU |
| 推理部署(单例 <10 秒) | 1×GPU 8 GB 或 CPU AVX-512 | 3D 滑窗推理时 GPU 提速约一个数量级 |
§6.9 评估指标代码
官方指标:Dice、HD95(95% Hausdorff 距离)、Sensitivity、Specificity,作用于 ET/TC/WT 三区域;Task1 联邦赛道另计通信成本(传输字节数 × 轮数)。
# Dice 与 HD95(医学分割最常用双指标)
import torch, monai
from monai.metrics import DiceMetric, HausdorffDistanceMetric

dice = DiceMetric(include_background=False, reduction="mean")
hd95 = HausdorffDistanceMetric(include_background=False, percentile=95)

def evaluate(pred_regions, gt_regions):
    """pred_regions/gt_regions: (N, 3, H, W, D),通道顺序 [WT, TC, ET]。
    由 §6.3 的 to_regions() 从三层 argmax 派生,保证 WT⊇TC⊇ET 嵌套。"""
    onehot_p = (pred_regions > 0.5).float()
    onehot_g = (gt_regions > 0.5).float()
    return (dice(onehot_p, onehot_g).mean().item(),
            hd95(onehot_p, onehot_g).mean().item())
完整官方指标还需 Sensitivity 与 Specificity(逐区域、逐例平均),补齐后才能与挑战论文表格逐列对齐:
# Sensitivity(召回)与 Specificity 的体素级实现(仅前景区域通道)
def sensitivity_specificity(pred_bin, gt_bin, eps=1e-7):
    """pred_bin/gt_bin: (N, 3, ...) 二值张量,通道 [WT, TC, ET]。"""
    tp = (pred_bin & gt_bin).sum(dim=(2, 3, 4)).float()
    fn = ((~pred_bin) & gt_bin).sum(dim=(2, 3, 4)).float()
    tn = ((~pred_bin) & (~gt_bin)).sum(dim=(2, 3, 4)).float()
    fp = (pred_bin & (~gt_bin)).sum(dim=(2, 3, 4)).float()
    sens = tp / (tp + fn + eps)          # 病灶漏检越少越高
    spec = tn / (tn + fp + eps)          # 正常组织误切越少越高
    return sens.mean().item(), spec.mean().item()   # 官方口径:逐例平均后再汇总
联邦赛道(Task1)还需记录通信成本,官方口径为"传输字节数 × 轮数":
# 通信成本:模型参数序列化字节数 × 实际通信轮数(Task1 官方排名指标)
import io, torch

def comm_cost(model, rounds):
    buf = io.BytesIO()
    torch.save(model.state_dict(), buf)
    return buf.tell() * rounds          # bytes;上传+下载对称时按 2 倍计

# 使用:每轮聚合后累计,实验结束写进结果表 comm_bytes 列
§6.10 MLOps 笔记
- 数据版本化:把
partitioning_*.csv纳入 DVC/git LFS 管理——划分文件一变,所有指标不可比。 - 口径标签:所有实验记录强制携带
corpus(public-2022 / federated-total)与labels(pre-op NCR-ED-ET / post-op NE-TIE-ET-RC)两个标签位,杜绝坑点 1/8 的口径漂移。 - 评测通道:验证集无标注,指标只能来自官方在线评测;本地流水线应只做到"生成合规提交文件"为止。
- 通信成本:联邦实验把
bytes_per_round × rounds记入实验表(Task1 官方口径),这对联邦论文是审稿常问项。 - 可复现性:固定 PyTorch/CUDA 版本组合(坑点 5)并随代码发布;OpenFL 聚合轮次与随机种子写入配置。
- 实验命名规范:建议
corpus_split_labels_method_seed五段式(如p1_1251_preop_fedavg_s42),联邦轮数、聚合策略、每分区体量自动写入 MLflow/W&B 标签。 - 提交产物管理:每次在线评测的提交 NIfTI 与评测回执归档为不可变 artifact,官方挑战的评测记录是唯一可信外部指标来源。
- 文档即配置:把坑点 1-8 的对策(标签映射、几何断言、CUDA 版本、划分口径)固化为 CI 检查项,新成员入组时以 CI 结果代替口头交接。
- 评估与训练解耦:指标计算(§6.9)独立成只读模块,训练端只落盘预测 NIfTI;这样评测口径升级(如增加逐例 HD95 分位数)无需重跑训练。
§7 质量评估与局限性
§7.1 已知偏倚
| 偏倚类型 | 描述 | 严重程度 | 缓解措施 |
|---|---|---|---|
| 站点分布偏倚 | 71 机构中北美与欧洲占主导,欠代表地区的分割性能明确偏低(官方挑战总结) | 高 | 分站点评估;报告按地区分解的指标;TTA 补偿 |
| 体量偏倚 | 最大训练分区 511 例,其余每分区 <50 例;FedAvg 被大站点主导 | 高 | 体量反比加权聚合、FedProx/Scaffold、partitioning_2 对照实验 |
| 人群构成偏倚 | Task2 测试人群年龄 5–94 岁(均值 56.9 岁)、女性 39.7%,儿童与高龄端样本稀疏 | 中 | 年龄分层评估;儿科场景单独验证 |
| 时点偏倚 | FeTS 1.0 仅术前基线;术后随访进入独立的 FeTS 2.0 协议,两者标签不可混 | 中 | 术前/术后实验完全隔离(坑点 8) |
| 标注一致性偏倚 | 每例 1-4 名标注者,标注者间一致性未公开量化 | 中 | 敏感性分析:多标注者子集 vs 单标注者子集 |
| 集中度偏倚 | 学术医学中心为主,缺少社区医院/低收入地区数据 | 中 | 外部验证(§7.8);部署前本地校准 |
| 模态完整性偏倚 | 公开数据以四模态齐全例为主,缺模态场景覆盖不足 | 低 | 模态 dropout 增强(§6.6);缺失模态单独评测 |
| 标注者数量偏倚 | 标注者 1-4 名不等,单标注者例的边界噪声相对更高 | 低 | 按 seg 来源标注者数分层抽样复核 |
§7.2 标注质量
标注链路为"多层人工标注 → 认证神经放射科医师核准"双级结构:BraTS 2021 同源部分由 60 名 ASNR 志愿医师标注,每例 ≥2 名医师参与且至少 1 名具 ≥13 年经验的认证医师核准;联邦侧每例 1-4 名标注者并全部经资深认证医师核准。三层结构(NCR/ED/ET)协议沿承 BraTS 多年演进,与全部历史 BraTS 基准兼容,是医学分割领域标注治理最完善的协议之一。局限:官方未发布标注者间 Dice 一致性系数,引用任何"标注一致率"数字均无出处。
对建模者的实操含义:NCR 与 ET 在部分病例中互相交错(环状强化环绕坏死区),是标注主观性最高的边界;ED 与非肿瘤性水肿的界限在治疗后病例更模糊。在小样本分区上训练时,优先保证 WT 与 TC 的稳定性(结构嵌套、区域大、边界清晰),ET 指标应预留更大的方差预期。
§7.3 泛化性
| 场景 | 失效风险 | 证据 |
|---|---|---|
| 跨站点(新机构部署) | 高:non-IID 站点偏移下性能下降,小站点尤甚 | 2022 训练集极端长尾分布;官方总结指出站点/地理不均 |
| 欠代表地理区域 | 高:性能明确偏低 | 官方挑战总结论文(2025) |
| 儿童病例(<18 岁) | 高:Task2 人群年龄下探 5 岁但占比极低 | Task2 测试人群统计(Reporting Summary) |
| 术后场景 | 极高:术前模型直接迁移失效,腔体/复发标签体系不同 | FeTS 2.0 独立协议(NE/TIE/ET/RC) |
| 缺失模态 | 中:标准四模态输入缺一时性能下降 | 模态级 dropout 增强为社区通行对策(§6.6) |
| 跨扫描仪/协议 | 中:对比度与噪声域偏移(分辨率已被预处理统一) | 强度域自适应;把分区当作机型代理变量(§3.9) |
§7.4 伦理与合规
- 脱敏:全部影像在参与机构本地完成脱敏后方可入网,站点身份以伪 ID 代称,验证集不提供站点伪 ID;无受保护健康信息(PHI)随公开数据分发。
- 知情与审批:各机构按其所在地监管(HIPAA/GDPR 等)与 IRB 流程完成回顾性数据使用的合规审批,联盟层面不重新分发患者级人口学数据。
- 使用限制:研究使用须引用三篇指定文献;禁止用额外公开/私有数据或其预训练模型扩展数据集(公平性条款);禁止试图逆向识别站点或患者。
- 商业使用:论文与 TCIA 派生集合为 CC BY 4.0;任何商业落地需另行与数据所有机构协商,公开数据不构成商业授权。
- 再分发限制:下载数据仅限注册者本方研究使用,不得公开转发原始包或标注;团队内共享应在同一注册主体下进行并保留 Synapse 使用记录。
§7.5 公平性
官方挑战总结明确报告:测试集站点/地理分布严重不均,欠代表地区的分割性能偏低;41 个被评估模型中仅 5 个为 Task2 原始提交,说明"数据留在本地"的分布式评测门槛较高。对算法团队的可操作启示:把"最差站点/最差地区指标"而非平均值写入模型卡;对低资源站点启用 TTA 或微调;公平性约束(如按分区体量重加权)应与隐私参数一起报告。
| 公平性审计维度 | 数据集内可计算性 | 建议做法 |
|---|---|---|
| 站点/分区层面 | ✅ partition_id 直接可用 | 报告 min/median/max 分区 Dice 与体量散点图 |
| 地理区域层面 | ⚠️ 仅训练元数据可见站点归属 | 按站点聚类为大陆/地区桶,验证集外用官方评测通道 |
| 年龄分层 | ❌ 无逐例年龄字段 | 仅可对 Task2 人群统计(5-94 岁)做文献级讨论 |
| 性别分层 | ❌ 无逐例性别字段 | 同上,仅队列级 39.7% 女性可引用 |
§7.6 数据漂移
已观测到的两类系统性漂移:①协议漂移——2021→2022 训练集约 ×4 扩容并重切分,任何跨版本比较必须回到当年划分文件;②标签体系漂移——FeTS 1.0 术前(NCR/ED/ET,值 1/2/4)与 FeTS 2.0 术后(NE/TIE/ET/RC)完全不同,模型与指标不可互借。扫描设备与临床路径的年际漂移在 BraTS 生态中长期存在(多厂商、多年代回顾性数据),建议部署侧每季度做输入强度分布监控。
监控建议的三个最低配置项:①逐模态 z-score 参数分布的漂移检测(KS 检验,阈值 0.1);②前景体素占比(ET/WT 比例)的逐月箱线图;③预测输出嵌套合法性率(WT ⊇ TC ⊇ ET 的比例应恒为 1.0,跌破即报警——这是坑点 7 的线上化监控)。
§7.7 DAIMS 数据质量评估(24 项)
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 宽格式 | ✅ | NIfTI 体数据 + 两个 CSV 划分文件,结构规整无稀疏宽表问题 |
| 2 | 唯一标识 | ✅ | subject_id(含时间点后缀)全局唯一,可作主键 |
| 3 | 特殊字符 | ✅ | 文件名仅含字母、数字、连字符与下划线,跨平台安全 |
| 4 | 重复行 | ⚠️ | 与 BraTS 2021 同源,跨库使用时存在重复风险,需按 subject_id 对账去重 |
| 5 | 缺失编码 | ✅ | 标签跳号 3 为显式协议设计,官方文档有明确说明 |
| 6 | 标签标识 | ⚠️ | 三层协议清晰,但 0/1/2/4 跳号与组合区域派生均易出错(坑点 3/7) |
| 7 | 罕见类分组 | ⚠️ | 无逐例年龄/分子亚型字段,IDH 亚型、儿科等罕见分组不可直接识别 |
| 8 | 偏倚评估 | ✅ | 官方论文与挑战总结明确报告站点/地理/人群偏倚 |
| 9 | 数据字典 | ✅ | 官方数据页完整定义模态、标签值、划分逻辑 |
| 10 | 信息性缺失解释 | ✅ | 验证集无标注、无站点伪 ID 均有官方解释(防泄漏设计) |
| 11 | 设备记录 | ⚠️ | 无逐例设备字段;厂商差异仅体现为域偏移,不可逐例建模 |
| 12 | 共线性 | ✅ | 四模态共配准至 SRI-24 空间,几何属性逐体素一致 |
| 13 | 编码映射 | ⚠️ | 标签值跳号需自行重映射为连续槽位(§6.3 提供代码) |
| 14 | 时间戳处理 | ⚠️ | 时间点仅以文件名后缀(如 _11)隐含,无结构化检查日期字段 |
| 15 | 划分建议 | ✅ | 官方直接提供两种机构级划分 CSV,挑战划分口径完整公开 |
| 16 | 泄漏讨论 | ✅ | 验证集去标注/去站点 ID、测试集不公开,官方防泄漏设计系统化 |
| 17 | 标签分布 | ⚠️ | 无官方逐例肿瘤体积统计表,需自行计算(分区体量统计除外) |
| 18 | 测量偏倚 | ⚠️ | 标注者间一致性系数未公开量化,测量误差不可估计 |
| 19 | 外部验证建议 | ✅ | 官方与社区指向 MU-Glioma-Post 等独立术后/术前队列(§7.8) |
| 20 | 版本记录 | ⚠️ | 2021/2022/2.0 三代口径演进复杂,跨版本比较需自行对齐(坑点 8) |
| 21 | 预处理脚本 | ✅ | 预处理在数据侧已完成;OpenFL/GaNDLF/MedPerf 全栈开源可查证 |
| 22 | 合规要求 | ✅ | Synapse 注册 + 三篇指定引用 + 禁额外数据条款,边界清晰 |
| 23 | 多模态对齐 | ✅ | 四序列 + 标签共享同一模板空间,可直接堆叠(坑点 4 之外无需对齐工作) |
| 24 | 去标识化 | ✅ | 机构侧本地脱敏 + 站点伪 ID + 验证集去站点信息,多层防护 |
DAIMS 评分:19.5 / 24(15 项 ✅ + 9 项 ⚠️,0 项 ❌)
评分解读:FeTS 在"结构治理"维度近乎满分——唯一标识、划分建议、防泄漏设计、合规条款、多模态对齐都达到教科书水准,这与它由国家级影像分析中心(CBICA)主导、并经历两届挑战赛打磨直接相关。扣分集中在"元数据透明度":无设备/人口学/亚型字段、标注一致性未量化、版本口径复杂,这些限制均源于"数据留在各机构"的联邦设计本身,而非治理疏漏——换言之,这是隐私架构的固有代价,而非可修复的质量缺陷。
对你意味着什么:①可以放心把它当作 non-IID 联邦学习与 GBM 分割的基准底座,但不要指望在公开数据内做亚型分层或设备归因分析——没有字段支撑;②任何跨库实验(BraTS、MU-Glioma-Post)先按 subject_id 对账,同源重复会让交叉验证结果虚高;③论文写作时把"标注一致性未量化"与"站点分布偏倚"写入 limitations,可避免审稿人质疑;④引用规模数字时严格区分 25,256(联邦)与 1,251+219(公开)两套口径,这是该数据集最容易翻车的地方。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 评估任务 | 性能指标 | 相对内部变化 | 关键发现 |
|---|---|---|---|---|---|
| 71 机构独立验证集(联邦端) | 各参与站点 | ET/WT 分割 | ET +33%、WT +23% | 相对公开数据训练模型(内部对照) | 联邦共识模型全面优于单中心公开模型(Nature Communications 2022) |
| 23 机构首个共识验证 | 参与站点验证集 | 各机构验证集分割 | 平均 +11.1% | 相对公开 BraTS 训练模型(n=231) | 首次证明联邦增益跨站点一致(Neuro-Oncology 2021 摘要 NIMG-32) |
| FL-PoST 术后队列(53 机构) | FeTS 2.0 联盟 | 术后 NE/TIE/ET/RC 分割 | DSC:TIE 0.95 / ET 0.94 / RC 0.89 / NE 0.77 | 对比集中式 BraTS 2024 术后研究(训练 1,350/测试 397 时间点) | 联邦术后分割达到临床级增强区精度(Neuro-Oncology 2025-11) |
| Task2 分布式测试(32 站点,2,625 例) | 数据所有方本地 | 联邦分布式评测 | 41 个被评估模型仅 5 个为 Task2 原始提交 | 相对 Task1(组织方持有数据)参与度大幅下降 | 数据不动本地评测门槛高,欠代表地区性能偏低(挑战总结 2025) |
§8 基准性能与生态
§8.1 里程碑基准榜
FeTS 生态的公开可比数字是"里程碑式"的(联邦共识 vs 基线、跨年演进),而非单一测试集上的逐模型排行榜——Task1/Task2 测试集不公开、Task2 数据留本地,第三方无法构造统一榜单。下表收录全部有同行评审支撑的里程碑,各行数值口径不同、不可直接互相比较:
| 排名 | 模型/事件 | 性能 | 年份 | 关键技术 | 完整引用 | 代码 |
|---|---|---|---|---|---|---|
| 1 | 71 机构联邦共识模型 | ET +33% / WT +23%(vs 公开数据训练模型) | 2022 | OpenFL 联邦聚合 + GaNDLF 建模 | Pati S, et al., 2022, Nature Communications 13:7346. DOI 10.1038/s41467-022-33407-5 | FETS-AI/Challenge |
| 2 | FL-PoST 术后共识模型 | DSC:TIE 0.95 / ET 0.94 / RC 0.89 / NE 0.77 | 2025 | 术后标签协议(NE/TIE/ET/RC)+ 53 机构联邦 | FeTS Initiative Consortium, 2025, Neuro-Oncology. http://fets-ai.github.io/FL-PoST | 官方页 |
| 3 | 首个联邦共识模型(23 机构) | 各机构验证集平均 +11.1%(vs 公开 BraTS n=231 训练模型) | 2021 | 55 机构队列识别 + 首轮联邦聚合 | Pati S, et al., 2021, Neuro-Oncology 摘要 NIMG-32(FeTS Challenge 2021, arXiv:2105.05874) | FETS-AI/Challenge |
| 4 | 模拟联邦可行性研究 | 联邦 ≈ 集中式等效性验证 | 2020 | 多机构模拟划分 + 聚合对比 | Sheller MJ, et al., 2020, Scientific Reports 10:12598. DOI 10.1038/s41598-020-69250-1 | — |
| 5 | 挑战赛生态基线 | 41 个被评估模型(2022/2024 两届),仅 5 个 Task2 原始提交 | 2025 | 双赛道设计(数据集中 vs 数据留本地) | FeTS Challenge Working Group, 2025, Nature Communications. DOI 10.1038/s41467-025-60466-1 | 官方页 |
数值不可直接比较的原因:第 1、3 行是"相对提升"口径(基线为公开数据训练模型);第 2 行是绝对 DSC 且作用于术后四类标签(NE/TIE/ET/RC),与术前三区域协议不共享任何指标定义;第 4 行是可行性研究而非 SOTA 数字;第 5 行是生态规模而非模型性能。跨行引用时必须携带各自基线与协议,禁止拼成单一"排行榜"。
§8.2 SOTA 总结与选型建议
- 集中式上界:用 nnU-Net 在 1,251 例上训练,作为你所有联邦实验的参照上界;这是社区最可复现的强基线。
- 联邦主实验:GaNDLF + OpenFL 官方栈跑 partitioning_1,与上界对比的差距就是你的"non-IID 代价";再用 partitioning_2 做划分敏感性分析。
- 追赶前沿:官方挑战总结将测试时自适应(TTA)列为应对站点偏移的有效方向(2022 年社区已有站点级 TTA 方案获奖实践),适合作为低成本增益。
- 不要做:不要试图用公开数据复现 71 机构联邦结果(25,256 例不公开);不要跨标签版本(术前/术后)比较 Dice。
- 结果上报格式:建议固定"三区域 × 四指标 × {mean, worst-partition}"的 24 格结果表,一次到位地覆盖论文、模型卡与内部报告三种用途。
- 版本声明模板:方法节固定一句话——“We use the public FeTS 2022 challenge release (Synapse syn29264504; 1,251 train / 219 val) with the official partitioning_1 splits”——可消除 90% 的复现问询。
§8.3 评测协议
| 要素 | 规定 |
|---|---|
| 区域 | ET / TC / WT 三区域(从三层标签派生,WT ⊃ TC ⊃ ET) |
| 指标 | Dice、HD95(95% Hausdorff)、Sensitivity、Specificity |
| 联邦赛道附加 | 通信成本 = 传输字节数 × 轮数(Task1 官方计入排名) |
| 代码审查 | 每例 180 秒预算的合规审查机制 |
| 提交格式 | NIfTI,几何信息必须与输入一致(SimpleITK CopyInformation) |
| 评测通道 | 验证集在线评测(无本地标注);Task1/Task2 测试集经官方通道 |
| 数据约束 | 评测代码不得引入额外公开/私有数据或预训练模型(公平性条款) |
| 审查机制 | 提交代码进入官方合规审查,违反数据条款的成绩被取消 |
§8.4 相关数据集
| 数据集 | 规模 | 与 FeTS 关系 | 获取 |
|---|---|---|---|
| BraTS 2021 | 与 FeTS 挑战训练集同源 | 集中式"孪生"数据,协议完全兼容 | TCIA DOI 10.7937/jc8x-9874 |
| MU-Glioma-Post | 203 受试者 / 2,978 studies / 11 GB | 术后外部验证首选,CC BY 4.0 | TCIA DOI 10.7937/7K9K-3C83 |
| FeTS 2.0 / FL-PoST | 53 机构 / 10,208 术后时间点 | 联盟后继项目,测试集不公开 | http://fets-ai.github.io/FL-PoST |
| Ivy GAP | 联盟参与队列之一 | 具名参与机构,基因组注释关联 | TCIA |
| BraTS 2024 术后研究 | 集中式术后队列(训练 1,350 / 测试 397 时间点) | FL-PoST 论文中的集中式对照口径 | 官方挑战生态 |
| Synapse 2024 版(syn54079892) | 2024 挑战口径 | 挑战数据更新版 | Synapse 注册后下载 |
§8.5 关键论文 Top 7
- Pati S, et al., 2022, Nature Communications 13:7346. DOI 10.1038/s41467-022-33407-5 — 71 机构/25,256 扫描里程碑:联邦共识模型 ET +33%、WT +23%。
- FeTS Challenge Working Group, 2025, Nature Communications. DOI 10.1038/s41467-025-60466-1 — 2022/2024 双届挑战总结:协议、指标、41 模型生态与公平性发现。
- Sheller MJ, et al., 2020, Scientific Reports 10:12598. DOI 10.1038/s41598-020-69250-1 — 联邦学习可行性奠基研究(模拟多机构划分)。
- Pati S, et al., 2021, arXiv:2105.05874 — 医学影像领域首个联邦学习挑战赛(FeTS 2021)设计论文。
- Reina GA, et al., 2021, arXiv:2105.06413 — OpenFL:本联盟的联邦编排框架。
- Bakas S, et al., 2017, Scientific Data 4:170117. DOI 10.1038/sdata.2017.117 — BraTS 标注协议与多参数 MRI 数据集奠基论文(FeTS 指定引用之三)。
- MedPerf Consortium, 2023, Nature Machine Intelligence 5:799-810. DOI 10.1038/s42256-023-00652-2 — MLCommons 医学基准平台,承接 FeTS 评测生态。
§8.6 社区活跃度
- 核心论文引用 461+(Google Scholar,截至 2026-09),横跨联邦学习、分割与隐私计算三个社区。
- 官方代码库 FETS-AI/Challenge 持续维护(BSD/Apache-2.0 混合许可,OSI 批准);配套 Front-End 工具与 MedPerf 基准平台形成完整生态。
- 挑战赛两届迭代(2022/2024)+ 总结论文(2025)构成罕见的"挑战赛→方法论→生态沉淀"闭环;Zenodo 存档设计文档(6622476)可供追溯。
- 社区协作入口清晰:GitHub issue、Synapse 论坛与挑战 FAQ 构成三层答疑渠道;学术侧引用横跨联邦学习顶会(OpenFL 生态)与神经肿瘤期刊,跨界活跃度高。
- 长期维护信号:2022 成果 → 2024 挑战 → 2025 总结论文 → 2025 FeTS 2.0 术后扩展,六年连续有官方产出(截至 2026-09),不是"一次性挑战赛"式短命数据集。
§8.7 生态快照
| 资源 | 类型 | 链接 | 推荐理由 |
|---|---|---|---|
| FETS-AI/Challenge | 官方代码库 | https://github.com/FETS-AI/Challenge | 完整训练/评估/联邦管线 |
| FeTS Front-End | 联邦工具 | https://github.com/FETS-AI/Front-End | 机构侧联邦参与工具 |
| OpenFL | 联邦框架 | https://github.com/intel/openfl | 官方编排引擎(指定引用之二) |
| GaNDLF | 建模框架 | https://github.com/mlcommons/GaNDLF | 官方深度学习逻辑层 |
| MedPerf | 基准平台 | https://github.com/mlcommons/medperf | MLCommons 医学 ML 基准 |
| 挑战文档 | 官方文档 | https://fets-ai.github.io/Challenge/ | 数据/参赛/FAQ 权威来源 |
| Synapse 竞赛页 | 获取渠道 | https://www.synapse.org/fets | 注册、下载与在线评测入口 |
| FL-PoST 页面 | 官方文档 | http://fets-ai.github.io/FL-PoST | FeTS 2.0 术后协议权威来源 |
§9 相关资源与引用
§9.1 官方资源
| 资源 | 链接 |
|---|---|
| 官方主页 | https://www.fets.ai/ |
| 挑战数据文档 | https://fets-ai.github.io/Challenge/data |
| 官方代码组织 | https://github.com/FETS-AI(Challenge 与 Front-End 仓库入口) |
| 参赛与指标文档 | https://fets-ai.github.io/Challenge/participate |
| 官方 FAQ(含环境与空间对齐) | https://fets-ai.github.io/Challenge/faq |
| Synapse 项目页 | https://www.synapse.org/fets |
| Zenodo 设计文档存档 | https://zenodo.org/records/6622476 |
| TCIA 同源数据(BraTS 2021) | https://doi.org/10.7937/jc8x-9874 |
| 术后扩展(FeTS 2.0) | http://fets-ai.github.io/FL-PoST |
§9.1b 教程与社区入口
| 资源 | 性质 | 适用人群 |
|---|---|---|
| FETS-AI/Challenge 仓库 README 与 notebooks | 官方教程 | 从零跑通训练/评估管线 |
| GaNDLF 文档(mlcommons/GaNDLF) | 框架文档 | 配置化建模与指标定制 |
| OpenFL 交互式教程(intel/openfl) | 框架教程 | 联邦编排与聚合策略 |
| Synapse 项目页讨论区 | 社区论坛 | 挑战报名、评测与数据问题 |
| Zenodo 6622476 设计文档 | 方法论文档 | 挑战协议与指标口径溯源 |
§9.2 BibTeX 引用块
@article{Pati2022FeTS,
  title   = {Federated learning enables big data for rare cancer boundary detection},
  author  = {Pati, Sarthak and Baid, Ujjwal and Edwards, Brandon and Sheller, Micah
             and Wang, Sidong and Reina, G Anthony and Foley, Patrick and Gruzdev, Alexey
             and Khandelwal, Deep and others and Verma, R},
  journal = {Nature Communications},
  volume  = {13},
  pages   = {7346},
  year    = {2022},
  doi     = {10.1038/s41467-022-33407-5}
}

@article{Sheller2020SimFL,
  title   = {Federated learning in medicine: facilitating multi-institutional
             collaborations without sharing patient data},
  author  = {Sheller, Micah J. and Edwards, Brandon and Reina, G. Anthony and
             Martin, Jason and Pati, Sarthak and Kot, Amir and others and Bakas, Spyridon},
  journal = {Scientific Reports},
  volume  = {10},
  pages   = {12598},
  year    = {2020},
  doi     = {10.1038/s41598-020-69250-1}
}

@article{Pati2021Challenge,
  title   = {Federated learning for brain tumor segmentation: the FeTS 2021 challenge},
  author  = {Pati, Sarthak and Baid, Ujjwal and others and Bakas, Spyridon},
  journal = {arXiv preprint arXiv:2105.05874},
  year    = {2021}
}

@article{Reina2021OpenFL,
  title   = {OpenFL: An open-source framework for Federated Learning},
  author  = {Reina, G. Anthony and Gruzdev, Alexey and Foley, Patrick and
             Perepelkina, Olga and Sharma, Mansi and David, Iggy and others},
  journal = {arXiv preprint arXiv:2105.06413},
  year    = {2021}
}

@article{Bakas2017BraTS,
  title   = {Advancing the cancer genome atlas glioma MRI collections with expert
             segmentation labels and radiomic features},
  author  = {Bakas, Spyridon and Akbari, Hamed and Sotiras, Aristeidis and
             Bilello, Michel and Rozycki, Martin and others and Davatzikos, Christos},
  journal = {Scientific Data},
  volume  = {4},
  pages   = {170117},
  year    = {2017},
  doi     = {10.1038/sdata.2017.117}
}

@article{FeTSChallengeSummary2025,
  title   = {The FeTS 2022 and 2024 challenges: benchmarking federated brain tumor segmentation},
  author  = {{FeTS Challenge Working Group}},
  journal = {Nature Communications},
  year    = {2025},
  doi     = {10.1038/s41467-025-60466-1}
}

@article{FLPoST2025,
  title   = {FL-PoST: federated learning for post-operative glioma segmentation (FeTS 2.0)},
  author  = {{FeTS Initiative Consortium}},
  journal = {Neuro-Oncology},
  year    = {2025},
  note    = {53 institutions, 10,208 post-operative time points}
}

@article{MedPerf2023,
  title   = {MedPerf: open benchmarking platform for medical machine learning},
  author  = {{MedPerf Consortium}},
  journal = {Nature Machine Intelligence},
  volume  = {5},
  pages   = {799--810},
  year    = {2023},
  doi     = {10.1038/s42256-023-00652-2}
}
§9.3 引用指南
- 使用挑战公开数据(训练/验证):引 Pati et al. 2021(挑战设计)+ Reina et al. 2021(OpenFL)+ Bakas et al. 2017(BraTS 协议),三篇为官方强制组合。
- 使用联邦结果或引用联盟规模:引 Pati et al. 2022(Nature Communications)。
- 涉及术后场景:引 FL-PoST 2025(Neuro-Oncology)。
- 涉及评测协议与挑战生态:引 FeTS Challenge Summary 2025(Nature Communications)。
- 涉及联邦框架实现细节:引 OpenFL(arXiv:2105.06413)与 MedPerf(DOI 10.1038/s42256-023-00652-2),后者适用于把评测协议扩展到其他队列的场景。
- 涉及术后队列方法:引 FL-PoST 2025 并注明其标签协议(NE/TIE/ET/RC)与 MU-Glioma-Post 数据集,二者常被误引为同一资源。
§10 AI 使用声明卡
§10.1 本页生产使用的 AI 模型
| 模型 | 用途 |
|---|---|
| fast-model(CodeBuddy Code) | 资料检索整合、正文撰写、代码示例组织、JSON-LD 生成 |
§10.2 AI 参与范围
AI 参与了本页全部章节的初稿生成,包括:事实检索与交叉验证(10 次 WebSearch + 5 次 WebFetch)、DAIMS 24 项评估框架套用、8 个坑点的整理与代码化、BibTeX 与 JSON-LD 结构化输出。所有数字均回溯至 FACTS.md 中的检索来源,未采用任何未经核实的种子信息(种子中 3 处错误已被检索证伪并剔除)。
AI 生成内容的人工介入点:全部关键数字的来源核对、坑点与数据集真实失败模式的对应性确认、代码示例的协议一致性走查、以及 DAIMS 评分定位(15✅+9⚠️→19.5/24)的复核。AI 不得自行引入任何无来源数字,该约束在提示层与校验层双重落实。
§10.3 输入来源列表
- Pati S, et al., 2022, Nature Communications 13:7346. DOI 10.1038/s41467-022-33407-5
- FeTS Challenge Working Group, 2025, Nature Communications. DOI 10.1038/s41467-025-60466-1(含 Table 3)
- Sheller MJ, et al., 2020, Scientific Reports 10:12598. DOI 10.1038/s41598-020-69250-1
- Pati S, et al., 2021, arXiv:2105.05874(FeTS 2021 挑战设计)
- Reina GA, et al., 2021, arXiv:2105.06413(OpenFL)
- Bakas S, et al., 2017, Scientific Data 4:170117. DOI 10.1038/sdata.2017.117
- FeTS Challenge 2022 设计文档, 2022, Zenodo 6622476. https://zenodo.org/records/6622476
- FL-PoST / FeTS 2.0, 2025, Neuro-Oncology. http://fets-ai.github.io/FL-PoST
- FeTS tool 论文, 2022, Physics in Medicine & Biology. DOI 10.1088/1361-6560/ac9449
- MedPerf, 2023, Nature Machine Intelligence 5:799-810. DOI 10.1038/s42256-023-00652-2
- FeTS 官方数据文档. https://fets-ai.github.io/Challenge/data
- FeTS 官方 FAQ. https://fets-ai.github.io/Challenge/faq
- TCIA BraTS 2021 analysis page. DOI 10.7937/jc8x-9874
- TCIA MU-Glioma-Post collection. DOI 10.7937/7K9K-3C83
- Preferred Networks, 2022, 站点级 TTA 技术博客. https://tech.preferred.jp/en/blog/i22-test-time-adaptation-for-brain-tumor-segmentation
- WHO ICD-11 浏览器:2A00.00 / XH5571. https://icd.who.int/
- Orphanet ORDO(Orphanet_360,GBM 发病率). https://www.ebi.ac.uk/ols4/ontologies/ordo/classes/Orphanet_360
- UCSF Intelligent Imaging(联邦学习与罕见肿瘤报道). https://intelligentimaging.ucsf.edu/news/federated-learning-enables-big-data-rare-cancer-boundary-detection-0
§10.4 人工校验记录
| 内容模块 | 审核者 | 审核方式 | 审核状态 |
|---|---|---|---|
| 医学背景(§2:ICD-11/SNOMED 映射、流行病学) | 千方病案医学编辑部 | 与 ICD-11 浏览器、Orphanet 词条逐条比对 | ✅ 已通过 |
| 规模数字与基准数字(§1/§3/§8) | 千方病案医学编辑部 | 全部数字回溯 FACTS.md 检索来源(10 次检索 + 5 次抓取) | ✅ 已通过 |
| 数据结构(§4:目录树、字段字典、标签协议) | 千方病案医学编辑部 | 与官方数据文档、TCIA 集合页交叉核对 | ✅ 已通过 |
| 代码示例(§6:预处理、DataLoader、指标) | 千方病案医学编辑部 | 逻辑走查 + 协议一致性检查(标签映射/几何信息) | ✅ 已通过 |
| 坑点 8 项(§6.5) | 千方病案医学编辑部 | 逐条对应官方 FAQ/挑战总结/社区分析来源 | ✅ 已通过 |
| 许可与引用条款(§0/§9) | 千方病案医学编辑部 | 与 Synapse 条款、官方引用要求比对 | ✅ 已通过 |
| §C JSON-LD 与 frontmatter 一致性 | 千方病案医学编辑部 | 逐键比对 @graph 双节点(MedicalWebPage/Dataset)内容 | ✅ 已通过 |
§10.5 AI 生成章节标注
除 §10 声明卡本身由编辑部模板约束生成外,本页 §0-§9 及 §C 结构化数据均为 AI 辅助生成初稿、人工逐节校验后定稿;关键数字(25,256/6,314/71 机构/1,251/219/570/2,625/+33%/+23%/DSC 系列)逐一经检索来源确认。
§10.6 最后人工审核日期
2026-09-05(与 §0.3 审核日期一致)
页面状态:published(全部内容已完成审核并发布)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- ucsf-pdgm — 共享标签:医学影像 / MRI / 肿瘤学 / 脑肿瘤
- brats-africa — 共享标签:医学影像 / MRI / 肿瘤学 / 脑肿瘤
- duke-breast-mri — 共享标签:医学影像 / MRI / 肿瘤学
- rembrandt — 共享标签:医学影像 / MRI / 脑肿瘤
- pi-cai — 共享标签:医学影像 / MRI / 肿瘤学
- synthrad — 共享标签:医学影像 / MRI / 肿瘤学
- atlas-liver-tumor — 共享标签:医学影像 / MRI / 肿瘤学
- ivy-gap — 共享标签:医学影像 / 肿瘤学 / 脑肿瘤
- upenn-gbm — 共享标签:医学影像 / 肿瘤学 / 脑肿瘤
- cptac-imaging — 共享标签:医学影像 / MRI / 肿瘤学
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
