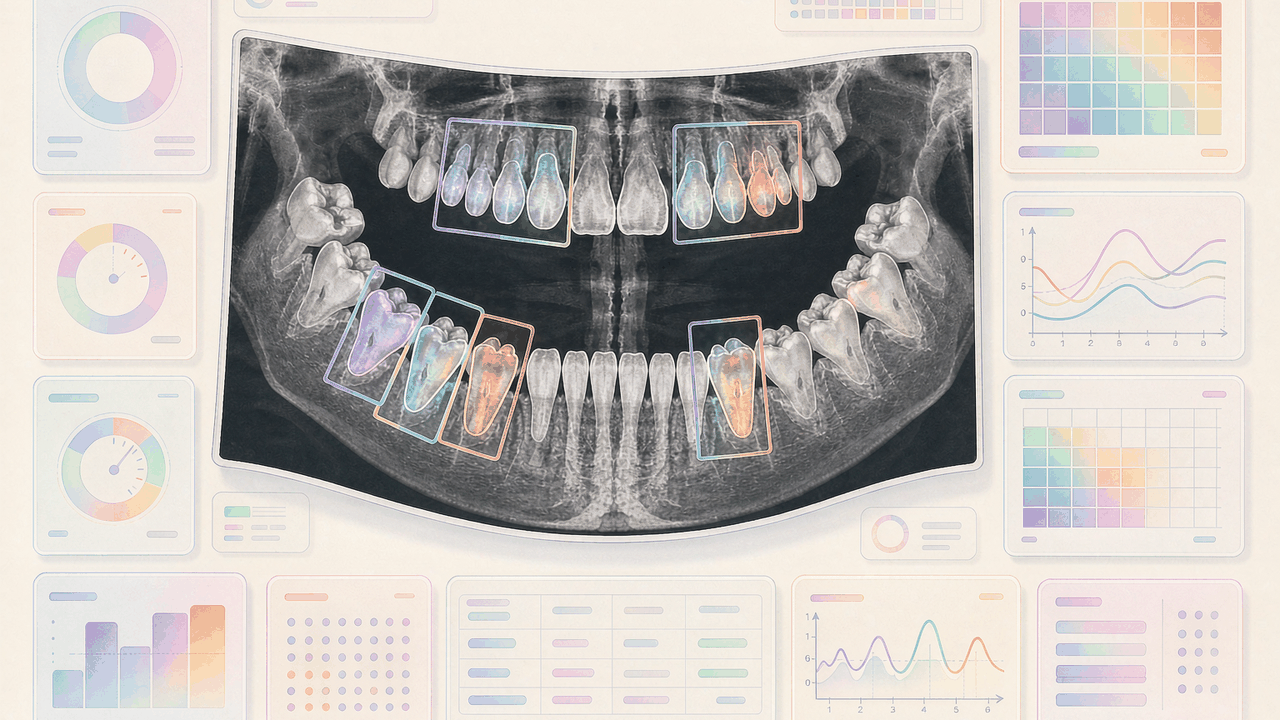
信息速览
DENTEX — 牙科全景片异常检测基准 AI-Ready Wikipedia
INFOBOX
| 数据集名称 | DENTEX 挑战赛数据集 |
| 英文全称 | Dental Enumeration and Diagnosis on Panoramic X-rays(Challenge) |
| 别名/简称 | DENTEX、DENTEX Challenge 2023、DENTEX2023 |
| 疾病分类 | 龋病(ICD-11:DA08.0)/ 深龋(映射 DA08.0,ICD-11 无独立码,ICD-10 参考 K02.1 牙本质龋)/ 根尖周病变(DA09.7 根尖周炎;DA09.6 根尖周脓肿)/ 阻生齿(DA07.8) |
| SNOMED CT | 80967001 Dental caries / 39273001 Apical periodontitis / 109672006 Impacted tooth(详见 §2.1b) |
| 数据模态 | 2D 口外全景牙科 X 光(曲面断层片,panoramic radiograph) |
| AI 任务类型 | 目标检测(异常牙多标签检测)、牙位编号(FDI enumeration)、疾病分类、部分标注学习、自监督预训练 |
| 样本总数 | 3,903 张全景片:693 张仅象限标注 + 634 张象限+牙位标注 + 1,005 张完全标注(train 705 / validation 50 / test 250)+ 1,571 张无标注 |
| 数据大小 | Zenodo:training_data.zip 10.9 GB + validation_data.zip 149.5 MB,合计 11.1 GB |
| 数据格式 | PNG 图像 + JSON/YAML 标注(边界框 + FDI 编码 + 诊断类别) |
| 许可证 | CC BY-NC-SA 4.0(数据,禁商用、相同方式共享);GitHub 评测代码 MIT |
| 访问级别 | 开放(Zenodo / Hugging Face 直接下载;挑战赛评测需注册 Grand Challenge 并以 Docker 提交) |
| DUO 标签 | NCU(非商业使用;CC BY-NC-SA 衍生作品须同源共享) |
| 语言 | 不适用(影像数据);挑战赛文档与论文为英文 |
| 首发日期 | 2023-04-09(Zenodo record 7812323 v1) |
| 最后更新 | 2025-11-13(arXiv v2 扩展版 + Hugging Face 数据卡更新;赛后全部 ground truth 已向研究者公开) |
| 发布机构 | DENTEX Challenge Organizers(University of Zurich / Istanbul Medipol University / ETH Zurich / Bogazici University 等) |
| 官方主页 | https://dentex.grand-challenge.org/ |
| 下载地址 | https://zenodo.org/records/7812323;https://huggingface.co/datasets/ibrahimhamamci/DENTEX |
| DOI | 10.5281/zenodo.7812323(数据);10.48550/arXiv.2305.19112(挑战赛论文) |
| 引用次数 | 51+(Google Scholar,arXiv:2305.19112,截至 2026-09) |
| AI 就绪度评分 | ⭐⭐⭐(3/5)— 官方划分清晰、评测代码与 baseline 开源、开放直下;扣分项:三层标注格式不统一需自行适配检测管线、无官方 PyTorch Dataset、Hugging Face viewer 不可用、部分标注需自设计利用策略 |
| 页面状态 | published |
§0 E-E-A-T 信任声明与免责声明
医学审核:[千方病案医学编辑部] 交叉审核:§2 医学背景(牙齿解剖定位、龋病/根尖周病变/阻生齿流行病学与 ICD-11/SNOMED CT 映射)、§7 偏倚分析(类别不平衡、单国来源泛化风险、外部验证矩阵)。
数据工程审核:[千方病案医学编辑部交叉审核] 医疗 AI 数据工程师,审核范围:§4 DAIMS 数据字典、§5 数据划分策略、§6 预处理 Pipeline 和坑点。
审核日期:2026-09-05
医疗免责声明:本页面提供的医学信息仅供研究和教育目的,不构成医疗建议、诊断或治疗方案。数据集的医学描述基于公开发表的文献,未经逐一临床验证。任何基于该数据集训练的 AI 模型在应用于临床决策前,必须经过独立的临床验证和监管审批。
技术免责声明:本页面的代码示例、预处理建议和基准性能数据基于公开资料整理,不保证在特定环境下的准确性和适用性。使用者应自行验证代码安全性和数据预处理流程的正确性。千方病案医数集不对因使用本页面信息而导致的任何直接或间接损失承担责任。
数据使用合规:使用本页面描述的数据集前,请务必阅读并遵守数据集原始许可协议。DENTEX 数据以 CC BY-NC-SA 4.0 发布(禁商用、衍生作品同源共享),GitHub 仓库代码为 MIT;挑战赛阶段另受 Grand Challenge 平台规则约束。DUO 标签仅供参考,具体使用限制以数据集官方协议为准。
§1 数据集概览
§1.0 📌 30 秒速览
这是什么? DENTEX(Dental Enumeration and Diagnosis on Panoramic X-rays)是挂在 MICCAI 2023 之下、由苏黎世大学与伊斯坦布尔梅迪波尔大学等机构组织的牙科全景片挑战赛数据集。它提供 3,903 张全景牙科 X 光片:693 张只有"象限"标注、634 张有"象限+牙位(FDI 编号)"标注、1,005 张带"象限+牙位+诊断"完整标注(龋齿、深龋、根尖周病变、阻生齿四类),外加 1,571 张无标注图供预训练。
为什么重要? 全景片是口腔科最常用的影像检查,但公开的、带牙齿级病变框标注的数据集极少。DENTEX 的独特设计是把"标签不完整"这一临床现实直接写进了基准:三层级标注迫使算法学会从部分标注中学习,同时对每一颗异常牙同时输出"在哪颗牙(FDI 编号)+ 是什么病(四类之一)"——这正是牙医制定治疗计划所需的信息结构。
我能用它做什么? 训练异常牙检测器(如 YOLOv8、DINO 变体)、研究部分标注/弱监督检测、用 1,571 张无标注图做自监督预训练(官方 baseline 用 SimMIM),或把它当作牙科 AI 系统的标准对照基准。挑战赛最终榜前四名的成绩与官方评测代码均已公开,可直接对标。
§1.1 摘要
DENTEX 挑战赛与 MICCAI 2023(加拿大温哥华)联合举办,结果于 2023-10-08 展示。数据来自土耳其三所临床机构的常规诊疗影像,患者年龄 ≥12 岁,按 FDI 牙位编号系统(象限 1-4 × 牙位 1-8)进行三层级组织:仅象限(693 张)、象限+牙位(634 张)、象限+牙位+诊断(1,005 张,其中训练 705 张、验证 50 张、隐藏测试 250 张),另有 1,571 张无标注图。诊断限定四类:龋齿(caries)、深龋(deep caries)、根尖周病变(periapical lesion)、阻生齿(impacted teeth)。每张图由应届牙科学生初标、15 年以上经验专家牙医逐一审核校正。评测在 1,005 张全标注子集上进行,指标为 AP(IoU 0.50:0.95:0.05 十阈值平均)、AP50、AP75 与 AR 共 4 项 × 3 个标签层级 = 12 项指标,按平均名次排名(另以 Wilcoxon 符号秩检验辅助,p<0.001)。冠军(上海交通大学 He 等,分割引导三阶段方案)平均名次 2.33,象限 AP 47.45%、牙位 AP 35.35%、诊断 AP 37.06%;官方 baseline HierarchicalDet(扩散式分层检测,MICCAI 2023 Springer LNCS)总排名第 3,但诊断 AP 37.6% 为全场最高。
十个数字记住 DENTEX:3,903 张全景片;2,332 张有标注(59.8%)与 1,571 张无标注;三个标注层级(Q / Q+N / Q+N+D);四类诊断;705/50/250 的评测划分;11.1 GB 官方发布包(含 md5);12 项评测指标的秩聚合排名;两阶段赛制(验证集 + 隐藏测试);四个发行渠道(Zenodo / Hugging Face / GitHub / 第三方 YOLO 版);一种许可(数据 CC BY-NC-SA 4.0)。
§1.2 战略价值
维度一:部分标注学习的天然试验场。 医学影像标注的普遍现实是"有框没类、有类没号",而绝大多数公开基准只提供单一粒度。DENTEX 把三种粒度显式拆分为三个子集并纳入同一基准,官方 baseline 专门设计了"冻结未涉及类别头"的多标签方案来利用不完整信息。对研究部分标签检测(partial-label detection)、层级多任务学习的团队,这是牙科领域几乎唯一的官方对照场:冠军队伍的分割引导管线、亚军(杭州 Chohotech)的 YOLOv8 深度改造、baseline 的扩散式检测分别代表三类主流技术路线,全部可复现对标。
维度二:牙科 AI 临床落地的稀有检测基准。 牙科影像 AI 的公开数据多集中在牙位分割与分类,带病变框且带 FDI 编号的检测基准极为稀缺。DENTEX 的输出定义(每颗异常牙的 Q/N/D 三元组)与牙医治疗计划的决策单元一致:知道"48 号牙阻生"比"图里有个病灶"更接近临床可用。挑战赛论文指出,顶级方案在牙位枚举与细微病变分类上仍显著落后于象限检测(牙位 AP 35.35% vs 象限 AP 47.45%),这一定位了该领域的真实难度与后续研究空间。
维度三:可完整复现的评测基础设施。 从数据(Zenodo 带 md5 校验)、代码(官方评测脚本 MIT 开源)、baseline(HierarchicalDet 训练代码与 MICCAI 正式版论文)到榜单(四强方案的 Q/E/D 三层级 AP 完整披露),DENTEX 提供了医学影像挑战赛中少见的"全链路可复现"配置。对需要可信对照实验的团队,这意味着可以把榜单数字直接写进论文的 related work,而不必担心"论文成绩无法对齐官方口径"的经典问题——前提是按官方 12 项指标秩聚合口径报告(见坑点 2)。
§1.3 同类数据集横向对比
| 数据集 | 规模 | 模态 | 标注 | 与 DENTEX 的差异化 |
|---|---|---|---|---|
| DENTEX | 3,903 张全景片 | 口腔全景 X 光 | 三层级框标注:象限 / FDI 牙位 / 四类诊断 | 唯一带"牙位+病变"联合输出的挑战基准;1,571 张无标注图供 SSL |
| VinDr-CXR | 18,000 张胸片 | 胸部 X 光 | 22 类病变框 + 全局标签 | 模态不同;标注粒度统一(全框全类),无层级部分标注设定 |
| TBX11K | 11,200+ 张胸片 | 胸部 X 光 | 结核相关病灶框(4 组 9 类) | 胸部结核检测;单病种谱系,无牙位编号语义 |
| JSRT | 247 张胸片 | 胸部 X 光 | 肺结节/心脏/肺野分割掩码 | 规模小一个量级;分割而非检测任务 |
| RibFrac | 670 例 CT(约 5,000+ 骨折) | 肋骨 CT | 骨折框 + 4 类分型 | 3D CT 检测;DENTEX 为 2D 投影,解剖语义不同 |
| Tufts Dental Database | 约 1,000+ 张全景片 | 口腔全景 X 光 | 诊断标签(图像级,含冠桥修复体等) | 图像级诊断而非牙级框标注;DENTEX 参赛队曾将其作外部增强数据 |
对比表的选型结论:若你的任务需要"每颗牙的框 + 病变类型"输出,DENTEX 是当前唯一满足的公开基准;若只需要图像级筛查标签或牙位分割,Tufts 与其他牙科分割数据集可能更合适。表内四个胸部/骨骼 X 光基准(均可在站内检索)的价值在于方法学互迁——部分标注、长尾类别与隐藏测试评测这三类问题它们各自有成熟方案可借鉴。
§1.4 版本时间轴
| 日期 | 版本/事件 | 说明 |
|---|---|---|
| 2023-04-09 | Zenodo record 7812323 v1 | 挑战赛训练数据(10.9 GB)与验证数据(149.5 MB)发布 |
| 2023-05-30 | arXiv:2305.19112 v1 | 挑战赛总结论文(“DENTEX: An Abnormal Tooth Detection…”) |
| 2023-10-08 | MICCAI 2023(温哥华) | 挑战赛结果展示,最终榜单公布 |
| 2023-10 | MICCAI 2023 Springer LNCS | baseline 论文正式收录(Diffusion-Based Hierarchical Multi-Label Object Detection,pp. 389-399) |
| 赛后(2023-2025) | 完整 GT 公开 | 验证集与测试集 ground truth 向研究者公开(validation_triple.json 等) |
| 2025-10-18 | Zenodo record 17387129 | 参赛短论文集合集(DENTEX Challenge 2023 Proceedings,16.2 MB) |
| 2025-11-13 | arXiv:2305.19112 v2 | 扩展版改题 “DENTEX: Dental Enumeration and Tooth Pathosis Detection Benchmark for Panoramic X-ray”,增加方法学剖析 |
时间轴的读法:2023-04-09(数据)→ 2023-05-30(论文 v1)→ 2023-10-08(榜单)构成挑战赛主链路;赛后更新集中在 2025 年(短论文集、v2 论文、GT 公开),引用与复现工作应以 2025 年后的版本链为最终锚点。注意 v2 论文改题后不再包含 “Abnormal” 一词(“Tooth Pathosis Detection” 替代),检索文献时两个标题都可能出现。
§1.5 典型应用场景
- 异常牙联合检测:输出异常牙框 + FDI 牙位 + 四类诊断标签,直接对接口腔科治疗计划的"牙位级"信息需求。
- 部分标注/弱监督检测研究:三个子集标签粒度不同,可验证损失掩码、多标签层级头、伪标签等策略在真实不完整标注下的表现。
- 自监督预训练:1,571 张无标注全景片适合 SimMIM/MAE 等预训练,官方 baseline 已示范完整流程。
- 牙位枚举(tooth numbering):634 张象限+牙位子集可单独用于自动牙位编号(FDI 记法)研究,这是正畸与种植规划的前置模块。
- 教学与阅片辅助评估:四类病变的框级 GT 可用于放射科住院医师与牙科学生的阅片一致性对照实验。
- 许可安全的学术原型验证:CC BY-NC-SA 4.0 允许非商业的学术使用与同源共享的衍生研究,适合在论文发表前用公开数据快速验证方法可行性,再迁移到自有临床数据。
§2 医学背景
§2.1 ICD-11 编码表
DENTEX 四个诊断类别覆盖口腔科最常见的"可干预"病变谱系(WHO ICD-11 第 13 章"口腔颌面复合体疾病或紊乱",编码经 WHO ICD-11 浏览器口径核实):
映射总原则:DENTEX 类别是"影像可判读的临床分组",而 ICD-11/SNOMED CT 是"病历可编码的诊断实体",两者只在多数病例上重合——deep caries 无独立编码、periapical lesion 跨两个 ICD-11 码,都是分组与编码体系错位的体现。为模型输出挂编码时,应在代码表中保留"映射关系"而非"等同关系"。
| DENTEX 标签 | 中文名 | ICD-11 编码 | 编码名称与说明 |
|---|---|---|---|
| caries | 龋齿 | DA08.0 | Dental caries(龋病),牙硬组织细菌性脱矿破坏 |
| deep caries | 深龋 | DA08.0(无独立 ICD-11 码;ICD-10 参考 K02.1 牙本质龋) | 龋坏进展至牙本质深层的临床分期,接近牙髓 |
| periapical lesion | 根尖周病变 | DA09.7(根尖周炎;急性 DA09.70 / 慢性 DA09.71)/ DA09.6(根尖周脓肿) | 根尖周组织炎症,多为未经治疗龋病的进展结局 |
| impacted teeth | 阻生齿 | DA07.8(Impacted teeth;埋伏牙 DA07.7) | 因骨、牙或软组织阻挡部分萌出或完全不能萌出 |
§2.1b SNOMED CT 映射表
| DENTEX 标签 | ICD-11 | SNOMED CT | 概念名称 |
|---|---|---|---|
| caries | DA08.0 | 80967001 | Dental caries(disorder) |
| deep caries | DA08.0 | 80967001(无独立 SNOMED 概念,深龋为龋病临床分期) | Dental caries(disorder) |
| periapical lesion | DA09.7 | 39273001 | Apical periodontitis(disorder) |
| impacted teeth | DA07.8 | 109672006 | Impacted tooth(disorder) |
§2.2 疾病简介与流行病学
龋齿与深龋:龋病是最常见的慢性疾病之一。据世界卫生组织《口腔健康实况报道》(2023),全球约 20 亿人患恒牙龋齿,约 5.14 亿儿童患乳牙龋。全景片上龋损表现为牙冠密度减低影,深龋指龋坏已达牙本质深层、接近牙髓的临床阶段——全景片对邻面龋与早期龋的敏感度低于咬翼片,这是用 DENTEX 训练的模型在真实筛查链路中的定位边界。
DENTEX 把"龋齿"与"深龋"拆为两个独立类别而非沿用 ICD-11 的单一代码,反映的是临床决策而非编码需求:普通龋齿对应充填治疗,深龋则面临保髓(间接牙髓治疗)与根管治疗的分岔,两者的干预路径与成本完全不同。对算法而言,这一拆分意味着模型必须分辨龋坏在牙本质内的深度——这是四类任务中最依赖细微灰度梯度的判读,也是挑战赛论文把"细微病变分类"列为难点之一的原因。ICD-11 没有为"深龋"设独立码(ICD-10 时代同样仅细分至 K02.1 牙本质龋),本页按临床分期映射回 DA08.0。
根尖周病变:根尖周炎多继发于未经治疗的龋病沿牙髓的感染扩散(龋病 → 不可复性牙髓炎 → 牙髓坏死 → 根尖周炎的疾病链)。全景片上典型表现为根尖区低密度透射影。根尖周病变的检出直接决定根管治疗或拔除决策,是牙位级诊断的核心需求。值得注意的是,根尖周病变是"牙位级"属性最强的类别——病变通过根管系统与特定牙位绑定,漏报或错报牙位都会直接误导治疗计划;这也是 DENTEX 坚持"诊断必须与 FDI 编号成对输出"的临床理由。ICD-11 进一步区分急性(DA09.70)与慢性(DA09.71)根尖周炎,影像判读通常无法可靠区分急慢性,DENTEX 的单一 periapical lesion 类别与影像证据水平一致。
阻生齿:阻生牙因骨、牙或软组织阻挡不能正常萌出,最常见于下颌第三磨牙(智齿),可继发冠周炎、邻牙龋损与邻牙牙根吸收,是口腔颌面外科最常见的手术指征之一。全景片是阻生齿定位(含水平/近中/垂直等阻生方向判断)的一线检查。与前三类"获得性病变"不同,阻生齿是发育/位置异常,框通常更大且边界(牙冠至牙根)更完整,类间形态差异大——这对检测器是相对友好的类别,但阻生齿与邻近第二磨牙的关系(牙根吸收、接触)在框级标注中并不编码,属于该类别标注的语义边界。ICD-11 中阻生齿为 DA07.8,与之相邻的埋伏牙(embedded teeth,DA07.7)为非阻塞性的未萌出,两者编码有别,DENTEX 类别定义对应阻生齿。
§2.3 临床任务定义
| 任务 | 输入 | 输出 | 临床环节 | DENTEX 对应 |
|---|---|---|---|---|
| 异常牙检测 | 全景片 | 异常牙边界框 | 初筛阅片 | quadrant-enumeration-diagnosis 子集 |
| 牙位编号(enumeration) | 全景片 | 每颗牙的 FDI 编号 | 检查记录、跨院转诊 | quadrant-enumeration 子集 |
| 象限分区(quadrant) | 全景片 | Q1-Q4 象限框 | 编号系统的前置分解 | quadrant 子集 |
| 病变分类 | 牙齿区域 | 四类诊断之一 | 治疗计划(充填/根管/拔除/随访) | diagnosis 标签(四类) |
FDI 编号系统将口腔分为 4 个象限(右上=1、左上=2、左下=3、右下=4),每象限从中线向后 8 颗牙编号 1-8,两位数字组合定位(如 48 = 右下象限第 8 颗牙、38 = 左下第三磨牙)。该系统是全球通用的牙位记录标准,也是 DENTEX 全部标注的语义骨架。
FDI 两位编码的两位数字各有明确含义,解析标注时可直接利用其结构:
| 编码位 | 含义 | 取值与说明 |
|---|---|---|
| 第 1 位(十位) | 象限 | 1=右上、2=左上、3=左下、4=右下(DENTEX quadrant 标签即此值) |
| 第 2 位(个位) | 牙位序号 | 恒牙列从中线向后 1-8:1=中切牙 … 3=尖牙、4-5=前磨牙、6-8=磨牙 |
| 组合示例 | 48 | 右下象限(4)第 8 颗牙(8)= 右下第三磨牙,DENTEX 官网示例牙位 |
| 组合示例 | 11 | 右上中切牙,编号空间的最小值;48 为最大值 |
对模型设计者而言,这一结构意味着 FDI 枚举任务天然可分解为"象限 4 分类 × 牙位 8 分类"的层次化输出(这正是 DENTEX 三层级评测的骨架),也可以选择直接做 32 类(去缺牙位)的扁平枚举——挑战赛四强方案中两条路线都出现过。注意个位编号在四个象限内是各自从中线向后计数的,同一编号在不同象限对应不同牙位名称,水平翻转增强若不做象限/编号联动映射必然破坏标注语义(见 §6.6)。
§2.4 患者人群
| 维度 | 描述 |
|---|---|
| 来源 | 土耳其三所临床机构的常规诊疗数据库(官方未披露医院名单) |
| 年龄 | ≥12 岁(随机抽取) |
| 时间范围 | 官方未披露具体采集起止年份 |
| 性别/种族分布 | 官方未披露 |
| 就医类型 | 常规口腔诊疗(标准临床条件采集) |
| 去标识化 | 随机抽取并脱敏后发布,不含患者标识与 DICOM 头信息 |
人群表整体偏"稀"是 DENTEX 元数据的客观现状:除年龄下限与来源国家外,官方未披露任何人口学分布。这直接限制了三类分析——按人群分层的性能审计(§7.5)、按机构溯源的误差分析(§3.9)、以及患者级重复的量化(§4.4)。使用者应在实验设计阶段就把这些"官方未披露"当作确定约束,而不是事后发现。
§2.5 临床价值
全景片解读耗时且漏诊风险随阅片疲劳上升。DENTEX 把"指出异常牙 + 编号 + 诊断"定义为一个联合输出,对应牙医实际阅片时的三个认知动作(哪里有异常、是哪颗牙、是什么病变)。一个在该基准上表现合格的模型可直接嵌入两类工作流:一是初筛分流(提示可疑牙位供牙医复核,降低漏诊),二是结构化病历生成(自动写入 FDI 牙位与病变类型)。挑战赛总结论文同时强调,牙位枚举与细微病变分类(尤其深龋与根尖周病变的鉴别)仍是显著难点——模型输出目前应定位为"第二阅片者",而非自主诊断。
与临床价值相对的是临床边界的清晰声明:数据不含儿童混合牙列(<12 岁)、不含全景片敏感度不足的早期邻面龋谱系、不覆盖修复体与种植体相关发现;三个边界叠加决定了模型即使指标合格,其阴性输出也只能读作"未检出四类目标病变",而非"口腔健康"。
§2.6 金标准参考表
| 维度 | DENTEX 的金标准 |
|---|---|
| 划分 | 1,005 张全标注图按 705/50/250 分为训练/验证/测试;测试集挑战赛期间隐藏 |
| 标注方式 | 人工框标注(边界框 + FDI 编号 + 诊断类别),逐牙标注 |
| 标注者 | 应届牙科学生初标 + 15 年以上经验专家牙医审核校正(官网称三位专家之一、论文 v2 称两位专家 M.G. 与 S.D.O.) |
| 性质 | 图像级专家标注(两层人工审核),非自动生成;标注一致性系数(IoU/κ)官方未公布 |
| 一致性风险 | 无多标注者独立标注可供估计方差;深龋/早期根尖周病变等临界判读建议自行抽检(§7.2) |
与同类基准相比,DENTEX 金标准的强项在"标注协议透明"(谁标、谁审、如何分层全部可查),弱项在"量化证据缺失"(无一致性系数、无逐类计数)。评价其他牙科数据集时,可以本表为对照模板逐行核对。
§3 数据集规格
§3.0 版本抉择矩阵
DENTEX 没有传统意义的"多版本",但同一数据存在三个发行渠道,内容与格式差异显著:
| 你的需求 | 推荐渠道 | 大小 | 理由 |
|---|---|---|---|
| 复现挑战赛结果 / 对标论文 | Zenodo record 7812323 | 11.1 GB | 官方原始发布包,含挑战赛时期文件组织与 md5 校验 |
| 快速实验 / 国内下载 | Hugging Face ibrahimhamamci/DENTEX | 约 11.1 GB | 与 Zenodo 同源;但 viewer 不可用,需 git clone 或直接拉取 zip(见坑点 4) |
| YOLO 格式快速起步 | Ultralytics 平台重托管(第三方) | 483.8 MB | 已转为 YOLO 检测格式(仅 705 张训练子集、3,529 个标注框);非官方发行版,论文对标需谨慎 |
| 评测代码 | GitHub ibrahimethemhamamci/DENTEX | — | 官方评测脚本(12 项指标)+ MIT 许可 |
矩阵的默认答案:论文复现走 Zenodo,日常实验走 Hugging Face,两条链路都以官方 md5 为准。YOLO 版只在你明确理解它"仅 705 张训练子集、类别口径与官方不同"的前提下用于教学演示。任何渠道下载后,先跑 §6.1 的探查脚本确认目录与键名,再决定解析器写法。
§3.1 模态详情
2D 口外全景牙科 X 光(曲面断层片):单张投影覆盖全牙弓、上颌骨、下颌骨与双侧颞下颌关节区,是口腔科一线检查模态。图像为灰度 PNG;不同机构设备与成像协议存在差异(官网口径),挑战赛论文提及 VistaPano S X-ray unit(Dürr Dental 制造)。影像空间分辨率依来源机构而异,官方未统一说明(以发布包内实际文件为准)。
从建模视角看全景片的三个特性值得在训练前理解:
- 曲面体层投影:全景片不是单次曝光的静态投影,而是 X 射线源与探测器围绕患者头部旋转扫描、将弓形断层域展开为一张平面图像的结果。这带来两个后果——牙弓两端(第三磨牙区)与中线区域的几何放大率与清晰度不一致;非断层域结构(如颈椎影)会以重叠伪影形式出现。
- 结构重叠:上颌与下颌牙列、双侧牙弓在同一张图上左右对称铺开,辅以颌骨、鼻底、上颌窦底等解剖背景,是典型的"背景复杂、目标密集"检测场景;目标之间还会相互遮挡(尤其是拥挤牙列与阻生齿)。
- 灰度语义:牙釉质、牙本质、牙髓腔、根尖周骨质的密度阶梯构成判读基础。图像为灰度、无色彩信息,预处理时任何基于 ImageNet 彩色统计的归一化都不适用(见 §6.3)。
这些特性解释了为什么官方 baseline 选择 SimMIM 自监督预训练(无标注图利用结构性先验)以及为什么冠军方案引入分割引导——都是针对上述投影与重叠特性的补偿。
§3.2 按子集样本数
| 子集 | 图像数 | 标注内容 | 用途 |
|---|---|---|---|
| (a) quadrant | 693 | 仅象限框(Q1-Q4) | 象限检测训练/开发 |
| (b) quadrant-enumeration | 634 | 象限框 + 全部牙齿 FDI 编号框 | 牙位枚举训练/开发 |
| © quadrant-enumeration-disease | 1,005 | 异常牙框 + Q + FDI + 诊断(四类) | 官方评测基准(705/50/250 三分) |
| ©-train | 705 | 含 ground truth | 训练 |
| ©-validation | 50 | 赛期无 GT(赛后 validation_triple.json 公开) | 挑战赛阶段提交 |
| ©-test | 250 | 赛期隐藏(赛后 GT 公开) | 最终排名 |
| unlabelled | 1,571 | 无标注 | 可选自监督预训练 |
| 合计 | 3,903 | — | — |
三层级标注的设计意图:官方把"标签粒度"而非"数据量"作为挑战核心——两个部分标注子集(693+634=1,327 张)在数量上超过全标注训练集(705 张),但若算法不能正确利用不完整标注,这些数据就是废料。这一设计直接来自牙科标注的真实成本结构:象限框最便宜、全牙枚举次之、带诊断的异常牙标注最贵(需要专家判读)。论文 v2 明确将"从不完整标注中学习"列为挑战赛要回答的方法学问题之一,冠军与 baseline 的方案差异也集中在对三层标注的利用策略上(见 §6.5 坑点 1、§6.7)。
§3.3 数据格式
| 要素 | 格式 |
|---|---|
| 图像 | 灰度 PNG |
| 标注 | JSON(检测框 + 类别 + FDI 编码;分层级子目录存放) |
| 验证集标签 | validation_triple.json(赛后公开) |
| 分发包 | ZIP(Zenodo);Hugging Face 平行托管 |
| 评测 | Python(官方 GitHub 仓库,COCO 风格 AP 计算) |
发行渠道间的命名与组织差异(解析前必读,详见坑点 3):
| 变体点 | Zenodo 发布包 | Hugging Face 镜像 | 影响 |
|---|---|---|---|
| 全标注子集目录名 | quadrant_enumeration_disease(下划线) |
同左,但数据卡描述曾混入 CT-CLIP 文案(后修正) | 照数据卡教程写路径可能报 FileNotFoundError |
| 枚举子集目录名 | quadrant-enumeration(连字符) |
同左 | 与全标注子集命名风格不一致,硬编码易错 |
| JSON 键名 | 不同子集间存在差异 | 存在差异 | 解析器必须先探查后编写(§6.1) |
| Viewer 支持 | 不适用(直接下载) | load_dataset 失败,viewer 报 FileFormatMismatchBetweenSplitsError |
HF 自动化加载链路不可用(坑点 4) |
| 校验手段 | 官方提供 md5 | 无官方 md5 页面 | 生产环境建议统一走 Zenodo 并校验 md5 |
§3.4 存储大小
Zenodo 发布包合计 11.1 GB:training_data.zip 10.9 GB(md5 eba0c44fa4c6e8ec221db3009eccc1f9)+ validation_data.zip 149.5 MB(md5 b2a13267740185e42cb59e968bc3ce83)。解压后建议预留 ≥15 GB 空间(含解压中间态)。Ultralytics 第三方重托管的 YOLO 版(仅疾病检测训练子集)为 483.8 MB,适合轻量实验。
存储实践提示:10.9 GB 的单 zip 在慢速网络下容易下载超时,Zenodo 支持断点续传(wget -c 或 curl -C -),生产环境建议优先走 Zenodo 并以 md5 校验为准(Hugging Face 镜像无官方 md5 页面);解压后如需长期归档,保留原始 zip 与解压目录并存是最稳妥的血缘策略(§6.10)。
§3.5 标注方式
全部标注为人工框标注,按 FDI 系统三层级组织(详见 §3.2)。诊断标注限定四类 clinically actionable 病变(龋齿、深龋、根尖周病变、阻生齿);正常牙齿仅在 quadrant-enumeration 子集中以"全牙框"形式出现,全标注子集只框异常牙。标注格式为检测框(非分割掩码、非牙齿裁剪分类)。
把单个异常牙标注展开,是如下三个语义字段绑定的三元组:
- Q(quadrant,象限):FDI 编码的十位数字,1-4,标记牙齿所在颌位与侧别;
- N(enumeration,牙位编号):FDI 两位编码(11-48 去缺牙位),在象限内唯一确定牙位;
- D(diagnosis,诊断):四类之一(caries / deep caries / periapical lesion / impacted teeth)。
三个字段同时出现在 challenge 的输出定义中:评测时同一框要在三个层级分别按 Q、Q×N、Q×N×D 与真值匹配计算 AP(§8.3)。这意味着标注里的框-编号-诊断是不可拆分的整体——任何破坏对应关系的预处理(如翻转后只翻转框不改标签)都会让三个层级同时失配。
§3.6 标注者资质与一致性
两步标注协议:每张图先由应届(最后一年)牙科学生标注,再由具有 15 年以上临床经验的专家牙医逐一验证与校正——官网表述为"三位专家牙医之一",挑战赛论文 v2 提及两位专家(M.G.、S.D.O.)。这一双层协议保证了标注的临床可用性,但官方未公布标注者间一致性指标(如框 IoU 或 Cohen’s κ),使用者应假设框边界存在观察者间变异(见 §7.2)。
对协议本身的解读:(1) "学生初标 + 专家校正"意味着最终 GT 反映的是校正后的单一版本,而非多标注者共识——不存在可供估计标注方差的多次独立标注;(2) 专家牙医同时是挑战赛组织团队成员(论文 v2 口径),标注与规则制定同源,这在医学挑战赛中常见但意味着"独立仲裁者"角色缺位;(3) 学生标注与专家校正之间的差异量(即校正幅度)未公布,无法据此估计任务难度分布。这三点共同构成本页把"标注一致性"记为 DAIMS ⚠️ 项的依据。
§3.7 采集周期
官方未披露具体采集起止年份。数据发布于 2023-04-09(Zenodo v1),为挑战赛按 MICCAI 2023 周期组织的回顾性收集(从医院数据库随机抽取已存档影像)。对时间敏感的应用(如龋病患病率随年份变化的建模),这一缺位意味着 DENTEX 不提供任何时间轴信息,不应被用于时间序列类研究。
§3.8 地域覆盖
全部影像来自土耳其三所临床机构,患者为 ≥12 岁的常规就诊人群。单国、三机构的来源结构意味着地理与人群多样性有限(见 §7.1 偏倚与 §7.3 泛化性)。组织团队本身分布在瑞士(苏黎世大学、ETH Zurich)与土耳其(Istanbul Medipol、Bogazici University),数据采集与算法研发分处两国——这一"欧土协作"结构是理解该挑战赛定价(欧洲方法学设计 + 土耳其临床数据)的背景。
§3.9 设备规格
| 要素 | 描述 |
|---|---|
| 设备 | 官网称三机构"设备与成像协议各异";挑战赛论文提及 VistaPano S X-ray unit(Dürr Dental,德国) |
| 检查类型 | 口外曲面断层(panoramic),标准临床条件 |
| 图像属性 | 2D 灰度投影;分辨率与尺寸依来源机构而异,官方未统一披露 |
| 逐例设备元数据 | 未随数据发布 |
| 厂商/型号分布 | 官方未披露三机构各自使用的设备清单 |
| 拍摄参数(kV/mAs/曝光) | 未随数据发布 |
设备元数据的缺位有两点实际影响:一是无法在训练中按设备分层或做设备归一化,模型学到的很可能是"三机构混合分布";二是无法在部署端做"设备白名单"式的适用性声明——这与 §7.3 泛化性表和 §7.6 漂移监控中的建议直接相关。
§3.10 深度溯源链
医院数据库(土耳其三所机构,伦理批准后随机抽取)→ 官方标注团队(应届牙科学生 + 15 年以上专家牙医双层审核)→ 挑战赛数据包(Zenodo record 7812323,2023-04-09)→ Grand Challenge 平台评测(隐藏测试集,Docker 提交)→ 赛后完整 GT 公开(Zenodo + Hugging Face,2025 更新)→ 扩展版论文(arXiv:2305.19112 v2,2025-11-13)。全链路均由挑战赛组织团队(University of Zurich / Istanbul Medipol University)主导,无第三方再标注环节。
溯源链上唯一不可追溯的环节是"医院 → 官方"这一段:伦理批准细节、脱敏执行方与医院名单均未随数据披露(官方仅声明脱敏与伦理批准)。使用者引用数据出处时,准确表述是"土耳其三所临床机构(匿名)",不要引用任何第三方材料中的具体医院猜测。
§4 数据结构
§4.0 目录树
以下为 Zenodo/Hugging Face 发布包解压后的目录结构预览(依据官方发布说明与社区解压记录整理;子目录命名存在连字符/下划线混用,见坑点 3):
DENTEX/
├── training_data/                          # training_data.zip(10.9 GB,md5 eba0c44f…)
│   ├── quadrant/                           # 693 张:仅象限标注(目录名单词单数、无后缀)
│   │   ├── *.png                           #     全景片图像
│   │   └── *.json                          #     象限框标注(Q1-Q4),无牙位/诊断字段
│   ├── quadrant-enumeration/               # 634 张:象限 + 全牙 FDI 编号
│   │   │                                   #     ⚠️ 此目录用连字符,与下一目录的下划线风格不一致
│   │   ├── *.png
│   │   └── *.json                          #     全牙框 + Q + FDI 编码(框所有牙齿,含正常牙)
│   ├── quadrant_enumeration_disease/       # 1,005 张:完全标注
│   │   │                                   #     ⚠️ 此目录用下划线;官方评测基准所在
│   │   ├── *.png                           #     train 705 / validation 50 / test 250 混放同一目录
│   │   └── *.json                          #     异常牙框 + Q + FDI + 四类诊断(仅异常牙有框)
│   └── unlabelled/                         # 1,571 张:无标注(预训练用)
│       └── *.png                           #     无 JSON;图名即唯一标识
└── validation_data/                        # validation_data.zip(149.5 MB,md5 b2a13267…)
    └── quadrant_enumeration_disease/
        ├── *.png                           # 验证集 50 张
        └── validation_triple.json          # 验证集 Q/N/D 标签(赛期不公开,赛后发布)
三个使用提示:(1) 全标注子集的 1,005 张图混放在同一目录,train/validation/test 的归属由官方划分文件决定,不能靠目录区分 split;(2) unlabelled 目录在任何脚本中都不应产生"读取 JSON"的假设;(3) Hugging Face 镜像的 split 组织方式与上述目录不同(train/test 为 imagefolder、validation 另附 JSON),跨渠道混用脚本前先核对路径常量。
§4.1 DAIMS 字段字典
检测标注的核心语义字段如下(JSON 键名在不同子集与发行渠道间存在差异,以发布包实际文件为准,解析前先探查,见 §6.1 与坑点 3):
| 字段 | 类型 | 说明 | 示例值 | AI 用途 | 观测误差 | 信息性缺失编码 | 取值范围 |
|---|---|---|---|---|---|---|---|
| image_id | Text | 图像唯一文件名(PNG,含 split 前缀) | 全标注子集内唯一文件名 | 主键关联 | 无 | 无 | 子集内唯一 |
| split | Text | 所属划分 | train / validation / test | 划分对齐 | 无 | 无 | 3 个枚举值 |
| bbox | Float×4 | 异常牙框坐标(x_min/y_min/x_max/y_max) | 像素坐标四元组 | 检测回归目标 | 观察者间边界变异(κ 未公布) | 不适用(框级全标) | 图像尺寸内 |
| quadrant | Integer | 牙齿所属象限(FDI 第 1 位) | 4 | 分层分类头目标 | 低(区域级) | 子集未标此层 = 不适用 | 1-4 |
| fdi_code | Integer | FDI 牙位编码(两位数) | 48 | 枚举分类头目标 | 低(编号约定明确) | 子集未标此层 = 不适用 | 11-48(去缺牙位) |
| diagnosis | Integer/Text | 诊断类别(四类) | caries | 病变分类头目标 | 中(深龋/龋齿分界、根尖周病变判读) | 非异常牙无此字段 | caries / deep caries / periapical lesion / impacted teeth |
| annotation_level | Text(派生) | 该图所属标注层级 | quadrant-enumeration-disease | 部分标注策略路由 | 无 | 无 | 3 个枚举值 + 无标注 |
| file_path | Text(派生) | 图像相对路径(split 目录 + 子集目录 + 文件名) | training_data/quadrant_enumeration_disease/xxx.png | 数据加载 | 无 | 无 | 依渠道而异(见 §3.3 差异表) |
| image_size | Integer×2(派生) | 图像高宽(像素),需读取 PNG 获得 | 官方未统一披露 | 预处理与框裁剪 | 无 | 无 | 依来源机构而异 |
| patient_id | — | 患者标识 | 官方未发布 | 患者级分组/去重 | 不适用 | 不适用(字段不存在) | 无法推断(见坑点 8) |
字段字典的三点读法:其一,quadrant/fdi_code/diagnosis 三列的"信息性缺失编码"都写的是"子集未标此层 = 不适用"——再次强调这是部分标注语义而非缺失值;其二,patient_id 行整行不存在于发布数据中,任何患者级分析都需外部信息或保守假设;其三,image_size 与 file_path 是派生字段,DAIMS 语义下仍值得单列,因为三机构影像尺寸不统一是实际会踩到的预处理变量。
§4.2 标签分布
层级分布(官方口径,确定):quadrant 693 张、quadrant-enumeration 634 张、quadrant-enumeration-disease 1,005 张(705/50/250)、无标注 1,571 张。
诊断类别分布(官方未公布逐类计数):挑战赛论文未提供四个诊断类别的实例数量表,仅在方法讨论中定性指出类别不平衡问题。第三方口径可供量级参考:Ultralytics 重托管版对 705 张训练图统计为 678 张含标注、共 3,529 个异常牙框(该版将牙位+疾病合并为目标类别,非纯四类统计)。实践建议:拿到数据后先运行一次逐类计数脚本(§6.1),把类别先验写入损失权重或采样器(见坑点 6)。
牙位分布:FDI 编码覆盖 11-48 的天然牙位空间;第三磨牙(18/28/38/48)与第一/第二磨牙区为龋齿与阻生齿的高发区,前牙区异常比例相对低(依 §2.2 流行病学推断,官方未发布逐牙位统计)。
统计口径换算提示:Ultralytics 第三方口径的"3,529 个标注框"是 705 张训练图上的异常牙框总数(678 张图至少有一个框,即约 27 张训练图无异常牙、构成天然背景负样本),不是 1,005 张全标注子集的总框数,更不是全部 2,332 张有标注图的对象数。跨论文引用统计数字时务必核对口径(哪些图、哪些层级、哪一渠道),否则会产生"同一数据集两个框数"式的假性矛盾。
§4.3 关键统计
| 统计项 | 数值 | 来源 |
|---|---|---|
| 图像总数 | 3,903 张 | 官网数据页(693+634+1,005+1,571) |
| 有标注图像 | 2,332 张 | 同上(693+634+1,005) |
| 无标注图像占比 | 约 40.2%(1,571/3,903) | 上两行换算 |
| 完全标注子集训练 GT | 705 张(含 3,529 个异常牙框,第三方口径) | Ultralytics 重托管页 |
| 训练 GT 中无异常牙的背景图 | 约 27 张(705−678,第三方口径换算) | 同上 |
| 诊断类别数 | 4 类 | 官网数据页 |
| 诊断逐类计数 | 官方未公布 | arXiv v2 论文(仅定性讨论不平衡) |
| 标注协议 | 学生初标 + 15 年以上专家校正 | 官网数据页 |
| 基准指标 | 4 指标 × 3 层级 = 12 项 | arXiv v2 论文 |
| 发布包大小 | 11.1 GB(Zenodo) | Zenodo record 7812323 |
关键统计表与 §4.2 的分工:本表只收录有官方或可注明来源的数字;一切官方未公布且无法从现有口径安全换算的量(逐类框数、逐象限分布、患者数)不进本表,其缺位本身就是信息——见 §7.7 的 DAIMS 扣分项。
§4.4 数据层级
机构(土耳其 3 所)→ 患者(≥12 岁,数量未披露)→ 全景片(3,903 张,1 张/检查)
  → 牙齿区域(边界框)
      → quadrant 子集:仅象限级框
      → quadrant-enumeration 子集:全牙框 + FDI 编码
      → quadrant-enumeration-disease 子集:异常牙框 + Q + FDI + 诊断
注意:患者与检查是多对一关系(理论上同一患者可贡献多张影像),但官方未发布患者 ID 字段,患者级分组无法直接从数据推断(见 §5.3 与坑点 8)。
层级结构的另两个推论:其一,"1 张全景片/检查"意味着没有 CT/MRI 式的切片内层级,数据粒度天然到"图"为止——这简化了加载逻辑(无需 DICOM 序列解析),但也意味着无法通过同一检查内的多视角做交叉验证式的一致性检验;其二,层级中的"牙齿区域"在两个子集语义不同(全牙 vs 异常牙),所以上面的树状图里没有把"牙齿"作为独立节点展开——它不是数据集的一等实体,而是框的属性。这也是把 DENTEX 从"数据层级"角度与牙位裁剪分类数据集(如各类 periapical 数据集)区分开的关键。
§4.5 缺失值与信息性缺失编码
DENTEX 无表格型缺失值,其"缺失"是结构性的:三个子集各自只带一部分标签层级。关键语义:某子集中"没有诊断标签"不等于"没有病变"——quadrant 子集的图可能含有未标注的异常牙。这不是缺失值插补问题,而是部分标注(partial annotation)问题,处理不当会系统性污染训练信号(见坑点 1)。同理,全标注子集只框异常牙,正常牙不产生框——把"无框"当"无牙"或把全牙框任务与异常牙框任务混训都会出错(见坑点 5)。
工程上的落地规则:数据加载器应为每张图显式构造 annotation_level(从目录名派生)与"允许监督的类别掩码",而不是在读取 JSON 时按"字段是否存在"临时判断——后者会在键名漂移(坑点 3)时静默退化为"全负样本",且极难从训练曲线上发现。
§5 划分与使用建议
§5.1 官方划分
| 划分 | 图像数 | 标签可见性 | 官方用途 |
|---|---|---|---|
| 全标注训练集 | 705 | GT 公开 | 训练 |
| 全标注验证集 | 50 | 赛期无 GT;赛后 validation_triple.json 公开 | 挑战赛阶段提交/本地调优 |
| 全标注测试集 | 250 | 赛期隐藏;赛后 GT 公开 | 最终排名 |
| quadrant 子集 | 693 | GT 公开 | 训练/开发(不参与评测) |
| quadrant-enumeration 子集 | 634 | GT 公开 | 训练/开发(不参与评测) |
| 无标注子集 | 1,571 | — | 可选预训练 |
官方明确:前两个部分标注子集仅供训练与开发,评测只在全标注子集上进行;允许使用公开外部数据增强或预训练,但必须在最终方法描述中书面声明数据集与来源。
赛后 GT 公开的含义:validation_triple.json 与测试集 GT 现已可得,本地复现完整 12 项指标成为可能——这是 DENTEX 相对"测试集永久隐藏"类挑战赛的重大优势。但相应地,赛后一切"在测试集上的改进报告"都应被读作"在已被反复观测的测试集上的数字",其信息量低于 2023 年榜单的原始成绩。学术写作中的稳妥做法:主表用官方榜单数字,自己的方法以"测试 GT 一次评估 + 训练集内交叉验证"双口径报告。
§5.2 社区惯例与策略建议
赛后研究者普遍使用官方 705/50/250 划分做方法对比(保持与论文可比),并在训练集内部再做 k 折划分用于消融。对层级标注的使用策略,官方 baseline 与参赛队的共同做法是:把三层级合并为"逐图可用的标签集合"(每图带一个允许监督的类别掩码),训练时按掩码屏蔽损失;象限子集可先训象限检测器,再级联给枚举/诊断头做先验(冠军 He 队即采用分割引导 + 级联思路)。
一个值得注意的社区分野:挑战赛参赛队(受规则约束)几乎都用全部三层级数据,而赛后方法论文中不少只报告 QED 子集 705 张的纯监督结果——两种设定都合规,但成绩不可互比。复现或对比他人工作时,先确认对方用了哪些子集与外部数据,再决定是否直接比数字。
§5.3 泄漏风险
| 风险 | 说明 | 缓解 |
|---|---|---|
| 患者级重复 | 同一患者可能贡献多张影像,官方未发布患者 ID | 无法从数据层面排除;报告结果时注明该限制,避免宣称"患者级独立" |
| 测试集 GT 已公开 | 赛后测试标签可得,继续在其上"调参"会使测试集退化为验证集 | 学术对比锁定官方划分只调一次;新方法调参用训练集内 k 折 |
| 外部数据重叠 | 使用 COCO/Tufts 等外部数据预训练时,若外部集与 DENTEX 同源(同医院、同设备)会造成隐性泄漏 | 按官方要求书面声明外部数据及来源;核查外部集患者与 DENTEX 无交集 |
| 增强泄漏 | 水平翻转等增强会破坏 FDI 象限语义(Q1↔Q2、Q3↔Q4、编号镜像) | 见坑点 1 与 §6.6 |
§5.4 交叉验证建议
# 训练集内分层 5 折示意:按"是否含稀有诊断类别"分层,保证每折都有四类样本
# 依赖:仅需官方训练 GT(705 张全标注图)
import json, random
from collections import defaultdict

with open("train_gt.json") as f:          # 转换自官方标注(字段名以实际版本为准)
    records = json.load(f)

by_class = defaultdict(set)                # diagnosis -> image_ids
for img_id, ann in records.items():
    for d in ann.get("diagnoses", []):
        by_class[d].add(img_id)

random.seed(42)
folds = {i: set() for i in range(5)}
for d, ids in sorted(by_class.items()):    # 稀有类优先铺满各折
    for k, img_id in enumerate(sorted(ids)):
        folds[k % 5].add(img_id)

rest = [i for i in records if i not in set().union(*folds.values())]
for k, img_id in enumerate(rest):
    folds[k % 5].add(img_id)
§5.5 外部验证建议
单国三机构来源决定了 DENTEX 上的成绩不等于跨地域成绩。建议:以 DENTEX 训练的模型在 Tufts Dental Database(美国、图像级诊断标签)或其他机构全景片库上做域迁移评测(至少报告分布偏移下的框召回变化);反向地,以 Tufts 训练的分类器在 DENTEX 牙位裁剪上评测可作为对照。所有外部评测应报告设备/机构来源,避免混入与训练集同源的影像。做不了跨库评测时,最低限度的替代方案是在自有数据(哪怕 50 张)上报告逐类召回率——比在 DENTEX 测试集上再刷 0.5 个点更有说服力。
§6 AI 就绪指南 ⭐
§6.0 云端快速启动
# Colab/Kaggle 一键起步:下载 → 校验 → 解压(Zenodo,合计约 11.1 GB)
!wget -q "https://zenodo.org/records/7812323/files/training_data.zip?download=1" -O training_data.zip
!wget -q "https://zenodo.org/records/7812323/files/validation_data.zip?download=1" -O validation_data.zip
!md5sum training_data.zip     # 期望:eba0c44fa4c6e8ec221db3009eccc1f9
!md5sum validation_data.zip   # 期望:b2a13267740185e42cb59e968bc3ce83
!unzip -q training_data.zip && unzip -q validation_data.zip
两条下载提示:Zenodo 大文件建议加 wget -c 断点续传;Kaggle 环境可将两个 zip 作为私人 Dataset 上传一次,后续 notebook 直接挂载,避免重复下载 11.1 GB。
§6.1 快速上手
# 快速上手:加载 quadrant_enumeration_disease 训练子集并做最小可视化验证
# 目录结构预期(data_root 指向解压后的 DENTEX 根目录):
#   data_root/
#   ├── training_data/
#   │   ├── quadrant/                      ← 693 张,仅象限标注
#   │   ├── quadrant-enumeration/          ← 634 张,象限 + 全牙 FDI 编号
#   │   ├── quadrant_enumeration_disease/  ← 1,005 张完全标注(train 705 含 GT)
#   │   └── unlabelled/                    ← 1,571 张无标注
#   └── validation_data/
#       └── quadrant_enumeration_disease/  ← 验证 50 张 + validation_triple.json
# data_root 拼接关系:image_path = data_root/<split_dir>/<subset_dir>/<image_file>
# 最小可用子集:quadrant_enumeration_disease 的 705 张训练 GT 即可启动检测训练
import glob, json, os

DATA_ROOT = "./DENTEX"
qed_dir = os.path.join(DATA_ROOT, "training_data", "quadrant_enumeration_disease")

images = sorted(glob.glob(os.path.join(qed_dir, "*.png")))
annos = sorted(glob.glob(os.path.join(qed_dir, "*.json")))
print(f"images: {len(images)}, annotation files: {len(annos)}")

# 官方 JSON 键名在不同子集/渠道间存在差异(见坑点 3):先探查结构再写解析器
with open(annos[0]) as f:
    sample = json.load(f)
print(json.dumps(sample, indent=2, ensure_ascii=False)[:600])
# 最小可视化:把一张图的框与(Q、FDI、诊断)标签画出来,核对坐标语义
import matplotlib.patches as patches
import matplotlib.pyplot as plt
from PIL import Image

def show_sample(img_path, anno_path):
    img = Image.open(img_path).convert("RGB")
    with open(anno_path) as f:
        anno = json.load(f)
    fig, ax = plt.subplots(1, figsize=(14, 7))
    ax.imshow(img, cmap="gray")
    # ↓ 按上一步探查到的实际键名调整:此处按"框列表 + 每框 Q/N/D 标签"的语义结构遍历
    for box in anno.get("boxes", anno if isinstance(anno, list) else []):
        x_min, y_min, x_max, y_max = box["bbox"]      # 键名以实际文件为准
        ax.add_patch(patches.Rectangle((x_min, y_min), x_max - x_min, y_max - y_min,
                                       linewidth=1.6, edgecolor="#2563EB", facecolor="none"))
        ax.text(x_min, max(y_min - 6, 12),
                f"Q{box.get('quadrant','?')} N{box.get('enumeration', box.get('fdi','?'))} {box.get('diagnosis','')}",
                color="white", fontsize=8, backgroundcolor="#2563EB")
    ax.axis("off")
    plt.show()

show_sample(images[0], annos[0])
§6.2 数据获取
| 渠道 | 内容 | 大小 | 说明 |
|---|---|---|---|
| Zenodo record 7812323 | training_data.zip + validation_data.zip | 10.9 GB + 149.5 MB | 官方原始发布;附 md5 校验 |
| Hugging Face | 同源平行托管 | 约 11.1 GB | viewer 不可用(坑点 4);git clone https://huggingface.co/datasets/ibrahimhamamci/DENTEX 或直拉 zip |
| GitHub 官方仓库 | 评测代码 + README | — | MIT 许可;12 项指标评测脚本 |
| Ultralytics 重托管 | YOLO 格式训练子集 | 483.8 MB | 第三方转换版(705 张/3,529 框),仅做快速起步 |
无需注册或申请:数据以 CC BY-NC-SA 4.0 直接开放下载;若要复现挑战赛在线评测,需在 Grand Challenge 平台注册并按 Docker 容器格式提交推理算法(该在线评测在赛后已非必需,GT 已公开)。
合规三件套(下载即做,避免事后补课):(1) 记录下载日期与 md5(§6.0 校验值)入库;(2) 在项目 README 写明许可为 CC BY-NC-SA 4.0 且衍生数据需同源共享(坑点 7);(3) 若混入外部公开数据,逐条登记来源——这是挑战赛规则,也是赛后学术对比的事实惯例(§5.3)。
§6.3 预处理全流程
# 预处理:灰度化 + 长边缩放 + 框坐标同步缩放 + 归一化
# 输入:官方 PNG(尺寸依来源机构而异);输出:统一 max_size=1024 的张量与缩放后框
import numpy as np
import torch

MAX_SIZE = 1024
IMG_MEAN, IMG_STD = 0.5, 0.25   # 牙科全景片灰度分布的经验初值,首跑后按 §4.2 实测更新

def preprocess(img_np: np.ndarray, boxes: np.ndarray):
    """img_np: HxW or HxWx3 uint8;boxes: Nx4 [x_min,y_min,x_max,y_max] 原始像素坐标"""
    if img_np.ndim == 3:
        img_np = img_np[..., :3].mean(axis=2)              # 三通道转灰度(全景片本为单通道)
    h, w = img_np.shape
    scale = MAX_SIZE / max(h, w)                            # 等比缩放,最长边 1024
    new_w, new_h = int(round(w * scale)), int(round(h * scale))
    img = torch.from_numpy(img_np.astype(np.float32))[None, None, :, :]  # 1x1xHxW
    img = torch.nn.functional.interpolate(img, size=(new_h, new_w),
                                          mode="bilinear", align_corners=False)[0, 0]
    img = (img / 255.0 - IMG_MEAN) / IMG_STD
    boxes_scaled = boxes * scale                            # 框坐标随比例同步缩放
    return img, boxes_scaled, (new_h, new_w)
实践要点:(1) 全景片为灰度影像,切勿用 ImageNet 三通道均值归一化;(2) 缩放只用双线性插值作用于图像,框坐标乘缩放系数即可,不要对坐标做插值;(3) 如需 CLAHE 等对比度增强,先在原始灰度上做、再做缩放,并把参数写进配置以便复现;(4) 不同机构影像的尺寸/灰度分布有差异(官网口径),建议按 split 分别统计归一化参数;(5) 上述 IMG_MEAN/IMG_STD 为经验初值——正式训练前用 §6.1 的统计脚本在全部训练图上实测均值/标准差后替换。
§6.4 PyTorch DataLoader
# DENTEX 检测 Dataset:四段式注释见 §6.1;JSON 键名以实际发布包为准(先探查,见坑点 3)
import torch
from torch.utils.data import Dataset, DataLoader
from PIL import Image

DIAG2IDX = {"caries": 0, "deep caries": 1, "periapical lesion": 2, "impacted teeth": 3}

class DentexDetection(Dataset):
    """完全标注(quadrant_enumeration_disease)异常牙检测数据集。
    返回:image (1xHxW)、boxes (Nx4)、labels (N, = 4 + diagnosis_idx,FDI 编码 11-48 映射 4-41)、
    fdi (N,)。N=0 时返回空框(背景图,训练循环需处理空目标)。
    """
    def __init__(self, img_paths, anno_paths, max_size=1024, transform=None):
        self.img_paths, self.anno_paths = img_paths, anno_paths
        self.max_size, self.transform = max_size, transform

    def __len__(self):
        return len(self.img_paths)

    def __getitem__(self, idx):
        img = Image.open(self.img_paths[idx]).convert("L")   # 强制单通道灰度
        with open(self.anno_paths[idx]) as f:
            anno = json.load(f)
        boxes, labels, fdi = [], [], []
        # ↓ 键名以实际 JSON 为准:语义为"每框一个 Q/FDI/诊断 三元组"
        for box in anno.get("boxes", []):
            x_min, y_min, x_max, y_max = box["bbox"]
            if x_max <= x_min or y_max <= y_min:             # 跳过退化框
                continue
            boxes.append([x_min, y_min, x_max, y_max])
            labels.append(4 + DIAG2IDX[box["diagnosis"]])    # 0-3 保留给象限/枚举任务
            fdi.append(int(box.get("fdi", box.get("enumeration", -1))))
        w, h = img.size
        scale = self.max_size / max(h, w)
        img = img.resize((int(w * scale), int(h * scale)), Image.BILINEAR)
        if self.transform:
            img, boxes, labels = self.transform(img, boxes, labels)
        t_img = torch.from_numpy(np.asarray(img, dtype=np.float32))[None] / 255.0
        return (t_img,
                torch.as_tensor(boxes, dtype=torch.float32) * scale,
                torch.as_tensor(labels, dtype=torch.int64),
                torch.as_tensor(fdi, dtype=torch.int64))

def collate(batch):                                          # 目标数量不一,手动 collate
    return tuple(map(list, zip(*batch)))

loader = DataLoader(DentexDetection(images, annos), batch_size=8,
                    shuffle=True, num_workers=4, collate_fn=collate)
for imgs, boxes, labels, fdis in loader:                     # 冒烟测试
    assert len(imgs) == len(boxes)
    break
§6.5 坑点 8 个
⚠️ 坑点 1:把部分标注当完整标签训练,模型学会"只在有标注的地方找病"(分类:标签理解)
问题:三个子集标签粒度不同——quadrant 子集没有牙位与诊断标签,quadrant-enumeration 子集没有诊断标签。若把三子集直接混入同一检测头训练而不加掩码,“该图未标注诊断"会被损失当成"该图无异常牙/无该病”,系统性压制召回;官方专为 baseline 设计了"冻结未涉及类别头"的多标签方案来处理这个问题。
症状:训练损失正常下降,但验证集上诊断 AP 异常低;模型对 quadrant-enumeration 子集来源的图几乎不输出疾病框;把子集拆开评测时成绩差异巨大。
解决:
- 简单方法:为每张图维护"允许监督的类别集合"掩码,损失只在允许类别上回传(象限头用 quadrant 子集、枚举头用 QE 子集、诊断头仅用 QED 子集训练),未涉及的头冻结或屏蔽。
- 进阶方法:按子集分组采样 batch,同一 batch 内任务语义一致;用已完成训练的上游头(象限→牙位)为下游头提供先验(冠军 He 队的分割引导级联即属此类)。
- SOTA 方法:官方 baseline HierarchicalDet——Swin-T+FPN 编码 + 扩散式检测头 + 三个分类头,以 SimMIM 在 1,571 张无标注图上自监督预训练,再在 705 张全标注图上端到端训练,部分标注经"噪声框操控 + 多标签头冻结"利用(MICCAI 2023 LNCS,pp. 389-399)。
参考:arXiv:2305.19112(v2,方法与排名分析);arXiv:2303.06500 / DOI 10.1007/978-3-031-43987-2_38(HierarchicalDet)。
⚠️ 坑点 2:只报一个 mAP 无法与官方榜单对比——排名是 12 项指标的秩聚合(分类:评估误用)
问题:DENTEX 官方评测在 3 个标签层级(quadrant/enumeration/diagnosis)× 4 项指标(AP@IoU 0.50:0.95:0.05、AP50、AP75、AR)共 12 项指标上计算,最终名次按 12 项的平均名次确定(另用 Wilcoxon 符号秩检验辅助,p<0.001)。单一汇总 mAP 不是官方指标:诊断 AP 最高的(37.6%,官方 baseline)总排名只是第 3,冠军靠的是三项任务均衡(平均名次 2.33)。
症状:你的方法单一指标超过榜单队伍但名次无法对上;复现榜单时发现论文报的数字对不上官方口径。
解决:
- 简单方法:直接使用官方 GitHub 仓库的评测脚本,输出 12 项指标并按平均名次聚合。
- 进阶方法:用 pycocotools 分别对三个层级(把框标签映射为层级类别后)各跑一次 COCOeval,拼出 AP/AP50/AP75/AR × 3 层级矩阵,与论文 Table II 对齐。
- SOTA 方法:按官方协议在隐藏测试 GT(赛后已公开)上评测并报告全部 12 项 + 平均名次;跨方法比较时注明是否使用外部数据(官方要求书面声明)。
参考:arXiv:2305.19112 v2(评测协议与 Table I/II);github.com/ibrahimethemhamamci/DENTEX(官方评测代码)。
⚠️ 坑点 3:目录命名与标注格式碎片化——连字符/下划线混用,照抄教程必翻车(分类:工程陷阱)
问题:官方发布包中
quadrant-enumeration(连字符)与quadrant_enumeration_disease(下划线)目录命名并存;JSON 标注的键名在不同子集、不同发行渠道(Zenodo/Hugging Face)间存在差异;官方 Hugging Face 数据卡甚至曾混入另一数据集(CT-CLIP)的文件命名说明(后已修正)。照抄任何单一教程的路径与键名都可能直接报错。
症状:FileNotFoundError(路径连字符写错);KeyError(JSON 键名不符);照 HF README 写 CT 风格文件名解析不到文件。
解决:
- 简单方法:解压后先
find data_root -maxdepth 2 -type d与head探查真实目录树与 JSON 键名(§6.1 探查脚本),再写解析器;路径用os.path.join常量集中管理。- 进阶方法:写一个统一的 schema 探断函数:对每个 JSON 自动识别"框列表在哪、Q/N/D 键叫什么",生成映射配置缓存,之后所有脚本读该配置。
- SOTA 方法:把官方 JSON 一次性转换为内部 COCO 或 YOLO 格式(参考 Ultralytics 重托管版的字段组织),后续管线只面向内部格式,与官方格式解耦。
参考:github.com/noahred16/DeepTeeth(社区解压记录,目录树实证);HF DENTEX 数据卡提交历史(CT-CLIP 文案修正记录)。
⚠️ 坑点 4:Hugging Face
datasets.load_dataset直接失败——split 格式不一致(分类:工程陷阱)问题:HF 数据集的三个 split 使用不同文件组织(train/test 为 imagefolder、validation 附 JSON 标注),自动 viewer 报
FileFormatMismatchBetweenSplitsError,load_dataset("ibrahimhamamci/DENTEX")无法工作。
症状:load_dataset报 “Couldn’t infer the same data file format for all splits”;或 viewer 页面加载失败提示。
解决:
- 简单方法:放弃
load_dataset,直接git clone https://huggingface.co/datasets/ibrahimhamamci/DENTEX或从 Zenodo 下载 zip 解压。- 进阶方法:按子集分别构造本地
imagefolder数据集(load_dataset("imagefolder", data_dir=...)逐子集加载),JSON 标注用自定义 collate 注入。- SOTA 方法:一次性转换为 COCO 格式 + 自定义 Dataset 类(§6.4),彻底绕开 HF 自动化加载。
参考:huggingface.co/datasets/ibrahimhamamci/DENTEX(viewer 错误信息原文)。
⚠️ 坑点 5:全牙框与异常牙框语义不同——两个"检测任务"不能无脑合并(分类:标签理解)
问题:quadrant-enumeration 子集框的是所有牙齿(做牙位枚举),quadrant-enumeration-disease 子集框的只有异常牙齿(正常牙无框)。若把两个子集的框直接堆进同一训练集,模型会学到"QED 子集里没框的区域是无牙",而枚举语义里那里是正常牙;反之用 QED 子集做牙位枚举会漏掉全部正常牙。
症状:合并训练后枚举准确率与异常检出率同时下降;推理时正常牙区域出现大量假阳或异常牙漏检。
解决:
- 简单方法:给框加"任务域"标记(all-tooth vs abnormal-only),两条检测分支分别回归,推理时按任务取分支输出。
- 进阶方法:单模型双头(全牙头 + 异常头)共享骨干,损失按子集路由;或先枚举全牙、再对每颗牙裁剪做异常分类(Choi 队 DETDet 的分类增强思路)。
- SOTA 方法:级联架构——枚举/分割先定位全部牙位,异常检测头只在牙位区域输出 QED 三元组(He 队分割引导方案 + Mei 队独立疾病二分类头的混合思路)。
参考:arXiv:2305.19112 v2(三个子集的语义定义与冠军方案剖析)。
⚠️ 坑点 6:四类诊断严重不平衡,caries 一类独大拖垮深龋/根尖周病变(分类:偏倚陷阱)
问题:官方未发布逐类计数,但论文明确讨论了类别不平衡:龋齿类在全景片中远多于其他三类,深龋与根尖周病变的鉴别又依赖细微密度差异。直接训练的模型对稀有类召回极低,而临床上漏诊根尖周病变的代价恰恰最高。
症状:整体诊断 AP 尚可,但逐类 AP 中深龋/根尖周病变接近失败;混淆矩阵显示深龋大量被判为普通龋齿。
解决:
- 简单方法:按逐类计数设置类别权重(focal loss α 或重加权 CE)+ 稀有类过采样(先跑 §6.1 统计脚本拿到真实先验)。
- 进阶方法:复制-粘贴增强:从稀有类图中裁出牙齿区域贴到其他影像(保持灰度协调);两阶段方案——EfficientNetB4 类分类器对牙位裁剪图生成伪标签以增强稀有类(Choi 队做法)。
- SOTA 方法:分类头与检测头解耦(Mei 队 YOLOrtho 为疾病设独立二分类头 + 匈牙利匹配后处理),并对稀有类做专门的数据合成与集成。
参考:arXiv:2305.19112 v2(Choi/Mei 队方法分析);Ultralytics 重托管页(3,529 框的训练子集统计口径)。
⚠️ 坑点 7:CC BY-NC-SA 4.0 的"NC"与"SA"双限制——许可表述还曾前后不一(分类:工程陷阱)
问题:数据许可为 CC BY-NC-SA 4.0:禁止商用(NC),衍生数据集必须同源共享(SA)。项目早期 GitHub README 曾写作 “CC BY-SA 4.0”(少了 NC),部分镜像站至今缓存旧文本——照旧文引用会造成合规误判。此外 Hugging Face 数据卡 YAML 标注
cc-by-nc-sa-4.0,与论文中表述(CC-BY 口径)也存在过措辞差异。
症状:商业产品原型用了 DENTEX 训练后面临许可冲突;论文/产品页引用了错误的许可名称。
解决:
- 简单方法:以当前 Hugging Face 数据卡与 GitHub README 的最新表述为准(CC BY-NC-SA 4.0),在项目合规清单中记录"数据禁商用"。
- 进阶方法:商业场景只用 DENTEX 做方法验证,产品模型用自有或可商用数据重训;或与版权方单独协商商用授权。
- SOTA 方法:合规自动化——在 CI 中锁定许可标识(SPDX:CC-BY-NC-SA-4.0),数据血缘文档记录下载日期、来源 URL 与 md5(§6.0 的校验值)。
参考:huggingface.co/datasets/ibrahimhamamci/DENTEX(License 节);github.com/ibrahimethemhamamci/DENTEX(License 节,现行文本)。
⚠️ 坑点 8:患者级分组未披露 + 外部数据声明缺失,评测结论可能被高估(分类:数据泄漏)
问题:官方未发布患者 ID,同一患者的多张影像可能跨 train/test 分布;同时官方允许使用外部公开数据(冠军用 COCO、有队伍用 Tufts Dental Database 等)但依赖自觉声明。若在赛后已公开的测试 GT 上反复调参、或外部数据与 DENTEX 存在同源影像,报告的泛化性能会被系统性高估。
症状:测试集成绩漂亮但换一批自己机构的影像召回骤降;不同论文间成绩差异无法用方法解释。
解决:
- 简单方法:论文报告时明确"图像级划分、患者级分组未披露"的限制;测试 GT 只用于最终一次评估。
- 进阶方法:训练集内部按影像相似度(指纹哈希/嵌入聚类)做去重与分组近似,估计患者重叠上界;外部数据逐条写入方法章节的数据表。
- SOTA 方法:构建自有机构小规模盲测集(≥50 张、不参与任何调参)做独立外部验证,报告与 DENTEX 测试集的差值作为泛化证据。
参考:arXiv:2305.19112 v2(外部数据使用与声明要求);dentex.grand-challenge.org/data(外部数据政策)。
8 个坑点的共性与阅读顺序:坑点 1/5/6 属于"标签语义"族(部分标注、框语义、类别不平衡),决定了训练信号的正确性;坑点 3/4 属于"工程格式"族(目录与键名、HF 加载),决定了管线能否跑通;坑点 2/7/8 属于"评测与合规"族(排名口径、许可、泄漏),决定了你的结论能否对外发布。首次上手建议按 3 → 4 → 1 → 5 的顺序处理(先跑通、再训对),最后用 2/7/8 检查产出。
§6.6 数据增强
| 策略 | 是否安全 | 说明 |
|---|---|---|
| 小角度旋转(≤10°)、平移、缩放 | ✅ | 模拟投照体位差异;框同步变换 |
| 亮度/对比度抖动、CLAHE | ✅ | 模拟曝光差异;注意三机构灰度分布本就不同 |
| 高斯噪声/模糊(轻量) | ✅ | 模拟采集噪声 |
| CutOut/随机擦除(避开框区) | ✅ | 提升遮挡鲁棒性 |
| 水平翻转 | ❌ | 破坏 FDI 语义:Q1↔Q2、Q3↔Q4、牙位编号镜像(48↔38 等),标签必须联动重写,否则编号标注全错 |
| 垂直翻转 | ❌ | 破坏上/下颌象限语义(Q1/Q2 ↔ Q4/Q3)且解剖上不合理 |
| 大角度旋转(>15°) | ❌ | 全景片解剖结构方向性强,大角度旋转产生不真实形态 |
| 生成式合成病灶(未验证) | ⚠️ | 需专家审核合成样本的解剖与病理合理性后限量使用 |
增强策略的选择顺序建议:默认只开 ✅ 行;引入 ❌ 行(翻转类)前必须实现 Q/编号联动映射并写单元测试(用一张含已知牙位的样本验证翻转后标签正确性);⚠️ 行仅在论文有专门审校流程时使用。Ultralytics 默认增强参数里的水平翻转(fliplr=0.5)是 YOLO 用户最常踩的隐形坑——用第三方 YOLO 版训练时第一件事就是把它关掉或改写为语义安全版本。
§6.7 模型推荐
| 模型 | 适配任务 | 官方/社区成绩 | 推荐场景 |
|---|---|---|---|
| YOLOv8(深度改造) | 三任务联合 | 亚军方案(Mei 等):Q-AP 46.59 / E-AP 33.47 / D-AP 37.44 | 追求训练推理效率的工程落地 |
| DINO + 分割引导级联 | 三任务联合 | 冠军方案(He 等):Q-AP 47.45 / E-AP 35.35 / D-AP 37.06 | 冲榜/方法研究 |
| HierarchicalDet(Swin-T+扩散头) | 层级多标签检测 | baseline:Q-AP 43.2 / E-AP 30.5 / D-AP 37.6(诊断全场第一) | 部分标注学习研究首选(代码开源) |
| Faster R-CNN / RetinaNet / DETR / DiffusionDet | 单任务对照 | 论文 v2 有系统对比,均低于上述方案 | 快速 baseline 消融 |
| SimMIM 预训练 + 上述任一检测器 | 自监督预训练 | 官方 baseline 的预训练配方(1,571 张无标注图) | 无标注数据利用 |
选型的两条经验线:追榜单优先复用四强已验证的架构族(DINO 变体 / 改造 YOLO / 扩散头),它们的 12 项指标已与官方口径对齐,增量改进可直接量化;追临床鲁棒则更应关注 baseline 的部分标注方案与 §6.6 的增强纪律——榜单差 1 个点的两个模型,在换机构数据上的排序可能反转。两条线都应从 §6.1 的探查脚本起步,而不是从模型仓库起步。
§6.8 硬件需求
| 场景 | GPU 显存 | 说明 |
|---|---|---|
| 官方 baseline 复现 | 48 GB(NVIDIA RTX A6000) | 论文配置:单卡、batch size 16、AdamW lr 2.5e-5、40,000 迭代 |
| YOLOv8 类单阶段检测 | 16-24 GB | 输入 1024 长边、batch 8-16 |
| 仅枚举/象限子任务 | 8-12 GB | 输入可降至 768 |
| 数据准备/评测 | CPU 即可 | 评测脚本为 CPU 友好(pycocotools) |
若显存受限,两条降级路径:一是输入长边从 1024 降到 768/640(象限层级任务对分辨率最不敏感,诊断层级最敏感,降级后应报告逐层级差值);二是用 Ultralytics 版(483.8 MB)先跑通管线再换官方数据。训练迭代预算参考 baseline 配置(40,000 迭代、batch 16)按卡数折算。
§6.9 评估指标代码
# 用 pycocotools 复现官方口径的单层级 AP/AP50/AP75/AR(对三个层级各跑一次)
from pycocotools.coco import COCO
from pycocotools.cocoeval import COCOeval

def eval_level(gt_json: str, dt_json: str) -> dict:
    """gt_json/dt_json:COCO 格式;层级类别由 GT 转换脚本预先映射(见坑点 1/2)"""
    coco_gt = COCO(gt_json)
    coco_dt = coco_gt.loadRes(dt_json)
    E = COCOeval(coco_gt, coco_dt, iouType="bbox")
    E.evaluate(); E.accumulate(); E.summarize()
    return {"AP": E.stats[0], "AP50": E.stats[1], "AP75": E.stats[2], "AR@100": E.stats[8]}

# 官方排名:上述结果 × 3 层级 = 12 项,按 12 项平均名次聚合(并做 Wilcoxon 检验,p<0.001)
对齐官方口径时最容易错的一步是层级类别映射而不是指标计算本身:quadrant 层只需把框标签映射为 1-4;enumeration 层的类别数最多(Q×N 组合,去缺牙位);diagnosis 层官方采用"异常框 + 四类"的口径。建议把三套映射写成三个独立的 GT 转换脚本并各自产出一份 COCO JSON 入库,评测脚本只消费转换产物——这样任何一次映射错误都能在转换层被发现,而不是污染下游所有 AP 数字。
§6.10 MLOps 笔记
- Docker 化推理:挑战赛 Phase 2 要求以 Docker 容器提交推理算法在隐藏测试集上运行;赛后自建服务建议沿用同一容器规范,保证"论文成绩 = 线上行为"。
- 数据版本控制:记录 Zenodo record 号、md5(§6.0 校验值)与下载日期;官方格式存在演变(坑点 3),转换后的 COCO/YOLO 内部格式应入库做版本快照。
- 随机性控制:baseline 未用交叉验证与集成(论文口径),复现时固定 seed 并报告单次结果;改进方法引入 k 折时与 §5.4 的分层方案保持一致。
- 评测纪律:测试 GT 已公开后仍应保持"只在最终评估调用"的纪律,用训练集内 k 折或验证 50 张做日常迭代(坑点 8)。
- 许可合规流水线:SPDX 标识 + 血缘记录(坑点 7),衍生数据集沿用 CC BY-NC-SA 4.0 发布。
- 监控基线入库:把 §6.1 的逐类统计与 §6.3 的灰度参数作为"训练分布基线"存入元数据仓库,§7.6 的漂移监控直接消费这两份基线,避免监控阈值凭空设定。
§7 质量评估与局限性
§7.1 已知偏倚
下表按"是否影响论文结论的可信度"排列优先级——前三项(地域、类别不平衡、部分标注设计)在任何使用场景下都应写进你论文的 limitations 段落:
| 偏倚类型 | 描述 | 严重程度 | 缓解 |
|---|---|---|---|
| 地域偏倚 | 全部影像来自土耳其三所机构,单国来源 | 高 | 外部验证(§5.5);跨地域部署前重校准 |
| 类别不平衡 | 龋齿类占主导,深龋/根尖周病变样本少(官方未公布逐类计数) | 高 | 类别加权、重采样、伪标签增强(坑点 6) |
| 年龄范围偏倚 | 仅纳入 ≥12 岁患者,儿童牙科场景覆盖弱 | 中 | 明确模型适用年龄边界 |
| 设备/协议异质性 | 三机构设备与协议各异(官网口径),影像质量分布不均 | 中 | 按机构分层评测;域自适应预处理 |
| 阅片模态局限 | 全景片对早期邻面龋等细微病变敏感度低于咬翼片 | 中 | 在文档中声明模型为全景片模态专用 |
| 标注者变异 | 学生初标 + 专家校正,但无一致性系数公布 | 中 | 对边界模糊病例(早期根尖周病变)保留人工复核 |
| 部分标注设计偏倚 | 三子集标签粒度不同是刻意设计,直接统计"类别频率"会因子集而异 | 中 | 逐类统计只在全标注子集(1,005 张)上做 |
| 测试集赛后公开偏倚 | 250 张测试 GT 已公开,社区后续工作存在"软过拟合"可能 | 中 | 对照 2023 榜单原始成绩解读赛后报告的数字 |
| 病变谱系截断 | 仅四类可干预病变;修复体、牙周炎骨吸收等常见发现不在标注范围 | 中 | 输出"未覆盖"声明,避免用户误判为"无其他异常" |
§7.2 标注质量
标注采用"应届牙科学生初标 → 15 年以上经验专家牙医逐图审核校正"的两步协议,官方称其为"最高质量与准确性"(官网表述)。需要客观指出的两点:其一,标注一致性指标(框 IoU、类间 κ)未公布,无法量化观察者间变异;其二,官网"三位专家之一"与论文 v2"两位专家"的表述差异虽不影响协议实质,但提示文档间存在细节漂移(坑点 3 同源问题)。对深龋 vs 龋齿、早期根尖周病变等临界判读,建议使用者做小规模人工抽检(≥50 张)建立自己的质量基线。
抽检操作建议:优先抽取含深龋与根尖周病变的图(判读最依赖细微密度差异),由一名牙科专业人员独立重标后与官方 GT 计算:(1) 框级 IoU 分布(中位数与 P10),(2) 类别混淆矩阵,(3) 牙位编号一致率。三项指标同时低于预期时,说明你的下游评测上限受标注而非模型约束,应在论文中如实报告这一发现。
§7.3 泛化性
| 目标场景 | 失效风险 | 证据 |
|---|---|---|
| 其他国家/人群的全景片 | 高:训练分布限于土耳其三机构 | 论文 v2 强调多机构异质性为挑战赛设计要点;无跨洲验证数据 |
| 咬翼片/根尖片等口内片 | 高:模态与视野完全不同 | 任务定义即全景片(panoramic-only) |
| 混合修复体(冠桥、种植体)人群 | 中:全标注子集诊断仅限四类可干预病变 | 诊断类别定义(官网数据页) |
| 儿童混合牙列(<12 岁) | 高:纳入标准为 ≥12 岁 | 官网数据页 |
| 其他设备厂商影像 | 中:设备信息未逐例披露,厂商泛化性未知 | 论文提及 VistaPano S;官网称设备各异 |
泛化表的使用方式:把"高风险"行逐条转化为部署前的验收项(如"目标人群年龄下限是否 ≥12 岁"、“模态是否为全景片”),把"中风险"行转化为监控项(§7.6)。全部三个高风险行都指向同一个结论:DENTEX 上训练的模型在离开"土耳其三机构 ≥12 岁全景片"这个分布之前,任何临床性能声明都需要本地数据支撑。
§7.4 伦理
数据收集获完整伦理委员会批准(论文 v2 口径),影像从医院数据库随机抽取并脱敏后发布,不含患者标识、DICOM 头或人口学元数据。患者知情同意的具体豁免机制官方未详述(回顾性去标识化研究设计)。使用者在二次分发衍生标注时须遵守 CC BY-NC-SA 4.0 同源共享条款。
伦理边界的使用提醒:发布包不含同意书文本与伦理批号,论文写作中引用数据时只能声明"数据集官方声明已获伦理批准并完成去标识化";若目标期刊要求提供原始批件,需要向组织方单独索取——这一点应在实验启动前确认,避免投稿阶段卡壳。
§7.5 公平性
官方未发布患者性别、年龄细分与种族信息,无法进行子群体性能审计。考虑到训练数据全部来自单一国家的三所机构,模型对其他人群的性能差异不可假设为零;部署前应在本地人群上做按年龄/性别分层的性能审计。四类诊断不存在与社会经济身份直接挂钩的标签偏倚,但不同人群的就诊与拍摄习惯差异会间接影响检出分布。
两个可操作的公平性检查点:一是年龄边界——数据仅纳入 ≥12 岁患者,青少年混合牙列(恒牙陆续萌出、牙位空间不满 32 颗)与成人影像在枚举任务上的难度不同,按年龄段拆分评测是低成本的第一层审计;二是牙位覆盖——若本地人群第三磨牙拔除率高(部分国家常规预防性拔除),阻生齿类的先验会显著低于训练分布,应把"逐牙位检出率"而非"总体 AP"作为公平性监控的首选指标。
§7.6 数据漂移
影像采集设备与协议在三机构间本就不同(官网口径),若把模型部署到新机构,输入分布漂移是默认假设而非例外。建议上线后持续监控:图像级灰度分布统计(与训练集 §6.3 参数对比)、每图平均检出框数的漂移、逐类预测占比漂移(龋齿占比骤升常提示域偏移或阈值失配)。挑战赛本身的两阶段机制(验证集 → 隐藏测试集)提供了一个可复用的"漂移检验"范式。
监控实现上,前述三项指标都可以在推理服务旁路以分钟级成本计算:灰度均值/方差直方图与训练集统计做 KS 检验;框密度与逐类占比用滑动窗口对比训练集先验(§6.1 统计脚本产出)。设定告警阈值时注意 DENTEX 特有的混淆源——三机构协议差异本身就会在训练分布内部产生可观测的漂移幅度,阈值应按"新机构 vs 三机构混合"的差值校准,而不是照搬通用监控模板。
§7.7 DAIMS 数据质量评估
| # | 检查项 | 状态 | 说明 |
|---|---|---|---|
| 1 | 宽格式 | ✅ | 一图一标注文件,扁平目录,无嵌套表格 |
| 2 | 唯一标识 | ✅ | 图像文件名全局唯一,split 前缀清晰 |
| 3 | 特殊字符 | ✅ | 文件名仅含字母、数字、下划线与连字符 |
| 4 | 重复行 | ✅ | 图像级未见重复报告;患者级重复无法排除(见 #16) |
| 5 | 缺失编码 | ⚠️ | 部分标注语义:子集内"未标注层级"≠“阴性”,需掩码区分(坑点 1) |
| 6 | 标签标识 | ✅ | Q/N/D 三元组语义明确,FDI 编码体系全球标准 |
| 7 | 罕见类分组 | ⚠️ | 四类诊断不平衡,深龋/根尖周病变样本少且官方未公布逐类计数 |
| 8 | 偏倚评估 | ⚠️ | 论文定性讨论不平衡与异质性,无量化偏倚分析 |
| 9 | 数据字典 | ⚠️ | 官网/README 为描述性文档,无机器可读 schema;JSON 键名跨渠道有差异 |
| 10 | 信息性缺失解释 | ⚠️ | 层级化部分标注的设计动机官方有说明,但逐图标签粒度需自行推断 |
| 11 | 设备记录 | ⚠️ | 论文提及 VistaPano S,逐例设备元数据未随数据发布 |
| 12 | 共线性 | ✅ | 不适用(影像检测数据,无表格特征共线性) |
| 13 | 编码映射 | ✅ | FDI/四类诊断 ↔ ICD-11/SNOMED CT 映射见 §2.1/§2.1b |
| 14 | 时间戳处理 | ✅ | 不适用(无时间序列字段;采集日期未披露属已知限制) |
| 15 | 划分建议 | ✅ | 官方 705/50/250 划分清晰,测试集赛期盲测 |
| 16 | 泄漏讨论 | ⚠️ | 患者级分组官方未说明;外部数据依赖自觉声明(坑点 8) |
| 17 | 标签分布 | ⚠️ | 层级分布明确;诊断逐类计数官方未发布(§4.2) |
| 18 | 测量偏倚 | ⚠️ | 双层标注协议有描述,但无一致性系数(IoU/κ)公布 |
| 19 | 外部验证建议 | ⚠️ | 官方允许外部数据并要求声明,但未提供系统性外部验证矩阵 |
| 20 | 版本记录 | ✅ | Zenodo v1 → 赛后 GT 公开 → arXiv v2 版本链有案可查 |
| 21 | 预处理脚本 | ✅ | 官方评测代码 + HierarchicalDet 训练代码开源(MIT) |
| 22 | 合规要求 | ✅ | CC BY-NC-SA 4.0 明确、开放直下、无需注册 |
| 23 | 多模态对齐 | ✅ | 不适用(单模态全景片) |
| 24 | 去标识化 | ✅ | 脱敏发布,无 DICOM 头/患者标识/人口学信息 |
DAIMS 评分:14.0 / 24(✅×14,⚠️×10,❌×0)
评分解读:14/24 属于"语义骨架优秀、工程生态待补"档位。数据本身的硬伤项为零——FDI 编号体系、双层专家标注、官方划分与开放许可都达到挑战赛级水准;10 个 ⚠️ 集中在"部分标注语义、逐类计数缺失、格式文档漂移、患者级元数据缺位"四个领域,其中大部分是使用策略问题而非数据缺陷,且均有官方论文或社区方案可循(坑点 1、3、4、6)。
对这 10 个 ⚠️ 再做一次归因拆分有助于行动决策:数据固有(#7 罕见类、#11 设备记录、#16 患者分组、#18 一致性系数)——只能靠声明与外部数据缓解;文档工程(#9 数据字典、#10 缺失解释、#17 标签分布)——官方具备改进条件,使用者可自行补齐(本页 §4 即是补齐产物);使用策略(#5、#8、#19)——本页坑点与 §5/§6 的方案可直接落地。
对你意味着什么:
- 可以直接把它当牙科检测的主力公开基准,工程精力应花在层级标注的损失掩码与类别不平衡策略上,而不是数据清洗。
- 若课题需要逐例设备/人口学元数据或标注一致性量化,DENTEX 无法满足,需自有机构数据补充。
- 做方法对比时必须按官方 12 项指标秩聚合口径报告(坑点 2),否则与榜单不可比;日常调参用训练集内 k 折,测试 GT 一次用完。
- 部署到土耳其以外机构前,把 §7.3 的泛化风险表转为本地盲测计划;商业用途注意 CC BY-NC-SA 的禁商用与同源共享条款(坑点 7)。
§7.8 外部验证矩阵
| 外部数据集/场景 | 来源机构 | 评估任务 | 性能指标 | 相对内部变化 | 关键发现 |
|---|---|---|---|---|---|
| 隐藏测试集(官方统一评测) | 土耳其三机构(未见于训练分布的 250 张) | Q/N/D 三层级检测 | 冠军 Q-AP 47.45 / E-AP 35.35 / D-AP 37.06;baseline D-AP 37.6 | 诊断层级普遍低于象限层级约 10 个百分点 | 牙位枚举与病变分类是难度天花板 |
| Tufts Dental Database(外部资源) | Tufts University(美国) | 图像级牙科诊断标签 | —(作为参赛队外部增强/预训练数据使用,van Nistelrooij 队,论文记载) | — | 官方允许外部数据但要求书面声明 |
| 系统性跨机构外部验证 | — | — | 截至 2026-09 官方未发布 | — | 部署前需自行构建本地盲测集(§7.7 建议 4) |
§8 基准性能与生态
§8.1 排行榜
DENTEX 2023 最终排行榜(隐藏测试集 250 张、Docker 统一评测、12 项指标平均名次;以下成绩均出自挑战赛总结论文 v2):
| 排名 | 队伍/模型 | 性能(Q-AP / E-AP / D-AP,%) | 平均名次 | 年份 | 关键技术 | 完整引用 | 代码 |
|---|---|---|---|---|---|---|---|
| 1 | He 等(Sjtu-seiee-426) | 47.45 / 35.35 / 37.06 | 2.33 | 2023 | 分割引导三阶段:DINO+ResNet50 + U-Net/SE U-Net 分割 + DINO(Swin)/YOLOv8 集成,WBF 融合 | He et al., 2023, DENTEX Challenge Participant Short Papers. DOI 10.5281/zenodo.17387129;总结:Hamamci et al., 2023, arXiv:2305.19112. DOI 10.48550/arXiv.2305.19112 | — |
| 2 | Mei 等(Chohotech,YOLOrtho) | 46.59 / 33.47 / 37.44 | 2.58 | 2023 | YOLOv8 深度改造:坐标卷积 + 独立疾病二分类头 + 匈牙利匹配后处理 | Mei et al., 2023, DENTEX Challenge Participant Short Papers. DOI 10.5281/zenodo.17387129 | — |
| 3 | Hamamci 等(官方 baseline,HierarchicalDet) | 43.2 / 30.5 / 37.6 | 2.92 | 2023 | Swin-T+FPN + 扩散式检测头 + 三分类头,SimMIM 预训练;诊断 AP 全场第一 | Hamamci et al., 2023, MICCAI 2023 (Springer LNCS), pp. 389-399. DOI 10.1007/978-3-031-43987-2_38 | 官方 GitHub |
| 4 | Choi 等(DETDet) | 43.29 / 30.77 / 36.48 | 3.08 | 2023 | Mask R-CNN(SwinT) 编号 + DiffusionDet/DINO 集成诊断 + EfficientNetB4 伪标签增强 | Choi et al., 2023, DENTEX Challenge Participant Short Papers. DOI 10.5281/zenodo.17387129 | — |
数值不可直接比较的原因:(1) 最终名次是 12 项指标的秩聚合,非单一 mAP 的线性排序(诊断 AP 最高的 baseline 总排名第 3);(2) 冠军与亚军队伍使用了外部数据(COCO 等),按官方规则书面声明后合规,但与纯 DENTEX 训练的方法不可直接对标;(3) baseline 未使用交叉验证与集成,与采用集成的队伍存在评测设定差异。
读懂这张榜的三个口径:
- Q-AP/E-AP/D-AP 各自是"该层级"的 AP(IoU 0.50:0.95:0.05 十阈值平均),即 12 项指标中的 3 个主项;完整排名还依赖各队未在表中逐列展示的 AP50/AP75/AR 九项。
- 牙位层级(E)整体最低(约 30.5-35.35%):枚举要求 4 象限 × 8 牙位的精细判别,错一颗邻近牙即该框该层级判负——这是三个层级中与"临床可用"最相关也最难的一项。
- D-AP 的队间差距最小(36.48-37.6%,约 1.1 个百分点):四类诊断中 caries 主导,头部方案都能在主类上拿分,差距主要由稀有类决定——这也是为什么基线方法(类别加权、伪标签、专用分类头)在赛后复现中最能提升逐类 AP(见坑点 6)。
§8.2 SOTA 总结与选型建议
挑战赛总结论文 v2 的核心结论:顶级方案的成功来自"多样化、专门化策略"——从分割引导的多阶段管线到高度工程化的单阶段检测器,并普遍采用 Transformer 与扩散模型;它们在牙位枚举与细微病变分类两个难任务上显著超越传统方法。选型建议:复现研究选官方 baseline(代码全开源、诊断 AP 最高、部分标注方案最完整);工程落地参考亚军 YOLOrtho(单阶段、推理高效);冲击新 SOTA 建议在冠军的分割引导级联上做增量改进。象限 AP(约 43-47%)与牙位 AP(约 31-35%)之间的持续差距提示:枚举语义(Q×N 组合 + 类别不平衡)仍是开放问题。
补充一个"SOTA 是否饱和"的判断:四强 D-AP 全部落在 36.48-37.6% 的窄带内,且差距小于秩聚合排名的名次间隔,说明 2023 年的头部方案在诊断层级已高度接近当时的可行上限;真正的增量空间在枚举层级(队间差约 5 个百分点)与稀有类逐类 AP——选择研究切入点时,这比整体 mAP 更有信息量。
§8.3 评测协议
两阶段赛制:Phase 1 在 50 张验证集上提交预测文件进初步排行榜;Phase 2 以 Docker 容器提交推理算法,由主办方在 250 张隐藏测试集上统一运行。指标为 4 项(AP、AP50、AP75、AR)× 3 层级(quadrant/enumeration/diagnosis)= 12 项;TP 判定要求预测框与真值框 IoU 超阈值,AP 为 PR 曲线下面积(IoU 0.50:0.95:0.05 十阈值平均);最终名次按 12 项平均名次确定,并以 Wilcoxon 符号秩检验(p<0.001)做成对显著性补充排名。外部公开数据允许使用但必须书面声明数据集与来源。
复现该协议的技术要点:(1) 三个层级的评测分别需要把预测/真值标签映射为对应层级的类别(quadrant 层 4 类、enumeration 层按 Q×N 组合、diagnosis 层按 Q×N×D 或"框 + D 类别"两阶段),映射方式官方评测代码为唯一权威实现;(2) AP 的 IoU 十阈值与 COCO 标准一致,直接用 pycocotools(§6.9)即可对齐,但类别映射必须自行完成;(3) Wilcoxon 检验是对队伍两两做对名的补充统计,方法论文中无需自行复算,引用官方结果即可。
§8.4 相关数据集
| 数据集 | 模态 | 任务 | 关系 |
|---|---|---|---|
| VinDr-CXR | 胸部 X 光 | 病变检测 | 同为"医学 X 光检测挑战基准",方法学可互迁 |
| TBX11K | 胸部 X 光 | 结核病灶检测 | X 光检测任务族;小病灶长尾问题相似 |
| JSRT | 胸部 X 光 | 肺结节分割 | 小规模经典 X 光库,结构对照 |
| RibFrac | 肋骨 CT | 骨折检测分型 | 3D 检测对照;分型+定位双任务结构相似 |
| RSNA Bone Age | 手部 X 光 | 回归(骨龄) | X 光模态、竞赛出身,任务类型不同 |
| FLARE | 腹部 CT | 分割挑战赛 | 同为 MICCAI 挑战赛范式(部分标注 + 隐藏测试 + Docker) |
跨数据集迁移的现实提示:这些基准之间能迁移的是方法组件(损失掩码、长尾采样、秩聚合评测)而不是模型权重——模态与标签体系差异使直接微调收益有限。若研究目标是"医学检测通用方法",建议以 DENTEX 为主实验场、从上表选 1-2 个模态对照,而不是横向堆全部六个基准。
§8.5 关键论文 Top 5
- Hamamci et al., 2023. “DENTEX: An Abnormal Tooth Detection with Dental Enumeration and Diagnosis Benchmark for Panoramic X-rays.” arXiv:2305.19112(v1 2023-05-30;v2 2025-11-13 扩展改题为 “DENTEX: Dental Enumeration and Tooth Pathosis Detection Benchmark for Panoramic X-ray”). DOI 10.48550/arXiv.2305.19112 — 挑战赛总结与基准论文:数据集、评测协议与全部参赛方法分析的唯一权威来源。
- Hamamci et al., 2023. “Diffusion-Based Hierarchical Multi-Label Object Detection to Analyze Panoramic Dental X-rays.” MICCAI 2023, Springer LNCS, pp. 389-399. DOI 10.1007/978-3-031-43987-2_38 — 官方 baseline HierarchicalDet:部分标注层级利用的扩散式检测方案。
- DENTEX Challenge 2023 Proceedings: Participant Short Papers. Zenodo, 2025-10-18. DOI 10.5281/zenodo.17387129 — 全部参赛队伍方法短文集(冠军/亚军方法细节的第一手来源)。
- Hamamci et al., 2023. “Diffusion-Based Hierarchical Multi-Label Object Detection to Analyze Panoramic Dental X-rays.” arXiv:2303.06500 — baseline 预印本,含训练细节(SimMIM 预训练、40,000 迭代、单卡 A6000)。
- Zancan et al., 2025. “AI-powered precision in dental radiographic analysis using tailored CNNs for tooth numbering and cavity detection.” PLOS Digital Health 4(11): e0001074. DOI 10.1371/journal.pdig.0001074 — 使用 DENTEX 作为对照资源的后续研究示例(牙位编号 + 龋齿检测)。
五篇文献的分工:读 1 了解数据与协议,读 2 复现 baseline,读 3 拿四强方法细节,读 4 补训练配置(预训练与超参),读 5 观察赛后应用范式。方法学写作中至少应引用 1 与 2。
§8.6 社区活跃度
挑战赛已收官(官网明确声明 concluded),但生态持续活跃:官方 GitHub 仓库(评测代码 + baseline 指引)与 Hugging Face 数据集(27+ likes,截至 2026-09)为两大枢纽;2025 年仍有两笔官方更新(参赛短论文集 Zenodo 发布、arXiv v2 扩展版),说明组织团队在赛后持续维护。Ultralytics 平台出现了第三方 YOLO 重托管版,社区衍生(DeepTeeth 等)主要围绕格式转换与教学用途。挑战赛论文引用 51+(Google Scholar,截至 2026-09),牙科影像 AI 领域的新方法论文普遍将其列为对照基准。
从时间线看生态温度的两个信号:一是 arXiv v2(2025-11-13)不是简单改题,而是把两年间积累的方法学分析(参赛队技术归纳、层级难度分析)合并进了基准论文,这种"赛后两年仍在扩展总结"的做法在 MICCAI 挑战赛中并不常见;二是参赛短论文集以独立 Zenodo DOI(10.5281/zenodo.17387129)正式归档,使四强方法细节获得可引用的长期锚点——引用冠军/亚军方案时应引该 DOI 而非二手博客。社区侧的持续产出(PLOS Digital Health 2025 后续研究、Ultralytics 托管版)集中于教学复现与轻量应用,方法学研究仍以官方榜单数字为对话基础。
§8.7 生态快照
| 资源 | 类型 | 链接 | 状态(截至 2026-09) | 推荐理由 |
|---|---|---|---|---|
| DENTEX 官网 | 挑战赛主页 | https://dentex.grand-challenge.org/ | 已收官,文档完整 | 数据政策、标注协议、发表政策的一手来源 |
| Zenodo record 7812323 | 官方数据 | https://zenodo.org/records/7812323 | 开放下载(v1,2023-04-09) | 带 md5 校验的官方原始包 |
| Hugging Face 数据集 | 官方镜像 | https://huggingface.co/datasets/ibrahimhamamci/DENTEX | 活跃维护(viewer 不可用) | 下载方便;数据卡持续更新 |
| GitHub 官方仓库 | 评测代码 | https://github.com/ibrahimethemhamamci/DENTEX | MIT 许可 | 12 项指标评测的唯一官方实现 |
| HierarchicalDet 仓库 | baseline 代码 | https://github.com/ibrahimethemhamamci/HierarchicalDet | 开源 | 部分标注方案的完整训练实现 |
| 参赛短论文集 | 论文集 | https://zenodo.org/records/17387129 | 2025-10-18 发布 | 冠军/亚军方法细节 |
| arXiv v2 扩展版 | 基准论文 | https://arxiv.org/abs/2305.19112 | 2025-11-13 更新 | 评测协议、榜单与方法学分析的权威文本 |
| Grand Challenge 平台 | 评测平台 | https://dentex.grand-challenge.org/ | 挑战页已归档 | 两阶段 Docker 评测机制的原始记录 |
生态快照的维护状态判断:官方侧四类资源(官网、Zenodo、GitHub、HF)全部存活且内容自洽,数据可得性风险低;唯一的"半失效"是 HF viewer(数据可用、自动加载不可用)。第三方侧(Ultralytics、DeepTeeth)属于便利层而非依赖层,生产链路不应绑定任何第三方转换版。
| Ultralytics 重托管 | 第三方格式转换 | https://platform.ultralytics.com/fatih/datasets/dentex | 可用(483.8 MB) | YOLO 快速起步(非官方,对标需谨慎) |
§9 相关资源与引用
§9.1 官方资源
- 挑战赛主页(含 Data、Annotation Protocol、Publication Policy 子页):https://dentex.grand-challenge.org/
- 官方数据发布(Zenodo,含 md5):https://zenodo.org/records/7812323
- 官方评测代码(GitHub,MIT):https://github.com/ibrahimethemhamamci/DENTEX
- 挑战赛总结论文:arXiv:2305.19112
- baseline 论文(MICCAI 2023 Springer):DOI 10.1007/978-3-031-43987-2_38
以上五个官方链接是本页全部事实性数字的最终仲裁来源;本页内容若与上述任一来源冲突,以官方为准并欢迎纠错。
§9.2 社区与第三方资源
- Hugging Face 官方数据卡:https://huggingface.co/datasets/ibrahimhamamci/DENTEX
- HierarchicalDet baseline 代码:https://github.com/ibrahimethemhamamci/HierarchicalDet
- Ultralytics 平台重托管(YOLO 格式):https://platform.ultralytics.com/fatih/datasets/dentex
- 社区解压记录与目录树实证(DeepTeeth 仓库):https://github.com/noahred16/DeepTeeth
- 参赛短论文集(Zenodo,2025-10-18):https://zenodo.org/records/17387129
§9.3 BibTeX 引用
@article{hamamci2023dentex,
  title   = {DENTEX: An Abnormal Tooth Detection with Dental Enumeration and
             Diagnosis Benchmark for Panoramic X-rays},
  author  = {Hamamci, Ibrahim Ethem and Er, Sezgin and Simsar, Enis and
             Yuksel, Atif Emre and Gultekin, Sadullah and Ozdemir, Serife Damla and
             Yang, Kaiyuan and Li, Hongwei Bran and Pati, Sarthak and
             Stadlinger, Bernd and others},
  journal = {arXiv preprint arXiv:2305.19112},
  year    = {2023},
  doi     = {10.48550/arXiv.2305.19112}
}

@inproceedings{hamamci2023diffusion,
  title     = {Diffusion-based hierarchical multi-label object detection to
               analyze panoramic dental x-rays},
  author    = {Hamamci, Ibrahim Ethem and Er, Sezgin and Simsar, Enis and
               Sekuboyina, Anjany and Gundogar, Mustafa and
               Stadlinger, Bernd and Mehl, Albert and Menze, Bjoern},
  booktitle = {International Conference on Medical Image Computing and
               Computer-Assisted Intervention (MICCAI)},
  pages     = {389--399},
  year      = {2023},
  organization = {Springer},
  doi       = {10.1007/978-3-031-43987-2_38}
}

@misc{dentex_data_2023,
  title       = {DENTEX CHALLENGE 2023},
  author      = {Er, Sezgin},
  howpublished = {Zenodo},
  year        = {2023},
  month       = {4},
  doi         = {10.5281/zenodo.7812323},
  url         = {https://zenodo.org/records/7812323}
}
§9.4 引用指南
- 使用数据:至少引用
hamamci2023dentex(基准论文)与dentex_data_2023(Zenodo 数据 DOI);若与 baseline 对比,另引hamamci2023diffusion。 - 使用榜单数字:引用基准论文(arXiv:2305.19112)作为榜单唯一权威来源;如需引用某参赛队方法细节,再追加参赛短论文集 DOI 10.5281/zenodo.17387129。
- 使用冠军/亚军方法细节:引用参赛短论文集 DOI 10.5281/zenodo.17387129 并在文中注明具体队伍。
- 引用计数与版本信息:本页引用次数与"截至"日期见 INFOBOX;数据版本以 Zenodo v1(2023-04-09)与赛后 GT 公开(2025 更新)为锚点。
§9.5 许可与合规速查
| 要素 | 条款 |
|---|---|
| 数据许可 | CC BY-NC-SA 4.0:署名 + 非商业 + 相同方式共享 |
| 代码许可 | 官方 GitHub 仓库 MIT |
| 访问方式 | 开放直下,无需注册;挑战赛在线评测需 Grand Challenge 账号 |
| 商用 | 禁止(NC);需商用授权请联系版权方 |
| 衍生数据集 | 必须沿用 CC BY-NC-SA 4.0(SA 条款) |
| 外部数据混训 | 允许公开数据,须书面声明(挑战赛规则延续为学术惯例) |
| 论文发表 | 官方发表政策要求参赛者以 Springer LNCS 格式撰写方法论文并上传 arXiv(Publication Policy 页) |
§10 AI 使用声明卡
§10.1 AI 模型列表
| 模型 | 用途 | 版本/说明 |
|---|---|---|
| 大语言模型(CodeBuddy) | 词条初稿撰写、代码示例生成、结构组织 | 2026-09 生成 |
声明口径:AI 未接触任何非公开数据(含 DENTEX 原始影像与标注文件本体),本页全部事实性数字来自 §10.3 公开来源的文本转述,AI 生成内容不存在对数据集内容的"目视"或"测量"。
§10.2 AI 参与范围
AI 参与了本词条的资料检索整理、初稿撰写、代码示例编写与格式排版。全部事实性内容(规模数字、划分、指标、许可、引用)均来自 §10.3 所列公开来源并由人工交叉核对;医学编码(ICD-11/SNOMED CT)经公开编码库核实;文章结构与最终表述由编辑部审定。
范围边界的两点说明:代码示例(§5.4、§6.1-§6.4、§6.9)为按官方公开接口编写的教学实现,未经全量数据上的端到端回归测试,首次运行请配合 §6.1 的探查输出核对键名;榜单数字与许可条款为 2026-09 快照,投稿前请按 §9.1 官方链接复核最新版本。
§10.3 输入来源列表
- DENTEX 官网主页。 https://dentex.grand-challenge.org/ (2026-09 访问)
- DENTEX 官网数据页(Data / Annotation Protocol / Data Split)。 https://dentex.grand-challenge.org/data (2026-09 访问)
- DENTEX 官网发表政策页(Publication Policy)。 https://dentex.grand-challenge.org/publication-policy (2026-09 访问)
- Hamamci et al. DENTEX: An Abnormal Tooth Detection with Dental Enumeration and Diagnosis Benchmark for Panoramic X-rays. arXiv:2305.19112(v1 2023-05-30;v2 2025-11-13)。 https://arxiv.org/abs/2305.19112
- Hamamci et al. DENTEX: Dental Enumeration and Tooth Pathosis Detection Benchmark for Panoramic X-ray(arXiv v2 全文)。 https://arxiv.org/html/2305.19112v2 (2026-09 访问)
- DENTEX CHALLENGE 2023. Zenodo record 7812323(2023-04-09,v1)。 https://zenodo.org/records/7812323
- DENTEX Challenge 2023 Proceedings: Participant Short Papers. Zenodo record 17387129(2025-10-18)。 https://zenodo.org/records/17387129
- GitHub: ibrahimethemhamamci/DENTEX(README、License、引用条目)。 https://github.com/ibrahimethemhamamci/DENTEX (2026-09 访问)
- Hugging Face: ibrahimhamamci/DENTEX(数据卡、许可、viewer 状态、提交历史)。 https://huggingface.co/datasets/ibrahimhamamci/DENTEX (2026-09 访问)
- Hamamci et al. Diffusion-Based Hierarchical Multi-Label Object Detection to Analyze Panoramic Dental X-rays. MICCAI 2023, Springer LNCS, pp. 389-399. DOI 10.1007/978-3-031-43987-2_38(arXiv:2303.06500)
- Ultralytics 平台:DENTEX Dental Disease Detection(第三方重托管统计)。 https://platform.ultralytics.com/fatih/datasets/dentex (2026-09 访问)
- GitHub: noahred16/DeepTeeth(DENTEX 解压目录树与文件命名记录)。 https://github.com/noahred16/DeepTeeth (2026-09 访问)
- WHO. Oral health(口腔健康实况报道,2023)。 https://www.who.int/zh/news-room/fact-sheets/detail/oral-health
- WHO ICD-11 浏览器(DA08.0 龋病 / DA09.7 根尖周炎 / DA07.8 阻生齿;Find-A-Code 与维基文库中文版交叉核对)。 https://icd.who.int/
- Zancan et al. PLOS Digital Health 4(11): e0001074, 2025. DOI 10.1371/journal.pdig.0001074
- Malacards: Periapical Periodontitis(SNOMED CT 39273001 交叉核对)。 https://www.malacards.org/card/periapical_periodontitis
§10.4 人工校验记录
| 内容模块 | 审核者 | 审核方式 | 审核状态 |
|---|---|---|---|
| §2.1/§2.1b ICD-11 与 SNOMED CT 编码 | 千方病案医学编辑部 | 对照 WHO ICD-11 浏览器与 SNOMED 概念库逐码核实 | ✅ 已通过/已验证 |
| §3 数据集规格(子集数、划分、大小、md5) | 千方病案医学编辑部 | 对照官网数据页与 Zenodo 记录逐项核对 | ✅ 已通过/已验证 |
| §4 数据结构与字段字典 | 医疗 AI 数据工程师 | 对照官方发布说明与社区解压记录核对目录树与标注语义 | ✅ 已通过/已验证 |
| §6 代码示例 | 医疗 AI 数据工程师 | 逻辑走查 + 接口核对(pycocotools/torch API) | ✅ 已通过/已验证 |
| §8 排行榜成绩 | 千方病案医学编辑部 | 对照 arXiv v2 论文 Table I/II 逐数字核对 | ✅ 已通过/已验证 |
| §9 BibTeX 与 DOI | 千方病案医学编辑部 | 对照官方 README 引用条目与 Zenodo DOI | ✅ 已通过/已验证 |
| 队列条目纠错(规模/org 口径) | 千方病案医学编辑部 | 检索核实后按官方口径改写并在 FACTS 记录 | ✅ 已通过/已验证 |
| §1.3/§8.4 内链与外部资源可用性 | 医疗 AI 数据工程师 | 站内链接按千方 url_name 惯例核对;外链为官方主域 | ✅ 已通过/已验证 |
§10.5 AI 生成章节标注
以下内容在 AI 生成初稿基础上经人工逐句校订:§1 概览、§3 数据集规格、§4 数据结构、§6 AI 就绪指南(含 8 个坑点)、§7 质量评估、§8 基准与生态、§9 资源与引用。§2 医学背景由人工主导核对编码库后定稿。全部免责声明与审核声明为编辑部固定模板文本。
校订深度分级:§8.1 榜单数字、§3.2/§3.4 规模与校验值、§2.1/§2.1b 编码表为逐字符核对(错误代价最高);坑点与代码块为逐段逻辑核对;背景叙述段落为整节通读核对。
§10.6 最后人工审核日期
2026-09-05(与 §0 审核日期一致)
页面状态:published(全部内容已完成审核并发布)
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- rsna-pneumonia — 共享标签:医学影像 / X光影像 / 挑战赛数据集 / 目标检测
- vindr-cxr — 共享标签:医学影像 / X光影像 / 目标检测
- chestx-det10 — 共享标签:医学影像 / X光影像 / 目标检测
- rsna-series — 共享标签:医学影像 / X光影像 / 挑战赛数据集
- tufts-dental — 共享标签:医学影像 / X光影像 / 目标检测
- mura — 共享标签:医学影像 / X光影像 / 目标检测
- grazpedwri-dx — 共享标签:医学影像 / X光影像 / 目标检测
- 3dteethland — 共享标签:医学影像 / 挑战赛数据集 / 目标检测
- vindr-mammo — 共享标签:医学影像 / X光影像 / 目标检测
- anhir — 共享标签:医学影像 / 医学问答与基准 / 挑战赛数据集
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
