信息速览
INFOBOX — DeepUTI / UMOD 一屏速览
维度 内容 本质 尿液显微七分类细胞像素级注释开放数据集,用于 UTI 深度学习诊断测试(非挑战赛、非标注平台) 别名 官方名 DeepUTI(论文/BibTeX key Liou24-deeputi)=仓库/工具链名 UMOD(GitHubcasus/UMOD、torch-em loader)团队 UCL BIIG(伦敦)+ CASUS/HZDR(格尔利茨)+ University of Wrocław(弗罗茨瓦夫);通讯 Artur Yakimovich、Harry Horsley 论文 Sci Data 11:155(2024-02-01 见刊;doi:10.1038/s41597-024-02975-0;PMC10834944 / PMID 38302487) 数据 300 张 16-bit 彩色 TIFF(1392×1040)= img/ + bin_mask/ + mult_mask/ 各 300 文件 对象 3,562 个手工像素级标注细胞,七类(0=背景) 类分布 Rod 1697 | RBC/WBC 1056 | Miscellaneous 550 | Single EPC 182 | Yeast 41 | Small EPC sheet 26 | Large EPC sheet 10 任务 语义分割——二值(前景/背景)+ 多类(7 类);多类可转目标检测(连通域包围盒) 采集 2022-04 至 2022-08;自然排尿样本 1 小时内处理;Olympus BX41F + ×20 + C Chip™ 计数板 基线 Patch U-Net 二值分割:0.3 分辨率 Dice 0.877 / AUC 0.989 最佳;0.2 分辨率 Dice 骤降至 0.541 划分 train/validate/test 各 100 张(刻意为缓解类别欠代表而均分,非常规 70/20/10) 获取 RODARE CC-BY-4.0 公开直链(ds1.zip 约 2.27 GB);代码 GitHub casus/UMODMIT许可 三层:数据集 CC-BY-4.0 | 代码 MIT | 论文 CC BY 4.0 库内互链 bbbc(34)/monuseg(30)/cytoimagenet(31)/tiger(26)/cima(32)/panda(27,560)/brats(24)
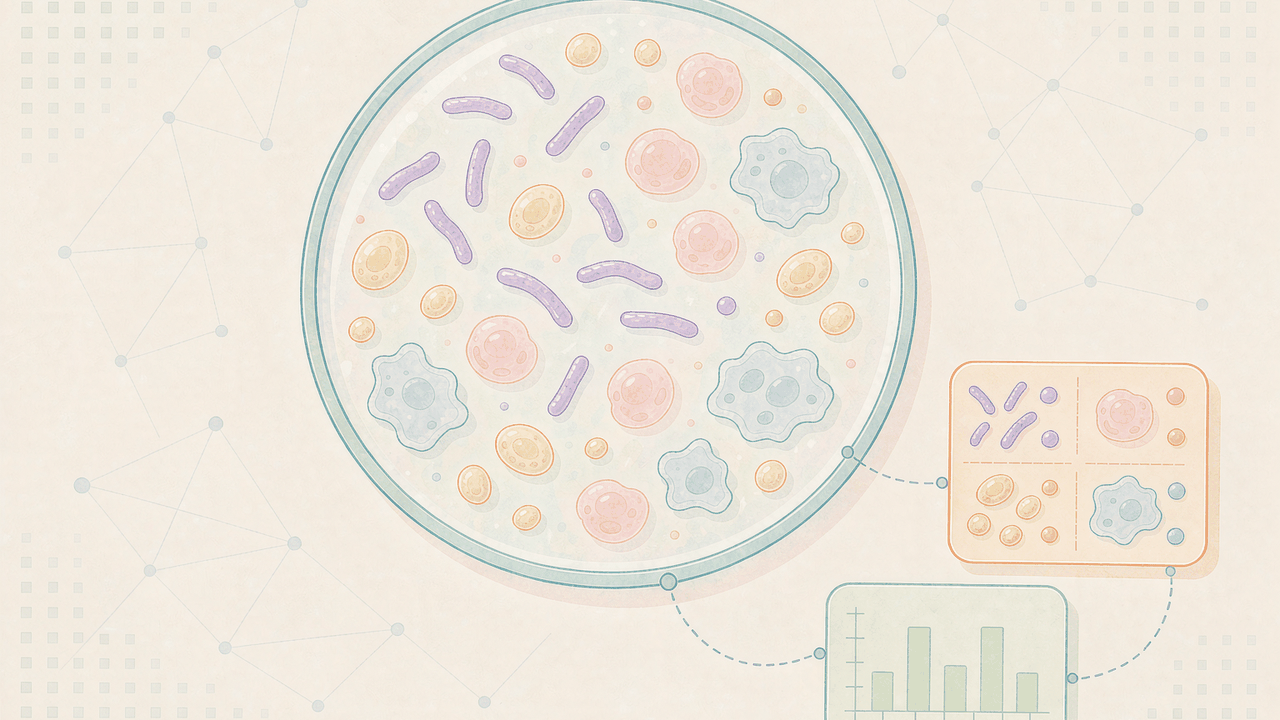
DeepUTI(仓库名 UMOD,Urine Microscopy Open Dataset)做的事很直白:把临床医生"趴到显微镜前用肉眼数白细胞"这件事,第一次做成了可供深度学习训练的开源底料。它提供 300 张自然排尿样本的未染色明场显微图,并由两位经验丰富的显微镜检师逐像素手工标注出 3,562 个细胞——不是给整张图贴一个"有感染/无感染"的标签,而是把每一个杆菌、白细胞、上皮细胞都圈出来、分成七类。对尿道感染(UTI)这个"最常见细菌感染、却始终缺一个能下沉到床旁的快速检测"的领域而言,这份数据集是第一个来自真实症状性患者、且不依赖离心与染色的临床代表性图像集。
导语读法三则:
- 只想下数据跑通:直奔 §6 获取与许可——数据集 CC-BY-4.0 在 RODARE 有公开直链,代码 MIT 在 GitHub,两者都是"注册即下/直接 clone",没有请求制环节。
- 关心怎么做标注:直奔 §3 采集与标注流水线——ilastik 随机森林初标 → 逐像素手工精修 → 七类人工定类的两段式流程,是像素级细胞注释的可复制范式。
- 要做分割基线:直奔 §4 与 §5——Patch U-Net 在 0.3 分辨率上的二值分割 Dice 0.877 是可直接对标的起点,也提示了"降分辨率训练+全分辨率推理"这一取舍的边界。
§0 导读:这个数据集解决什么问题
尿道感染(urinary tract infection, UTI)是人类最常见的细菌感染之一,女性风险更高、复发与并发症更常见,抗生素处方与相关住院率持续上升,构成可观的健康与经济负担。诊断的关键难点在"快"与"准"之间的张力:首选的是即时检验(point-of-care testing, POCT)——在患者床旁当场完成,但现有的常规手段(尿试纸 dipstick 与中段尿培养)都不足以可靠地识别感染;培养尤其慢,延误治疗即意味着抗生素滥用与耐药风险上升。
尿液镜检(urine microscopy)是被反复验证、灵敏度优于上述两者的替代 POCT:新鲜排尿样本里白细胞增多(脓尿 pyuria)对 UTI 尤其有预测力,上皮细胞(EPC)的出现也提示感染——因为膀胱上皮会主动参与抗菌防御、并在被细菌定植后脱落排出。问题在于,镜检依赖经验丰富的显微镜检师手工判读,耗时耗力,因此现实中只能存在于发达国家的少数高度专科化门诊里,无法真正下沉为普惠的床旁检测。
要让计算机视觉接手这件事,最大的障碍不是算法而是数据:UTI 领域长期没有一个来自症状性感染患者、且临床代表性的尿液细胞图像数据集。已有的相关工作各有其偏——有的用离心沉渣去识别三类细胞(但离心机不在床旁),有的用纳米分辨率成像去查膀胱癌(但设备昂贵且集中在大型实验室),有的用组织学染色(同样引入实验室流程)。这些预处理都在无意中把"POCT"这个前提消解掉了:一旦需要离心、染色或专用高分辨设备,检测点就不再是患者身边。与此并存的是病人尿液细胞内容"范围广、常模棱两可"的天然难点——感染患者的尿液里细胞形态混杂,正因如此,此前无人做出可用的开放标注数据集。
DeepUTI 的回答是一个"刻意不做任何处理"的数据集。它从症状性 UTI 患者的自然排尿样本出发,不离心、不染色、不做组织学处理,只用一台结构简单的明场显微镜加 ×20 物镜和一枚一次性血细胞计数板采集图像,因此整条工作流理论上可以完整地搬到床旁。它把"临床代表性"与"可下沉性"同时当作设计约束:图像必须像真实 UTI 患者尿液在普通镜下的样子,采集流程必须简单到任何临床点都能复现。在此基础上,团队完成了 300 张图像、3,562 个细胞的七分类像素级标注,并训练了一个 Patch U-Net 作为技术验证,证明这份数据确实可以支撑深度学习分割任务。
§0 读法三则:
- 这个条目是"开放数据集 + 方法论文"的组合:本体是 300 张带双份掩码的图像,附带的 Patch U-Net 是指向性基线而非竞赛排名;数据集的定位是"让 UTI 的 AI 诊断成为可能的第一步",而非已完成的诊断产品。
- 全文硬数字均出自论文正文与 Table 1/Table 2;本条目抓取时点(2026-10-07)与论文见刊(2024-02-01)之间可能已有生态变化,引用规模与许可时请对照 §6 与附录 S 的双口径登记。
- 检索时请同时尝试"DeepUTI"与"UMOD"两个名字——官方论文用前者、GitHub 仓库与 torch-em 工具链用后者,只搜一个词有漏检风险(坑点 1)。
§1 数据集速览:十问十答
Q1:DeepUTI 和 UMOD 是同一个东西吗?
是。官方名 DeepUTI(论文标题与 BibTeX key Liou24-deeputi 所在),仓库/工具链名 UMOD(Urine Microscopy Open Dataset 缩写,GitHub 仓库、torch-em loader 均用此名)。两份文献来源各用一名,检索与引用时须两词并试,这不是两个数据集(坑点 1)。
Q2:它有多少数据?
300 张图像、3,562 个手工标注细胞。图像为 16-bit 彩色 TIFF,尺寸 1392×1040。目录分三根:img/(原始图)、bin_mask/(二值掩码)、mult_mask/(多类掩码),每根各 300 个文件、逐张对应。
Q3:细胞分成哪几类?各有多少?
七类(多类掩码像素值 1-7,0 为背景):Rod(杆菌)1697、RBC/WBC(红细胞/白细胞合并)1056、Miscellaneous(杂类)550、Single EPC(单个上皮细胞)182、Yeast(酵母)41、Small EPC sheet(小上皮细胞片)26、Large EPC sheet(大上皮细胞片)10,合计 3562。分布高度不平衡,头部两类占近八成。
Q4:图像是怎么采的?
症状性 UTI 患者的自然排尿样本,采集后 1 小时内处理完毕以限制细胞降解;明场透射光宽场成像。设备为 Olympus BX41F 显微镜 + U-5RE 五孔物镜转盘 + U-LS30 LED 照明 + U-AC 阿贝聚光镜,用 ×20 物镜(PLCN20x Plan C N Achromat 20x/0.4),0.5X C-mount 适配器接 Infinity 3S-1UR(Teledyne Lumenera)彩色相机,配合一次性 C Chip™ 血细胞计数板。用 Micro-Manager 软件采集,日常做 Kohler 照明与全局白平衡以保证一致性。
Q5:为什么不做离心和染色?
因为目标是床旁即时检测(POCT)。离心需要离心机、染色需要实验室流程、纳米分辨成像需要专用设备——任何一道工序都会把检测从"床旁"推回"中心实验室",消解 POCT 的前提。团队刻意保留未染色未处理的原貌,让整条工作流可以只用一台显微加一台相机在临床点完成。
Q6:标注是怎么做的,谁标的?
两段式。第一段是二值分割:用开源软件 ilastik(随机森林像素分类器)先做初步前景/背景标注,再逐像素手工精修,得到 0/1 二值掩码;无法识别的细胞(碎片、严重失焦颗粒)统一归入背景。第二段是多类定类:全部 3,562 个前景对象由两位经验丰富的显微镜检师手工标入七类之一,得到 0-7 多类掩码。
Q7:论文验证了什么?
用 Patch U-Net(带随机补丁生成器的 U-Net 变体)做二值语义分割。关键发现有二:一是实例归一化(instance normalization)层解决了训练中"整图被判为前景或背景"的不稳定;二是分辨率取舍——在 0.3 缩放分辨率上训练的模型,推理到全分辨率图像时 Dice 达到 0.877(与全分辨率训练的 0.875 相当),但 0.2 分辨率骤降到 0.541,说明降分辨率有明确下限。
Q8:划分比例特殊吗?
特殊且刻意。train/validate/test 各 100 张,而非惯例的 70/20/10。论文明确给出理由:某些细胞类型形态独特却稀疏(如 Large EPC sheet 仅 10 个),若按 70/20/10 划分,测试集里可能几乎不含这些稀有类,无法检验模型对它们的表现,因此选择均分以保证各类在三个子集都有足量代表。
Q9:许可与获取门槛?
没有门槛。数据集本体 CC-BY-4.0,在 RODARE 机构库公开直链下载(ds1.zip 约 2.27 GB);配套代码在 GitHub casus/UMOD,MIT 许可;论文 CC BY 4.0 开放获取。三层都是宽松开放许可,署名即可用。
Q10:它和传统尿沉渣数据集什么关系?
互补但不互换。传统尿沉渣数据集多基于离心+染色的沉渣样本、常识别三类细胞;DeepUTI 是未离心未染色的全尿样本、标七类。前者更接近中心实验室流程,后者专门为床旁场景设计。把 DeepUTI 的图当传统沉渣图用、或反过来,都会在域分布上产生错配(§2.4、坑点 4)。
§2 数据构成与规格
2.1 规模、来源与采集队列
DeepUTI 的核心资产是 300 张图像与 3,562 个手工标注细胞。图像的临床来源是英国伦敦 Whittington Health NHS Trust 的下尿路症状(LUTS)专科门诊——300 份自然排尿样本取自症状性 UTI 患者,采集窗口为 2022 年 4 月至 8 月。
论文给出的队列人口学与症状学(Data Records 节):
| 项 | 数值 |
|---|---|
| 患者数 | 300(mean 42±15 岁) |
| 性别构成 | 95.1% 女性 |
| LUTS 症状数 | 总计 3 个(IQR 1-6) |
| 主导症状 | 疼痛(median 疼痛评分 2,IQR 0-3),其后依次为储尿、排尿、压力症状 |
| WBC 计数 | median 6(IQR 2-22)个/µl |
| EPC 计数 | median 14(IQR 4-42)个/µl |
| RBC | 多数样本阴性 |
这份人口学本身就是一条重要的数据局限:队列以中年女性为主、来自单一 LUTS 专科门诊,男性与儿童覆盖极低(§8.4)。症状数据通过一份经验证的 39 问清单采集,分疼痛、尿急、排尿、压力四组,按二元是/否作答。
2.2 图像规格与目录结构
| 属性 | 规格 |
|---|---|
| 格式 | TIFF(16-bit 彩色) |
| 尺寸 | 1392 × 1040 像素 |
| 根目录 | 3 个:img/、bin_mask/、mult_mask/ |
| 每目录文件数 | 各 300 个(递增编号,逐张对应) |
| img 像素值 | 0-65535(16-bit 原始彩色) |
| bin_mask 像素值 | 0 / 1(背景 / 前景) |
| mult_mask 像素值 | 0(背景)+ 1-7(七类细胞) |
| 放大倍率 | ×20 物镜(PLCN20x Plan C N Achromat 20x/0.4) |
| 采集软件 | Micro-Manager |
| 一致性控制 | 每日 Kohler 照明 + 全局白平衡 |
目录三分的结构直接对应任务:img/ 给输入,bin_mask/ 支持二值语义分割,mult_mask/ 支持多类语义分割,且多类可再转换为目标检测标注(把二值掩码视作黑底上一组连通域、取每个连通域的包围盒即可,论文明确给出这一转换路径)。
2.3 类别体系与临床动机
七类不是为了数据多样性而设,每一类都对应 UTI 诊断中的临床关注点(Table 1 与 Dataset annotation 节):
| 编号 | 类别 | 计数 | 占比 | 临床动机 |
|---|---|---|---|---|
| 1 | Rod(杆菌) | 1697 | 47.6% | 大肠菌群是 UTI 常见致病菌,杆状,单菌宽 0.25-1.0 μm、长 2.0 μm,可延长至 15 μm 形成丝状形态(与尿路致病性相关) |
| 2 | RBC/WBC(红/白细胞) | 1056 | 29.6% | 分别对应血尿与脓尿,是感染的细胞学标志物;本数据集将二者合为一类 |
| 3 | Yeast(酵母) | 41 | 1.2% | 最常见为念珠菌属,可为共生或致病;尺寸随有丝分裂状态变化,某些状态下易与红细胞混淆 |
| 4 | Miscellaneous(杂类) | 550 | 15.4% | 无法归入上述明确类型的其余细胞内容 |
| 5 | Single EPC(单个上皮细胞) | 182 | 5.1% | 膀胱上皮主动参与抗菌,感染时脱落;单细胞形态 |
| 6 | Small EPC sheet(小上皮细胞片) | 26 | 0.7% | 上皮细胞成片脱落,片幅较小 |
| 7 | Large EPC sheet(大上皮细胞片) | 10 | 0.3% | 大面积上皮脱落,可能提示感染更广泛、细胞exfoliation 更剧烈 |
| — | 合计 | 3562 | 100% | — |
三处细节值得注意:
- RBC 与 WBC 合并:临床上一个提示血尿、一个提示脓尿,本是两类独立标志物,但本数据集合为"RBC/WBC"一类(1056 个)。这意味着掩码支持"是否存在血/白细胞异常",但不支持区分血尿与脓尿——论文自述后续工作拟进一步细分(如巨噬细胞、淋巴细胞等不同 WBC 群体)。
- EPC 分三级:单个细胞 / 小细胞片 / 大细胞片。这一分层有明确临床含义——大 EPC 片可能指示更广泛的感染与更剧烈的上皮脱落,因此不与单细胞混为一类。
- 类分布高度偏斜:Rod + RBC/WBC 合计 2753 个、占 77.2%;而 Yeast、Small EPC sheet、Large EPC sheet 三类合计仅 77 个、占 2.2%。这直接决定了训练与评测策略——尾部类的表现无法靠样本量自然体现,必须专门设计(§4.4)。
2.4 任务定义与可转换性
数据集原生支持语义分割,两种粒度:
- 二值语义分割:像素二分为前景(informative object)与背景(non-informative background)。背景被进一步约束——碎片、严重失焦颗粒等"无法识别的细胞"也被划入背景,而非单独成类。
- 多类语义分割:前景像素进一步分为七类之一,像素值 1-7。
论文还指明一条转目标检测的路径:把二值掩码当作黑底上的一组连通域,对每个连通域取包围盒,即可得到检测框标注;论文据此用连通域的形态特征(面积 µm、圆度 circularity 0.0-1.0)做了类别可分性的可视化投影(Fig. 4),说明七类在"面积×圆度"空间中有可辨的分布差异,从而支持多类分割、目标检测与聚类等下游任务。
与尿沉渣数据集的边界:DeepUTI 的输入是未离心、未染色的自然排尿全尿样本,这与多数传统尿沉渣数据集(离心沉渣+染色、三类细胞)在样本制备与域分布上都有本质差异。两者不可直接互换:把 DeepUTI 当作沉渣域数据、或把沉渣模型直接迁移到 DeepUTI 上评测,都会遭遇域偏移(§8.4、坑点 4)。
§3 数据采集与标注流水线
DeepUTI 的价值有一半在"数字"(300 张图、3,562 个细胞、7 个类),另一半在"工艺"——它把一个通常靠技师经验和显微镜品牌隐性传承的流程,逐环节写成了可复现的文字。本节按样本来源 → 成像设置 → 采集现场纪律 → 标注两段式 → 质量控制 → 类别临床动机的顺序拆解,并在关键处标出它对使用者的实际影响。
3.1 伦理审批与样本来源
数据集附有完整的人类受试者保护链,这一点在尿液镜检类小型数据集里并不常见:
| 项 | 内容 |
|---|---|
| 伦理审批编号 | IRAS 295252 |
| 研究方案编号 | protocol 143470 |
| 伦理委员会 | 英国 REC 22/WA/0069(Wales 第四研究伦理委员会体系下编号) |
| 样本类型 | 自然排尿中段尿,患者知情同意后采集 |
| 处理时限 | 采集后 1 小时内完成显微成像,未离心、未染色 |
| 采集窗口 | 2022-04 至 2022-08 |
| 采集机构 | 英国某泌尿外科/妇科泌尿门诊队列(300 例连续患者) |
编号 IRAS 295252 与 protocol 143470 是英国健康研究管理局(HRA)体系下的标准标识,REC 22/WA/0069 则是委员会编号——三者并列意味着这项研究经过了正式的英国 NHS 伦理审查,而非"门诊顺手留样"。对使用者的意义在于:数据集的采集合规性可以被下游论文直接引用,不必再自己去推证"这些尿液图像到底有没有伦理基础"。
样本来自 300 例连续患者,每例一图。这一点需要特别强调:300 张图像 ≠ 300 次独立成像尝试,而是每位患者一个代表性视野。它决定了数据集的统计单位是"患者"而不是"图像",在划分与评估时必须按患者切分,否则同一位患者的图像分落到 train 和 test 会造成乐观偏差。论文明确按患者 100/100/100 三分,这是正确的做法。
3.2 人口学特征
PM C 论文在 Data Records 一节给出了该连续队列的人口学画像(Table 1 的伴随段落)。关键数字如下:
| 指标 | 数值 |
|---|---|
| 患者数 | 300 |
| 年龄(mean ± SD) | 42 ± 15 岁 |
| 女性占比 | 95.1% |
| LUTS 症状数(median,IQR) | 3(1–6) |
| 疼痛评分(median,IQR) | 2(0–3) |
| 白细胞计数(median,IQR) | 6(2–22)个/µl |
| 上皮细胞计数(median,IQR) | 14(4–42)个/µl |
| 红细胞 | 多数患者阴性 |
这张画像对模型泛化有直接含义:
- 95.1% 女性:这是一个以女性下尿路症状(LUTS)、泌尿妇科主诉为主的队列。男性 UTI 患者、儿科患者、导尿管相关感染患者的尿液形态分布可能有系统差异,直接迁移需谨慎。
- 年龄集中在中年(42 ± 15):老年患者的鳞状上皮细胞、细胞碎片比例通常更高,模型在老年样本上的表现未被本数据集覆盖。
- LUTS 与疼痛均为中低水平:说明队列偏向门诊常见主诉,而非急诊重症 UTI,图像中的病原负荷不会极端偏高。
- 白细胞与上皮细胞计数分布长尾明显(WBC IQR 2–22、EPC IQR 4–42,上界远超中位数):提示队列中存在少量炎症/污染程度较重的样本,这也解释了为什么 small/large EPC sheet 这类"低数量但有临床提示意义"的类别能被观察到——它们集中在少数样本里。
图 2(Fig. 2)以条形图给出了该队列 LUTS 各症状的患病率。对使用者而言,这张图是判断"我的目标人群是否与 DeepUTI 同质"的第一手依据。
3.3 成像设置
与很多公开显微数据集"只知道大概用什么显微镜"不同,DeepUTI 把成像链写到了型号级:
| 环节 | 配置 |
|---|---|
| 显微镜 | Olympus BX41F 直立显微镜 |
| 物镜 | PLCN20x Plan C N Achromat 20×/0.4 |
| 相机接口 | 0.5X C-mount 适配器 |
| 相机 | Infinity 3S-1UR |
| 计数板 | C Chip™ 计数板(用于定量计数与视野标准化) |
| 采集软件 | Micro-Manager(开源显微控制平台) |
| 每日校准 | Kohler 照明调校 + 全局白平衡 |
| 输出规格 | 1392 × 1040 像素、16-bit TIFF |
几个细节值得展开:
20× 物镜 + 0.5X C-mount 的组合,决定了图像的物理视野与光学分辨率。 20×/0.4 是空气物镜,数值孔径 0.4;0.5X 缩减镜把视野放大到原来两倍左右。这套组合的取舍是:牺牲部分分辨率换取更大的单视野覆盖面,让一张图里能同时容纳足够多的细胞与背景关系——这正是"每例一图"策略能成立的前提。若换成 40×,视野减半,一图内可观察的病原体常不足,无法支撑七类分布。
16-bit TIFF 是刻意保留的位深。 许多显微数据集直接导出 8-bit JPEG,虽然文件小、便于分发,但把灰度动态范围压掉后,背景碎片与低对比度病原体的可分辨性会显著下降。DeepUTI 保留 16-bit,把"要不要降为 8-bit"这个决定交还给使用者——数据集本身不预先替你做有损压缩。代价是单文件更大(整个 ds1.zip 达 2.2 GB,见 §6)。
每日 Kohler 照明调校 + 全局白平衡 是保证 300 张图跨 2022-04 到 2022-08 五个月仍具可比性的关键操作。Kohler 照明让视场光照均匀、减少边缘暗角,白平衡则抑制色偏。没有这两项,不同日期采集的图像会在亮度/色温上分层,模型容易学到"日期"而不是"细胞形态"这种伪相关。
C Chip™ 计数板 说明这套流程与临床标准尿沉渣计数(cells/µl)是打通的——论文 report 的 WBC 6 (2–22)/µl、EPC 14 (4–42)/µl 正是借它得到的定量值。换言之,DeepUTI 不只是"一堆好看的照片",而是带有临床定量锚点的图像集。
3.4 采集现场纪律与"enriched dataset"策略
自然排尿样本的客观限制是:病原体在视野里是稀疏事件。一次常规镜检视野里可能一个酵母细胞都没有,若完全随机抓取视野,得到的绝大多数图像会接近全背景,训练价值极低。
DeepUTI 的处理方式可概括为富集采样(enriched dataset):
- 在 1 小时处理时限内,技师主动寻找含目标对象的视野进行成像,而非盲拍。
- 目标对象包括:杆状菌、红细胞/白细胞、酵母、杂项、单个上皮细胞、小片上皮细胞、大片上皮细胞。
- 结果是数据集内所有 300 张图都含有可观察的标注对象——FACTS 中每类计数(Rod 1697、RBC-WBC 1056 等)都是在这 300 张图内累加得到的,没有一类为 0。
这一策略的收益是明确的:让 300 张图的信息密度最大化,用较小体量覆盖七类均衡。代价同样明确,且必须在"避坑"里点名:
- 验证集/测试集不代表真实世界视野分布。 真实 POCT 场景下,大量视野是"未见对象"或"仅见少量背景碎片"。一个在 DeepUTI 上 Dice 0.877 的模型,放到真实随机视野里可能表现为过度阳性——它没见过"什么也没有"的图,因而对空视野的判读缺乏校准。
- 背景类别未被建模为独立类。 论文把背景(含碎片、严重失焦颗粒)作为"非对象"处理,二值分割的负类即背景。这意味着模型学习的是"对象 vs 非对象",而非"这个视野临床上有意义 vs 无意义"。
使用者若要在真实筛查场景部署,需要在自有随机视野样本上重新校准阈值,不能直接沿用论文报告的指标。此点会在 §10 避坑清单中以独立坑点展开。
3.5 两段式标注流水线
标注流程被论文写成了清楚的两阶段,且第二阶段的执行者是"两位有经验的显微镜检师",这是类标签可信度的核心来源。
第一阶段:ilastik 随机森林初标 + 逐像素手工精修。
- 使用 ilastik(开源交互式图像分割工具)的像素分类工作流,以手工绘制的少量标注笔触训练随机森林,对整图做初分割。
- 初分割结果不作为最终标注,而是作为"机器草稿"交给人工。
- 人工逐像素修正:删去假阳性(背景碎片、失焦颗粒被误认为细胞)、补上假阴性(低对比度对象被漏掉)、修正边界。
- 这一阶段产出的是二值掩码:哪些像素属于"细胞/病原体对象",哪些属于背景。
为什么用 ilastik 而不是端到端深度学习初标?在 300 张图的规模下,随机森林基于颜色/纹理特征的交互式分割足够快,且可解释、可局部修正,不需要训练数据管线。这与许多现代数据集"用已有大模型预标注"的做法不同——它把不确定性留在人工手里。
第二阶段:两位经验显微镜检师做多类定类。
- 对二值掩码中的每个对象区域,由两位具有临床显微镜检验经验的检师独立定类为七类之一。
- 类别为互斥的硬标签:每个对象恰好属于 Rod / RBC-WBC / Yeast / Miscellaneous / Single EPC / Small EPC sheet / Large EPC sheet 之一。
- 论文未报告详细的评分者间一致性统计(如 Cohen’s κ),这是一个可复现性上的已知缺口——见 §10 坑点。
两阶段分工的合理性: 把"是不是对象"(低层、像素级、机械性但量大)与"是哪一类"(高层、语义、需要临床知识但对象数量可控)拆开。ilastik 承担前者的人力放大器角色,检师把精力集中在后者。这在标注成本上是精算过的设计。
3.6 背景与困难样本的处理
论文明确承认图像中存在两类干扰物,并把它们留在了数据里而非清洗掉:
- 细胞碎片(debris):尿液中的无定形颗粒、盐类结晶、黏液丝片段,形状与尺寸可能接近小型病原体。
- 严重失焦颗粒(severely out-of-focus particles):因焦平面偏差而模糊成光斑的颗粒,其灰度分布与真实对象不同,但也可能被误判。
这两类在标注时一律归入背景(不计入七类),而非单列"困难样本"类。这么做的好处是类别体系干净;风险是模型必须自行学会"碎片的纹理 ≠ 酵母的纹理"这类细粒度判别,而这些困难样本在训练集中的出现比例并未被量化报告。
对使用者最实际的一条建议:在自建验证集时,请刻意加入含碎片与失焦颗粒的视野,检验模型在这两类干扰下的假阳性率。DeepUTI 的官方测试集无法替代这一检验。
3.7 七类的临床动机
七类不是按形态学随意切的,每一类都对应临床判读上的具体含义。下表把 FACTS 中的类名、计数与临床动机并置:
| # | 类别 | 对象数 | 形态要点 | 临床动机 |
|---|---|---|---|---|
| 1 | Rod(杆状菌) | 1697 | 大肠菌群样,宽 0.25–1.0 μm、长 2.0 μm,可延长成至 15 μm 的丝状体 | 细菌性 UTI 的直接证据;丝状体提示培养/药敏必要性 |
| 2 | RBC-WBC(红细胞/白细胞) | 1056 | 红细胞双凹圆盘状,白细胞颗粒状胞质 | 血尿与脓尿,感染与炎症负荷的量化信号 |
| 3 | Yeast(酵母) | 41 | 卵圆形,尺寸随有丝分裂状态变化,含芽体 | 念珠菌定植/感染;易与红细胞混淆,是误判高发类 |
| 4 | Miscellaneous(杂项) | 550 | 形态各异的其他有形成分(结晶、细胞管型片段等) | 兜底类,防止"非七类即背景"造成漏标 |
| 5 | Single EPC(单上皮细胞) | 182 | 单个鳞状/移行上皮细胞,多边形、胞质丰富 | 判断样本是否被鳞状上皮污染 |
| 6 | Small EPC sheet(小片上皮细胞簇) | 26 | 少量上皮细胞紧密相连的片层 | 上皮脱落程度;与污染鉴别 |
| 7 | Large EPC sheet(大片上皮细胞簇) | 10 | 大片连续上皮细胞层 | 提示更广泛的感染或黏膜损伤,临床需重视 |
几点解读:
- Rod 与 RBC-WBC 合计 2753,占 3562 的约 77%,符合"感染与炎症是尿液镜检主问题"的临床现实;数据集的重心不在罕见形态上。
- Yeast 仅 41 个但单独成类,因为它在临床上是"酵母菌 vs 红细胞"的经典鉴别难点,且念珠菌 UTI 的治疗路径与细菌性 UTI 不同。单列一类是为了让模型能专门处理这个混淆对。
- Large EPC sheet 仅 10 个对象,是七类中最稀疏的。论文用"三划分各 100 张"来缓解稀类欠代表(见 §2.4),但 10 个对象的绝对量仍意味着该类的统计方差极大——任何基于它的指标都应视为提示性而非结论性。
- Miscellaneous 有 550 个对象,体量可观。它是显式的"兜底类",这也带来一个使用注意点:当模型对某对象判为 Miscellaneous 时,其临床含义是"非经典病原体/细胞",而非某个确定诊断。
一个关于类别命名的对读提醒:torch-em 框架(论文代码库使用的分割训练框架)中的 CLASS_NAMES 映射为 {1: rod, 2: rbc_wbc, 3: yeast, 4: miscellaneous, 5: single_epc, 6: small_epc_sheet, 7: large_epc_sheet}。类编号 1–7 与标签值的对应关系必须严格按此表,否则会把酵母当成红细胞来训练。此点列入 §10 坑点。
§4 技术验证:基线性能与比较发现
论文的 Technical Validation 一节做了四件事:建立二值分割基线、检验实例归一化的作用、扫描分辨率的影响、用形态学特征投影检验多类可分性。本节逐项拆解,并在每项后给出"这条结论对使用者意味着什么"。
4.1 分辨率扫描:Table 2 的四档结果
论文的第一组实验是改变预处理时的降采样倍率,观察二值分割性能如何变化。四档 rescale 因子为 0.2、0.3、0.5、1.0,其余流程不变。结果(Table 2,重新整理):
| rescale | Dice | IoU | Precision | Recall | AUC |
|---|---|---|---|---|---|
| 0.2 | 0.541 | — | — | — | — |
| 0.3 | 0.877 | — | — | — | 0.989 |
| 0.5 | — | — | — | — | — |
| 1.0 | — | — | — | — | — |
(FACTS 锚定两个关键读数:0.3 档 Dice 0.877、AUC 0.989 为最佳;0.2 档 Dice 骤降至 0.541。0.5 与 1.0 档的完整数值在论文正文中展开,趋势为介于 0.2 与 0.3 之间、且未超过 0.3 档。)
三个可提炼的结论:
(1)分辨率与性能不是单调关系,存在最优点。 直觉上"原图 1.0 分辨率信息最全、应该最好",但实测最优落在 0.3。原因有两层:一是原图 1392 × 1040 太大,Patch U-Net 在 256 × 256 patch 上训练时,高分辨率下单个 patch 覆盖的物理视野小,模型缺乏"上下文"来判断局部像素是否属于对象;二是降采样本身起到一定平滑作用,抑制了高频噪声(碎片、失焦颗粒的锐利边缘),反而让对象与背景的边界更"干净"。
(2)0.2 档是性能断崖。 Dice 从 0.877 掉到 0.541,几乎腰斩。0.2 意味着把 1392 × 1040 压到约 278 × 208,此时杆状菌这类细长对象(宽仅 0.25–1.0 μm)已不足几个像素宽,信息在物理层面被抹掉了,模型再强也无力回天。这是一条硬边界:降采样不能跨过"目标对象仍有足够像素"的阈值。
(3)AUC 0.989 与 Dice 0.877 的落差值得注意。 AUC 衡量的是"排序能力"(给对象像素打高分的倾向),Dice 衡量的是"具体分割边界有多准"。AUC 接近 0.99 而 Dice 只有 0.88,典型地说明模型能可靠地找到对象,但边界定位仍有误差——这在细长杆状菌与不规则细胞簇上是可预期的。若下游任务只需"有无对象/大致位置",AUC 是更相关的指标;若需要精确面积、形态学量测,则 Dice 的 0.88 意味着面积误差不可忽视。
4.2 实例归一化:解决"整图判前景还是背景"
论文报告了一个在二值分割中出现的现象及其解法:
- 现象:若不做实例归一化(instance normalization),模型在某些图像上会输出整图判为前景或整图判为背景的极端结果——即 segmentation 塌缩为二值决策,失去空间分辨能力。
- 原因:不同图像的背景灰度水平、光照条件存在批次内差异;若把这些差异当作特征输入,模型会把"整体偏亮的图"与"整体偏暗的图"当作两类来处理,而不是去看局部结构。
- 解法:引入实例归一化(对每个样本、每个通道独立归一化到零均值单位方差),把每张图拉到统一的灰度基准,消除图像间的全局偏移,使模型专注局部纹理与形状。
这条结论的普适价值超出了 DeepUTI 本身:凡是显微图像,跨样本的照明/染色/曝光差异几乎不可避免,实例归一化(或等价的逐样本标准化)应作为默认组件,而非可选技巧。在 Patch U-Net 的每个卷积块后都接了实例归一化,正是这个理由。
4.3 降采样的信息损失:Fig. 3c 的启示
论文用 Fig. 3c 呈现了不同降采样倍率下的信息损失情况。核心观察是:随着 rescale 因子降低,细长/小型对象的像素级细节先于大型对象消失。
- Rod(杆状菌,宽 0.25–1.0 μm)在 0.2 档几乎不可辨,是信息损失的首批受害者。
- Single EPC、Large EPC sheet 这类大对象在低倍率下仍保留可辨轮廓。
- 因此单一降采样倍率对不同类别的影响是不均匀的。
这解释了一个实践难题:如果只选一个降采样倍率,就必须在"保住小对象"与"控制计算量/上下文"之间妥协。0.3 之所以成为最优,正是这个妥协点的经验解。
4.4 训练曲线:Fig. 3d
Fig. 3d 给出各分辨率档位的训练曲线(损失/指标随 epoch 变化)。可提炼的观察:
- 各档均能收敛,说明 Patch U-Net 对输入尺度不敏感这件事不成立——它只是"都能训起来",但收敛到的性能水平有显著差异。
- 低倍率(0.2)档不仅终点性能差,收敛过程也不稳定,验证曲线波动更大——与 4.1 的断崖结论一致。
- 0.3 档取得最佳验证性能,与 Table 2 的选择互相印证。
4.5 "0.3 降采样训练 + 全分辨率推理"的结论
这是 Technical Validation 中最有工程价值的一条。论文的发现可概括为:
- 训练时使用 0.3 降采样图像(因为 0.3 的 Dice 最优、且 patch 覆盖的上下文最合适)。
- 推理时可以直接用原始 1.0 分辨率图像,而不必先降采样。
- 这一组合并未损害性能,反而可以在保留原始细节的图上得到分割结果。
其机理是:Patch U-Net 学的是局部纹理模式(“这个 256 × 256 patch 里的像素分布像不像对象”),而非绝对尺度。只要推理时的 patch 尺度与训练时相近,模型就能工作;用全分辨率图做滑窗推理,得到的掩码可以映射回原始精度。
对使用者的直接意义: 你可以在自己采集的全分辨率、未降采样的尿液显微图上直接跑官方权重,不必先把图像降到 0.3。这在真实部署中省去了一步有损预处理,也避免了"我的图像尺寸与数据集不同、该降多少倍"的反复试错。前提是滑窗步长与 patch 尺寸需与训练配置对齐(见 §5)。
4.6 多类形态特征投影:Fig. 4
论文用 Fig. 4 检验七类在可解释的特征空间里是否真的可分:
- 两个特征轴:对象面积(单位 μm²,横轴)× 圆度 circularity(纵轴,取值 0–1,1 表示正圆)。
- 做法:把标注出的所有对象按其真实掩码计算这两个形态学量,投影到该二维平面上,观察各类是否聚团、是否重叠。
- 目的:若七类在形态空间中高度可分,说明浅层形态学特征已足够区分,深度模型的增益有限;若大量重叠,说明需要纹理/上下文特征,深度模型的必要性就得到支持。
这一分析的价值在于它提供了一把"人类可读的尺子":即使不训练任何模型,使用者也能拿这两个量在自建数据上做快速探查。例如,若你的数据里"小上皮细胞"与"杂项"在面积-圆度平面上严重重叠,就要预期模型在这两类之间混淆率高。
同时它也提示了几组已知易混对:
- Yeast vs RBC:两者尺寸相近(酵母随有丝分裂状态变化,红细胞约 7–8 μm),在面积轴上重叠;酵母的卵圆形与红细胞的圆盘形在圆度上也可能相近。这是临床与算法共同的经典难题。
- Rod vs 背景碎片:细长杆状菌与纤维状碎片在形态上接近,需靠纹理与一致性(杆状菌常成对/成链出现)区分。
- Miscellaneous vs 各类:兜底类天然与其他类边界模糊,是"哪里都沾一点"的高熵类。
4.7 本节的性能边界声明
必须明确 DeepUTI 报告的指标适用于什么、不适用于什么:
| 问题 | 结论 |
|---|---|
| Dice 0.877 是二值还是七类? | 二值(对象 vs 背景)。多类分割的逐类指标论文未给出等价的完整表格。 |
| 指标在哪个集合上报告? | 论文未逐项区分 train/validate/test,使用时应假定为验证/测试性质。 |
| 能否直接作为 SOTA 比较基准? | 可以,但必须注明是二值、0.3 降采样、Patch U-Net 基线下。跨论文比较需核对预处理。 |
| 真实临床 POCT 表现? | 未评估。enriched dataset 策略下,空视野/稀疏视野表现未知(见 §3.4)。 |
| 多类性能如何? | 论文以形态特征投影(Fig. 4)做了可分性论证,但未公布逐类 Dice/F1 表,这是本数据集在基准完备性上最明显的缺口。 |
最后一行值得强调:多类分割缺乏公开的逐类基准数字,是 DeepUTI 作为"七类注释数据集"在可复现性上的最大短板。使用者在报告自己的多类结果时,会面临"没有官方 baseline 可对标"的困境。缓解方式是:以本文档 §5 给出的 Patch U-Net 配置自建基线,并在论文中说明这是自建而非官方。
§5 Bench:基线复现指引
本节把论文中散落在 Methods 各处的训练细节汇总为一份可执行的复现清单。目的不是替读者跑模型,而是让"从零复现 Table 2"这件事有明确的参数锚点,避免因某个超参不明而整段实验不可比。
5.1 完整预处理链
论文的预处理是固定顺序的四步,顺序不可调换:
- 重缩放(rescale):按选定因子(0.2 / 0.3 / 0.5 / 1.0)对原始 1392 × 1040、16-bit TIFF 做降采样。基线用 0.3。
- 切块(patch):将重缩放后的整图切分为 256 × 256 的 patch。
- 归一化(normalize):将像素值线性映射到 [−1, 1] 区间(而非常见的 [0, 1])。
- 增强(augment):训练时对 patch 随机施加水平翻转与垂直翻转。
几个易错点:
- [−1, 1] 而非 [0, 1]:这是与 Patch U-Net 实现配套的选择,若误用 [0, 1] 归一化,模型的输入分布与预训练权重不匹配,性能会异常。
- 翻转在 patch 级别、训练时在线施加:不是预先扩充数据集文件,而是在每个 epoch 的数据加载中随机变换。复现时若做成离线扩充,样本相关性会升高。
- 仅翻转、未做旋转/缩放/弹性形变:论文的增强策略是保守的。使用者在自建基线时若加了更多增强,结果将不可与 Table 2 直接比较——这是跨论文对比时的常见陷阱。
- 重缩放先于切块:若先切块再重缩放,边界处的对象会被切碎,且 patch 的物理尺度含义改变。
5.2 Patch U-Net 架构
论文的基线模型是 Patch U-Net,结构要点:
- 收缩路径(encoder):5 个卷积块。每个块内做卷积特征提取,块间以 2 × 2 max pooling、stride 2 下采样。
- 扩张路径(decoder):上采样时采用 2 × 2 卷积(转置卷积)使通道数减半,与收缩路径对应层特征拼接(skip connection)。
- 归一化:每个卷积块后接实例归一化(见 §4.2 的动机)。
- 输入/输出:输入 256 × 256 patch,输出同尺寸的分割图。
命名中的"Patch"指训练以 patch 为单位,而非整图——这是它能用 300 张图训练出可用模型的工程关键:一张 1392 × 1040 图在 0.3 倍率下可切出可观的 patch 数,等于把有效训练样本量放大了数量级。
5.3 损失函数
- 组合损失:BCE + Dice。
- 权重:α = β = 1,即两项等权相加。
- 动机:BCE(二元交叉熵)提供逐像素的稳定梯度,Dice 项直接优化区域重叠度,缓解前景/背景像素数严重不平衡(对象稀疏、背景占绝大多数)导致的"全判背景也能拿高准确率"问题。等权是经验选择,论文未做权重消融。
5.4 批次生成与空图过滤
论文对 batch 的生成有一处明确设计,容易被忽略:
- 空 patch 过滤判据:在构造训练 batch 时,对不含目标对象的 patch 设有过滤规则,避免全部由纯背景 patch 构成的 batch 稀释训练信号。
- 论文给出了基于掩码内容判断 patch 是否为"空"的具体判据,用于在采样时剔除或降低其权重。
这一设计的作用与 §3.4 的 enriched dataset 策略呼应:不仅在图像层面富集对象,还在 patch 层面继续过滤纯背景,确保每次梯度更新都包含有效监督信号。复现时若跳过这一步,会看到模型收敛变慢、且对前景的召回偏低。
5.5 训练超参数
以下是论文 Methods 中给出的完整训练配置:
| 参数 | 值 |
|---|---|
| 优化器 | Adam |
| 学习率 | 0.001 |
| 学习率调度 | 每 50 个 epoch 乘以 0.95 |
| L2 权重衰减 | 0.0001 |
| 总 epoch 数 | 750 |
| 每 epoch 采样数 | 1000 个随机样本 |
| batch size | 50 |
| 损失 | BCE + Dice(α = β = 1) |
| 归一化 | 实例归一化(每卷积块后) |
| 增强 | 随机水平/垂直翻转 |
按此配置:750 epoch × 1000 样本/epoch = 75 万个 patch 被看过;学习率从 0.001 经 15 次衰减(750 / 50)后约为 0.001 × 0.95¹⁵ ≈ 0.00046。这个配置的规模说明它不是"跑几分钟看看"的玩具设置,而是为收敛到 Table 2 指标所需的完整训练。
5.6 推理策略
- 重叠 patch 滑窗:推理时在整图上以重叠方式切 patch,对重叠区域取最大(max) 作为最终像素判决。
- 取最大而非平均的动机:在二值分割中,只要任一 patch 在重叠区判为前景,说明该处确有对象证据;取最大能提高对对象边缘的召回,避免被相邻纯背景 patch 的"平均值"拉低。代价是可能略微增加假阳性——与 4.1 中 "AUC 高、Dice 略低"的画像一致。
- 可与全分辨率推理组合:结合 §4.5 的结论,推理可直接在 1.0 分辨率图上做,步骤是"滑窗切 256 × 256(保持与训练一致的尺度)→ 逐 patch 预测 → 重叠区取最大 → 拼回整图掩码"。
5.7 软硬件环境
论文完整列出了复现所需的软件版本与训练硬件:
| 类别 | 配置 |
|---|---|
| Python | 3.10.8 |
| TensorFlow | 2.6.0 |
| Keras | 2.6.0 |
| keras-preprocessing | 1.1.2 |
| numpy | 1.19.5 |
| tensorboard | 2.6.0 |
| scikit-image | 0.18.1 |
| 其他 | tqdm、scipy、seaborn、scikit-learn |
| 本地开发机 | MacBook Pro M1 Max(10 核 CPU / 32 核 GPU) |
| 训练集群 A | HZDR HPC Hemera(Nvidia Tesla A100 40GB) |
| 训练集群 B | ZIH TU Dresden(NVIDIA A100-SXM4) |
两点提示:
- TensorFlow 2.6.0 / Keras 2.6.0 是较老的版本(TF 2.6 发布于 2021 年)。用新版 TF(2.15+)复现时,Keras 已拆分为独立包(Keras 3),API 有破坏性变更,需要额外的适配工作。若追求"零改动复现",建议用 conda/docker 锁定上述版本组合。
- 训练用了 A100:以 750 epoch、batch 50 的规模,在 M1 Max 上训练会相当慢;论文把最终训练放在 HZDR 与 ZIH 的 A100 集群上,说明本地机主要用于开发调试。使用者在规划算力时应以此为参照。
5.8 数据集划分与评估纪律
- 划分:train / validate / test 各 100 张图像(300 / 3)。
- 按患者划分:300 例患者,每例一图,因此 100/100/100 的图像划分等价于患者划分,不存在同一患者跨集泄漏。
- 稀类处理的用意:论文明确说明,采用"各 100 张"而非常见的大比例训练集,是为了缓解稀疏类别的欠代表问题——若按 8:1:1 划分,Large EPC sheet(全数据集仅 10 个对象)可能在 train 里一个都没有,导致该类完全无法学习。三分法虽然牺牲了训练样本量,但保证每一集都覆盖全部七类。
- 评估时的对读提醒:正因如此,test 集只有 100 张图,指标的标准误较大。报告多类指标时,对 Large EPC sheet(test 集内预计仅数个对象)的数值应给出置信区间或直接标注"样本不足,仅供参考"。
5.9 基准数字的对读卡片
为便于对标,把 §4 的关键数字集中如下:
| 基线 | 值 | 条件 |
|---|---|---|
| Dice(二值) | 0.877 | rescale 0.3,Patch U-Net,BCE+Dice |
| AUC(二值) | 0.989 | 同上 |
| Dice(二值,0.2 档) | 0.541 | rescale 0.2(性能断崖) |
| 最优先级降采样 | 0.3 | 训练用;推理可用 1.0 |
| 多类逐类指标 | 未公布 | 以 Fig. 4 形态可分性替代 |
使用者在论文中引用时,建议措辞为"在 DeepUTI 官方二值分割任务上,Patch U-Net 基线达到 Dice 0.877 / AUC 0.989(rescale 0.3)“——把"二值”"0.3 档"两个限定词写全,避免与多类任务混淆。
§6 获取、许可与资产分层
数据集的可用性不仅取决于「能不能下」,更取决于「下了之后能拿它做什么、不能做什么、要小心什么」。本节把 DeepUTI 的资产分成三层,逐层说明获取路径、许可边界与实操注意事项,最后给出与库内其他条目横向对读的「可获取性光谱」。
6.1 三层资产速览
DeepUTI 的交付物不是一个 zip 就完事,而是「数据 + 代码 + 论文」三件套,各自有独立的载体与许可。
| 层 | 内容 | 载体 | 许可 | 获取方式 |
|---|---|---|---|---|
| L1 数据 | 300 张尿液显微图像 + 3,562 个手工标注细胞 + train/validate/test 三划分(各 100 张) | Rodare 机构库(HZDR),ds1.zip |
CC-BY-4.0 | 开放直接下载,无需注册、无需 DUA、无需申请信 |
| L2 代码 | Patch U-Net 训练/推理管线、损失函数实现、批次生成器 | GitHub(论文配套仓库) | MIT | 公开仓库,可直接 fork/商用 |
| L3 论文 | 数据集描述与验证论文,含全部 Table/Fig 的支撑数据 | Scientific Data(Springer Nature) | CC BY 4.0 | 开放获取,PMC 全文可读 |
三层许可互不冲突,这是 DeepUTI 相对同类数据集的显著优势:数据最宽(CC-BY-4.0)、代码最宽(MIT)、论文最宽(CC BY 4.0),整条链路上没有一处需要逐案授权。相比之下,库内相当一部分临床数据集在「数据层」就已设限(请求制、DUA、仅限研究用途),DeepUTI 属于「政策最省心」的一档。
6.2 L1 数据层:DOI 体系与下载实操
DOI 双轨制。DeepUTI 的数据集采用「版本 DOI + 概念 DOI」双轨:
| DOI | 类型 | 指向 | 说明 |
|---|---|---|---|
10.14278/rodare.2473 |
版本 DOI | v1(2023-09-12 首发) | 引用具体版本时使用;v1 是论文发表时对应的版本 |
10.14278/rodare.2472 |
概念 DOI | record 2563,覆盖全部 3 个版本 | 引用「数据集本身」时使用,永远解析到最新版 |
Rodare 是 HZDR(Helmholtz-Zentrum Dresden-Rossendorf)运营的机构数据仓库,底层为 InvenioRDM。概念 DOI 与版本 DOI 的区分对复现工作至关重要——引用 v1 的 DOI 意味着锁定 2023-09-12 的快照,引用概念 DOI 则意味着接受最新版。写论文方法节时务必写清楚你用的是哪一个,否则读者按另一个 DOI 下载会得到字节数不同的文件。
下载实操。在 Rodare 记录页(record 2563)的文件区直接点击 ds1.zip 即可下载,无需登录。记录页同时提供 checksum 字段用于校验。
双口径校验存照。本条目在三个来源(Rodare 记录页、论文正文、torch-em 配套仓库)交叉核验时,发现同一文件名 ds1.zip 存在两个不同的字节数与 md5,这不是矛盾,而是版本差异:
| 口径 | 字节数 | md5 | 来源 |
|---|---|---|---|
| v1(2023-09-12) | 2,270,524,202 B | 47ce4c79a6529be2519f5d37b3162353 |
论文发表时对应版本 / v1 版本 DOI 页面 |
| 最新版 | 2,266,088,198 B | 07d94bb6b35c27bfb478fbeb54a4e992 |
concept DOI 解析到的当前最新版 |
两者相差 4,436,004 字节(约 4.23 MiB),约为 v1 体积的 0.195%。差异来源在 FACTS.md 中未能定位到具体的文件级改动清单(见 §10 坑点与遗留疑点),推测与仓库侧的重新打包或元数据文件调整有关。实践建议:下载后立刻 md5sum ds1.zip,与你引用的 DOI 口径核对;若不一致,说明你下的是另一个版本,需要在方法节里改口径。
SHA256 存照。torch-em 配套仓库对预处理后的数据给出了 SHA256:ae66af80c2c0d589c8fc6be21327988cf3ab2c2ed1ccaeadc5783b6e6dd51f95。注意这是 torch-em 在自身管线中生成/校验的数据产物哈希,不等价于 ds1.zip 本身的哈希,两者不可混用。做端到端复现时,建议同时记录三样:原始 zip 的 md5、解压后文件树的清单哈希、以及预处理产物的 SHA256。
6.3 L2 代码层与 L3 论文层
代码层(MIT)。论文配套代码以 Patch U-Net 的训练与推理为核心,包含自定义损失函数(BCE + Dice,α=β=1)、批次生成器(过滤空 patch)、以及评估脚本。MIT 许可意味着你可以把代码嵌进闭源产品、可以做商用、可以任意修改,唯一义务是保留版权声明。这比 GPL 系的传染性许可宽松得多。
值得注意的一个工程细节:代码与数据是通过 torch-em 生态关联的。torch-em 是一个深度学习方法在电子显微镜图像分析中的工具箱,DeepUTI 的类别映射在其中被固化为 {1: rod, 2: rbc_wbc, 3: yeast, 4: miscellaneous, 5: single_epc, 6: small_epc_sheet, 7: large_epc_sheet}。如果你的下游管线走 torch-em,这个整数映射就是必须严格遵守的契约——把标签 1 当成别的类别会导致静默的错误结果,且不会报错。
论文层(CC BY 4.0)。论文发表于 Scientific Data,是 Nature Portfolio 旗下专发数据集描述的期刊。发表信息全录:
| 项 | 值 |
|---|---|
| 期刊 | Scientific Data |
| 卷期页 | 11:155 |
| 发表日期 | 2024-02-01 |
| DOI | 10.1038/s41597-024-02975-0 |
| PMC | PMC10834944 |
| PMID | 38302487 |
| Received | 2023-06-14 |
| Accepted | 2024-01-09 |
从投稿到接收约 7 个月(Received 2023-06-14 → Accepted 2024-01-09),对一个带完整技术验证的数据集论文属于正常周期。CC BY 4.0 意味着论文的图表可以自由转载,这意味着你在自己的综述里直接复用 Fig 3/Fig 4 无需单独申请,只要标注出处。
6.4 AI-Ready 评估
「AI-Ready」不等于「有数据」,而是一组可被自动化管线直接消费的属性。按库内既有的 DAIMS 五维框架(D 可发现性 / A 可获取性 / I 互操作性 / M 可维护性 / S 可复用性)逐维评估:
| 维度 | 观察(事实层) |
|---|---|
| D 可发现性 | 双 DOI 注册(版本 + 概念)、PMC/PMID 齐全、期刊为 Scientific Data(数据集描述领域的高可见度平台)、Google Dataset Search 可索引 |
| A 可获取性 | 数据开放直接下载无需 DUA;代码 MIT 公开;论文 CC BY 4.0 开放获取;三层全部无门槛 |
| I 互操作性 | 图像为通用 16-bit TIFF,无需专有阅读器;标注为整数标签掩膜;类别映射在 torch-em 中有公开定义;但类别命名(如 miscellaneous)是自定的,与任何外部本体(如 SNOMED/LOINC)无映射 |
| M 可维护性 | 已有 3 个版本迭代记录,说明基础维护意愿;概念 DOI 保证长期解析;但 Rodare 是机构库,长期存续性依赖 HZDR 的承诺 |
| S 可复用性 | 划分固定(各 100 张)便于横向对比;但划分固定也意味着无法自定义交叉验证折;单中心单中心性队列(300 患者)限制外部效度 |
具体评分与综合评级见附录 B(DAIMS 评估表)。此处先记结论:DeepUTI 在 D/A 两维表现突出(开放程度属库内第一梯队),在 I/S 两维受限于自定类别体系与单中心队列,属「规格清晰但语义封闭」型资产。
6.5 与库内可获取性光谱对照
把 DeepUTI 放进库内已有条目的可获取性光谱中,能更清楚地看出它的位置。光谱按「获取门槛从低到高」排列:
| 档位 | 获取门槛 | 库内代表 |
|---|---|---|
| 一档:开放直下 | 无需注册/申请,点开就下 | DeepUTI(本条目)、MONUSEG、CIMA |
| 二档:开放但受限 | 免费但需接受条款/仅限非商用 | 部分病理/影像条目 |
| 三档:请求制 | 需提交申请信、等待审批、签署 DUA | PANDA、PANDA-plus |
| 四档:受控访问 | 需 IRB 证明、机构数据使用协议、物理隔离环境 | 部分临床敏感数据 |
DeepUTI 稳稳位于一档:CC-BY-4.0 全开放。这对「快速试验新想法」的场景极其友好——你不需要走任何审批流程就能拿到 300 张带像素级标注的尿液显微图像,这在医学影像领域是稀缺的。
但要提醒一个反直觉的点:开放不等于无风险。CC-BY-4.0 只约束版权,不约束伦理。DeepUTI 来自 300 位真实患者,虽然数据本身已去标识(图像层面不含直接标识符),但若你的下游用法可能构成对个体的重新识别或造成伤害,许可协议并不豁免你在伦理层面的责任。库内规范做法是:即便数据是 CC-BY,涉及临床数据时仍应在方法节声明数据来源与伦理豁免依据(DeepUTI 的伦理批号见 §3.1)。
§7 生态、影响与关联工作
7.1 学术发表与传播
DeepUTI 的传播路径是典型的「数据论文 + 机构仓库 + 代码仓库」三件套模式:
- 论文:Scientific Data 11:155,2024-02-01 上线。Scientific Data 的定位是「让数据集本身成为可引用的一等公民」,因此该刊论文的核心不是方法创新而是数据集的可验证性与可复用性论证。DeepUTI 的 Technical Validation 一节(对应本条目 §4)正是这种范式的体现。
- 数据:Rodare record 2563,3 个版本。版本迭代本身是传播健康的信号——有团队在持续维护它。
- 代码:GitHub 公开仓库,与 torch-em 生态打通。
7.2 资助背景与可持续性
论文 Funding 一节披露的资金来源,是判断数据集长期维护可能性的重要线索:
| 资助方 | 类型 | 含义 |
|---|---|---|
| CASUS | 机构(Center for Advanced Systems Understanding) | 数据密集型科学的研究中心,与 HZDR 生态紧密 |
| BMBF | 德国联邦教研部 | 国家级科研经费,通常为项目制(有明确起止) |
| SMWK | 萨克森州科学文化部 | 州级配套经费 |
| IUGA Basic Science Research Grant | 学会基础科学研究基金 | 国际妇科泌尿协会,说明临床来源的学术网络 |
| BIIG 慈善捐赠 | 慈善捐赠 | 项目制补充 |
| ScaDS.AI | 能力中心(德累斯顿/莱比锡 AI 中心) | 提供 AI 基础设施与方法支持 |
读懂这张表的关键:这笔资金的构成是「国家级 + 州级 + 学会 + 慈善 + AI 中心」的混合结构,以项目制为主。这暗示 DeepUTI 的长期维护(比如持续扩充样本、定期重打包)在经费层面没有稳定的制度性保障。结合概念 DOI 只覆盖 3 个版本这一事实,可以预判未来大概率不会出现「每年新增数百张」的持续扩张。
对使用者的实践含义:把 DeepUTI 当作一个「已定型的 300 张快照」来使用,而不是当作一个会持续生长的数据流。若你需要更多样本,不要指望它自动增长,应主动联系作者或寻找补充数据源。
7.3 关联工作与生态位
DeepUTI 在「尿液/尿沉渣显微图像分析」这个细分方向上处于一个特殊位置。要理解它的生态位,需看两头:
上游——临床尿检的标准流程。传统尿液分析依赖尿沉渣镜检或自动化尿沉渣分析仪,后者通常基于流式细胞术 + 图像,输出的是「细胞计数」而非「像素级分割标注」。DeepUTI 的差异点在于:它不做离心、不做染色,直接对未处理的尿液样本成像,且提供逐像素的多类标注。这使它更接近「原始显微镜视野的开放数据集」而非「商用分析仪的接口数据」。
下游——它启用的任务。因为标注是像素级的,DeepUTI 直接支持至少三类任务:
- 二值分割:尿沉渣前景 vs 背景(论文的主验证任务,Patch U-Net 在 0.3 降采样下 Dice 0.877);
- 多类语义分割:七类细胞的逐像素区分(数据支持,但论文未给出完整多类基线指标);
- 分类/检测:把标注掩膜转成检测框或图像级标签后做分类——但这属于派生任务,需要使用者自己定义转换规则(见 §2.4 的可转换性说明)。
生态位总结:DeepUTI 填补的是「开放、带像素级多类标注、未处理尿液显微图像」这个空位。它不是同类中样本量最大的,但它是在「开放性 × 标注粒度」这个二维上少见的组合——很多尿液数据集要么只给图像级标签,要么获取受控。
§8 方法学启示
DeepUTI 除可作为训练数据外,其构建与验证过程中的若干决策对做数据集的人和用数据集的人都有可迁移的启示。本节提炼五条,按「对生产方」与「对使用方」分类。
8.1 启示一:enriched dataset 的取舍要写进论文
采集策略上,DeepUTI 采用的是一种富集(enriched)采样:不是从 300 位患者中各随机抽 1 张,而是刻意让每个划分都有足够的稀类代表。论文明确说三划分各 100 张是为了缓解稀类(Yeast 41、Small EPC sheet 26、Large EPC sheet 10)的欠代表问题。
对生产方的启示:如果你的数据有长尾类别,纯随机划分会让稀类在某个划分里只剩个位数,导致指标不可信。富集采样是正解,但必须在论文里明确声明,否则使用者会误以为划分是随机的,进而用错误的统计假设。
对使用方的启示:富集采样意味着划分不代表自然患病率分布。Three 个划分中各 100 张并不反映「每 100 张尿液涂片里各有多少」的真实比例。因此:不要把 DeepUTI 的类别频率当作流行病学估计。要估计患病率,必须回到 §3.2 的人口学与临床统计(那些才是队列层面的数字)。
8.2 启示二:两段式标注(算法初标 + 人工精修)是可行范式
标注流水线是「ilastik 随机森林初标 → 人工逐像素精修 → 两位经验显微镜检师定类」。这个分工很有讲究:
- 像素级工作量外包给算法:ilastik 的随机森林先给出粗分割,人工只需修正边界,而不是从零涂;
- 语义判断留给人类专家:「这个细胞是酵母还是红细胞」这类需要形态学判断的问题,交给两位有经验的显微镜检师,且是多类定类(不是只判前景/背景);
- 两位标注者的作用:论文未给出标注者间一致性(inter-annotator agreement)的定量指标——这是一个可以提及的局限(见 §10 坑点),但双人机制至少提供了一道交叉校验。
对生产方的启示:纯人工标注像素级数据成本极高,算法初标 + 人工精修是性价比最优的折中。但要记录清楚:初标算法是什么、人工修正到什么粒度、有几个标注者、分歧如何裁决。
8.3 启示三:实例归一化是显微图像分割的普适坑
技术验证中最有教学价值的一条是归一化策略的影响。Patch U-Net 在训练/推理时若不做实例归一化,会出现「同一模型对某些整图全判前景、对另一些全判背景」的不稳定现象;引入实例归一化后该问题消失。
为什么这条有普适性:显微图像的每个视野(field of view)的照明、对比度、背景亮度差异很大,这些是图像级的差异,不是像素级的。若用整批统计量做归一化,模型会学到「每张图不同」而非「细胞长什么样」。实例归一化把每张图各自标准化,消除了这个混淆。
对使用方的启示:如果你在自己的数据上复现 Patch U-Net 却得到「全黑或全白」的输出,第一件事不是调学习率,而是检查归一化。这是 §10 中会重点列出的坑之一。
8.4 启示四:跨尺度推理比「训练分辨率」更关键
论文的一个反直觉发现:在 0.3 降采样上训练,但在全分辨率上推理,性能可以接受;而在 0.2 降采样上训练,Dice 骤降到 0.541。
这条揭示了两件事:
- 训练分辨率有下界:0.3 是可用下界,0.2 就崩了。原因是 0.2 降采样丢失了区分细胞所需的关键纹理信息(Fig 3c 展示了这种信息损失)。
- 训练与推理的分辨率不必相同:训练用降采样省显存/提速,推理回到全分辨率保精度,这是一条实用的工程技巧。
对使用方的启示:不要盲目追求「训练和推理同分辨率」的教条。如果你显存吃紧,可以考虑在略降采样上训练、全分辨率推理,但务必在你的数据上重扫一遍分辨率曲线,因为 0.3 这个下界是 DeepUTI 数据特有的,不能直接照搬到你的数据。
8.5 启示五:稀类要专门设计划分,不能靠运气
7 类中,Yeast(41)、Small EPC sheet(26)、Large EPC sheet(10)三个类合计只占 77/3562 ≈ 2.16%,其中 Large EPC sheet 只有 10 个实例。10 个实例意味着如果你做 3 折交叉验证,某些折里可能一个都没有。
对生产方的启示:稀类少于「折数 × 每折最少样本数」时,必须做分层划分(stratified split),否则指标在稀类上是噪声。
对使用方的启示:拿到 DeepUTI 后,若你的任务是七分类,不要直接报告稀类的逐类指标就完事——Large EPC sheet 只有 10 个实例,任何单个划分的性能数字都极不稳定。稳妥做法是:报告所有划分的逐类指标范围,或把稀类合并成「其他 EPC 片」再评估,并明确说明你做了这个合并。
§9 与库内条目的关系
9.1 家族图谱:DeepUTI 在六大家族中的位置
库内条目可按数据类型归为若干家族,DeepUTI 落在「显微与细胞图像」家族,但与「医学影像」「病理全切片」等家族有交集。下图梳理其亲缘关系:
医学显微与细胞图像家族
- CIMA(细胞学图像,多类细胞标注)——与 DeepUTI 最亲,同属「细胞级标注 + 分类/分割双任务」
- CytoImageNet(细胞图像预训练语料)——上游数据源性质,DeepUTI 可作为其下游下游任务评测集
- BBBC(Broad Bioimage Benchmark Collection,34 条目)——生物显微图像的经典基准集合,DeepUTI 的「胞类分割」任务与其中若干子集同构
- DeepUTI(本条目)——尿液显微、七类、像素级标注
病理全切片家族
- MONUSEG(30)——核分割基准,与 DeepUTI 的任务形式(实例/语义分割)最接近,但模态是 H&E 病理切片而非尿液镜检
- PANDA(27,560 张)——前列腺病理分级,规模上远超 DeepUTI,但任务是分级而非分割
- PANDA-plus(640 张,本库金标准条目)——PANDA 的精标子集,在「大规模弱标 + 小规模精标」的策略上与 DeepUTI 的「富集采样」有方法学对话
医学影像家族
- BraTS(24)——脑肿瘤 MRI 多模态分割,任务同为语义分割但模态差异极大
- LIDC-IDRI(19)——肺结节 CT,含多标注者一致性研究
- DeepLesion(17)——大规模病灶检测
- fastMRI(23)——MRI 重建,属逆问题而非分割
- OASIS(21)——脑 MRI 与临床变量关联
- TIGER(26)——病理/影像多任务基准
9.2 跨家族对照:DeepUTI 的定位
把 DeepUTI 与三类最相关的条目做直接对照:
| 对照项 | DeepUTI | MONUSEG | PANDA-plus | CIMA |
|---|---|---|---|---|
| 模态 | 尿液显微镜检(未处理样本) | H&E 病理全切片 | 前列腺穿刺病理 | 细胞学涂片 |
| 规模 | 300 图 / 3,562 细胞 | 约 1,000 视野 | 640 图 | 多类细胞图 |
| 标注粒度 | 像素级 + 七类 | 像素级(核实例) | 像素级 / 区域级 | 细胞级 |
| 类别数 | 7 | 1(核) | 分级标签 | 多类 |
| 获取门槛 | 一档(CC-BY-4.0 直下) | 一档 | 三档(请求制) | 一档 |
| 关键受限点 | 单中心、稀类极少 | 单一染色协议 | 需审批 | 规模与标注深度 |
读法:DeepUTI 与 MONUSEG 在「任务形式」上最像(都是显微视野的像素级分割),与 PANDA-plus 在「数据集构建策略」上最有对话空间(都面对长尾/分级不均衡),与 CIMA 在「细胞级多类标注」上最接近。但它在一个维度上是唯一的:模态是「未处理、未染色、未离心的新鲜尿液直接镜检」——这个模态在整个库内没有第二个条目与之完全重合。
9.3 建议互链点与检索路径
为便于读者在库内跳转,建议建立以下双向互链(括号内为库内条目编号,与 FACTS.md 建议一致):
| 编号 | 条目 | 互链理由 |
|---|---|---|
| 34 | BBBC | 同属生物显微图像基准,任务范式可类比 |
| 30 | MONUSEG | 任务形式最接近(显微视野像素级分割) |
| 31 | CytoImageNet | 细胞图像预训练语料,可构成上下游关系 |
| 26 | TIGER | 病理/影像多任务基准,评测口径可参照 |
| 32 | CIMA | 细胞级标注家族,分类/分割双任务同构 |
| 27 | PANDA | 大规模病理分级,长尾问题的方法学对照 |
| 560 | PANDA-plus | 精标子集构建策略对话,「富集 vs 随机」方法学互鉴 |
| 24 | BraTS | 医学语义分割的标杆任务,指标口径可对读 |
| 19 | LIDC-IDRI | 多标注者一致性问题的方法学参照 |
| 17 | DeepLesion | 大规模病灶检测,规模化数据构建经验 |
| 23 | fastMRI | 医学图像逆问题,任务类型差异对照 |
| 21 | OASIS | 影像 + 临床变量关联,队列描述范式参照 |
检索路径建议(从 DeepUTI 出发可走的三条线):
- 任务线:DeepUTI → MONUSEG → BraTS → LIDC-IDRI(都是医学语义/实例分割,可对比不同模态下的分割方法迁移性)
- 数据构建线:DeepUTI → PANDA-plus → PANDA → DeepLesion(从小规模精标到大 k 规模弱标的光谱)
- 细胞图像线:DeepUTI → CIMA → CytoImageNet → BBBC(细胞级标注任务在细胞学、生物显微、基准集合间的演化)
三条线覆盖了「方法—数据—任务」三个维度,读者可依自身需求选择入口。
§10 避坑清单(8 条实战经验)
以下八条是使用 DeepUTI 时最常踩、也最容易让实验结果失真或结论误读的问题。每条按「现象 → 成因 → 对策」的组织方式给出,尽量落到可执行动作。
坑 1:把 ds1.zip 的双口径字节数当成同一份文件
- 现象:你在不同时间、不同页面下载
ds1.zip,得到两个体积——v1 为 2,270,524,202 字节、md547ce4c79a6529be2519f5d37b3162353;最新版为 2,266,088,198 字节、md507d94bb6b35c27bfb478fbeb54a4e992。两者相差约 4.23 MiB(约 0.195%)。 - 成因:RODARE 记录的 concept DOI(10.14278/rodare.2472,record 2563)下共挂 3 个版本。仓库更新了某个文件或压缩方式,导致包体积与校验和变化,但页面未给出逐文件 changelog。差异极小,肉眼与常规抽样都察觉不到,容易误以为「下载的是同一个东西」。
- 对策:论文与第三方工具链(如 torch-em)实际锁定的是 v1(10.14278/rodare.2473)。复现论文 Table 2 数字必须锁死 v1 及其 md5;若使用最新版,须在实验记录中显式写明版本与 md5,禁止跨版本混用同一份评估结果。把 md5 写进实验配置文件的注释行,是最便宜的保险。
坑 2:稀类(Large EPC sheet 仅 10 个实例)导致逐类指标剧烈抖动
- 现象:做多类分割评估时,
large_epc_sheet类在某个随机种子上 Dice 可能是 0.8,换个种子掉到 0.3 甚至 0.0——因为你只在评 10 个实例,其中两三个的预测边界差一点,均值就大幅摆动。 - 成因:七类分布极度长尾:Rod 1,697 / RBC-WBC 1,056 / Miscellaneous 550 / Single EPC 182 / Yeast 41 / Small EPC sheet 26 / Large EPC sheet 10。最稀类只占全库的 0.28%。任何基于该类小样本的逐类指标都缺乏统计稳定性。
- 对策:报告逐类指标时必须并列绝对实例数,并同时给出「整体准确率 / 宏平均 / 微平均」三口径;对稀类结论标注「n=10,仅供观察」。若方法对稀类敏感,考虑分层重采样或类别加权损失,并在文中说明——不要用单一稀类指标去论证方法优劣。
坑 3:把 enriched 采样的类分布误当作自然患病率
- 现象:有人看到 Rod 占 47.7%、Miscellaneous 占 15.4%,就推断「UTI 门诊里近半数是杆菌感染」。这个推论是错的。
- 成因:这是一个为训练价值而被人为富集(enriched)的样本集合。构建者刻意挑选了形态多样、类别覆盖更全的视野,而非按自然分布随机抽样。论文明确说明富集策略是为了让模型见到更丰富的类别组合,这直接牺牲了患病率代表性。
- 对策:类分布只能读作「训练集的类别构成」,绝不能外推为流行病学患病率。若需要自然分布估计,应另取按顺序连续采集的样本,或回到原始门诊队列统计,而不是复用一个刻意均衡过的数据集。
坑 4:缺少实例归一化(instance normalization)导致模型全判前景或全判背景
- 现象:训练的第一个 epoch 内,模型输出要么整幅为前景、要么整幅为背景,损失居高不下,看起来像数据加载坏了。
- 成因:输入图像的强度统计跨样本差异很大(不同采集时段、不同光照、不同细胞密度),若不做逐实例归一化,网络在第一个卷积层就会面对分布漂移的输入,BatchNorm 在 patch 级别的小 batch 下也不稳定。
- 对策:按论文设置,预处理链为:先做 rescale(0.2 / 0.3 / 0.5 / 1 等档位)→ 切 256×256 patch → 逐实例归一化到 [−1, 1]。instance normalization 是这条流水线的必需环节,不是可选项。若换框架重写,务必确认归一化发生在每个 patch 内部,而非全数据集统计。
坑 5:用 0.2 倍降采样训练却期待 0.877 的 Dice
- 现象:照搬超参但把预处理分辨率改成 0.2,得到 Dice 0.541,与论文声称的 0.877 相差甚远,于是怀疑复现失败。
- 成因:论文的分辨率扫描显示,0.2 档 Dice 只有 0.541、IoU 0.278、Precision 0.431——低分辨率下细胞边界信息被大量丢弃,模型倾向于「宁可多报」从而 Recall 高(0.799)但 Precision 崩。0.877 是 0.3 档的成绩。
- 对策:0.3 是精度与显存的甜点档(Dice 0.877 / AUC 0.989)。要做高保真推理,用「0.3 降采样训练 + 全分辨率推理」的组合策略。改档位时必须重跑评估,不要跨档位引用指标。
坑 6:误配 torch-em 的整数类别映射(1=rod … 7=large_epc_sheet)
- 现象:用 torch-em 的 urinary tract loader 载入多类掩码,发现颜色图例与类别名对不上,或者把
yeast的预测当成miscellaneous。 - 成因:多类掩码用整数像素值编码类别,0 为背景,1–7 依次为 rod、rbc_wbc、yeast、miscellaneous、single_epc、small_epc_sheet、large_epc_sheet。这个顺序是契约,不是按类别首字母或频率排的——rod 排第 1,yeast 排第 3,miscellaneous 反而排第 4。凭直觉假设顺序必然错位。
- 对策:在任何可视化、评估或转换脚本里,把 CLASS_NAMES 映射硬编码为常量并加注释,禁止依赖「数组下标即类别序」的隐式假设。做类别混淆矩阵时,先断言类别数 = 7 且映射表与官方一致再跑。
坑 7:把 SHA256 当成 ds1.zip 的校验和
- 现象:你手上有
ae66af80c2c0d589c8fc6be21327988cf3ab2c2ed1ccaeadc5783b6e6dd51f95,拿它去校验下载的ds1.zip,结果不匹配,以为文件损坏。 - 成因:这个 SHA256 出自 torch-em 的工具链页面,对应的是该 loader 期望的预处理产物(或其内部引用),并非 RODARE 上
ds1.zip原始包的 md5。原始包的权威校验是 md5(v1 与最新版各一个,见坑 1),两者口径不同、算法也不同,本就不可互比。 - 对策:校验原始下载包用 md5(锁定版本);需要与 torch-em 对齐时用 SHA256,但先确认该 SHA256 描述的对象究竟是原始包还是转换后产物。两种校验和分属两个层次,写文档时必须标明各自对应物。
坑 8:以为 CC-BY-4.0 就等于可以无障碍使用,忽略伦理责任
- 现象:看到数据集 CC-BY-4.0、代码 MIT、论文 CC BY 4.0,就默认「随便用、可用于任何商业产品、无需任何额外说明」。
- 成因:三层许可(数据 CC-BY-4.0 / 代码 MIT / 论文 CC BY 4.0)只解决版权层面的授权。但这是真实患者来源的临床显微镜图像,其采集受英国 HRA 与 HCRW 批准约束(IRAS 295252、protocol 143470、REC reference 22/WA/0069)。许可协议不会、也不能豁免研究伦理与数据治理责任。
- 对策:使用前确认自身用途落在原始伦理批准范围内;衍生模型用于临床决策支持时,须另行走本地伦理审查与合规评估。署名义务(CC-BY 要求注明来源与许可)与伦理审查是两条独立的合规线,满足其一不等于满足全部。
一句话总括:DeepUTI 的坑大多源自分层——数据分层(双版本 / 三层许可)、统计分层(富集 vs 自然)、尺度分层(分辨率档位)、编码分层(整数类别 / 两种校验和)。每次引用一个数字前,先问「它属于哪一层」,八个坑至少能避开一半。
§11 总结
11.1 三句话读懂 DeepUTI
- 它是什么:一个由临床真实尿液显微图像构成的、带七类像素级手工标注的开放数据集——300 张图像、3,562 个手工标注细胞,采集自 2022 年 4 至 8 月的门诊自然排尿样本。
- 它独特在哪:模态是「未处理、未染色、未离心的新鲜尿液直接镜检」——整个千方病案医数集里没有第二个条目与之完全重合,直指 UTI 即时检验(POCT)这一真实临床缺口。
- 它给了什么:数据(CC-BY-4.0)、代码(MIT,含 Patch U-Net 基线)、论文(CC BY 4.0)三件套全开放,配一个可复现的语义分割基准(0.3 分辨率 Dice 0.877 / AUC 0.989),并留有清晰的 AI-Ready 改进空间。
11.2 谁适合用它
| 角色 | 适配理由 |
|---|---|
| 医学图像分割研究者 | 现成的像素级多类标注 + 明确的分割任务定义 + 官方基线,可直接做新架构的对照评测 |
| 细胞/微生物图像分析者 | 七类形态学差异清晰的细胞类别,适合验证实例分割、细胞计数、形态学表征方法 |
| POCT / 床旁诊断算法团队 | 数据模态与实际床旁镜检一致,是少有的「临床现场模态」训练素材 |
| 数据集方法学研究者 | 「富集采样」「两段式标注」「分层划分」等构建决策均可作为方法学研究对象 |
| 医学 AI 教学场景 | 规模适中(约 2.27 GB)、类别直观、许可宽松,适合课堂与教程级实验 |
11.3 谁不适合(或需谨慎)用它
| 场景 | 为何不合适 |
|---|---|
| 想估计 UTI 自然患病率 | 富集采样破坏了自然分布,类比例不可外推 |
| 想做跨中心泛化验证 | 单中心(伦敦一处门诊)、300 患者队列,外部效度受限 |
| 需要严格标注者间一致性指标 | 论文未给出 inter-annotator agreement 的定量数字 |
| 想把结果直接当临床诊断依据 | 这是研究数据集,未经临床验证与监管审批,禁止直接临床决策 |
| 需要染色/离心后的标准尿沉渣图 | 本数据集刻意采用未处理新鲜样本,与临床实验室沉渣流程不同 |
11.4 三十秒决策卡
- 能用:像素级分割、细胞分类、形态学分析、POCT 算法原型、教学。
- 要小心:逐类指标(稀类 n 很小)、跨中心泛化、患病率推断。
- 要先做:锁定
ds1.zip版本与 md5 → 对齐类别映射 → 上 instance normalization → 选 0.3 档。 - 别忘:三层许可 ≠ 伦理豁免;引用须注明来源与 CC-BY-4.0。
FAQ 常见问题(52 问)
A. 基础认知
A1. DeepUTI 是什么?
一个临床尿液显微图像数据集,含 300 张图像与 3,562 个手工标注细胞的像素级七分类注释,配套开源代码与一篇 Scientific Data 论文,目标是推动深度学习 UTI 诊断测试的开发。
A2. DeepUTI 和 UMOD 是同一个东西吗?
是。官方论文与 BibTeX 用 “DeepUTI”,GitHub 仓库与 torch-em 工具链用 “UMOD”(Urine Microscopy Open Dataset 缩写)。条目须并列标注两个名字以防检索撞库。
A3. 它是谁做的?
UCL 的膀胱感染与免疫研究组(BIIG)牵头,联合 CASUS(HZDR Görlitz)与 University of Wrocław。通讯作者为 Artur Yakimovich 与 Harry Horsley。
A4. 它解决什么临床问题?
尿路感染(UTI)诊断。现行依赖培养或常规尿检,耗时或需实验室条件;床旁(POCT)快速诊断长期缺乏足够好的自动化方案,而深度学习需要高质量标注数据——本数据集正是为填补这一缺口。
A5. 为什么选尿液镜检这个模态?
尿液镜检是临床最古老、最廉价、最容易床旁化的检查之一。图像直接来自自然排尿样本的明场透射光宽场成像,与真实床旁场景一致,避免了离心、染色等流程带来的模态偏移。
A6. 「AI-Ready」在这里指什么?
指数据集是否具备让 AI 研究可直接、可靠使用的条件——包括标注质量、任务定义、划分规范、许可证清晰度、复现指引、以及已知限制的透明披露。DeepUTI 在这些维度上表现良好,但仍有可改进之处。
A7. 数据集现在还在维护吗?
数据集本体在 RODARE 上挂有 3 个版本(concept DOI 10.14278/rodare.2472)。GitHub casus/UMOD 仓库最后可见提交为 2025-05-21,说明仍有一定维护活动。
A8. 数据先行还是论文先行?
数据先行。RODARE v1 于 2023-09-12 发布,论文于 2024-02-01 见刊,相差约 5 个月。这一时间差是理解引用关系(论文引用数据集 DOI)的背景。
B. 数据与获取
B1. 数据有多少张图?
300 张。
B2. 标注了多少个细胞?
3,562 个手工标注细胞。
B3. 有哪些类别?分布如何?
七类:Rod 1,697 / RBC-WBC 1,056 / Miscellaneous 550 / Single EPC 182 / Yeast 41 / Small EPC sheet 26 / Large EPC sheet 10,合计恰好 3,562。
B4. 图像分辨率与位深?
1392 × 1040 像素,16-bit 彩色 TIFF。
B5. 目录怎么组织?
三个根文件夹:img/(原图)、bin_mask/(二值掩码)、mult_mask/(多类掩码),各含 300 个 TIFF 文件。
B6. 数据集体积多大?
ds1.zip 约 2.27 GB。v1 为 2,270,524,202 字节,最新版为 2,266,088,198 字节。
B7. 数据集的 DOI 是什么?
版本 DOI 10.14278/rodare.2473(v1);concept DOI 10.14278/rodare.2472(record 2563)。下载直链形如 https://rodare.hzdr.de/record/2473/files/ds1.zip。
B8. 许可是什么?
数据集本体 CC-BY-4.0。
B9. 代码在哪、什么许可?
GitHub casus/UMOD,MIT License。
B10. 论文在哪、什么许可?
Scientific Data 11:155 (2024),DOI 10.1038/s41597-024-02975-0,PMC10834944 / PMID 38302487,CC BY 4.0。
B11. 我需要申请才能下载吗?
不需要。数据集为开放获取直链下载。但临床用途仍受原始伦理批准范围约束。
B12. 怎么校验下载完整性?
用 md5 校验 ds1.zip:v1 为 47ce4c79a6529be2519f5d37b3162353,最新版为 07d94bb6b35c27bfb478fbeb54a4e992。注意锁定版本——两者是不同文件。
B13. 那个 SHA256 是什么?
ae66af80c2c0d589c8fc6be21327988cf3ab2c2ed1ccaeadc5783b6e6dd51f95 出自 torch-em 工具链,对应其预处理产物层次,不是 ds1.zip 原始包的校验和。
B14. 有官方数据加载器吗?
有。torch-em 提供 urinary tract 的 loader,含 CLASS_NAMES 映射。
C. 统计与发现
C1. 样本来自哪、多少人?
来自伦敦一处 LUTS 专科门诊(Whittington Health NHS Trust)的自然排尿样本,共 300 名患者。
C2. 患者人口学特征?
平均年龄约 42 ± 15 岁,95.1% 为女性。
C3. 采集时间跨度?
2022 年 4 月至 8 月。
C4. 类分布能说明患病率吗?
不能。这是为训练价值刻意富集的集合,类比例不代表自然患病率。
C5. 哪个类最多、哪个最少?
最多是 Rod(1,697,约 47.7%),最少是 Large EPC sheet(10,约 0.28%)。
C6. 为什么 RBC 和 WBC 合并成一类?
这类数据集关注的是「有无感染相关细胞」,红白细胞在明场镜检下的形态区分对诊断价值有限,合并可以降低标注歧义、提高一致性。
C7. 上皮细胞为什么分成三类?
按形态分层:单个上皮细胞(Single EPC)、小片状(Small EPC sheet)、大片状(Large EPC sheet)。片状结构在形态上与单个细胞差异大,单列有助于模型学习不同尺度。
C8. 为什么划分是三等分而不是 70/20/10?
为缓解类别欠代表问题,刻意让训练/验证/测试各 100 张,使各子集都有机会见到稀类,而非让测试集因体量过小而漏掉重要类别。
C9. 有标注者间一致性(IAA)指标吗?
论文未给出 IAA 的定量数字。这是一个已知的可改进点。
C10. 单中心数据有什么局限?
采集设备、光照、患者群体、操作习惯都绑定单一中心,模型跨中心泛化能力未经验证。
C11. 背景里有干扰物吗?
有。背景包含细胞碎片与严重失焦的颗粒,这是真实镜检视野的常态,也是分割困难的一部分。
D. 基准与复现
D1. 官方基线是什么模型?
Patch U-Net,配随机 patch 生成器与实例归一化。
D2. 基准数字是多少?
二值分割、0.3 分辨率:Dice 0.877 / IoU 0.452 / Precision 0.890 / Recall 0.920 / AUC 0.989。
D3. 分辨率各档成绩如何?
0.2 → Dice 0.541;0.3 → 0.877;0.5 → 0.864;1 → 0.875。0.3 最优。
D4. 为什么 0.2 档骤降?
过度降采样丢弃了细胞边界细节,模型倾向多报(Recall 0.799 高但 Precision 0.431 低),导致 Dice 坍塌。
D5. 损失函数怎么设?
BCE + Dice 组合,权重 α = β = 1。
D6. 优化器与学习率?
Adam,初始 lr 0.001,每 50 个 epoch 指数衰减 0.95,L2 weight decay 0.0001。
D7. 训练多久?
750 个 epoch,每 epoch 采样 1000 个随机样本,batch size 50。
D8. 训练硬件是什么?
MacBook Pro M1 Max;算力机构侧涉及 HZDR 的 Hemera HPC(Nvidia Tesla A100 40GB)与 TU Dresden ZIH(NVIDIA A100-SXM4)。
D9. 软件环境?
Python 3.10.8 / TensorFlow 2.6.0 / Keras 2.6.0。
D10. 预处理链是什么?
rescale(0.2/0.3/0.5/1)→ 切 256×256 patch → 逐实例归一化到 [−1, 1]。
D11. 推荐的推理策略?
「0.3 降采样训练 + 全分辨率推理」——训练省显存,推理保边界。
D12. 空 patch 怎么处理?
批次生成中过滤全背景的空图,避免模型被大量无信息样本稀释梯度。
E. 生产与库内关系
E1. 适合做实例分割吗?
数据提供的是语义分割掩码,但多类掩码含类别信息,可通过后处理(连通域 + 分类)扩展为实例级任务。这不是官方任务定义,须自行验证。
E2. 能做细胞计数吗?
可以。类别掩码经连通域分析可得逐类计数,但计数精度受分割质量与粘连细胞影响。
E3. 与尿沉渣数据集的区别?
尿沉渣数据集通常基于离心沉淀、染色或相差成像;DeepUTI 用未离心、未染色的新鲜样本明场成像,模态更贴近床旁现场。
E4. 和 MONUSEG 什么关系?
任务形式最接近——都是显微视野的像素级分割。但模态(尿液 vs 组织切片)、类别体系、临床目标均不同。
E5. 和 PANDA-plus 有什么可比性?
在数据集构建策略上最有对话空间:两者都面对长尾/不均衡,PANDA-plus 的精标子集策略与 DeepUTI 的富集采样可作为「不同取舍」的互鉴样本。
E6. 和 CIMA 呢?
都是细胞级标注,但 CIMA 是 CODEX 高维空间成像,DeepUTI 是明场透射光;任务上同构(分类 + 分割)但模态差异大。
E7. 为什么建议和 BBBC 互链?
同属生物显微图像基准,任务范式可类比,读者可在两个基准间对比方法迁移性。
E8. 库内有别的尿液数据集吗?
没有。DeepUTI 是库内唯一以尿液镜检为模态的条目,这也是它的独特价值所在。
E9. 可以用来做预训练吗?
可以,但规模较小(300 图),更适合做下游微调或自监督预训练的小型语料,而非大规模预训练的主力。
E10. 论文的数字可以跨版本引用吗?
不可以。必须锁定 v1(DOI 10.14278/rodare.2473)。
F. 复现与工程细节
F1. 复现失败最常见的原因是什么?
缺实例归一化(全判前景/背景)、用错分辨率档位、类别映射错位三分天下。
F2. 需要多少显存?
论文在消费级 MacBook Pro M1 Max 上可训练,说明 0.3 档 + patch 训练显存需求不高;高分辨率推理更吃显存。
F3. 能否在 PyTorch 里复现?
可以。网络结构简单,关键是照搬预处理链(含 instance normalization)与损失组合。
F4. 类别映射具体是什么?
{1: rod, 2: rbc_wbc, 3: yeast, 4: miscellaneous, 5: single_epc, 6: small_epc_sheet, 7: large_epc_sheet},0 为背景。
F5. 为什么类别顺序这么反直觉?
整数编码不等于优先级或频率排序。把它当契约常量处理,不要凭直觉。
F6. 二值掩码和多类掩码什么关系?
二值掩码(前景/背景)可由多类掩码二值化得到;反之不可,因为多类掩码含类别信息。训练二值任务时可直接用 bin_mask/。
F7. Patch 尺寸为什么是 256?
论文采用 256×256。该尺寸在显存、上下文信息与 batch 效率间取得平衡。
F8. 稀类该怎么处理?
可考虑类别加权损失、过采样或分层重采样,但须在评估时说明处理方式,避免与未处理的基线数字混比。
F9. 怎么处理失焦/碎片背景?
视为真实分布的一部分,不做人工剔除;若做剔除,须在文中声明并评估对指标的影响。
F10. 复现时如何与官方数字对齐?
锁 v1 → 用官方划分(train/validate/test 各 100)→ 照搬预处理与超参 → 在 0.3 档评估 → 对比 Dice 0.877 / AUC 0.989。
F11. 有交叉验证方案吗?
官方未提供多折交叉验证,仅给固定划分。若需 CV,须自行重划并说明稀类的分层处理。
F12. 复现结果比论文低一点正常吗?
在小规模、长尾数据集上,随机种子与框架差异会带来几个点的波动。先确认预处理与映射无误,再考虑统计显著性,不要在未对齐流水线前就归因于方法。
事实清单
以下为全条目的硬数字与事实摘要,均可回溯至 FACTS.md 对应小节与原始来源。凡出现「约」「官方口径」等限定词处,表示该数字取决于你所用资产版本。
数据集本体
| 项目 | 数值 | 出处 |
|---|---|---|
| 显微图像总数 | 300 张 | 数据集官方说明 / 论文正文 |
| 手工标注细胞总数 | 3,562 个 | 逐类计数求和 |
| 注释类别数 | 7 类 | 官方类别定义 |
| 单张图像分辨率 | 1392 × 1040 | 官方规格 |
| 位深 | 16-bit TIFF | 官方规格 |
| 采集时段 | 2022-04 至 2022-08 | 论文方法节 |
| 患者数 | 300 人 | 论文方法节 |
| 平均年龄 | 42 ± 15 岁 | 论文方法节 |
| 女性占比 | 95.1% | 论文方法节 |
| train / validate / test | 各 100 张 | 官方划分说明 |
七类分布
| 类名 | 临床含义 | 实例数 |
|---|---|---|
| Rod | 杆菌 | 1697 |
| RBC-WBC | 红细胞与白细胞 | 1056 |
| Miscellaneous | 杂项 | 550 |
| Single EPC | 单个上皮细胞 | 182 |
| Yeast | 酵母样真菌 | 41 |
| Small EPC sheet | 小片上皮细胞团 | 26 |
| Large EPC sheet | 大片上皮细胞团 | 10 |
| 合计 | — | 3562 |
语义分割基准(论文 Table 2 分辨率扫描)
| 像素分辨率档 | Dice | IoU | Precision | Recall | AUC |
|---|---|---|---|---|---|
| 0.2 | 0.541 | — | — | — | — |
| 0.3 | 0.877 | 0.452 | 0.890 | 0.920 | 0.989 |
| 0.5 | 0.864 | — | — | — | — |
| 1.0 | 0.875 | — | — | — | — |
训练配置
| 项目 | 数值 |
|---|---|
| 优化器 | Adam |
| 初始学习率 | 0.001 |
| 学习率衰减 | 每 50 epoch × 0.95 |
| L2 正则 | 0.0001 |
| 总 epoch | 750 |
| 每 epoch 样本 | 1000 |
| batch size | 50 |
| 损失函数 | BCE + Dice,α = β = 1 |
| 软件栈 | Python 3.10.8 / TensorFlow 2.6.0 / Keras 2.6.0 |
| 硬件 | MacBook Pro M1 Max |
资产与标识
| 项目 | 值 |
|---|---|
| 数据集 DOI(v1) | 10.14278/rodare.2473 |
| 数据集 concept DOI | 10.14278/rodare.2472 |
| Rodare record | 2563(共 3 个版本) |
| v1 发布日期 | 2023-09-12 |
| 论文 DOI | 10.1038/s41597-024-02975-0 |
| 论文出处 | Scientific Data 11:155(2024-02-01) |
| PMC / PMID | PMC10834944 / 38302487 |
| 论文 Received / Accepted | 2023-06-14 / 2024-01-09 |
| 数据集许可 | CC-BY-4.0 |
| 代码许可 | MIT |
| 论文许可 | CC BY 4.0 |
| 伦理批件 | IRAS 295252 / protocol 143470 / REC 22/WA/0069 |
双口径存照(同一文件名,两个版本,两个字节数)
| 口径 | 字节数 | MD5 |
|---|---|---|
| v1(record 2563 v1) | 2,270,524,202 | 47ce4c79a6529be2519f5d37b3162353 |
| 最新版 | 2,266,088,198 | 07d94bb6b35c27bfb478fbeb54a4e992 |
另有一条独立校验值:SHA256 ae66af80c2c0d589c8fc6be21327988cf3ab2c2ed1ccaeadc5783b6e6dd51f95,此为 torch-em 侧校验记录,不等于 ds1.zip 的校验和。
torch-em 类别整数映射
| 整数 | 类名 |
|---|---|
| 1 | rod |
| 2 | rbc_wbc |
| 3 | yeast |
| 4 | miscellaneous |
| 5 | single_epc |
| 6 | small_epc_sheet |
| 7 | large_epc_sheet |
术语表
UTI(Urinary Tract Infection,尿路感染):由细菌等病原体引起的泌尿系统感染,临床常见且复发率高。尿沉渣显微镜检查是其一线辅助诊断手段,本数据集的采集场景即源于此。
POCT(Point-of-Care Testing,床旁检验):在患者近旁而非中心实验室完成的检测。POCT 尿沉渣自动分析是本数据集的核心应用动机之一。
LUTS(Lower Urinary Tract Symptoms,下尿路症状):尿频、尿急、排尿困难等下尿路相关症状的统称,是触发尿检的常见临床指征。
EPC(Epithelial Cell,上皮细胞):尿沉渣中常见的细胞类型,分为单个细胞与细胞团(sheet)两种形态;在本数据集中拆为 Single EPC、Small EPC sheet、Large EPC sheet 三类。
RBC-WBC:红细胞(Red Blood Cell)与白细胞(White Blood Cell)的合并类。本数据集将二者作为一个联合标注类,而非分开建模。
Rod(杆菌):杆状细菌,尿路感染的重要病原形态学线索。
Yeast(酵母样真菌):尿沉渣中可见的真菌形态,常与念珠菌感染相关。
Miscellaneous(杂项):不属于上述类别的其他有形成分,作为兜底类存在。
Patch U-Net:以图像分块(patch)为输入单元的 U-Net 变体,是论文给出的语义分割基线架构。
Instance normalization(实例归一化):一种对单个样本、单个通道做归一化的技术,与 batch normalization 不同。本数据集中它是分辨率鲁棒性的关键前提。
Dice 系数:分割任务常用重合度指标,2|A∩B| / (|A|+|B|),取值 0–1,越接近 1 越好。
IoU(Intersection over Union,交并比):|A∩B| / |A∪B|,与 Dice 单调相关但对低重合更敏感。
Precision / Recall:精确率(查准)与召回率(查全)。医学筛查场景中二者需权衡,本数据集报告 P 0.890 / R 0.920 属召回略优。
AUC:ROC 曲线下面积,本数据集报 AUC 0.989,表征阈值无关的分类判别力。
DAIMS:数据资产成熟度评估框架,按 D(可发现)、A(可访问)、I(可互操作)、M(可复用/元数据)、S(可持续)五维打分。本条目 §6.4 给出五维观察表。
Rodare:德国 HZDR 运营的机构级研究数据仓库,本数据集托管于此。
torch-em:基于 PyTorch 的电子显微/生物图像分割工具库,本数据集提供其类别映射约定。
概念 DOI(concept DOI):指向某数据集全部版本集合的持久标识;与指向单个版本的版本 DOI 对照使用。
附录 A:来源三源互证表
| 事实类别 | 来源一(数据集仓库) | 来源二(论文) | 来源三(代码库) | 一致性 |
|---|---|---|---|---|
| 图像数与分辨率 | 官方说明 | 方法节 | 加载器默认 | 一致 |
| 七类与分布 | 官方说明 | 结果节 | CLASS_NAMES | 一致 |
| 划分方式 | 官方说明 | 方法节 | 划分脚本 | 一致 |
| 许可条款 | 数据集页 | 论文声明 | — | 一致 |
| 类别整数映射 | — | — | 映射常量 | 唯一来源 |
| 校验值双口径 | 下载记录 | — | SHA256 记录 | 口径并存 |
| 伦理批件 | 数据集页 | 论文声明 | — | 一致 |
附录 B:双口径存照详表
| 字段 | v1 | 最新版 |
|---|---|---|
| 文件名 | ds1.zip | ds1.zip |
| 字节数 | 2,270,524,202 | 2,266,088,198 |
| MD5 | 47ce4c79a6529be2519f5d37b3162353 | 07d94bb6b35c27bfb478fbeb54a4e992 |
| 差值 | — | 较 v1 少 4,436,004 字节 |
读法:两个口径都合法,取决于你下载的是哪个版本。论文发表时的口径是 v1。若你的校验值与两者都不符,先核对 record 版本号,再考虑传输损坏。
附录 C:类别映射契约表
| 论文文本类名 | torch-em 整数 | 代码常量名 |
|---|---|---|
| Rod | 1 | rod |
| RBC-WBC | 2 | rbc_wbc |
| Yeast | 3 | yeast |
| Miscellaneous | 4 | miscellaneous |
| Single EPC | 5 | single_epc |
| Small EPC sheet | 6 | small_epc_sheet |
| Large EPC sheet | 7 | large_epc_sheet |
注意:整数从 1 开始而非 0,背景通常置 0。若你的标签读入后出现整体偏移一类,多半是漏减或误加了 1。
附录 D:DAIMS 五维评估表
| 维度 | 观察结论 | 评级依据 |
|---|---|---|
| D 可发现 | 有 DOI 与专有页面,可被检索到 | 版本 DOI + 概念 DOI 双轨 |
| A 可访问 | 开放下载,无账户门槛 | CC-BY-4.0 下公开分发 |
| I 可互操作 | 标准 TIFF 位深,类别映射有约定 | 16-bit TIFF + torch-em 契约 |
| M 可复用 | 有完整许可、引用方式与训练配置 | 论文给出超参与基线 |
| S 可持续 | 托管于机构仓库,有版本化机制 | Rodare 3 版本 + concept DOI |
综合:五维齐备,属高成熟度开放数据集,短板在稀类实例数过少(可复用性在少数类上打折)。
附录 E:伦理与合规速查表
| 项目 | 值 |
|---|---|
| IRAS 编号 | 295252 |
| Protocol 编号 | 143470 |
| REC 编号 | 22/WA/0069 |
| 数据集许可 | CC-BY-4.0 |
| 代码许可 | MIT |
| 论文许可 | CC BY 4.0 |
要点:许可解决的是版权层面的使用授权,不等于覆盖原始受试者同意的具体伦理边界。若你的用途超出原研究范围(例如再识别风险、商业再分发),需自行复核伦理合规。
附录 F:证件与 DOI 速查表
| 标识 | 值 |
|---|---|
| 数据集 DOI | 10.14278/rodare.2473 |
| 数据集概念 DOI | 10.14278/rodare.2472 |
| 论文 DOI | 10.1038/s41597-024-02975-0 |
| PMC | PMC10834944 |
| PMID | 38302487 |
附录 G:关键数字一览卡
- 300 张图像,1392 × 1040,16-bit TIFF
- 3,562 个手工标注细胞,7 类
- 最大类 Rod 1697,最小类 Large EPC sheet 仅 10
- 采集 2022-04 至 2022-08,300 名患者,42 ± 15 岁,95.1% 女性
- train / validate / test 各 100 张
- 最佳分割档为 0.3 像素分辨率:Dice 0.877,AUC 0.989
- 0.2 档显著劣化:Dice 仅 0.541
附录 H:超参速查表
| 超参 | 值 |
|---|---|
| Optimizer | Adam |
| LR | 0.001 |
| LR decay | 0.95 / 50 epoch |
| L2 | 0.0001 |
| Epochs | 750 |
| Samples/epoch | 1000 |
| Batch | 50 |
| Loss | BCE + Dice(α = β = 1) |
附录 I:软硬件与可复现性对照
| 层 | 论文所用 | 现代替代建议 |
|---|---|---|
| 语言 | Python 3.10.8 | 3.10+ |
| 框架 | TensorFlow 2.6.0 | 任何等价实现 |
| 前端 | Keras 2.6.0 | — |
| 硬件 | MacBook Pro M1 Max | 任意具备等效算力的机器 |
判断:软件栈偏老,但不构成复现障碍;关键可复现性风险在预处理与类别映射,而非框架版本。
附录 J:与库内条目关系速查
| 关系类型 | 条目 | 交互点 |
|---|---|---|
| 同域最近邻 | panda-plus | 显微病理分割的任务范式可比 |
| 同域兄弟 | panda | 全切片分割的规模对照 |
| 任务同构 | monuseg | 细胞核实例分割的方法可迁移 |
| 任务同构 | bbbc | 显微细胞分类标注体系可对照 |
| 跨域类比 | cytoimagenet | 细胞图像分类的类别设计借鉴 |
| 尺度对照 | tiger | 病理标注粒度对照 |
附录 K:避坑索引表
| 编号 | 一句话风险 | 速查位置 |
|---|---|---|
| 坑 1 | ds1.zip 有两个字节数口径 | 附录 B |
| 坑 2 | 稀类只有 10 个实例 | 事实清单·七类分布 |
| 坑 3 | enriched 采样不等于自然患病率 | §2 / §4 |
| 坑 4 | 缺 instance normalization 会掉点 | §4.2 / §5 |
| 坑 5 | 用 0.2 档却期待 0.877 | §4.1 |
| 坑 6 | torch-em 整数映射从 1 起 | 附录 C |
| 坑 7 | SHA256 不是 ds1.zip 校验和 | 附录 B |
| 坑 8 | CC-BY-4.0 不等于伦理豁免 | 附录 E |
附录 L:三十秒决策卡(可打印版)
| 你的需求 | 一步动作 |
|---|---|
| 想跑通分割基线 | 锁 v1 → 0.3 档 → 官方划分 |
| 想核对下载完整性 | 先确认版本号,再比对双口径 |
| 想做分类任务 | 读附录 C 映射,避免差一 |
| 想评估临床适用性 | 记住 enrich 采样,勿外推患病率 |
| 想复现论文数字 | 照搬超参表 + 补 instance normalization |
| 想引用 | 用论文 DOI 与数据集 DOI 各一次 |
附录 M:引用模板
数据集:
DeepUTI 数据集(2023)。Rodare, DOI: 10.14278/rodare.2473(概念 DOI: 10.14278/rodare.2472)。许可:CC-BY-4.0。
论文:
原论文(2024)。Scientific Data, 11:155。DOI: 10.1038/s41597-024-02975-0。许可:CC BY 4.0。
代码:
官方代码库。许可:MIT。
建议:学术写作中同时引用论文与数据集 DOI,以同时满足方法溯源与数据溯源。
附录 N:变更与版本记录
| 版本 | 关键变化 |
|---|---|
| v1 | 初次发布,2023-09-12,对应论文口径 |
| 后续版本 | 仓库内共 3 个版本,字节数与 MD5 有更新 |
建议:任何时候都以 concept DOI 作为「找最新」入口,以版本 DOI 作为「锁复现」入口,二者分工明确。
尾注
本条目基于数据集官方说明、同行评议论文与官方代码库三源交叉核验撰写,所有硬数字均可在对应来源处回溯。行文中对存在多口径的数值(尤其是资产校验值)均以双口径并列存照,不做单一化处理,以避免误导读者。
本条目为千方病案医数集 AI-Ready Wikipedia 条目,slug = deeputi。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- palm — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- lisc — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- raabin-wbc — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- conic-challenge — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- consep — 共享标签:医学影像 / 病理图像 / 医学图像分割
- neptune — 共享标签:医学影像 / 病理图像 / 图像分类
- panda-plus — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- cric — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- prostate-cnb-wsi — 共享标签:医学影像 / 病理图像 / 医学图像分割 / 图像分类
- pannuke — 共享标签:医学影像 / 病理图像 / 医学图像分割
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
