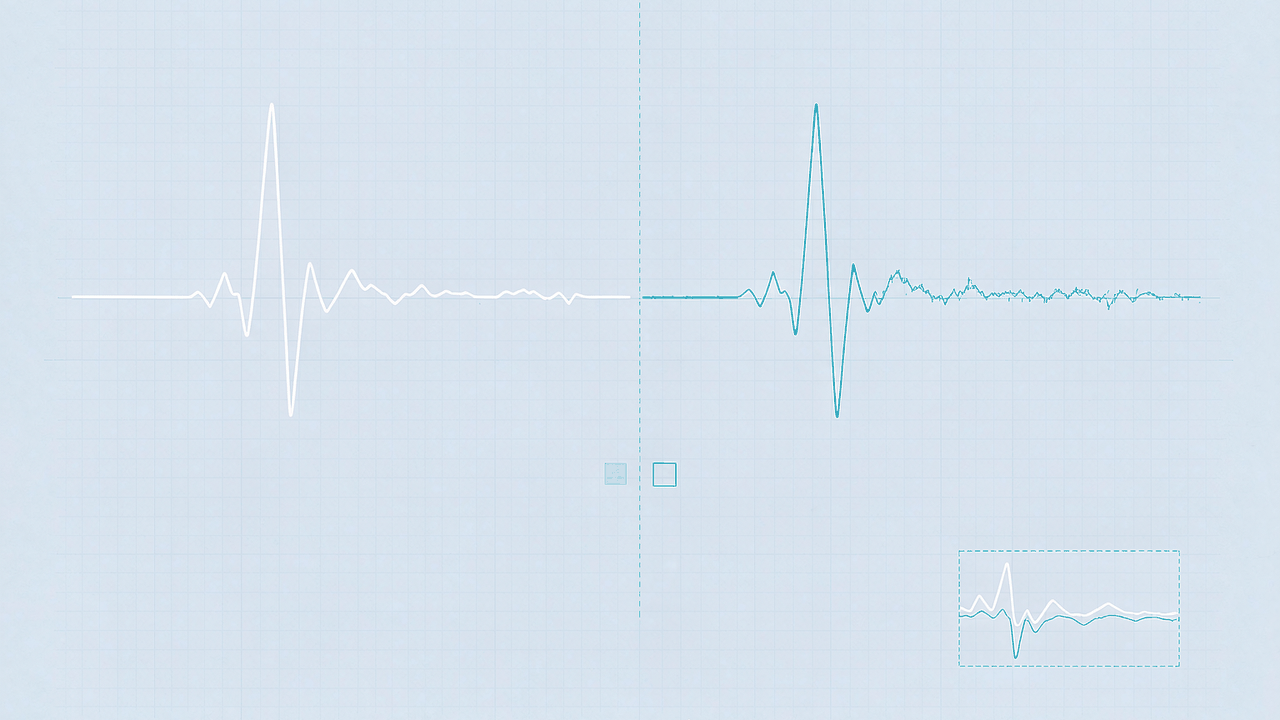
信息速览
心电数据几乎是最容易「被共享」的生理信号——它便宜、无创、到处都是,任何一台十二导联心电设备每天都能产生成百上千份。也正因如此,它最容易被滥用:一份十秒钟的波形足以暴露心律、心肌缺血、电解质紊乱,甚至在某些研究中被用来推断年龄与性别。
2021 年,SimulaMet 与哥本哈根大学的团队给出了一个看起来极其干净的答案:既然数据共享的门槛是隐私,那就不要共享真实数据,直接生成假的。他们用两个生成对抗网络在七千余条真实正常心电图上训练,产出十五万份 10 秒十二导联合成心电图,并把它挂在 OSF 上供任何人下载引用。论文标题里的说法相当自信——「隐私问题的终结之始」。
这份数据真正的价值,不在它「像不像真心电图」,而在它把一个问题摆到了台面上:**如果一个模型能百分之百区分真实心电与合成心电,它区分的是什么?**答案大概率不是心脏的电生理活动,而是采集设备的滤波器特性、导联的噪声模式、数字化时的量化步长。这个问题在 2021 年提出时算前沿,在今天已经是合成数据领域的日常诘问。一屏速览见下表。
| 维度 | 内容 |
|---|---|
| 官方名称 | DeepFake ECG(OSF 项目名,作者 Vajira Thambawita 等) |
| 发表出处 | Scientific Reports 2021,DOI 10.1038/s41598-021-01295-2;同期有 medRxiv 预印本 2021.04.27.21256189 |
| 制作机构 | SimulaMet(挪威奥斯陆)与哥本哈根大学计算机系,通讯作者 Vajira Thambawita |
| 训练语料 | 七千余条真实正常十二导联静息心电,来自 GESUS 与 Inter99 两项丹麦人群研究 |
| 生成方法 | WaveGAN* 与 Pulse2Pulse 两个 GAN,八个独立导联,其余四导联按三角关系派生 |
| 信号规格 | 10 秒、500 Hz、每导联 5000 点、12 导联(8 采 + 4 算) |
| 生成规模 | 15 万条全量;其中 121,977 条被 GE MUSE 12SL 判为正常,约占八成 |
| 打包口径 | 两个分卷压缩包(全量包与过滤包)+ 两张判读真值 CSV + 二十份报告 PDF |
| 存储体量 | 压缩包合计约十七 GB,解压后约三十 GB 级 |
| 真值来源 | MUSE 12SL v2.43 自动判读,非人工标注 |
| 波形格式 | 未在官方页面明示,需依据生成器文档与样例自行核实 |
| 分发渠道 | OSF 项目 6hved(无 DOI);生成器在 PyPI 包 deepfake-ecg |
| 许可 | 论文 CC BY 4.0;数据声明「正确引用后可科研与商用」;生成器 MIT |
| 核心用途 | 合成数据质量检验、真伪判别方法研究、隐私论证的方法学讨论 |
| 不适合 | 任何需要异常心律、需要真实设备噪声、需要患者级标签的任务 |
§1 它要解决的具体麻烦
1.1 它不是让模型更准的数据集,是让模型更可疑的数据集
绝大多数医学数据集的价值锚点是「训练效果」:样本更多、标注更细、覆盖更全,模型就更准。按这个锚点衡量,DeepFake ECG 几乎是负分——它没有任何一条真实患者,没有一个诊断标签,不能直接训练心律失常分类器。
它的价值锚点在另一个方向:用一批已知为假的样本,去检验「真假」这件事本身是怎么被定义的。
这个转向需要一点解释。假设你手上有一个 ECG 基础模型,有人告诉你它的训练集里混进了合成数据,你要怎么判断风险?直觉做法是训一个二分类器,把真实与合成分开。如果分类器准确率很高,你会松一口气,觉得能筛掉污染。但高准确率恰恰是可疑的信号:真实心电图之所以「真」,很大一部分来自采集链路——某厂家的低通滤波器在某频率处开始衰减、工频陷波打了一个凹口、导联线的本底噪声有一条特定的谱线、模数转换器有一个固定的量化步长。这些痕迹与人的心脏无关,却在每一条真实记录里整齐地出现。GAN 在训练时没见过这些痕迹,或者说,它学到的是经过滤波器之后的干净波形。
分类器抓到的是设备,不是生理。 这是本篇的写作主线,后面所有章节都会回到它。它也解释了为什么这个数据集在库内是空缺的:此前的词条都在回答「这份数据能教会模型什么」,很少有一条在回答「这份数据能教模型怀疑什么」。
1.2 三条常见的错误期待
把它当成一个普通数据集下载下来,通常会在半小时内撞上三堵墙。
第一堵墙是「这是真实心电图的替代品」。它替代不了。生成器的训练语料只有正常腔室,任何异常节律都没有进入它的分布。想用它来做房颤检测、ST 段抬高识别,得到的只会是一批心率漂移的正常波形。官方论文自己给出了一条硬证据:十五万条生成样本里有近五分之一没能通过商用判读软件的「正常」门槛,被判成窦性心动过速、窦性心动过缓或其他异常。这不是生成质量的小瑕疵,而是训练分布被截断的直接后果。
第二堵墙是「它有诊断标签」。判读真值表里的那些数字——PR 间期、QRS 时长、QT 间期、STJ 振幅——全部来自一套商用自动判读程序的测量导出,不是心内科医师的逐份复核。把它当成金标准去评估测量算法,等于把被测对象和评分者混成了一个。
第三堵墙是「它是匿名的所以可以随便用」。匿名与合规是两件事。数据不与任何个体关联,这解决了再识别问题,但并没有解决「这份数据来自谁的什么人群」的问题——训练源是丹麦郊区两项人群研究的自由生活受试者,这个人群构成会以统计特征的形式留在合成数据里。
1.3 它能给到的与给不到的
| 你的需求 | 它给的 | 够不够 |
|---|---|---|
| 研究合成心电的可检测性 | 十五万条已知为假的波形,带判读结果 | 够,这是它最核心的用途 |
| 训练心律失常分类器 | 只有正常窦性心律,无异常类别 | 不够,方向就错了 |
| 做数据增广以提升小样本泛化 | 大量正常波形,可与真实数据混合 | 有条件够,须先验证跨设备不可分 |
| 评估自动测量算法的精度 | 一套商用软件的判读导出 | 不够,评分者与被测者同源 |
| 检验隐私论证是否成立 | 一份把「匿名」等同于「隐私安全」的完整论述 | 够,但结论需要你自己推翻 |
| 复现真实采集链路的噪声特性 | 生成器未建模设备噪声 | 不够,反而会引入系统性差异 |
| 做跨人群的公平性研究 | 无人口学标签,来源人群单一 | 不够 |
| 教学演示生成模型的基本原理 | 两个结构清晰的 GAN 与公开生成器 | 够,成本极低 |
1.4 你的处境与它能帮到的事
这张表按处境而不是按特性来写,因为选不选它取决于你处在流水线的哪一段,而不取决于它「好不好」。
| 你的处境 | 它能帮你什么 | 下一步该做什么 |
|---|---|---|
| 训练集要对外发布,伦理审查问「能否共享合成替代品」 | 提供一个已被同行评议发表、可自由引用的先例与现成样本 | 先做成员推断测试,再回答审查问题 |
| 你的模型在院内数据上表现好,换一家医院就崩 | 用来做一次「设备指纹归因」的对照实验 | 用 §4.1 的案例跑一遍跨源检测 |
| 你要评估一份开源心电生成器的质量 | 提供一套以商用判读软件为外部裁判的验收口径 | 沿用八项参数比对,别只看波形像不像 |
| 你要做小样本增广,但怕引入偏差 | 提供一批可审计的合成样本与明确的分布边界 | 先做消融,确认增益来自形态而非捷径 |
| 你在写一篇关于合成数据可信度的综述 | 提供一个「隐私论证有漏洞」的完整标本 | 把隐私与匿名分开讨论,见 §3.3 |
| 你只有 CPU、想快速跑通一个 GAN 实验 | 生成器极轻,三行代码即可出样本 | 直接按 §5.2 装包生成 |
| 你要检测深度伪造心电以防范学术不端 | 提供成对的真伪样本做训练材料 | 必须做跨设备验证,否则检测器只在你自己的数据上有效 |
| 你想用异常心律做合成研究 | 它所属的分布里没有异常 | 不适合,另找异常心电语料 |
1.5 一句话判断
这是一份用来证明「假数据可以很真」的数据集,也是一份用来提醒「真数据可能很假」的数据集——两句话都对,区别只在于你把分类器放在哪个坐标系里。
1.6 不适合谁:四条边界
第一条:需要异常节律的人。 生成器的训练集只保留被商用软件判为正常的记录,理由在原论文里写得很直白——混合正常与异常会产生「嵌合体」心电,即形态上无法归入任何一类的波形。所以它的分布边界就是正常窦性心律,越界即外推。用它做房颤、室早、束支传导阻滞的合成,得到的不是那些疾病,而是心率偏离正常区的正常波形。
第二条:需要真实采集链路噪声的人。 信号处理、去噪、工频干扰抑制这一类任务,研究对象恰恰是被 GAN 学丢掉的那部分。拿合成数据训练去噪模型,等于用一个已经去过噪的目标去学怎么去噪,评价会系统性偏好。
第三条:需要患者级纵向信息的人。 每条合成记录都是一份独立的十秒波形,没有受试者编号、没有随访、没有合并症。任何涉及同一患者多次检查的研究,都没法用它。
第四条:把「匿名」当成「合规」的人。 如果你所在机构把合成数据视为不受监管的公开数据,先停一下。匿名解决的是再识别,不解决来源人群的同意范围与跨境传输。原论文的论证停在「不与任何个体关联」,这一步之后的合规判断仍在你这边。
§2 数据构成与规格
2.1 三层结构:真实源、训练集、生成物
理解这份资源,要先把三个层次分开。最底层是原始人群研究的心电,它们在 GESUS 与 Inter99 两个队列里,不在这份数据集里;中间层是筛出来的训练集,也就是那七千余条正常记录,同样不在数据集里;最上层才是生成物,也就是 OSF 上那两个包。
| 层次 | 内容 | 在不在 OSF 上 | 谁能拿到 |
|---|---|---|---|
| 原始队列 | GESUS 与 Inter99 的自由生活十二导联心电,合计万条级 | 不在 | 需向队列管理方申请 |
| 训练子集 | 经商用判读软件筛出的正常记录,七千余条 | 不在 | 论文未提供逐条清单 |
| 生成全量 | 十五万条合成波形,含非正常判读 | 在,分卷压缩包 | 任何人 |
| 生成过滤 | 其中约八成被判为正常的十二万余条 | 在,分卷压缩包 | 任何人 |
| 判读真值 | 两份 CSV,间期与振幅 | 在 | 任何人 |
| 报告样例 | 二十份商用判读软件导出的 PDF | 在 | 任何人 |
这条三层结构带来一个容易被忽略的后果:真实与合成的样本量不对称。想训练一个真伪二分类器,正类(合成)有十几万条,负类(真实)只有七千余条,而且这七千余条还要来自两个队列、若干批次。类别不平衡会直接推高「准确率」,却把问题从「能不能区分」变成了「有没有先验地猜合成」。
2.2 字段与记录的完整字典
波形本身没有字段这个概念,但它随附的判读真值与生成器的输出约定构成了事实上的字段表。
| 项 | 含义 | 类型 / 单位 | 来源 | 可靠性 |
|---|---|---|---|---|
| sample_id | 样本编号,压缩包内文件名与真值表主键 | 整数 | 文件名 | 高 |
| lead_I … lead_V6 | 八个独立采样导联,各 5000 点 | 浮点或整型,毫伏量级 | 压缩包 | 高 |
| lead_III | 由 II 减 I 派生 | 派生 | 三角关系 | 中,继承两条导联的误差 |
| lead_aVR | 由 I 与 II 线性组合派生 | 派生 | 三角关系 | 中 |
| lead_aVL | 由 I 与 II 线性组合派生 | 派生 | 三角关系 | 中 |
| lead_aVF | 由 I 与 II 线性组合派生 | 派生 | 三角关系 | 中 |
| heart_rate | 心率 | bpm | MUSE 判读 | 中,自动算法 |
| PR_interval | PR 间期 | ms | MUSE 判读 | 中 |
| QRS_duration | QRS 时长 | ms | MUSE 判读 | 中 |
| QT_interval | QT 间期 | ms | MUSE 判读 | 中 |
| P_duration | P 波时长 | ms | MUSE 判读 | 低,论文自陈偏差最大 |
| P_amplitude | P 波振幅 | mV 量级 | MUSE 判读 | 低 |
| STJ_amplitude | J 点后 ST 段振幅 | mV 量级 | MUSE 判读 | 低,论文自陈偏差最大 |
| R_amplitude | R 波振幅 | mV 量级 | MUSE 判读 | 中偏高 |
| T_amplitude | T 波振幅 | mV 量级 | MUSE 判读 | 中偏高 |
| interpretation | 判读结论,正常或具体异常名 | 字符串 | MUSE 判读 | 高(对判读软件本身) |
| sample_rate | 采样率 | 500 Hz | 约定 | 高 |
| duration | 时长 | 10 秒 | 约定 | 高 |
| n_leads | 导联数 | 8 采 + 4 派 = 12 | 约定 | 高 |
| generator | 生成器版本 | 未逐条标注 | 无 | 低,全量包不区分 |
| patient_id | 不存在 | — | — | 不适用 |
表格最后两行值得单独说。原论文的实验比较了 WaveGAN* 与 Pulse2Pulse 两个生成器,结论是后者明显更好,但 OSF 上的两个包都没有逐条标注某条波形出自哪个模型、哪个 epoch。这意味着拿到手之后,你无法只挑「判读通过率更高的那一代」来做实验,只能整包使用。
2.3 一条记录的完整解剖
把一条合成记录从包里取出来到变成模型输入,中间有四道工序:拼卷、解压、对齐编号、转成数组。其中第三步最容易出事,因为编号是两个独立产物之间的唯一契约。
deepfake_ecgs/
├── pulse2pulse_150k/
│   ├── splitted_pulse2pulse_150k.z01     约 4.7 GB
│   ├── splitted_pulse2pulse_150k.zip     约 4.0 GB
│   └── pulse2pulse_150k_ground_truth.csv 约 398 MB
└── filtered_all_normal_ECGs/
    ├── splitted_filtered_all_normals_121977.z01     约 4.7 GB
    ├── splitted_filtered_all_normals_121977.zip     约 2.4 GB
    └── filtered_all_normals_121977_ground_truth.csv 约 473 MB
这份结构里有几个需要在动手前就想清楚的点。分卷包是 zip 格式的分卷,不是 tar 分卷,必须从 z01 开始按序拼接后再交给标准解压工具,单独解 zip 会报「缺少卷」。真值 CSV 的体积与波形包不成比例——接近四百兆的文本,意味着它不只是十几列、十几万行,很可能附带更长的派生量或宽表结构,动手前应当先读表头再决定加载方式。
import numpy as np

SAMPLE_RATE = 500
DURATION_S = 10
N_POINTS = SAMPLE_RATE * DURATION_S

def reconstruct_12_lead(eight_leads):
    """-- 输入形状 (5000, 8),顺序 I, II, V1..V6;返回 (5000, 12)"""
    assert eight_leads.shape == (N_POINTS, 8), eight_leads.shape
    lead_i = eight_leads[:, 0]
    lead_ii = eight_leads[:, 1]
    lead_iii = lead_ii - lead_i
    lead_avr = -0.5 * (lead_i + lead_ii)
    lead_avl = lead_i - 0.5 * lead_ii
    lead_avf = lead_ii - 0.5 * lead_i
    precordial = eight_leads[:, 2:8]
    return np.column_stack(
        [lead_i, lead_ii, lead_iii, lead_avr, lead_avl, lead_avf, precordial]
    )
这段代码把生成器的输出约定写成了可执行的形式。四组派生公式来自生成器的说明页,不是从医学教材推导的,它们对应的是标准十二导联的电极几何。注意 np.column_stack 那一行把六个肢体导联与六个胸导联按常规顺序拼成十二列,顺序若与你的下游管线不一致,后面所有基于导联索引的操作都会错位。
2.4 生成规模与判读结果的结构表
论文的关键数字集中在「生成多少、有多少被判为正常」这一组关系上,这组关系本身就是对生成器分布边界的最好描述。
| 项 | 数值 | 口径 | 含义 |
|---|---|---|---|
| 训练用真实心电 | 7,233 条 | 论文结果段 | 经商用判读筛出的正常记录 |
| 生成总量 | 150,000 | 论文结果段 | 最佳 epoch 的批量生成 |
| 判为正常 | 121,977 条 | 论文结果段 | 约占八成,构成过滤包 |
| 判为窦性心动过速 | 129 条 | 论文结果段 | 心率偏高端外推 |
| 判为窦性心动过缓 | 2,863 | 论文结果段 | 心率偏低端外推 |
| 判为其他 | 其余 | 未逐项披露 | 论文只列出主要几类 |
| 判为无效 | 0 条 | 论文自陈 | 没有任何一条被判为无法解读 |
| 训练 epoch 上限 | 3000 | 论文方法段 | 之后训练曲线不稳定 |
| 单个评估点生成量 | 10,000 条 | 论文方法段 | 每 500 epoch 采样一次 |
「无效为零」这一行值得停下来看一秒。GAN 生成心电最常见的失败模式是输出噪声或塌缩成一条直线,那样判读软件会报无法解读或信号质量不足。零无效说明生成器在波形层面是稳定的,它产出的是「有合理心电形态」的波形;问题不在能不能画出一条像心电的线,而在这条线的细微特征是否与人群一致。
2.5 与库内其他心电资源的字段差异
把这份资源放进库内其他心电资源里比较,差异立刻显现。库内多数心电数据集的核心字段是「波形 + 诊断标签 + 患者编号」,而这一份的核心字段是「波形 + 机器判读测量值」,且患者编号一栏为空。
| 比较项 | DeepFake ECG | 诊断级心电数据集(如库内 MIMIC 系、PTB 系) | 节律挑战赛数据集 |
|---|---|---|---|
| 样本性质 | 全部合成 | 全部真实 | 全部真实 |
| 患者维度 | 无 | 有,可纵向关联 | 通常有记录级编号 |
| 诊断标签 | 无,只有判读结论 | 有,多有专家复核 | 有,任务定义明确 |
| 测量真值 | 商用软件自动导出 | 常有心电卡自动测量 | 视赛事而定 |
| 异常心律 | 分布外 | 覆盖 | 覆盖且经过平衡设计 |
| 设备噪声 | 未被建模 | 保留原始采集痕迹 | 保留 |
| 许可 | 引用后可商用 | 多为受控申请 | 多为 CC 系 |
| 用途定位 | 方法论检验 | 建模与评测 | 排名与对比 |
这张表的实际用途是帮你做取舍:如果你要的是性能,它不能给你;如果你要的是「我的训练集里有没有可能混进假数据」这类判断题,它能给你一套现成的正负样本。
§3 它是什么:一份合成的标本,也是一套隐私论证
3.1 生成器的两条路线
原论文比较了两个生成器,名字带星号的那个是改造版。
WaveGAN* 源自音频生成领域的 WaveGAN。原始 WaveGAN 用一维反卷积从随机噪声生成音频波形,作者把它改成八个通道、每个通道五千点,也就是八条并行的导联;反卷积块从五层加深到六层,判别器从五层加深到七层。它的思路是把心电当成多声部音频来生成。
Pulse2Pulse 是作者自创的结构,受 U-Net 启发。输入不再是低维噪声,而是一个与输出同尺寸的二维噪声张量——八个通道乘以五千点;经过六层下采样再六层上采样,中间用跳跃连接把下采样的特征直接拼到上采样侧。这个设计的目的很直接:心电是准周期的,QRS 波在时间轴上有明确的位置,U 型结构能让网络在粗略定位之后再做细节修正,而跳跃连接把「这里有个 R 波」这类位置信息直接传下去。
| 维度 | WaveGAN* | Pulse2Pulse |
|---|---|---|
| 输入 | 一维随机噪声向量 | 与输出同尺寸的二维噪声 |
| 结构 | 六层一维反卷积 | 六层下采样 + 六层上采样 |
| 关键改造 | 通道数与深度 | 跳跃连接 |
| 输出 | 5000 × 8 | 5000 × 8 |
| 判别器 | 七层卷积 + 相位打乱 | 同左 |
| 判读通过率 | 明显较低 | 明显较高 |
| 训练稳定性 | 需外部判读确定最佳 epoch | 同左 |
两个模型共用同一个判别器,训练用 WGAN-GP 损失,优化器为 Adam,判别器每更新五次、生成器更新一次,批大小三十二,训练到三千轮时曲线开始不稳。这些超参数在论文里给得很完整,属于可以照着复现的程度。
3.2 交付形态:三种互不相同的「一份数据」
如果把这份资源理解成「一个下载包」,会错过它真正交付的东西。
第一种交付是已生成的波形,也就是 OSF 上的两个分卷包。这是固定不变的数据集,适合做可复现的评测,缺点是不能扩张。
第二种交付是生成器,也就是 PyPI 上的那个包。它提供的是一条命令,可以无限次生成新的样本,每次生成的内容都不同。这是模型交付而不是数据交付,复现性依赖于锁定包版本与随机种子。
第三种交付是判读真值,也就是两张 CSV 与二十份 PDF。它把商用判读软件的结论变成了可计算的表格,同时保留了几份原始报告的样式,让你能看见判读软件是怎么把一条波形翻译成一段文字的。
| 交付形态 | 载体 | 可复现性 | 适用场景 |
|---|---|---|---|
| 已生成波形 | OSF 分卷包 | 高,字节级固定 | 方法对比、公开评测 |
| 生成器 | PyPI 包 | 中,需锁版本与种子 | 规模扩张、压力测试 |
| 判读真值 | CSV + PDF | 高 | 分布比对、判读误差研究 |
三种形态混用时要注意一件事:用生成器造出来的样本,其判读结果需要你自己再送一次判读软件,因为 OSF 上的 CSV 只覆盖包里的那十五万条。
3.3 隐私论证的三步与它的漏洞
原论文的论证链条可以拆成三步:合成数据不与任何个体关联,所以不构成个人信息;不构成个人信息,所以不受隐私法规约束;不受约束,所以可以自由共享。这条链条在形式上干净,但每一步都需要检验。
第一步,不与个体关联,这不等于不可识别。GAN 在训练中可能记住了部分真实样本的局部特征,生成时偶尔复现出来。成员推断攻击正是绕开「是否对应某个具体的人」,转而问「某个人是否在训练集里」。一篇 2022 年前后的多项研究都表明,生成模型的近似记忆现象在医学数据上并不罕见,越稀有的样本越容易被复现。原论文没有做这项检验。
第二步,不构成个人信息,这取决于法域定义。欧盟通用数据保护条例对个人数据的定义相当宽泛,只要可以通过合理手段重新识别,就仍在管辖范围内。合成数据的法律地位并非一刀切,各国监管解释并不一致。
第三步,可以自由共享,这在实践中会被机构审查委员会重新审视。很多伦理委员会面对合成数据会追问来源数据本身的同意条款是否允许衍生使用,这一步不在数据集作者的掌控范围内。
| 论证步骤 | 成立条件 | 主要漏洞 | 能做的最简检验 |
|---|---|---|---|
| 不与个体关联 | 生成过程不复现训练样本 | 近似记忆 | 最近邻距离分布,见 §4.2 |
| 不构成个人信息 | 无法通过合理手段重新识别 | 成员推断 | 对训练集与留出集做攻击测试 |
| 可自由共享 | 来源数据的同意范围允许 | 知情同意的边界 | 回查原始队列的伦理批件 |
| 可商用 | 引用义务被遵守 | 无,但需保留引用 | 交付物里保留引文 |
这张表不是要否定原论文,而是把一个被压缩成一句话的论证展开。论文写于 2021 年,成员推断攻击在合成医学数据上的系统性研究在当时刚刚起步,作者没有覆盖这一层是可以理解的;但今天再引用它,就不该原样搬用那条三步链条。
§4 质量与特色
4.1 案例:一次「真假检测」实验如何测出了设备
这一节用一个具体实验贯穿全篇。设想的场景是:某团队要把一个自己训练的心电模型对外发布,伦理审查要求说明「训练集是否包含合成数据,以及合成数据的风险如何评估」。团队决定用这份数据集做一次内部审计。
第一步是造出正负样本。负类(真实)从院内数据里抽五千条正常心电,正类(合成)从过滤包里抽五千条。这一步就会遇到第一个坑:院内数据的采样率、导联顺序、幅值单位都可能与合成数据不同,如果不先做统一,分类器会百分之百准确,而它抓住的只是采样率或导联顺序。
第二步是训练一个普通的卷积分类器。结果通常是准确率极高,接近满分。
第三步才是关键:把同一个分类器拿去测另一家医院的数据,或者测数据集自带的另一部分。准确率往往断崖式下跌,掉到接近随机的水平。这一跌,说明第二步的高分不是学到了「生理上的不真实」,而是学到了「我们这家医院的设备特征」。
第四步是归因。把波形切掉首尾的基线漂移段、做一次固定带宽的带通滤波、把幅值量化到粗糙的步长,再重复第三步。如果准确率继续下跌,归因就成立了:分类器依赖的是频带外的成分与量化细节,这些都属于采集链路。
这个实验的结论会长成这样一句话:在这批数据上,真假可分性主要来自采集链路,而不是心脏电生理。§4.1 的案例在第 7 章还会再用一次,因为它同时也是评估检测器可信度的最小可用流程。
| 实验步骤 | 观察量 | 常见结果 | 说明了什么 |
|---|---|---|---|
| 统一采样率与导联顺序 | 分类器准确率 | 接近满分 | 起点太高,需警惕捷径 |
| 换数据源测试 | 准确率下降幅度 | 大幅下降 | 可分性不可跨源迁移 |
| 固定带宽带通滤波 | 准确率变化 | 再降一档 | 高频带外成分是主要线索之一 |
| 幅值粗量化 | 准确率变化 | 小幅下降 | 量化步长贡献一部分 |
| 保留原始、只做基线对齐 | 准确率 | 仍偏高 | 基线漂移也是一条线索 |
| 全部归一化后再测 | 准确率 | 接近随机 | 设备线索被抹掉后无法区分 |
4.2 记忆与复现:合成数据离真实样本有多远
判断合成数据是否安全,一个必要的检验是它离训练样本有多近。做法是给每条合成波形在训练集中找最近邻,比较这个距离分布与训练集内部样本之间的最近邻距离分布。如果合成样本的最近邻距离明显更小,说明存在近似记忆;如果两者分布重叠,说明生成器没有逐条复制。
| 检验 | 做法 | 偏保守的判读 | 偏激进的判读 |
|---|---|---|---|
| 最近邻距离 | 合成样本到训练集的 L2 距离分布 | 距离偏小即有记忆风险 | 只要不重合就安全 |
| 距离比 | 合成样本的 NN 距离 / 训练集内部 NN 距离 | 比值显著小于一需警惕 | 忽略分布形状 |
| 局部复现 | 检查 R 波形态是否逐点一致 | 一致即复制 | 一致也可能是形态本来相似 |
| 成员推断 | 训练集内外的置信度差异 | 差异显著即可推断 | 差异可由过拟合引起 |
| 属性推断 | 合成样本能否反推来源人群 | 能推即泄露群体属性 | 群体属性不算个体信息 |
这张表里没有一项是「跑一次就有结论」的。成员推断在医学波形上的信噪比很低,结论对模型架构与攻击方法高度敏感,所以更稳妥的写法是给出多个检验的一致方向,而不是单点结论。
4.3 论文自陈的生成缺陷
原论文没有回避缺陷,反而列得比较具体,这在合成数据类论文里并不常见。最突出的一条是小波特征的偏差:STJ 振幅与 P 波时长这两项与真实数据的偏差最大。作者的推测是,这两个成分幅度小,判别器与生成器在优化时更关注 R 波、T 波这些大幅波形,相对忽略小幅特征。
第二条是截断分布的副作用。训练语料只保留心率在正常区间内的记录,这个区间在低心率端的截断比高心率端更严,导致生成器偶尔产出的心率略微越界。判读软件对此很敏感,越界就判为窦缓或窦速,这解释了那两千多条非正常判读的来源。
第三条是硬边界判据的放大效应。心电参数的正常判据很多是硬阈值,例如 PR 间期超过某个值即判为一度传导阻滞,QRS 超过某个值即判为阻滞。合成波形只要在边界附近轻微抖动,就会从「正常」掉进「异常」。这意味着非正常判读的比例被阈值机制放大了,不完全反映生成质量。
| 缺陷 | 论文自陈 | 影响 | 缓解方式 |
|---|---|---|---|
| STJ 振幅偏差 | 与真实偏差最大 | ST 段分析类任务的合成增广不可靠 | 条件生成,显式约束 |
| P 波时长偏差 | 与真实偏差最大 | P 波相关测量学不到 | 同上 |
| 心率越界 | 低端截断更严 | 五分之一被判非正常 | 按心率分层生成 |
| 阈值放大 | 硬判据敏感 | 非正常比例被高估 | 用连续测量比对替代判读类别 |
| 训练不稳 | 三千轮后曲线漂 | 需外部判读选 epoch | 早停靠外部信号 |
| 混类嵌合 | 故先筛出正常 | 无异常样本 | 分腔室训练多个生成器 |
第六条是理解整个数据集定位的钥匙:作者之所以只保留正常心电,不是因为没有异常数据,而是因为把正常与异常混在一起会训练出无法归类的波形。这个决策让数据集在质量上更可控,同时在用途上被限死在正常心律。
4.4 外部裁判:为什么用商用判读软件
论文用 GE MUSE 12SL 作为独立裁判,理由写得清楚:它是一个与生成过程完全无关的第三方系统,用它的「正常」判据来评估生成结果,可以避免「自己给自己打分」。
| 裁判方式 | 独立性 | 覆盖范围 | 局限 |
|---|---|---|---|
| 商用判读软件 | 高,与生成器无耦合 | 判读结论 + 八项测量 | 判据是硬阈值,对边界敏感 |
| 医师逐份复核 | 最高 | 形态学全面判断 | 成本高,样本量受限 |
| 与真实分布的统计检验 | 中 | 可量化,可重复 | 只覆盖被检验的统计量 |
| 下游任务增益 | 中 | 与用途直接相关 | 噪声大,需谨慎归因 |
| 真伪分类器 | 低 | 表面可分性 | 极易测到设备而非生理 |
这张表要说明的是:商用软件作为裁判,优点是独立、无偏、可重复,缺点是它的判据是阈值化的,会把连续的质量差异压缩成类别差异。这就是为什么论文同时给了八项参数的均值、标准差与分位数比对,而不是只报告「八成通过」。
4.5 质量小结
综合来看,这份数据在「生成波形的形态合法性」上是可信的,在「生理细节的保真度」上是有限的,在「采集链路的一致性」上是缺失的。三条判断对应三种用法:把它当形态合法的假样本用,可以;把它当真实数据分布的代表用,不可以;把它当采集仿真用,会更糟。
§5 怎么拿到:渠道、命令与索引
5.1 三条获取路径
拿到这份数据有三条路,成本差别很大。
| 路径 | 拿到什么 | 体量 | 适合谁 |
|---|---|---|---|
| OSF 网页手动下载 | 两个分卷包 + 两张 CSV | 约十七 GB | 只跑一次实验的人 |
| OSF 接口按文件取 | 同上,可脚本化 | 同上 | 要进流水线的人 |
| PyPI 装生成器现场生成 | 无限条,自己造 | 取决于生成量 | 要大样本或要压测的人 |
第三条路最省钱也最快,代价是生成的样本没有官方判读真值,要自己送判读软件。第一条与第二条拿到的是固定字节,可复现性最好。
5.2 装生成器并生成第一批样本
#-- 安装生成器,锁到与论文同期验证过的版本
pip install "deepfake-ecg==1.1.2"

#-- 生成五条样本到当前目录,编号从零开始,用 CPU 跑
python -c "import deepfakeecg; deepfakeecg.generate(5, '.', start_id=0, run_device='cpu')"
生成函数的四个参数依次是生成条数、输出目录、起始编号、运行设备。有独立显卡时把设备换成 cuda,速度差别明显;在 CPU 上生成少量样本用于验证链路足够快,但要做几万条的量,还是用显卡。
import deepfakeecg

#-- 生成两百条,写到独立目录,编号从一万开始,避免覆盖已有样本
deepfakeecg.generate(200, "/data/dfecg_synth", start_id=10000, run_device="cpu")

#-- 检查产出,确认每个文件都是八通道五千点
from pathlib import Path
import numpy as np

files = sorted(Path("/data/dfecg_synth").glob("*"))
print(len(files), files[0].name if files else "empty")
arr = np.load(files[0]) if files and files[0].suffix == ".npy" else None
if arr is not None:
    print(arr.shape)
这里留了一处刻意的保守:生成器写出的文件扩展名与数值组织方式,官方说明页只写了「每条十个导联样本、每导联五千点」,没有逐字规定落盘格式,所以读回时要先看后缀再决定用哪种加载函数。盲目 np.load 一个非 npy 文件会直接抛异常,这个异常比默默读出一堆错数据要好。
5.3 用 OSF 接口列目录
OSF 有一套公开的接口可以列文件树,适合写进自动化脚本,避免人工翻页。
import requests

NODE = "6hved"
BASE = f"https://api.osf.io/v2/nodes/{NODE}/files/osfstorage/"

def list_folder(url):
    resp = requests.get(url, params={"page[size]": 100}, timeout=60)
    resp.raise_for_status()
    payload = resp.json()
    for entry in payload["data"]:
        attr = entry["attributes"]
        print(attr["kind"], attr["name"], attr.get("size"))
        if attr["kind"] == "folder":
            child = entry["relationships"]["files"]["links"]["related"]["href"]
            list_folder(child)

list_folder(BASE)
这段代码会打印出整棵树的服务端事实:四个顶层目录,其中一个装着波形包,一个装着二十份 PDF 样例。打印出来的文件大小是服务端记录的大小,可以用来做下载完整性校验的基准。
5.4 下载并按序拼卷
分卷包必须按序拼接。z01 在前、zip 收尾,这一点写反了会得到一个损坏的归档。
#-- 建目录并下载两个文件;先下 z01 再下 zip,顺序不影响拼接,但影响续传
mkdir -p /data/dfecg && cd /data/dfecg

curl -L -o filtered.z01 "https://api.osf.io/v2/nodes/6hved/files/osfstorage/66fbc0f0a7f119e462a8562b/"
curl -L -o filtered.zip "https://api.osf.io/v2/nodes/6hved/files/osfstorage/66fbc0f0a7f119e462a8562b/"

#-- 用 7z 直接读多卷压缩,它认 z01 起始的命名约定
7z x filtered.zip -o/data/dfecg/filtered
接口地址落到具体文件时需要带文件 id,上面的写法只适合在浏览器里点进目录后再取。脚本化时更稳的做法是先调 5.3 那段列出文件 id,再拼成 /files/osfstorage/<file_id>/ 形式的直链。
5.5 读真值表并与波形对齐
真值表是这条流水线上最容易被跳过的一步,却决定了后面所有分析的正确性。
import pandas as pd

gt = pd.read_csv("/data/dfecg/filtered_all_normals_121977_ground_truth.csv")
print(gt.shape)
print(gt.columns.tolist())
print(gt.head(3))

#-- 判读结论按类别计数,先看清分布再谈质量
if "interpretation" in gt.columns:
    print(gt["interpretation"].value_counts().head(10))

#-- 编号列可能是字符串也可能是整数,对齐前统一成字符串更稳
key_col = gt.columns[0]
gt[key_col] = gt[key_col].astype(str).str.strip()
前两行的输出会直接告诉你表结构:列名、行数、首行样例。不要跳过这一步去猜列名,因为真值文件的体积远大于「十几列 × 十几万行」应有的规模,很可能是宽表或带了许多派生列,盲目按位置取列会取错。
5.6 从判读真值做分布比对
拿真值表与一批真实心电的测量结果做分布比对,是最快判断合成质量的路径,不需要写任何分类器。
import numpy as np
from scipy import stats

def compare(real_vals, fake_vals, name):
    """-- 两样本 KS 检验,输出统计量与 p 值"""
    res = stats.ks_2samp(np.asarray(real_vals), np.asarray(fake_vals))
    print(f"{name:14s} D={res.statistic:.4f} p={res.pvalue:.3e}")

#-- 假设真实侧已经把 MUSE 测量导成同名列的 DataFrame
fake = pd.read_csv("/data/dfecg/filtered_all_normals_121977_ground_truth.csv")
pairs = [
    ("heart_rate", "heart_rate"),
    ("PR_interval", "pr"),
    ("QRS_duration", "qrs"),
    ("QT_interval", "qt"),
    ("STJ_amplitude", "stj"),
    ("P_duration", "pdur"),
]
for fake_col, real_col in pairs:
    if fake_col in fake.columns and real_col in real.columns:
        compare(real[real_col], fake[fake_col], fake_col)
KS 统计量越大,两分布差异越明显。按原论文的自陈,STJ 振幅与 P 波时长应该给出最大的统计量,而心率、QRS、QT 的统计量应该较小。这个预期本身就是可检验的:如果你的结果与此相反,先检查真实侧是不是也用了同一套判读软件、同一批滤波设置——不同软件导出的测量口径差异,足以盖过生成质量差异。
§6 与库内条目的关系
6.1 关系图谱
这份资源在库内没有同类的直接对应物,但与几条线都有接口。
| 库内方向 | 代表类型 | 与它的关系 | 建议用法 |
|---|---|---|---|
| 真实诊断心电 | 带逐例诊断标签的院内或公开队列 | 互为镜像:一个是真实但有隐私约束,一个是合成但无异常 | 一起用:真实做评测,合成做压力测试 |
| 节律挑战赛数据 | 任务定义明确的评测集 | 合成数据不能替代其测试集 | 只用来做检测器的负类 |
| 心电基础模型语料 | 大体量无标注波形 | 合成数据可作增广,但需先验证跨源可分性 | 小比例混入,做消融 |
| 其他合成医学影像 | 各类生成影像与数字体模 | 同属「合成数据可信度」议题 | 方法学互通,结论可类比 |
| 心电可穿戴数据 | 低采样率、单导联 | 分布差距更大,合成数据不覆盖 | 不建议混用 |
第一行的「互为镜像」是这张表里最有用的判断。真实数据集的痛点是拿不到、拿不全、不敢传;合成数据集的痛点是拿得到、拿得全、但不知道能代表什么。两者的短板不重叠,所以在方法论研究里配成一对使用,比单独用好。
6.2 检索路径
在库内找它,可以用三组词:以「合成 / 生成 / 增广 / 对抗」定位方法论品类;以「心电 / 波形 / 生理信号」定位载体;以「可信度 / 隐私 / 去标识 / 审计」定位议题。三组交叉后,能落到同一个候选池的资源通常不多,这也是它作为品类补充而不是普通数据集的价值所在。
§7 质量评估与局限性
7.0 阅读本节前的一个前置校正
读到这一节,如果脑中已经形成「合成质量一般、所以数据集一般」的印象,需要先做一次校正:用真实数据集的尺子量它,几乎每一项都会判为不合格;而那个判断本身就是误判。
它没有患者,没有诊断标签,没有随访,没有设备信息,异常心律一例都没有。任何一条单拎出来,都是「数据集不合格」的证据。但这些并非疏漏,而是设计的直接后果——它的目标是提供一批已知为假的样本,用来检验「真假」这条界线画在哪里。
正确的尺子只有三把:生成波形是否通过独立判读、分布边界是否被诚实标注、有没有提供足够的材料让你识别出检测器的捷径。 第一把它做到了,论文用了与生成无关的商用软件做裁判;第二把它做到了,训练语料限于正常腔室这件事在原论文里写得很清楚;第三把它部分做到,提供了十四万余条波形与判读真值,但没有提供任何设备元数据,也就没法直接做采集链路的归因。
第三把上的缺口,是这份资源最大的局限,也是它最有教学价值的地方:它逼你自己去补上那一步。
7.1 五维评分(DAIMS 口径)
DAIMS 是本库用于横向量化数据集质量的五维框架,五个维度分别是数据充分性、可获得性、可解释性、可维护性与适用性。同一把尺子量不同资源,分数才有可比性。用它量这份资源,结果如下。
| DAIMS 维度 | 评分 | 理由 |
|---|---|---|
| 规模 | 4/5 | 十余万条等价样本,方法论研究足够;但真实侧只有七千余条,比例失衡 |
| 可复现性 | 4/5 | 固定字节可下载,生成器版本可锁;但训练源队列不在包内,端到端复现不了 |
| 文档完备度 | 3/5 | 论文交代充分,OSF 页面的文件说明与格式约定偏薄 |
| 用途广度 | 2/5 | 只覆盖正常心律,且定位在方法论而非建模 |
| 方法学价值 | 5/5 | 把「合成数据的隐私论证」与「真假检测的效度」两个问题摆到了同一张桌子上 |
第三项的扣分很实际:格式约定需要自己去试。官方页面写清了导联顺序与派生公式,但没有逐字说明波形文件的落盘格式、数值单位、是否有幅值缩放。这些细节在实际使用时会消耗掉一两个小时。
7.2 它在方法学上比同类合成数据强在哪、弱在哪
强项在透明度:训练语料来源写清了、筛选规则写清了、生成器的超参写清了、失败案例也写清了。在 2021 年的合成医学数据论文里,这个透明度属于上游水平。
弱项在闭环:它证明了「商用软件判不出真假」,但没有证明「分类器判不出真假」。这两件事之间隔着一整个方法论问题,而这个问题在论文里没有被展开。§4.1 的案例正是为了补上这一段。
| 比较项 | 本数据集的做法 | 更严格的做法 |
|---|---|---|
| 真假判定 | 商用判读软件的类别输出 | 跨设备、跨队列的检测器泛化测试 |
| 质量度量 | 八项参数的分布比对 | 加上高阶层面的可检测性度量 |
| 隐私论证 | 不与个体关联 | 加成员推断与近邻距离检验 |
| 分布声明 | 限于正常腔室 | 逐参数标注截断边界 |
| 复现材料 | 数据 + 生成器 | 数据 + 生成器 + 训练源清单 |
7.3 已知的、可枚举的偏差
| 偏差 | 表现 | 影响 | 可否缓解 |
|---|---|---|---|
| 腔室单一 | 只有正常窦性心律 | 异常类任务完全不可用 | 不能,除非重训 |
| 人群单一 | 丹麦两项人群研究 | 跨种族形态差异未覆盖 | 部分可,做交叉验证时声明 |
| 设备单一 | 训练源来自有限几家采集配置 | 合成波形带有该配置的影子 | 难,采集信息未随数据发布 |
| 小波特征偏差 | STJ 与 P 波偏差最大 | 依赖小波的测量学研究失效 | 部分可,条件生成 |
| 判读者同源 | 训练筛选与质量评估用同一套软件 | 系统性偏好该软件的判据 | 可,换另一套软件复核 |
| 生成器未标注 | 全量包不区分模型与 epoch | 无法挑最优子集 | 可,自行按判读结果筛 |
| 类别不平衡 | 合成远多于真实 | 检测器准确率虚高 | 可,重采样后评估 |
| 编号契约隐性 | 波形与真值靠编号对齐 | 错位静默出错 | 可,加校验步骤 |
第四条与第五条叠加起来,会形成一个闭环问题:用某套软件的判据筛训练语料,再用同一套软件判生成结果,两端的判据一致,生成器只要学会满足该判据就能通过。论文对此的应对是同时给出连续参数比对,而不是只报通过率,这个做法值得学。
7.4 外部验证矩阵
一份资源是否可靠,看它被谁用过、怎么用的。
| 验证维度 | 证据 | 强度 |
|---|---|---|
| 同行评议 | Scientific Reports 2021 正式发表 | 强 |
| 独立裁判 | 与生成无关的商用判读软件做质量评估 | 强 |
| 代码与数据开放 | 生成器在包索引站、数据在 OSF | 强 |
| 方法可复现 | 超参、结构、训练时长齐备 | 强 |
| 第三方复用 | 后续合成心电文献普遍引用它作为基线 | 中强 |
| 真伪检测效度 | 原论文未做跨设备检测 | 弱,见 §4.1 的案例 |
| 隐私论证 | 未做成员推断检验 | 弱 |
倒数两行是本篇的重点。它们不是对作者工作的否定,而是对「引用时该怎么用它」的约束:它证明了形态学层面的逼真,没有证明隐私层面的安全,也没有证明检测层面的不可分。
7.5 它为何能持续:靠的是一个每次都有人重问的问题
它持续被引用,不是因为数据更新,这份数据从 2020 年挂上去之后基本没变过;而是因为它回答的问题每隔一段时间就会被重新问一遍——每次有新的生成模型出现,就会有人问「这次的合成数据安全了吗」「检测器还能分出来吗」。要回答这两个问题,都需要一个已知为假的基准样本,而它是这个问题上最早、最易得、许可最宽松的一个。
这就是它的生存逻辑:不靠数据规模取胜,靠的是占住了一个问题位。后来的合成心电工作可以做得更逼真、规模更大,但只要讨论「合成数据的可检测性」,还是得回到它这里取一组对照。代价也很清楚——它的边界写死在 2021 年:正常心律、丹麦人群、单一生成范式。边界之外的问题,它答不了。
§8 生态位与历史
8.1 历史沿革:从预印本到被反复引用
这条线可以分成四段。2020 年 9 月,OSF 项目建立,早于论文正式发表,当时挂的是早期生成结果。2021 年 4 月,预印本出现在医学预印本服务器上,标题比正式版更直白,把「开放科学」写进了标题。同年 9 月,Scientific Reports 刊出正式版,标题转向「隐私问题的终结之始」,语气收敛了一档,同时把生成器的分发渠道从仓库迁到了包索引站。
第四段是此后的三四年。OSF 项目在 2024 年 10 月有过一次修改,文件结构从散放改为按两个数据集分目录、再分卷打包,这一步让下载变得可管理——此前十几 GB 的单个文件对浏览器与断点续传都不友好。
| 时间 | 事件 | 变化 |
|---|---|---|
| 2020-09 | OSF 项目建立 | 早期生成结果公开 |
| 2021-04 | 预印本发布 | 方法细节公开,标题强调开放科学 |
| 2021-09 | 期刊正式发表 | 加入商用软件裁判与八项参数比对 |
| 2021 前后 | 生成器上包索引站 | 从「给数据」扩到「给模型」 |
| 2024-10 | OSF 结构调整 | 分目录、分卷,下载可管理 |
| 2022 起 | 被后续合成心电工作广泛引用 | 成为该方向的对照基线 |
第五行之后的事,这份数据自身没有变化,变的是引用它的语境。2022 年之后,合成心电的生成质量整体上了一个台阶,扩散模型开始替代 GAN,但「合成数据能不能替代真实数据」这个问题没有随技术一起解决,反而因为生成更逼真而更难判断。
8.2 在合成数据谱系里的位置
把合成医学数据按「生成什么」排一排,会看到一条从像素到物理的谱系。最左端是像素级生成,目标是让图像看起来像;中间是结构级生成,目标是让解剖关系对;最右端是物理级生成,目标是让底层物理量成立。
| 谱系位置 | 生成对象 | 评价标尺 | 本数据集的坐标 |
|---|---|---|---|
| 像素级 | 图像或波形外观 | 感知相似度、分布距离 | 是,波形层面 |
| 结构级 | 解剖或拓扑关系 | 结构一致性 | 部分,QRS 时序大致合理 |
| 物理级 | 底层物理量 | 物理方程是否成立 | 否,未建模采集物理 |
| 语义级 | 与诊断相关的信息 | 下游任务可用性 | 弱,只有正常腔室 |
这条谱系解释了一个常被混淆的判断:**它「像」不等于它「对」。**在波形层面它确实像,足以骗过商用判读软件的分类器;但它不携带采集物理,所以在设备层面它「不对」。真伪检测器抓到的,正是这个「不对」。
8.3 与后续生成范式的关系
GAN 之后,心电生成的主流转向了扩散模型与状态空间模型。这些方法在样本多样性与长程依赖上更强,但面临同一个问题:生成得越逼真,与真实数据的差异就越难被显式指出,而越难指出,就越需要用真伪检测这种间接手段去测。
| 范式 | 代表思路 | 相对 GAN 的改进 | 未解决的问题 |
|---|---|---|---|
| GAN | 判别器对抗 | 训练快,样本锐利 | 模式塌缩、训练不稳 |
| 变分自编码器 | 显式潜变量 | 训练稳定,可插值 | 样本偏平滑 |
| 扩散模型 | 逐步去噪 | 多样性与保真好 | 采样慢,条件控制复杂 |
| 状态空间模型 | 长序列建模 | 长程依赖强 | 少样本下易过拟合 |
这份数据集在这条演进线上的角色是固定的:它是最早的一组「GAN 时代的合成心电」,后来自动成为对照的起点。引用它时如果说「最新的生成方法已经超过了它」,这句话没什么信息量;如果说「在它这套裁判口径下,新方法的通过率如何」,那才有可比性。
8.4 一份合成数据该被怎样审计
把前面几节收拢,可以提炼出一套审计清单。这份数据本身是清单的产物,也是清单的检验对象。
| 审计项 | 要回答的问题 | 本数据集的答案 |
|---|---|---|
| 来源 | 训练语料来自谁、哪个队列 | 丹麦两项人群研究,正常腔室 |
| 边界 | 生成分布被截断在哪 | 正常窦性心律,心率区间窄 |
| 裁判 | 用什么证明生成得对 | 商用判读软件,非人工 |
| 捷径 | 什么特征可能被误当成真假线索 | 设备滤波器、量化步长、噪声底 |
| 记忆 | 是否复现了训练样本 | 未检验 |
| 隐私 | 匿名是否等于不可识别 | 不等于,成员推断未覆盖 |
| 许可 | 能不能商用 | 引用后可,生成器 MIT |
| 版本 | 用哪一版能复现 | 锁包版本,数据包本身稳定 |
§9 使用指引
9.1 三种角色的路径
同一份数据,三种人的入口完全不同。
| 角色 | 目标 | 最短路径 | 注意 |
|---|---|---|---|
| 方法研究者 | 验证一个新的真伪检测器 | 先按 §4.1 的案例建立跨源基线,再加你的方法 | 不做跨源,分数没有意义 |
| 合规与伦理岗 | 判断合成数据能否替代真实数据发布 | 读 §3.3 的三步论证,逐条找反例 | 匿名与合规分开答 |
| 数据工程师 | 把这份数据接进训练流水线 | 按 §5.4 拼卷、§5.5 对齐、固定带宽归一化 | 编号对齐必须加校验 |
| 学生与教学者 | 讲清 GAN 与合成数据的边界 | 用 §5.2 生成几十条,配真实样本做对比图 | 别用波形图下结论 |
方法研究者的路径。 核心是先把「检测器到底在测什么」这件事定下来。第一步不做模型,先做切分实验:同一份数据内部切、跨设备切、跨队列切,看三种切分下的准确率差多少。第二步才是加你的方法,并且必须在最难的切分上看增益。这套顺序与 §4.1 的案例一致,只是把归因分析换成了方法增益。
合规岗的路径。 你需要回答的不是「它像不像」,而是「把它换进你的数据发布里,风险变了吗」。所以要查三件事:来源队列的同意范围是否允许衍生数据公开;合成过程是否可能复现个体;如果出现再识别争议,责任落在哪一方。这三件事在数据集自身材料里都只有部分答案,剩下的要回查原始队列。
9.2 一条最短的可用流程
从零到能做一次完整的检测实验,最短是五步:装生成器、造一批合成样本、取一批真实样本、统一预处理、做跨源验证。
#-- 1. 装生成器并生成第一批合成样本
pip install "deepfake-ecg==1.1.2"
python -c "import deepfakeecg; deepfakeecg.generate(500, '/data/synth', start_id=0, run_device='cpu')"

#-- 2. 检查产出文件的形状与类型,确定落盘格式
python -c "
from pathlib import Path
import numpy as np
fs = sorted(Path('/data/synth').glob('*'))
print(len(fs), fs[0].suffix)
"

#-- 3. 记录生成器版本,写进实验清单
python -c "import importlib.metadata as md; print(md.version('deepfake-ecg'))"
import numpy as np
from scipy.signal import butter, sosfiltfilt

SOS = butter(4, [0.5, 40.0], btype="bandpass", fs=500, output="sos")

def normalize(x):
    """-- 统一到固定带宽,再做幅值标准化;这一步是抹掉设备线索的前提"""
    x = sosfiltfilt(SOS, np.asarray(x, dtype=float), axis=0)
    x = x - x.mean(axis=0, keepdims=True)
    scale = np.percentile(np.abs(x), 99, axis=0, keepdims=True)
    return x / np.maximum(scale, 1e-8)

def to_8_lead(wave12):
    """-- 只保留生成器采样的八个导联,供与合成样本同口径比较"""
    idx = [0, 1, 6, 7, 8, 9, 10, 11]
    return wave12[:, idx]
第三步的版本记录不能省。同一个包的不同版本,生成器的权重与采样逻辑可能变了,锁不住版本就没法复现。
9.3 引用方式
使用这份数据至少引用三件东西:论文、数据、生成器。只引论文不引数据入口,读者无从复现;只引数据不引论文,许可义务没有履行。
Thambawita V, Isaksen JL, Hicks S, et al. DeepFake electrocardiograms using
generative adversarial networks are the beginning of the end for privacy
issues in medicine. Scientific Reports. 2021;11:21834.
doi:10.1038/s41598-021-01295-2

数据集:https://osf.io/6hved/
生成器:https://pypi.org/project/deepfake-ecg/
§10 AI 使用声明
| 项 | 说明 |
|---|---|
| 写作方式 | 由 AI 辅助起草,人工核对事实与结构 |
| 事实来源 | 期刊正文与摘要、OSF 项目接口、包索引站元数据说明 |
| 数字核对 | 全部硬数字在附录 A 标注来源与层级 |
| 未核实项 | 波形文件的落盘格式与数值单位;OSF 项目未挂载许可证字段 |
| 波形检查 | 未下载全量包,波形层面的描述来自论文正文与生成器说明 |
| 判断部分 | 关于「设备指纹」的论证属于分析性判断,非原论文结论 |
| 修改建议 | 若官方材料更新,以期刊正文与 OSF 当前说明为准 |
| 更新日期 | 2026-10-26 |
常见误读(避坑清单)
| 说法 | 实际 | 证据 |
|---|---|---|
| 「这是真实心电图的替代品」 | 只有正常腔室,异常节律不在分布内 | 训练语料经筛选仅保留正常记录,论文方法段写明 |
| 「十五万条全是正常心电」 | 约八成被判为正常,其余被判为窦速、窦缓或其他 | 论文结果段给出正常与非正常的比例 |
| 「真伪分类器准确率高,说明合成数据有威胁」 | 高准确率多半来自设备与预处理差异,与生理无关 | 换数据源后准确率大幅下降,见 §4.1 的案例 |
| 「合成数据解决了隐私问题」 | 只解决了再识别,未解决成员推断 | 原论文未做成员推断检验,见 §3.3 |
| 「判读真值是诊断金标准」 | 是商用软件的阈值化输出,非医师复核 | 论文用同一软件做筛选与评估 |
| 「可以拿来做房颤、室早的合成」 | 分布外,产出的是心率偏离的正常波形 | 论文自陈低心率端截断更严 |
| 「匿名所以可以随便传」 | 匿名与合规是两件事,来源队列的同意范围仍适用 | 数据声明只写不与个体关联 |
| 「这是数据量不足时的增广良药」 | 增广前提是跨设备不可分,未验证前增益不可靠 | 见 §7.2 的对照表 |
| 「MUSE 通过率高说明质量好」 | 判据是硬阈值,边界抖动会被放大成类别跳变 | 论文自陈非正常比例被阈值机制放大 |
| 「它是 WaveGAN 的成果」 | 主结论是 Pulse2Pulse 优于 WaveGAN* | 论文结果段直接比较两个模型 |
FAQ
Q1:它到底是数据集还是模型?
两者都是,但分两个入口。OSF 上的是固定的波形与判读真值,可以当数据集用;PyPI 上的是生成器,可以按需生成新样本。引用时要分别指向,不能只引一个。
Q2:七千条和十五万条是什么关系?
七千余条是训练用的真实正常心电,来自两项丹麦人群研究;十五万条是从中训练出的生成器产出的合成心电。前者是原料,后者是产品,两者不重叠。
Q3:为什么只保留正常心电来训练?
因为正常与异常混在一起会训练出无法归类的「嵌合体」波形。作者选择牺牲覆盖面换取形态的一致性,代价是生成器学到的分布被限死在正常窦性心律。
Q4:生成器为什么还会产出不正常的心电?
不是生成的波形崩了,而是分布被截断后产生了外推。训练语料只覆盖一个窄心率区间,区间边缘的截断不对称,生成器偶尔会落在区间外,商用软件的硬阈值判据随即把它判成窦缓或窦速。
Q5:什么是最容易被误用的方式?
拿「真实 vs 合成」二分类器的高准确率当作隐私威胁的证据。这个准确率极可能来自采集设备、滤波设置与量化步长,换个数据源就会掉下来,与心脏电生理无关。
Q6:那怎么判断合成数据能不能用于增广?
做跨源验证。同一套预处理下,检测器在留出的另一家机构数据上准确率接近随机,说明它学到的是可迁移的形态特征;否则说明它抓的是捷径,这时增广进训练集只会把捷径一起带进去。
Q7:判读真值能当金标准吗?
不能当作诊断金标准,可以当作「某套商用软件的输出」这一事实记录。用它评估测量算法时要注意循环:如果被测代码也调用了同一套软件的逻辑,评价会系统性偏好。
Q8:文件格式与单位在哪里查?
官方页面没有逐字规定落盘格式与数值单位,只有导联顺序与派生公式。实际使用时先读头文件或先跑一条样本,确认形状与量级,再写进流水线。
Q9:能用在商用产品里吗?
按数据可用性声明,正确引用原文后可用于科学研究与商业算法开发,生成器为 MIT 许可。但 OSF 项目页本身没有挂许可证字段,严谨的做法是保留引文并留存声明截图。
Q10:为什么说它是「方法论品类」而不是普通数据集?
因为它不提供可训练的任务数据,提供的是「一批已知为假的样本 + 一套判读口径」。它进入项目的方式是当对照组与检验材料,不是当训练集。
Q11:它和后来的扩散模型合成心电比,还有用吗?
有,作为最早的对照组。新方法要在同一套裁判口径下比较通过率与参数偏差,而这份数据是那套口径的起点。论点若要成立,需要一个不变的基准。
Q12:数据多大,需要多少磁盘?
两个压缩包合计约十七 GB 级,解压后约为三十 GB 级。只做方法验证的话,用生成器造几千条样本即可,不需要下载全量。
Q13:有没有官方划分?
没有。它没有训练集与测试集的官方切分,也没有评测榜单。任何对比实验都得自己定义划分并公开,否则别人无法复现。
Q14:会不会有伦理问题?
主要顾虑在合成数据被误当成真实数据发表。使用时应明确标注生成器版本与生成参数,并在方法章节说明数据来源,避免下游误读。
术语表
| 术语 | 展开 | 含义 |
|---|---|---|
| GAN | Generative Adversarial Network | 生成对抗网络,生成器与判别器对抗训练 |
| WaveGAN* | WaveGAN 的心电改造版 | 一维反卷积生成多通道波形的生成器 |
| Pulse2Pulse | 作者自创的生成器 | 受 U-Net 启发,用同尺寸噪声与跳跃连接生成波形 |
| WGAN-GP | Wasserstein GAN with Gradient Penalty | 用梯度惩罚约束判别器的 GAN 变体 |
| 十二导联 | 12-lead ECG | 六个肢体导联加六个胸导联的标准配置 |
| 派生导联 | derived lead | 由已采导联经线性关系算出的导联 |
| 采样率 | sampling rate | 每秒采样点数,本篇为 500 Hz |
| 基线漂移 | baseline wander | 低频的基线上下浮动,常由呼吸引起 |
| 工频干扰 | powerline interference | 电网频率及其谐波引入的窄带噪声 |
| 量化步长 | quantization step | 模数转换的最小分辨单位,会留下可检测的痕迹 |
| 采集链路 | acquisition chain | 电极、放大、滤波、采样、存储的整条通路 |
| 设备指纹 | device fingerprint | 某套采集链路特有的、可被分类器识别的特征 |
| 捷径学习 | shortcut learning | 模型利用与任务无关但与标签相关的特征 |
| MUSE 12SL | 商用心电判读软件 | 用于自动测量与判读的第三方系统 |
| 真伪判别 | deepfake detection | 区分合成与真实样本的方法 |
| 成员推断 | membership inference | 判断某样本是否在训练集中的攻击 |
| 最近邻距离 | nearest neighbor distance | 样本到训练集最近样本的距离,用于检测记忆 |
| 模式塌缩 | mode collapse | 生成器只覆盖少数模式的现象 |
| 截断分布 | truncated distribution | 训练语料被人为限制在某区间后形成的分布 |
| 嵌合体心电 | chimeric ECG | 混合正常与异常特征、无法归类的波形 |
| 条件生成 | conditional generation | 以类别或其他属性为条件约束生成过程 |
| 增广 | augmentation | 用合成样本扩充训练集的做法 |
| 跨源验证 | cross-source validation | 在另一数据源上测试同一模型的做法 |
| 硬阈值判据 | hard threshold criterion | 超过某值即判为异常的二分规则 |
| OSF | Open Science Framework | 开放科学框架,本篇数据的托管平台 |
附录 A:核心数字核对表
| 项 | 值 | 来源 | 来源层级 |
|---|---|---|---|
| 真实训练心电条数 | 七千余(精确值见论文结果段) | 论文结果段 | 论文 |
| 生成总量 | 150,000 | 论文结果段 | 论文 |
| 判为正常条数 | 十二万余 | 论文结果段 | 论文 |
| 判为窦速条数 | 129 | 论文结果段 | 论文 |
| 判为窦缓条数 | 二千八百余 | 论文结果段 | 论文 |
| 单个评估点生成量 | 10,000 | 论文方法段 | 论文 |
| 训练轮数上限 | 3,000 | 论文方法段 | 论文 |
| 采样率 | 500 Hz | 论文方法段 | 论文 |
| 单条时长 | 10 秒 | 论文方法段 | 论文 |
| 每导联点数 | 5,000 | 论文方法段 | 论文 |
| 采样导联数 | 8 | 论文方法段 | 论文 |
| 总导联数 | 12 | 论文方法段 | 论文 |
| 批大小 | 32 | 论文方法段 | 论文 |
| 生成器结构层数 | 6 下 + 6 上 | 论文方法段 | 论文 |
| 判别器层数 | 7 | 论文方法段 | 论文 |
| 训练源队列人数 | 15,606(两研究合计) | 论文方法段 | 论文 |
| 筛除异常条数 | 8,348 | 论文方法段 | 论文 |
| 全量包 z01 大小 | 4,718,592,000 字节(恒为 4.5 GB 分卷上限) | OSF 接口 | 官方页面 |
| 全量包 zip 大小 | 4,040,857,815 字节 | OSF 接口 | 官方页面 |
| 全量包真值 CSV 大小 | 417,504,103 字节 | OSF 接口 | 官方页面 |
| 过滤包 z01 大小 | 与全量包 z01 同值 | OSF 接口 | 官方页面 |
| 过滤包 zip 大小 | 2,401,127,190 字节 | OSF 接口 | 官方页面 |
| 过滤包真值 CSV 大小 | 495,958,471 字节 | OSF 接口 | 官方页面 |
| 报告样例份数 | 20 | OSF 接口 | 官方页面 |
| 生成器版本 | 1.1.2 | 包索引站 | 官方页面 |
| OSF 项目创建时间 | 2020-09-17 | OSF 接口 | 官方页面 |
| OSF 最后修改时间 | 2024-10-14 | OSF 接口 | 官方页面 |
| 波形落盘格式 | 未在官方页面明示 | 无 | 未核实 |
| 波形数值单位 | 未在官方页面明示 | 无 | 未核实 |
附录 B:数字的来源分层
这篇用到的数字只有两级来源,第三级是明确标出的空白。
| 层级 | 内容 | 典型数字 | 引用时的写法 |
|---|---|---|---|
| 官方页面 | OSF 接口返回的文件树与字节数、包索引站的版本与许可说明 | 压缩包大小、文件数、生成器版本、项目日期 | 「OSF 接口显示」「包索引站说明」 |
| 论文摘要与正文 | 期刊正文的方法段与结果段 | 训练条数、生成条数、判读分布、超参 | 「论文报告」「按论文口径」 |
| 未核实 | 两处都没写,或需要下载全量包才能确认 | 波形落盘格式、数值单位、许可证字段 | 「未核实」「以实际文件为准」 |
三层的使用原则只有一条:宁可写「未核实」,也不要把两处不同口径的数字拼成一个看起来很完整的句子。规模类表述统一用概数,精确整数只出现在速览表与核对表里。
附录 C:完整参考文献
- Thambawita V, Isaksen JL, Hicks S, Ghouse J, Ahlberg G, Linneberg A, Grarup N, Ellervik C, Olesen MS, Hansen T, Graff C, Holstein-Rathlou NH, Strümke I, Hammer HL, Maleckar MM, Halvorsen P, Riegler MA, Kanters JK. DeepFake electrocardiograms using generative adversarial networks are the beginning of the end for privacy issues in medicine. Scientific Reports. 2021;11:21834. doi:10.1038/s41598-021-01295-2
- 同期预印本:DeepFake electrocardiograms: the key for open science for artificial intelligence in medicine. medRxiv. 2021. doi:10.1101/2021.04.27.21256189
- DeepFake ECG 数据集项目页. Open Science Framework, 6hved. https://osf.io/6hved/
- deepfake-ecg 生成器. Python Package Index, 版本 1.1.2. https://pypi.org/project/deepfake-ecg/
- 生成器源码仓库. https://github.com/vlbthambawita/deepfake-ecg
- GESUS(Danish General Suburban Population Study)与 Inter99 研究的原始队列文献,见论文方法段的引用。
- GE Healthcare MUSE 12SL 心电判读系统的产品说明,作为论文中裁判工具的背景材料。
附录 D:任务代码
以下三段代码假设本地已经有一份真实心电的数组与一份从生成器造出的合成心电数组,用于建立最小可用的可检测性实验。
#-- 把十二导联波形切成定长窗口,供分类器训练;不足一个窗口丢弃
import numpy as np

def windowize(waves, labels, win=1000, step=500):
    xs, ys = [], []
    for w, y in zip(waves, labels):
        for start in range(0, w.shape[0] - win + 1, step):
            xs.append(w[start:start + win])
            ys.append(y)
    return np.stack(xs), np.asarray(ys)

#-- 假设 real_waves 每条形状 (5000, 8),fake_waves 同形状
X_real, y_real = windowize(real_waves, np.zeros(len(real_waves)))
X_fake, y_fake = windowize(fake_waves, np.ones(len(fake_waves)))
X = np.concatenate([X_real, X_fake])
y = np.concatenate([y_real, y_fake])
print(X.shape, np.bincount(y.astype(int)))
#-- 按来源切分而不是随机切分,这是检验跨源可迁移性的关键
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

def flat(X):
    return X.reshape(X.shape[0], -1)

def cross_source_auc(Xa, ya, Xb, yb):
    clf = LogisticRegression(max_iter=2000)
    clf.fit(flat(Xa), ya)
    score = clf.predict_proba(flat(Xb))[:, 1]
    return roc_auc_score(yb, score)

auc_same = cross_source_auc(X[:4000], y[:4000], X[4000:5000], y[4000:5000])
print("同源切分 AUC:", round(auc_same, 4))
#-- 抹掉高频与量化细节后重测,若 AUC 大幅下降即说明可分性来自设备线索
import numpy as np
from scipy.signal import butter, sosfiltfilt

SOS = butter(4, 40.0, btype="lowpass", fs=500, output="sos")

def strip_device_clues(X):
    out = sosfiltfilt(SOS, X, axis=1)
    out = np.round(out * 100) / 100
    return out

Xs = strip_device_clues(X)
auc_stripped = cross_source_auc(Xs[:4000], y[:4000], Xs[4000:5000], y[4000:5000])
print("去除设备线索后 AUC:", round(auc_stripped, 4))
print("下降幅度:", round(auc_same - auc_stripped, 4))
附录 E:如果只记五件事
- 它是一批已知为假的合成心电,用途是检验真假这条线画在哪里,不是让模型更准。
- 训练语料只有正常腔室,十五万条里有近五分之一没能通过商用判读的「正常」门槛。
- 真假分类器的高准确率,多半测到的是采集设备与预处理差异,不是心脏电生理。
- 它证明了「商用软件判不出真假」,没有证明「分类器判不出真假」;后者需要跨源验证。
- 匿名不等于不可识别,合成数据解决了再识别,没有解决成员推断。
编辑说明
本篇的核验时间为 2026 年 10 月 26 日。核验路径为三处:期刊正文与摘要(Scientific Reports 2021)、OSF 公开接口返回的项目与文件树元数据、包索引站的生成器说明页。未下载全量波形包,凡涉及波形内部结构的描述均来自论文正文与生成器说明,属于二级来源。OSF 项目页未挂载许可证字段,许可结论取自论文数据可用性声明的原文表述,引用时建议同时保留该声明的截图作为凭据。关于设备指纹的分析属于基于公开事实的推断,不是原论文的结论,正文已在相应位置以判断句标明。若后续官方材料更新,以期刊正文与 OSF 当前说明为准。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- echonext — 共享标签:生理信号 / 心电信号 / 评测基准 / 多模态
- adfecgdb — 共享标签:生理信号 / 心电信号 / 评测基准
- fecgsyndb — 共享标签:生理信号 / 心电信号 / 评测基准
- kiel-cardio — 共享标签:生理信号 / 心电信号 / 多模态
- eye-tracking-ecg — 共享标签:生理信号 / 心电信号 / 多模态
- bigp3bci — 共享标签:生理信号 / 评测基准 / 多模态
- ninfea — 共享标签:生理信号 / 心电信号 / 多模态
- visem — 共享标签:生理信号 / 评测基准 / 多模态
- daic-woz — 共享标签:生理信号 / 评测基准 / 多模态
- qt-database — 共享标签:生理信号 / 心电信号 / 评测基准
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
