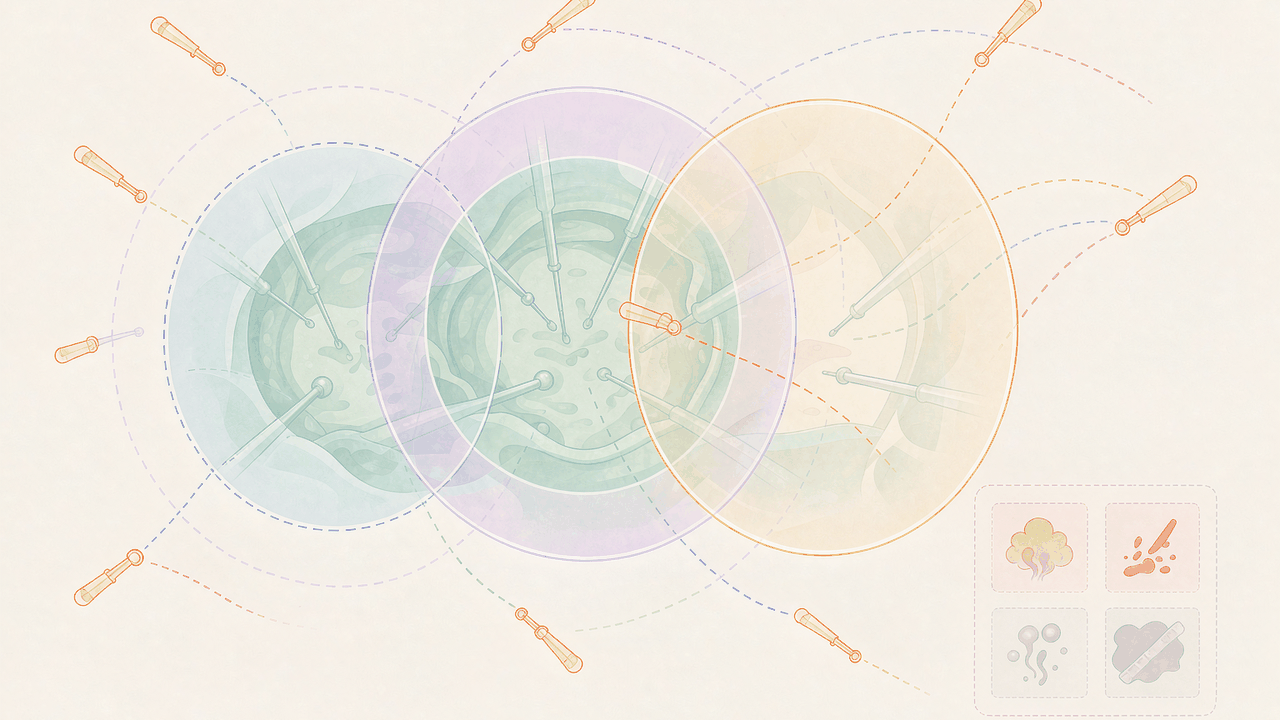
信息速览
INFOBOX — CholecTrack20 一屏速览
维度 内容 本质 腹腔镜胆囊切除手术视频的多类多器械多视角追踪数据集(非分割、非三元组识别) 团队 CAMMA(University of Strasbourg / CNRS / INSERM / ICube / IHU Strasbourg)+ University of Basel / Clarunis 论文 CVPR 2025(pp.8942-8952);arXiv:2312.07352 v1 2023-12-12 / v2 2025-03-24 一作 Chinedu Innocent Nwoye;通讯 Nicolas Padoy 数据 20 段全长春囊切除视频;1 FPS 标注;>35K 帧;65K 器械实例 视角 三视角轨迹:术中(intraoperative)/ 体内(intracorporeal)/ 可见性(visibility) 器械 7 类:grasper/bipolar/hook/scissors/clipper/irrigator/specimen bag 操作者 4 类:MSLH / MSRH / ASRH / NULL 划分 train 10 / val 2 / test 8 指标 HOTA、CLEAR MOT、Identity、Count、DetEval AP;TrackEval/DetEval 库 核心结论 SOTA < 45% HOTA,未达临床精度;术中视角最难(最佳 HOTA 17.4)获取 请求制:DUA → 填表领 accesskey → Synapse.org(表单 2025-03-25 起) 许可 CC-BY-NC-SA 4.0(非商业) 库内互链 CholecT50(rid 223)、Cholec80(rid 78)、CholecSeg8k(rid 233)
CholecTrack20 是一份「把追踪的『追踪』重新定义一遍」的手术视频数据集。它不做分割、不做动作识别,只专注一件事:在腹腔镜视频里把一把器械从它进体一直到出体,认成同一把。难点在于——手术中器械会移出相机视野(OOCV)、会退出患者身体(OOB)、会被另一把器械替班、会被出血和烟雾遮住。传统追踪数据集把「轨迹」定义成「在画面里连续出现的这一段」,于是这些手术特有的中断全部被当成新目标,轨迹碎成渣。
CAMMA 团队的解法是把「一条器械轨迹」拆成三种视角同时标注:只算画面里(可见性)、算到体内但可出画(体内)、算到器械离体为止(术中)。同一段视频因此有三套轨迹 ID,任务难度递增:术中视角要跨出画和离体做重识别,最难,最佳方法 HOTA 只有 17.4;可见性视角只算画面内,最易,最佳 44.7。这个「一个数据集、三种难度、三套标尺」的设计,是它区别于库内 Cholec80(阶段识别)和 CholecT50(三元组识别)的立身之本。
导语读法三则:
- 只想下数据:直奔 §6 获取与许可——注意是「DUA + 表单 + Synapse」三步请求制,没有直链,别被 GitHub 仓库的代码仓库假象骗了。
- 关心追踪任务本身:直奔 §2 三视角定义与 §5 基准表——先想清楚你要的是哪条轨迹,再读对应的 HOTA 行。
- 做手术视频预训练/评测:直奔 §7 与 §10——CholecTrack20 与 Cholec80/CholecT50 视频重叠,跨库使用前必须先做重叠核对。
§0 导读:这个数据集解决什么问题
手术视频 AI 有一条被反复踩的暗沟:数据集的任务定义决定了模型的天花板,而医学数据集的任务定义常常是从通用视觉领域「借」来的。追踪(tracking)就是重灾区。
通用多目标追踪(MOT)的经典定义假定目标是「在画面里连续移动的物体」,进出画即进出轨迹。放到腹腔镜手术里,这个假定处处失效:
- 器械移出相机视野(Out of Camera View, OOCV):腔镜视野只有几厘米,外科医生的手经常把器械抽出画面去换器械或清理;
- 器械退出患者身体(Out of Body, OOB):器械经套管(trocar)退出体外,画面上完全看不到;
- 器械替班:助手把一把抓钳交给主刀,画面里「旧的消失、新的出现」,通用追踪会切成两条轨迹,但临床语义上是「同一个操作位置的一把器械」;
- 视觉挑战:出血、烟雾、反光、镜头污染、器械拥挤,都会让外观特征失效,基于外观的重识别(re-ID)随之崩溃。
结果是:在通用追踪数据集上训练的方法,一到手术场景就退化,而且退化得很难解释——因为你无法判断是模型不行,还是任务定义本身把问题问错了。
CholecTrack20 的核心主张是:追踪的「轨迹」不该只有一个定义,不同临床任务需要不同的时间跨度(temporal duration):
| 临床任务 | 需要的轨迹视角 | 时间跨度 |
|---|---|---|
| 实时反馈、安全区估计 | 可见性(visibility) | 器械在相机视野内的每一段 |
| 工作流分析、阶段识别 | 体内(intracorporeal) | 器械在患者体内的整段(含出画重识别) |
| 技能评估、人机协作 | 术中(intraoperative) | 器械终生轨迹(含出画重识别 + 离体重识别) |
这一「一份数据、三套轨迹」的形式化,是 CholecTrack20 对手术视觉领域的头号贡献,也是它区别于所有前作的地方——它不是更大的数据集,而是把问题重新定义过的数据集。
为什么它值得进 AI-Ready 库:它把「数据集任务定义」这一常被忽视的维度做成了一个可评测、可对比、可复用的对象。任何做手术视频追踪的团队,只要用 CholecTrack20,就必须先回答「你追的是哪条轨迹」——这个强制性追问本身,就是它最大的方法学价值。
0.1 追踪问题在手术场景里的特殊性
要理解 CholecTrack20 的必要性,先要理解为什么通用追踪的形式化在手术里会失效。通用多目标追踪(MOT)的经典锚点是「可见性」——目标在画面里就是一条轨迹,出画即结束。这套定义在行人追踪(MOTChallenge)、车辆追踪、舞蹈追踪(DanceTrack)里都够用,因为那些目标永不出画。但腹腔镜手术把这一假定彻底打破:
第一层失效——器械移出相机视野(OOCV)。 腔镜视野只有几平方厘米,外科医生为了换器械、清理器械或调整角度,会频繁把器械抽到画面外。此时器械还在体内,仍在被使用,只是因为角度没拍到而已。通用追踪会在这里断轨,把「一次连续使用」切成两段。
第二层失效——器械退出患者身体(OOB)。 器械经套管(trocar)完全退出体外,画面上彻底消失。它可能过一会儿换一个方向再进来。通用追踪无法把「出去的那把」和「进来的那把」关联起来。
第三层失效——器械替班。 主刀把抓钳交给助手、助手递上剪刀——画面里「旧的消失、新的出现」,但临床语义上这是同一个手术步骤内的器械切换。追踪系统若不能区分「替班」与「同一把的短暂遮挡」,就会产生虚假的轨迹分裂。
第四层失效——外观特征不可靠。 手术场景的视觉挑战(出血、烟雾、反光、镜头污染、器械拥挤)会让基于外观的重识别(re-identification, re-ID)失效。通用追踪依赖的「外观相似度」在这里经常给不出答案。
这四层失效叠加,正是 CholecTrack20 诞生的直接动因:当「轨迹」的定义本身就是问题的一部分时,数据集必须先把这个定义显式化。三视角形式化就是这个显式化的产物。
0.2 「数据集任务定义」作为一等公民
多数数据集的论文把「任务定义」写在方法部分,一笔带过。CholecTrack20 反其道而行——它把「追踪的形式化」本身作为核心贡献的第一条列出(论文 contributions 第 1 条)。这在数据集论文里并不常见。
这一取向的价值在于:它让「任务定义」从隐式假设变成显式对象,从而可讨论、可比较、可复用。当后续研究者说「我的方法在 CholecTrack20 上 HOTA 更高」时,他必须先声明「在哪个视角下」——这避免了大量「鸡同鸭讲」式的比较。对医学 AI 而言,这种「先定义再评测」的严谨性尤为重要,因为临床应用的差异(实时反馈 vs 技能评估)恰恰就落在轨迹定义这一层。
0.3 本文的阅读坐标
为帮助读者建立地图,本条目按「是什么 → 长什么样 → 怎么来的 → 有多难 → 怎么拿 → 和谁有关」展开:
- §1:速览与横向对照,30 秒建立全局;
- §2:数据构成、三视角定义、格式与血缘边界;
- §3:标注体系的工作含义(三视角不是三份标注,而是三种读法);
- §4–§5:论文、团队、时间线,与检测/追踪基准的完整数字;
- §6:请求制获取与 CC-BY-NC-SA 许可、DAIMS 评估;
- §7–§9:CAMMA 手术视频宇宙、库内互链与重叠警示;
- §10–§11:避坑清单与总结决策卡。
若时间有限,读「INFOBOX + §1.3 四类读者 + §11.4 决策卡」三处即可完成 90% 的判断。
§1 数据集速览:十问十答
Q1:这是什么数据?
20 段腹腔镜胆囊切除手术的全长视频,逐帧(1 FPS)标注了手术器械的包围盒、类别、操作者、三条轨迹 ID、手术阶段和视觉挑战条件。— https://github.com/CAMMA-public/cholectrack20
Q2:谁做的?
CAMMA 研究组(University of Strasbourg / CNRS / INSERM / ICube UMR7357 / IHU Strasbourg)+ University of Basel / Clarunis。一作 Chinedu Innocent Nwoye,通讯 Nicolas Padoy。— https://camma.u-strasbg.fr/datasets/
Q3:发了在哪里?
CVPR 2025(pp.8942-8952);arXiv:2312.07352(v1 2023-12-12,v2 2025-03-24)。— https://arxiv.org/abs/2312.07352
Q4:有多大?
20 段视频、1 FPS 标注、超过 35K 帧、65K 个器械标注实例。原始视频 25 FPS(仅测试集提供)。— arXiv 摘要 / GitHub README
Q5:标了什么?
每个器械实例:空间包围盒、类别(7 类)、操作者(4 类)、三条视角轨迹 ID、所属手术阶段、帧视觉挑战状态。— GitHub README
Q6:三视角是什么?
可见性(画面内)、体内(体内含出画重识别)、术中(终生含出画+离体重识别)。— arXiv 摘要
Q7:怎么划分的?
官方划分 train 10 / val 2 / test 8 视频。— GitHub README
Q8:怎么做基准?
检测用 DetEval(基于 COCO API 的 AP);追踪用 TrackEval 适配版(HOTA / CLEAR MOT / Identity / Count)。— GitHub README
Q9:SOTA 怎么样?
远不够用:当前方法均 < 45% HOTA;术中视角最佳 Bot-SORT 只有 17.4 HOTA。— arXiv 摘要 / GitHub README
Q10:怎么拿、什么许可?
CC-BY-NC-SA 4.0,请求制:读 DUA → 填表领 accesskey → Synapse.org 下载。表单 2025-03-25 起接受响应。— GitHub README
一句话定位:库内 Cholec80 答「现在到哪个阶段」,CholecT50 答「在做什么动作」,CholecTrack20 答「这把器械从哪来到哪去」——三者构成 CAMMA 手术视频理解的三根柱子。
Q11:为什么叫「多视角(multi-perspective)」而不是「多相机(multi-view)」?
这是最容易望文生义的坑。「perspective」在这里不是指多个摄像头视角,而是指对「一条轨迹」这一概念的三种定义方式(可见性/体内/术中)。数据集本身仍是单目腔镜视频,没有多路相机。把它误解为「多相机追踪数据集」会导致检索方向完全跑偏。— arXiv 摘要
Q12:20 段视频的「20」够用吗?
单看视频段数确实不多,但这是全长手术视频(每段是完整的胆囊切除过程,不是片段),且标注极密(65K 实例)。在手术视频领域,由于隐私与标注成本,数据集普遍不大——Cholec80 是 80 段、CholecT50 是 50 段,CholecTrack20 的 20 段虽小,但标注维度最丰富(追踪 ID × 三视角)。规模小是被任务复杂度而非懒惰决定的。
Q13:它和手术机器人(如 da Vinci)的数据有关系吗?
没有直接关系。CholecTrack20 是腹腔镜(laparoscopic)手术,器械经套管手动操作,不是机器人手术(robotic surgery)。数据中的「操作者」标签(MSLH/MSRH/ASRH)是手部/操作通道维度,不是机器人臂。做机器人手术追踪的检索者需另寻数据集。
Q14:这个数据集有「官方挑战赛」吗?
截至本条目核实期,没有为 CholecTrack20 单独举办挑战赛;它提供官方划分与公开排行榜(Papers with Code)作为评测载体。这一点与 CholecT50(有 CholecTriplet2021/2022 挑战赛)不同——检索者不应假定存在「CholecTrack Challenge」。— GitHub README
1.1 与库内 Cholec 系条目横向对照
为帮助检索者一眼分辨,把库内四个 Cholec 系条目并列:
| 条目 | rid | 任务 | 输出粒度 | 视频数 | 规模 | 获取 |
|---|---|---|---|---|---|---|
| cholec80 | 78 | 阶段识别 | 帧级阶段 | 80 | 阶段标签 | 请求制 |
| cholect50 | 223 | 三元组识别 | 帧级 <器械,动词,目标> |
50 | 100.9K 帧 / 151K 实例 | 请求制 |
| cholecseg8k | 233 | 语义分割 | 像素级 13 类 | 17 段片段 | 8,080 帧 | Kaggle 公开 |
| cholectrack20 | 本条目 | 多视角追踪 | 器械级三视角轨迹 | 20 | >35K 帧 / 65K 实例 | 请求制(Synapse) |
关键差异一句话:前三个条目回答「画面里发生了什么」(阶段/动作/像素类别),本条目回答「每把器械的时空轨迹是什么」——它是唯一带「身份(identity)」维度的 Cholec 系数据集。
1.2 三条硬数字的来源锚点
| 硬数字 | 数值 | 出处 |
|---|---|---|
| 视频数 | 20 | CAMMA 官方页 + GitHub README + arXiv 三源一致 |
| 帧数 | >35K | arXiv 摘要 + CVPR 摘要 |
| 器械实例 | 65K | arXiv 摘要 + CVPR 摘要 |
| 轨迹 ID 数 | 术中 70 / 体内 247 / 可见性 916 | GitHub README 基准表 |
| 检测框数 | 29994(三视角恒定) | GitHub README 基准表 |
| 器械类别 | 7 | GitHub README + arXiv Fig.1 |
| 操作者 | 4 | GitHub README |
| 划分 | 10/2/8 | GitHub README |
1.3 三类典型读者与推荐入口
读者 A:多目标追踪研究者(想找个新场景刷方法)
直奔 §2.2(三视角定义)与 §5.2(追踪基准表)。你会关心「可见性视角最佳 HOTA 44.7、术中视角仅 17.4」这组数字,以及为什么 IDF1 这么低。别急着下数据,先想清楚你要 claim 的是哪个视角的 SOTA。
读者 B:临床 AI 应用开发者(想做术中提示/技能评估系统)
直奔 §0.2(任务驱动形式化)与 §7.6(下游应用三路径)。你要先回答「系统是实时提示还是离线评估」,据此选视角;再评估请求制获取的时间成本与 NC 许可是否可接受。
读者 C:数据集方法论研究者(关心怎么设计数据集)
直奔 §8(方法学启示)与 §2.5(家族边界重叠)。CholecTrack20 的「同源多任务衍生」范式、三视角形式化、多指标讲故事的设计都值得借鉴;同时它的重叠代价也是反面教材。
读者 D:只想快速判断「要不要用它」的决策者
直奔 §11.4(30 秒决策卡)与 §6.5(可获取性档位)。若你在意「当天能下到」,答案很可能是「否」。
§2 数据构成与规格
2.1 规模、来源与机构构成
CholecTrack20 的数据规模硬数字(三源一致):
| 维度 | 数值 | 来源 |
|---|---|---|
| 视频数 | 20 段全长腹腔镜胆囊切除视频 | CAMMA 页 / GitHub / arXiv 三源一致 |
| 标注帧率 | 1 FPS | GitHub README / arXiv 摘要 |
| 帧数 | 超过 35K 帧(“>35K”) | arXiv 摘要 / CVPR 摘要 |
| 器械实例 | 65K 个标注实例(“65K”) | arXiv 摘要 / CVPR 摘要 |
| 原始视频帧率 | 25 FPS(仅测试集提供 .mp4) | GitHub README |
| 官方划分 | train 10 / val 2 / test 8 | GitHub README |
来源链条:原始视频来自 CAMMA 研究组在斯特拉斯堡医学中心采集的腹腔镜胆囊切除视频池——与 Cholec80、CholecT50 同源。CholecTrack20 从中选取 20 段全长视频,在既有标签基础上「继承」部分属性(如手术阶段),并新增追踪专属标注。官方明确说明:数据集与 Cholec80、CholecT50「shares content」,且与同医学中心的其他胆囊切除数据集存在重叠,为便于识别重叠,保留了原始视频编号(VID01、VID02、VID12、VID111 等)。— https://github.com/CAMMA-public/cholectrack20
机构构成:数据采集与标注主体为 CAMMA(ICube UMR7357,University of Strasbourg / CNRS / INSERM),协作方为 IHU Strasbourg;作者中 Joël L. Lavanchy 隶属 University of Basel / Clarunis(瑞士)。这是典型的「法国主导 + 瑞士协作」的欧洲手术 AI 团队结构。
患者级规模:数据集为视频级组织,未披露独立患者数;按腹腔镜胆囊切除常规一例一视频的组织方式,可理解为 20 例手术(但官方未明确「一视频一患者」,检索者不应把 20 当作患者数断言)。本条目 patient_count 字段按「20 段视频」保守表述。
2.2 三视角轨迹:本数据集的核心
这是 CholecTrack20 与其他所有手术视频数据集的分水岭。官方把「一条器械轨迹」按时间跨度的考虑方式拆成三种:
- 可见性轨迹(visibility):器械出现在相机视野内的那一段。轨迹随器械出画而结束。这是通用 MOT 的默认口径。
- 体内轨迹(intracorporeal):器械在患者体内的整段轨迹。器械移出相机视野(OOCV)后,若它还在体内,轨迹应延续——即需要跨出画的重识别。
- 术中轨迹(intraoperative):器械的终生轨迹。不仅重识别出画(OOCV),还维持器械退出身体(OOB)期间的轨迹身份。这是最贴近临床「同一把器械」语义、也最难的一种。
官方定义原文(README):
Intraoperative tracking not only re-identifies tools out of camera view (OOCV) as done in intracorporeal tracking but also maintains their trajectory when out of body (OOB).
OOB(器械离体)的三种判定方式(官方明确):
- 视觉上观察到器械退出套管(trocar);
- 由另一把器械经同一套管进入来推断(一进一出);
- 初始器械在失焦状态下释放了抓持。
这三条判定规则是标注协议里最「外科领域知识密集」的部分——它无法从像素直接读出,必须依赖对手术流程的理解。这也是为什么该数据集标注成本高于通用追踪数据集。
三视角的 groundtruth 计数(README 追踪基准表,@25 FPS):
| 视角 | #Dets(检测框数) | #IDs(轨迹数) | 平均每轨迹帧数(≈29994/#IDs) |
|---|---|---|---|
| 术中 intraoperative | 29994 | 70 | ≈428 |
| 体内 intracorporeal | 29994 | 247 | ≈121 |
| 可见性 visibility | 29994 | 916 | ≈33 |
数据读法:检测框数恒定(同一批器械框),但轨迹 ID 数量随视角放宽而暴涨(70 → 247 → 916),平均每条轨迹的长度则从约 428 帧坍缩到约 33 帧。这直观显示了「轨迹碎裂」问题:只按画面可见性看,一条器械平均只能连续追踪约 33 个采样点(33 秒);按术中视角整合,同一条器械能维持约 428 个采样点(约 7 分钟)。视角选择把「有 70 个目标」变成「有 916 个目标」,任务难度与评测口径随之完全改变。
2.3 标注属性与类别体系
器械类别(7 类):grasper(抓钳)、bipolar(双极电凝钳)、hook(L 形钩/电凝钩)、scissors(剪刀)、clipper(夹钳)、irrigator(冲洗器)、specimen bag(标本袋)。— GitHub README / arXiv Fig.1
操作者(4 类):MSLH(Main Surgeon Left Hand,主刀左手)、MSRH(主刀右手)、ASRH(Assistant Surgeon Right Hand,助手右手)、NULL(空/无归属)。— GitHub README
手术阶段(phase):沿用 CAMMA 胆囊切除的阶段体系(Cholec80 的 7 阶段:preparation / calot triangle dissection / clipping and cutting / gallbladder dissection / gallbladder packaging / cleaning and coagulation / gallbladder retraction)。README 未列出完整名单,本条目标为待核。— 依据 Cholec80 体系推断
视觉挑战(visual challenges):论文 Fig.1 附图列出了 bleeding(出血)、blurring(模糊)、crowded(拥挤)、trocar view(套管视野)、reflection(反光)、smoke(烟雾)、occlusion(遮挡)、lens fouling(镜头污染)、blood stain(血迹)等命名。具体最终清单与计数以论文正文为准(本轮 PDF 抓取超时,标为遗留疑点)。
其他属性:官方 README 提到标签还含 spatial coordinates(空间坐标)、track identities、frame visual conditions 等,并在数据记录表中列出「本数据集引入的属性」与「继承自源数据的属性」两类。
2.4 数据格式与目录结构
数据集为单个 zip 文件,含三个 split 子目录,每段视频序列含三项内容:
- 原始匿名 .mp4 视频(25 FPS)——仅测试集提供;
- 1 FPS 采样帧文件夹——与标签一一对应;
- JSON 标签文件——结构为「以帧 ID 为键的字典」,每个键对应的记录数 = 该帧内的器械数;每条记录(属某把器械)以字典属性携带全部标签,例如:
tool_bbox: [120.0, 132.0, 23.0, 65.0]
category: 3
operator: 3
intraoperative_track_id: 7
(字段为示意,取自官方 README 原文示例。)— https://github.com/CAMMA-public/cholectrack20
格式转换工具:官方提供 conversion.py,可将 JSON 标注转为 MOTChallenge、COCO、TAO 等主流格式,以便直接接入对应数据加载器。— GitHub README
JSON 结构的读法示例(官方 README 原文给出示例字段):假设某帧 ID 下有 2 把器械,则该帧对应 2 条记录;每条记录是一个字典,例如:
"frame_id": {
  "0": {"tool_bbox": [120.0, 132.0, 23.0, 65.0], "category": 3, "operator": 3,
        "intraoperative_track_id": 7, "intracorporeal_track_id": 19, "visibility_track_id": 65, ...},
  "1": {...}
}
注意:同一把器械在三条视角下会携带三个不同的轨迹 ID(示例中 7 / 19 / 65)——这正是三视角形式化在数据层面的落地方式。检索者解析 JSON 时必须明确取哪条 track id 字段,取错字段会得到完全不同的「轨迹数」。
2.5 与 Cholec 家族的边界与重叠
这是检索者必须读清楚的一节,也是本条目与库内 Cholec 系条目发生关系的地方。
任务边界:
| 数据集 | 任务 | 输出 |
|---|---|---|
| Cholec80 | 手术阶段识别 | 每帧 7 类阶段标签 |
| CholecT50 | 手术动作三元组识别 | <器械, 动词, 目标> 三元组 |
| CholecSeg8k | 语义分割 | 每像素 13 类 |
| CholecTrack20 | 多类多器械追踪 | 每器械包围盒 + 三视角轨迹 ID + 操作者 + 阶段 + 视觉挑战 |
内容重叠:官方声明 CholecTrack20 与 Cholec80、CholecT50 及其他同医学中心胆囊切除数据集存在内容重叠,并保留 VID 编号以便识别。官方提醒:VID 前缀在其他数据集中可能写作 Video。这是跨库使用的头号风险:若把 Cholec80 用作 CholecTrack20 的预训练数据,可能造成视频级(乃至帧级)数据泄漏,使评测虚高。— https://github.com/CAMMA-public/cholectrack20
CAMMA 另维护 camma_dataset_overlaps 仓库,专门给出跨数据集重叠矩阵与合并建议(这一点在库内 cholec50 条目的 FACTS 中亦有记录)。检索者若做多库联合实验,应以此为权威依据。
2.6 拿到数据后的处理建议
若成功申请到 CholecTrack20,建议的接入顺序:
- 先跑 conversion.py,把 JSON 转成你熟悉的格式(MOTChallenge 做追踪评测、COCO 做检测);
- 确认你用的视角:明确取
intraoperative_track_id/intracorporeal_track_id/visibility_track_id中的哪一个——这决定你的「目标数」; - 对齐帧率:训练用 1 FPS 采样帧,评测若要与官方表对齐则需在 25 FPS 上进行;
- 先做重叠核对:若同时用 Cholec80/CholecT50,先查
camma_dataset_overlaps; - 分场景评测:利用 visual conditions 标签做 bleeding/smoke/crowded 等子集评测,这比单一总体指标更有信息量。
2.7 从数字推算出的几个直觉
用公开硬数字做几个简单推算,有助于建立对数据集的直觉:
- 每帧平均器械数:65K 实例 ÷ 35K 帧 ≈ 1.86 把/帧。也就是说画面上平均同时有不到两把器械。这符合腹腔镜胆囊切除的实况——通常主刀一手持抓钳、一手持电凝钩,助手偶有器械。
- 每段视频平均帧数:35K ÷ 20 = 约 1,750 帧 = 约 1,750 秒 ≈ 29 分钟。胆囊切除手术通常 30-90 分钟,采样后 1,750 帧(约半小时)是合理的量级。
- 可见性视角下的碎片化:916 条可见性轨迹 ÷ 20 视频 ≈ 每视频 46 条轨迹;而术中视角只有 70 ÷ 20 = 3.5 条/视频。也就是说每段手术里真正被使用的器械只有三四把,但它们在画面里会进出 46 次。这个「3.5 对 46」的对比,是 CholecTrack20 想说清楚的核心矛盾。
- 检测框数恒定 29994:这是三视角共享的物理标注量,约等于 65K 的一半数量级(65K 含更多属性实例计数口径差异,具体见遗留疑点)。
这些推算是「用已有硬数字建立量感」,不引入新数字,但对理解数据集的实际形态很有帮助。特别提醒:以上除法结果是本条目为帮助理解所做的推算,不是官方数字,引用时请回到原始硬数字。
§3 标注体系与三视角的工作含义
3.1 三视角不是「三份标注」,而是「同一份标注的三种读法」
一个常见的误解是把三视角理解为「团队标了三遍」。实际更接近:标注者标出器械的连续身份,然后在轨迹归并规则上按三种粒度输出三套 track ID。物理标注(包围盒、类别、操作者)是共享的,差异在于「什么时候判定一条轨迹结束、什么时候判定两条轨迹是同一条」。
- 可见性视角:出画即断。
- 体内视角:出画但在体内 → 不断;离体 → 断。
- 术中视角:出画不断、离体不断 → 只有器械真正退役才断。
因此三套轨迹 ID 是同一批包围盒的三种分组方案,#Dets 恒为 29994,而 #IDs 从 916 折叠到 70。
3.2 为什么三视角是必要的:临床任务反推
论文的论证逻辑是「从应用需求反推形式化」,而非「先造数据再想用途」:
- 实时反馈 / 安全区估计:系统要告诉外科医生「你的钳子现在在哪、离关键结构多近」。这只需要当前画面内信息——可见性视角足够,且计算最省。
- 工作流分析 / 阶段识别:需要知道「这把器械在体内待了多久、什么时候进来的」。器械出画但仍在体内时必须保持身份——体内视角。
- 技能评估 / 人机协作:需要完整的手术动作轨迹,「这把器械被使用了几次、每次用多久」。器械离体再入体也应视为同一把的连续使用——术中视角。
同一段手术视频,对三类应用提供三种不同粒度的答案。这种「任务驱动」的数据集设计哲学,是 CholecTrack20 最值得库内其他条目借鉴之处。
3.3 标注难点的外科知识密度
CholecTrack20 的标注难点不在于画框(检测层面 YOLO 系列已能做),而在于身份判定:
- 器械移出画面后再出现,如何确认是「同一把」而非「助手换了一把」?——需要理解套管位置:同一套管进出的通常是同类器械的同一操作通道。
- 器械离体的判定:画面里看不清退出动作时,需要从「另一把器械经同一套管进入」反推。
- 器械拥挤(crowded)时的遮挡归因:哪把器械挡住了哪把,需要外科场景知识。
这些判定规则(前述 OOB 三条)体现了该数据集极高的领域知识密度:标注者不只是画框工人,而是接受过手术流程培训的标注员。论文正文约会有标注员培训与质控的描述,但本轮未抓取到(标为遗留疑点)。
3.4 数据质量与可利用性的现实边界
- 视觉挑战导致的退化是数据集的「特性」而非「缺陷」:官方把出血、烟雾、反光等作为显式标签给出,正是为了让研究者能分场景评测——这是设计上的优点。
- 帧率不一致需注意:标注在 1 FPS,评测在 25 FPS(README 追踪表标注 @25 FPS)。做追踪时需明确你用的是采样帧还是原始帧序列。
- 类别长尾:7 类器械中,specimen bag、bipolar 等出现频率远低于 grasper/hook,检测与追踪指标在稀有类上会明显偏低。
3.5 逐视角的工作量与失败模式
三视角不仅在评测上难度不同,在模型设计的失败模式上也各有侧重:
- 可见性视角:主要失败来自密集遮挡与外观混淆(crowded、occlusion)。模型需要强检测与短时关联。
- 体内视角:主要失败来自「出画-入画」的重识别。模型需要能跨帧记忆中段缺失的轨迹,并判「是同一把还是新的一把」。
- 术中视角:主要失败来自「离体-再入体」的长时间重识别,以及 OOB 判定的歧义。这是身份保持的终极考验。
从基准表可以印证:随视角放宽(ID 从 916 折到 70),IDF1 从 41.4 掉到 10.2。也就是说,越接近临床语义的视角,现有方法的身份保持能力越差——这恰恰是该数据集最想暴露的问题。
3.6 标注的隐藏成本
CholecTrack20 的标注成本远高于「画框 + 分类」的常规检测数据集,原因有三:
- 轨迹一致性维护:跨出画、跨离体保持 ID 一致,需要标注员记住整段手术的器械使用历史;
- 外科语义判定:OOB 的三条判定规则需要外科流程知识,标注员须经专门培训;
- 多视角输出:同一批物理标注要按三种归并规则产出三套轨迹,增加了后处理复杂度。
这也是为什么该数据集只有 20 段却仍有很高价值——标注密度的提升补偿了视频数量的不足。相较之下,纯粹扩大视频数而不提升标注维度的做法,边际价值反而更低。
3.7 三视角的形式化对照表
为便于理解,把三视角在「何时断轨」上的判定整理成一览:
| 事件 | 可见性 | 体内 | 术中 |
|---|---|---|---|
| 器械被遮挡(仍在画面) | 不断 | 不断 | 不断 |
| 器械移出相机视野 OOCV | 断 | 不断 | 不断 |
| 器械退出患者身体 OOB | 断 | 断 | 不断 |
| 器械真正退役(不再使用) | 断 | 断 | 断 |
| 器械替班(换一把同类) | 断 | 断 | 断(不同器械) |
读法:从可见性到术中,轨迹的生命周期被逐层「延长」——每放宽一层,就有更多「中断」被判定为「仍属同一轨迹」。这正是 #IDs 从 916(断得最多)降到 70(断得最少)的机制。
一个常见的标注歧义:器械「替班」和器械「出画后重新入画」在像素上可能长得一样(都是旧的消失、新的出现)。三视角形式化的价值之一,就是要求标注者在语义层面区分它们——替班是新轨迹,出画再入画是同轨迹。这种区分对标注员的领域知识要求很高。
3.8 属性清单整理
综合 README 与论文,CholecTrack20 每条器械记录携带的属性可归为五组:
- 空间组:
tool_bbox(包围盒坐标 [x, y, w, h]); - 分类组:
category(7 类器械之一); - 操作者组:
operator(MSLH / MSRH / ASRH / NULL); - 身份组:三条轨迹 ID(intraoperative / intracorporeal / visibility);
- 场景组:
phase(手术阶段)、visual conditions(遮挡/出血/烟雾等)。
这五组属性使单条记录同时成为「检测样本 + 分类样本 + 追踪样本 + 场景上下文」。研究者可以只取其中一组做单一任务,也可以全取做多任务联合建模——灵活度很高。
§4 论文、团队与时间线
4.1 论文档案
- 正式题名:CholecTrack20: A Multi-Perspective Tracking Dataset for Surgical Tools
- 发表:Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 2025,June 2025,pp.8942-8952
- 预印本:arXiv:2312.07352(v1 2023-12-12;v2 2025-03-24)
- 篇幅:11 页,10 图,3 表
- 学科:Computer Vision and Pattern Recognition (cs.CV);Artificial Intelligence (cs.AI)
- DOI(arXiv):10.48550/arXiv.2312.07352
标题双口径存照:v1(2023)标题为「CholecTrack20: A Dataset for Multi-Class Multiple Tool Tracking in Laparoscopic Surgery」;v2(2025)与 CVPR 版标题为「CholecTrack20: A Multi-Perspective Tracking Dataset for Surgical Tools」。同一数据集两版标题并存,引用时应以 CVPR 2025 版为准。
4.2 作者与机构
| 作者 | 机构 |
|---|---|
| Chinedu Innocent Nwoye(一作) | University of Strasbourg, CNRS, INSERM, ICube, UMR7357 / IHU Strasbourg |
| Kareem Elgohary | ICube, University of Strasbourg |
| Anvita Srinivas | ICube, University of Strasbourg |
| Fauzan Zaid | ICube, University of Strasbourg |
| Joël L. Lavanchy | University of Basel, University Digestive Health Care Center, Clarunis(瑞士) |
| Nicolas Padoy(通讯) | ICube, University of Strasbourg / IHU Strasbourg |
Nwoye 的谱系意义:Chinedu Innocent Nwoye 同时是 CholecT50 数据集页的维护者、Rendezvous(RDV)三元组识别模型的一作、以及多多篇 CAMMA 手术视频论文的核心作者。他参与 CholecTrack20,意味着该数据集与 CholecT50 在同一批人手里延续——这也解释了为何两者共享 VID 编号与阶段标签体系。
资助:ANR(AI4ORSafety ANR-20-CHIA-0029-01、DeepSurg ANR-16-CE33-0009、IHU Strasbourg ANR-10-IAHU-02);BPI France(CONDOR、5G-OR);Swiss National Science Foundation(Lavanchy:P500PM_206724、P5R5PM_217663)。HPC 由 CAMMA / IHU Strasbourg / Unistra Mesocentre / GENCI-IDRIS(2021-AD011011638R3/R4)支持。
4.3 时间线
| 日期 | 事件 | 来源 |
|---|---|---|
| 2023-12-12 | arXiv:2312.07352 v1 提交(标题为 “A Dataset for Multi-Class Multiple Tool Tracking…”) | arXiv |
| 2025-02-26 | 论文被 CVPR 2025 接收 | GitHub News |
| 2025-02-28 | 完整数据集在 Synapse.org 发布 | GitHub News |
| 2025-03-15 | GitHub 仓库 utils/、DUA.md 初始提交 | GitHub commit |
| 2025-03-24 | arXiv v2 修订(改为 “A Multi-Perspective Tracking Dataset…”) | arXiv |
| 2025-03-25 | 数据集请求表单开始接受响应 | GitHub README |
| 2025-04-03 | images/ 上传(示例图) | GitHub commit |
| 2025-11-10 | DATA_FORMAT.md 创建 | GitHub commit |
| 2026-02-21 | TrackEval 库加入 CholecTrack20 MOT 评测支持 | GitHub News / commit |
这条时间线显示:v1 预印(2023 底)→ CVPR 接收与数据发布(2025 初)→ 评测生态接入(2026)的完整链路。注意数据发布晚于论文接收,且请求表单开放又晚于数据发布近一个月,检索者引用「公开时间」时应区分「Synapse 发布(2025-02-28)」与「表单开放(2025-03-25)」两个节点。
4.4 论文贡献的三条主线
按论文自述,主要贡献有三:
- 引入 CholecTrack20——一个带丰富标注的「多视角追踪」先驱数据集;
- 大量实验分析——验证该数据集在手术器械检测与追踪上的有效性;
- 跨视觉挑战的方法性能洞察——揭示每种追踪视角对 AI 驱动手术方案的实用性差异。
第 3 条尤其值得注意:论文不只是「发布数据 + 报个榜」,而是把「每种视角对下游应用有多大用」当作一个科学问题来回答。这呼应了 §0 的「任务驱动」取向——视角不是标注的副产品,而是被研究的主体。
4.5 会议与社区反馈
CVPR 是计算机视觉三大顶会之一,医学影像方向在 CVPR 的接收意味着该数据集被通用 CV 社区而非仅医学影像社区认可。这对数据集的可见度有实质帮助:它进入了 leaderboard(Papers with Code)生态、进入了 TrackEval 支持列表(2026),并被后续方法(SurgiTrack)作为刷榜对象。数据集的「活性」在发布一年后仍在延续。
4.6 论文的实验设计
论文的实验分两大块,对应两个子任务:
检测实验:以主流检测器(Faster-RCNN、YOLO 系、DETR 系等 13 个)在 CholecTrack20 上评测 AP,并按器械类别、按视觉挑战场景分组报告。分组报告的用意是揭示「哪类器械难检、哪类视觉干扰最致命」,而非只给一个总 AP。
追踪实验:以主流追踪方法(SORT、ByteTrack、Bot-SORT 等)在三个视角上分别评测,用 HOTA 及 CLEAR/Identity/Count 系列指标,并按手术阶段、按视觉挑战分组报告。分组揭示「哪个手术阶段最难追、哪种视角最考验方法」。
这种「多维度分组评测」的设计,使论文的结论不止于「谁第一」,而能回答「为什么难」——这是数据集论文里较高的实验标准。
4.7 论文的三个关键发现(据摘要与 README 表)
- 性能鸿沟:当前 SOTA
< 45% HOTA,未达临床转化精度——这是论文的核心警句; - 视觉挑战是主因:出血、烟雾、反光、遮挡场景下性能显著退化;
- 视角价值差异:不同视角对下游 AI 手术方案的价值不同,可见性视角偏实时反馈、术中视角偏技能评估。
这三条共同支撑了论文的立论:手术追踪需要「先进且直觉的算法」,而 CholecTrack20 是开发这类算法的基础。
§5 基准与评测
5.1 检测基准(DetEval / COCO AP 口径)
官方 README 给出 13 个检测模型的基准(AP@0.5 / AP@0.75 / AP@0.5:0.95,及逐类 AP@0.5):
三个阈值下的总体 AP(节选,@0.5 / @0.75 / @0.5:0.95):
| 模型 | AP@0.5 | AP@0.75 | AP@0.5:0.95 |
|---|---|---|---|
| YOLOv7 | 80.6 | 62.0 | 56.1 |
| YOLOv9 | 80.2 | 62.6 | 56.5 |
| YOLOv10 | 80.1 | 62.1 | 55.8 |
| YOLOv8 | 79.1 | 62.4 | 55.6 |
| YOLOX | 64.7 | 48.9 | 44.2 |
| PAA | 64.5 | 44.9 | 41.1 |
| Swin-T | 62.3 | 44.3 | 40.2 |
| SSD | 61.9 | 37.8 | 36.1 |
| Faster-RCNN | 56.0 | 38.1 | 34.6 |
| Def-DETR | 58.4 | 42.0 | 38.3 |
| Cascade-RCNN | 51.7 | 39.0 | 34.7 |
| CenterNet | 53.0 | 39.5 | 35.0 |
| FCOS | 43.5 | 31.5 | 28.1 |
读法:YOLO 系(v7/v8/v9/v10)明显领先(AP@0.5 约 80),R-CNN 系与 DETR 系落后 15-25 个点。这说明检测层面任务已相对成熟——瓶颈不在「能不能框住器械」,而在追踪身份。
逐类 AP@0.5(节选):irrigator(YOLOv8 96.2)、hook(SSD 91.6)、clipper(YOLOv7 89.3)较高;specimen bag、bipolar 相对较低。类别频率与外观独特性共同决定检测难度。
视觉挑战下的 AP 退化:README 表按 bleeding / blur / smoke / crowded / occluded / reflection / foul / lens / trocar 等场景分列。多数模型在 bleeding、blur、crowded 场景下 AP 显著下降(例如 Faster-RCNN 全场景 AP@0.5=28.9,在 blur 场景降至 31.8、在 foul 场景 35.7,波动明显)。这印证了「视觉挑战是手术追踪的核心难点」这一论文主张。
5.2 追踪基准(TrackEval,三视角分列)
官方 README 给出 6 个追踪方法的基准,按三视角分别评测(@25 FPS)。这是本数据集最关键的一张表:
术中视角(点 #IDs = 70,最难):
| 模型 | HOTA↑ | MOTA↑ | IDF1↑ | MT | ML |
|---|---|---|---|---|---|
| Bot-SORT | 17.4 | 69.6 | 10.2 | 58 | 1 |
| SMILETrack | 15.9 | 66.4 | 9.2 | 55 | 2 |
| ByteTrack | 15.8 | 67.0 | 9.5 | 54 | 2 |
| OCSORT | 14.6 | 49.2 | 9.5 | 24 | 14 |
| TransTrack | 7.4 | 4.2 | 4.2 | 9 | 25 |
| FairMOT | 5.8 | 5.0 | 4.3 | 3 | 43 |
体内视角(#IDs = 247,中等):
| 模型 | HOTA↑ | MOTA↑ | IDF1↑ | MT | ML |
|---|---|---|---|---|---|
| Bot-SORT | 27.0 | 70.0 | 18.9 | 188 | 21 |
| SMILETrack | 24.9 | 66.7 | 16.9 | 186 | 22 |
| ByteTrack | 24.7 | 67.4 | 16.9 | 176 | 23 |
| OCSORT | 23.7 | 47.1 | 18.1 | 115 | 45 |
| TransTrack | 13.1 | 4.6 | 8.7 | 80 | 88 |
| FairMOT | 7.5 | 5.4 | 6.0 | 19 | 168 |
可见性视角(#IDs = 916,最易):
| 模型 | HOTA↑ | MOTA↑ | IDF1↑ | MT | ML |
|---|---|---|---|---|---|
| Bot-SORT | 44.7 | 72.0 | 41.4 | 638 | 94 |
| ByteTrack | 41.5 | 69.3 | 36.8 | 591 | 108 |
| SMILETrack | 41.3 | 68.9 | 36.5 | 619 | 105 |
| OCSORT | 37.0 | 50.2 | 35.9 | 300 | 245 |
| TransTrack | 19.2 | 5.8 | 16.1 | 224 | 412 |
| SORT | 17.4 | 21.4 | 13.4 | 139 | 378 |
三条解读:
- 视角越难,HOTA 越低:最易的可见性视角最佳 44.7,最难的术中视角最佳仅 17.4——相差 27 个点。这直观量化了「跨出画 + 跨离体重识别」的难度。
- 身份指标(IDF1)普遍惨淡:即便最易视角最佳也仅 41.4,术中视角低至 10.2。说明方法能「跟上目标位置」(MOTA 不低),但认不住身份(IDF1 极低)——正是手术追踪的痛点。
- Bot-SORT 在三视角全面领先,ByteTrack / SMILETrack 紧随;TransTrack、FairMOT 全面落后。
5.3 评测指标与工具链
检测侧(DetEval):基于 COCO API 的 AP 指标(AP@0.5 / @0.75 / @0.5:0.95),是标准目标检测口径。
追踪侧(TrackEval):官方采用适配版 TrackEval,涵盖主流追踪指标:
- CLEAR MOT(MOTA / MOTP)
- Identity(IDF1 / IDSW / Frag)
- Count(MT / PT / ML — Mostly Tracked / Partially / Mostly Lost)
- HOTA(DetA / LocA / AssA 分解)
- 另有 VACE、Track mAP、J&F、ID Euclidean 等
其中 **HOTA(Higher Order Tracking Accuracy)**是核心指标,分解为 DetA(检测精度)、AssA(关联精度)、LocA(定位精度)——AssA 特别低是手术追踪的典型特征。
自动化评测入口:TrackEval 适配代码于 2026-02-21 合入,官方提供 DetEval/ 与 TrackEval/ 两个库目录;评测代码部分借用原始 TrackEval 与 Cocoapi(官方致谢)。
Leaderboard:Papers with Code 提供公开排行;README 的 Detection / Tracking Leaderboard 与之同步。
5.4 新 SOTA:SurgiTrack
README 的 “Emerging Research Methods” 一节标注 SurgiTrack 为该数据集上的新 SOTA 方法(README 仅给外链)。这说明数据集发布后已吸引后续方法在其上刷榜——数据集的「活性」良好。SurgiTrack 的正式论文出处本轮未抓取,标为遗留疑点。
5.5 评测卫生:读这张基准表的四条守则
- 先确认视角:HOTA 17.4(术中)与 44.7(可见性)不是同一件事,跨视角比数字无意义。
- 区分检测与追踪:YOLOv7 检测 AP@0.5=80.6 很漂亮,但它的关联精度(AssA)并未因此变好——检测强不等于追踪强。
- 注意帧率:追踪表标注 @25 FPS,而标注是 1 FPS;若你在 1 FPS 上评测,数字不可与此表直接比。
- 别忽略稀有类:总体 AP 被高频类(grasper/hook)主导,specimen bag 等稀有类的实际性能远低于平均值。
5.6 指标分解:DetA / AssA / LocA 讲的故事
HOTA 之所以成为本数据集的核心指标,是因为它可分解为三个子指标,能分别诊断「检测」「关联」「定位」三方面的能力:
- DetA(Detection Accuracy):检测精度。若 DetA 高说明「框得准」;
- AssA(Association Accuracy):关联精度。若 AssA 低说明「认不住身份」;
- LocA(Localization Accuracy):定位精度,通常与检测框质量相关。
从 README 表看,多数方法在术中视角的 DetA 尚可(如 OCSORT 52.7),但 AssA 极低(4.1)——关联是瓶颈,不是检测。这为后续方法指明了方向:改进重识别与轨迹关联,而非一味提升检测器。
5.7 各方法画像(追踪侧)
| 方法 | 类型 | 表现画像 |
|---|---|---|
| Bot-SORT | 检测+外观+运动 | 三视角全面最佳(HOTA 17.4/27.0/44.7),MT 最高、ML 最低,身份保持最好 |
| ByteTrack | 双阈值检测关联 | 紧随其后,MOTA 出色(67-70),工程上易复现 |
| SMILETrack | 相似度学习 | 与 ByteTrack 接近,AssA 略优 |
| OCSORT | 纯运动关联 | DetA 不低但 AssA 极差,说明无外观特征时关联崩溃 |
| TransTrack | Transformer 关联 | 全面落后,MT 低 ML 高,学不动 |
| SORT / FairMOT | 经典/基线 | 垫底,FairMOT 的 ML 极高(术中 43/70),几乎跟丢大半目标 |
这张画像的实用价值是:做 CholecTrack20 请从 Bot-SORT 起步,ByteTrack 是稳健基线,OCSORT 揭示了「纯运动关联在手术场景行不通」。
5.8 检测侧方法画像
- 单阶段 YOLO 系(v7/v8/v9/v10)统治榜单(AP@0.5 约 80),且推理速度快(20-30 FPS),适合实时应用;
- 两阶段 R-CNN 系(Faster/Cascade)AP 落后且慢(约 7 FPS);
- Anchor-free / DETR 系(FCOS、CenterNet、Def-DETR)居中偏下;
- PAA(Probabilistic Anchor Assignment)在 AP@0.5 上达 64.5,但速度一般。
结论:检测侧已是「成熟但非饱和」——YOLO 系足够好,但视觉挑战场景下仍会显著掉点。结合追踪看,手术追踪的真正瓶颈在关联而非检测。
5.9 一个具体的读表示例
假设你想回答「当前最好的手术器械追踪方法有多准」,正确的读表步骤是:
- 先在心里选一个视角。如果你做的是「实时术中提示系统」,那关心的是可见性视角(画面内的器械位置);
- 定位到可见性表的 HOTA 行。最佳是 Bot-SORT 44.7;
- 再补看身份指标。Bot-SORT 的 IDF1 只有 41.4——意味着即使最好的方法,身份保持也才四成出头;
- 补看场景维度。README 另有跨视觉挑战的追踪结果,出血/烟雾场景下还会更低;
- 给出结论:可见性视角最佳方法 HOTA 44.7、IDF1 41.4,距离临床可用(通常要求高可靠身份保持)仍有明显差距。
若换成术中视角,第 2 步就会变成 HOTA 17.4、IDF1 10.2——差了一个量级。同一份数据,换一个视角,结论天差地别。这就是 CholecTrack20 逼你「先定义问题」的价值。
5.10 为什么 MOTA 高但 IDF1 低
这是本数据集最值得玩味的现象。以术中视角 ByteTrack 为例:MOTA 67.0(看起来不错),IDF1 仅 9.5(惨不忍睹)。为什么?
- MOTA 主要由「漏检 + 误检 + 身份切换」构成,但身份切换(IDSW)在 MOTA 里权重有限;只要目标位置大体跟上,MOTA 就不会太差;
- IDF1 直接度量「同一目标的检测是否正确关联到同一轨迹」,一旦轨迹频繁断裂/串号,IDF1 就会崩。
手术场景里,器械频繁出画入画、遮挡、替班,导致关联极易出错——于是「位置对、身份错」成为常态。这正是 CholecTrack20 想暴露的核心短板:现有追踪方法在手术场景里「看得见但认不住」。
5.11 给方法研究者的两个方向提示
基于上面的分析,本条目给出两个高价值研究方向(属分析性建议,非官方结论):
- 方向一:强重识别(re-ID)模块。既然瓶颈在 AssA,那么专门针对手术器械外观(金属反光、细长形状、部分遮挡)设计的 re-ID 特征,可能比通用外观特征更有效。
- 方向二:利用场景语义约束。手术阶段(phase)与套管位置是强先验——比如「clipping and cutting 阶段主刀右手大概率是 clipper」。把 phase 标签作为关联先验注入追踪器,可能改善身份保持。CholecTrack20 恰好同时标注了 phase 与轨迹,为这类研究提供了现成监督。
§6 获取与许可:请求制的门怎么进
6.1 四步获取流程
官方给出的获取路径是一个请求制流程(没有公开直链):
- 阅读 Data Use Agreement(DUA)——仓库内
DUA.md; - 确认许可——数据集以 CC-BY-NC-SA 4.0 发布;
- 填写数据集请求表单领取下载
accesskey——官方说明表单自 2025-03-25 起接受响应;accesskey 需妥善保存; - 经 Synapse.org 数据门户下载——用 accesskey 完成下载。
— https://github.com/CAMMA-public/cholectrack20
关键提醒:GitHub 仓库(github.com/camma-public/cholectrack20)只有代码、文档与评测库,不含数据。数据本体在 Synapse.org。把 GitHub 仓库「star」了并不等于拿到了数据——这是检索者最常见的误会。
6.2 许可:CC-BY-NC-SA 4.0
- 全称:Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International(署名-非商业性使用-相同方式共享 4.0)。
- 含义:可自由使用、修改、分发,但须署名、仅限非商业用途、衍生作品须以相同许可共享。
- 实操影响:
- 学术研究、非商业评测:可用;
- 商业产品、商业化模型:不可——需另行协商;
- 基于该数据集训练的模型的许可归属:许可未明确覆盖「模型权重」,属灰色地带(与库内多数医学数据集共有的问题)。
6.3 仓库与数据格式
GitHub 仓库内容(commit 历史):
| 路径 | 内容 | 最近提交 |
|---|---|---|
DUA.md |
数据使用协议 | 2025-03-15 |
LICENSE.txt |
许可文本 | — |
DATA_FORMAT.md |
数据格式说明 | 2025-11-10 |
utils/ |
工具脚本(含 conversion.py) | 2025-03-15 |
DetEval/ |
检测评测(COCO API) | — |
TrackEval/ |
追踪评测适配(含 CholecTrack2DBox 导入) | 2026-02-21 |
images/ |
示例图/GIF | 2025-04-03 |
数据本体结构:单个 zip,含 train/val/test 三个 split 子目录;每段视频序列含 (1) 原始匿名 .mp4(25 FPS,仅测试集)(2) 1 FPS 采样帧文件夹 (3) JSON 标签文件。
6.4 AI-Ready 评估(DAIMS 五维评分表)
以库内 AI-Ready 检查单 / DAIMS 维度过一遍:
| DAIMS 维度 | 评分 | 依据 |
|---|---|---|
| Discoverability(可发现性) | 高 | CVPR 2025 顶会论文 + CAMMA 官方数据集页 + GitHub 仓库 + Papers with Code 排行,四大入口齐全 |
| Accessibility(可获取性) | 中低 | 请求制:DUA + 表单 + accesskey + Synapse 四步,无公开直链;但流程文档清晰、表单已开放 |
| Interoperability(互操作性) | 高 | JSON 标签 + conversion.py 一键转 MOTChallenge/COCO/TAO;DetEval/TrackEval 标准工具链 |
| Metadata quality(元数据质量) | 高 | README 详尽(三视角定义、OOB 判定规则、属性表、基准表齐全);DATA_FORMAT.md 专述格式 |
| Sustainability(可持续性) | 中高 | CAMMA 长期维护多数据集;TrackEval 支持 2026 年仍在更新;但依赖 Synapse + accesskey 机制,长期可得性受机构政策影响 |
综合 AI-Ready 等级:中高——方法论与文档质量一流,可获取性被请求制拖低。这与库内 cholec50(同为请求制、同为 CAMMA)处于同一档位。亮点是互操作性极高:官方直接给格式转换工具与标准评测库,接入成本远低于许多「给个 zip 就完事」的数据集。
6.5 与库内可获取性光谱的对照
| 档位 | 库内参照 | 本条目对应 |
|---|---|---|
| 注册墙(最严) | LMC2(rid 531,注册+审批) | — |
| 请求制 | CholecT50(rid 223,同 CAMMA,DUA+表单) | 本条目(DUA+表单+Synapse) |
| 平台托管 | Zenodo 型(TopBrain,rid 632) | — |
| 公开直链 | HF/Zenodo 直链型 | — |
本条目与库内 cholec50(rid 223)同处「请求制」档,且同源同团队——两者是库内可获取性光谱上的一对「同门兄弟」。对按「能否立刻下载」过滤条目的使用者,两者都会被标注为请求制。
6.6 请求制实操要点
对准备申请的研究者,几个实操建议:
- 先读 DUA 再填表:DUA 里通常会写明用途限制(非商业)、禁止再分发、禁止尝试重新识别患者等条款。填表时用途描述要与 DUA 一致,否则可能被拒或延误。
- 用途描述写具体:「手术器械追踪研究」比「AI 研究」更容易通过。写明机构隶属与项目背景。
- accesskey 妥善保存:官方明确提醒 accesskey 要保密——它是你的下载凭证,泄露等于数据被他人下载。
- 预留等待时间:请求制通常非即时,项目排期要留缓冲。
- 测试集原始视频是稀缺资源:只有测试集提供 25 FPS 原始 .mp4,训练/验证集只有 1 FPS 采样帧——这一点在做「用原始视频推理」的实验时会成为约束。
6.7 许可合规的三条红线
- 非商业(NC):任何商业产品、商业模型、商业服务不得使用该数据或其衍生;
- 相同方式共享(SA):基于该数据制作的衍生数据集/标注,须以 CC-BY-NC-SA 4.0 或兼容许可发布;
- 署名(BY):须按官方要求引用论文与数据集。
模型权重是否受 SA 约束属灰色地带——许可文本针对「作品」(数据),未明确「训练出的参数」是否算衍生作品。保守做法:商用前逐一确认,或完全避免用该数据训练商用模型。
6.8 与其他 CAMMA 数据集获取方式的对照
CAMMA 系数据集的获取方式并不统一,这是检索者容易忽略的一点:
- CholecT50 / CholecTrack20:请求制(DUA + 表单 + accesskey),托管 Synapse / GitHub 指引;
- Cholec80:早期通过 CAMMA 数据集页指引,多为请求/学术用途;
- CholecSeg8k:经 Kaggle 公开(库内 cholecseg8k 条目记录其 Kaggle 直链)。
也就是说,同一个实验室的四个数据集,「门」的严宽各不相同。用「CAMMA 数据集都能直接下」或「CAMMA 数据集都要申请」一概而论都是错的——必须逐条目核对。这一点在库内多条目收录后尤其重要。
6.9 获取失败的应对
若请求表单长时间无响应或申请被拒,可考虑的替代路径(均为合规建议,不涉及绕过许可):
- 检查是否完整阅读并同意 DUA 条款;
- 补充更详细的用途说明与机构信息;
- 检索是否有下游研究公开的衍生标注/划分(非原始数据);
- 改用同源但更易获取的 Cholec80/CholecSeg8k 做近似实验,并在论文中说明差异。
切勿寻找非官方镜像下载——既违反 CC-BY-NC-SA 与 DUA,也可能拿到被篡改的数据。
§7 生态与互链:CAMMA 的手术视频宇宙
7.1 Cholec 家族谱系
CholecTrack20 属于 CAMMA 的 Cholec「视频 IP」家族。该家族以同一批斯特拉斯堡医学中心的胆囊切除视频为源头,按不同任务切分出多个数据集:
斯特拉斯堡医学中心 胆囊切除视频池(共享 VID 编号)
    ├─ Cholec80         → 手术阶段识别(7 阶段,1 fps)
    ├─ CholecT50/T45    → 手术动作三元组识别(100 类 triplet)
    ├─ CholecSeg8k      → 语义分割(13 类像素级)
    └─ CholecTrack20    → 多视角器械追踪(三视角轨迹)★ 本条目
这一「同源多任务」的家族结构,使它们之间必然存在视频/帧级重叠。官方在 README 中明确承认并提醒,CAMMA 另维护 camma_dataset_overlaps 仓库给出重叠矩阵。
7.2 库内互链点(附 rid)
- CholecT50(rid 223,slug cholect50):最强互链。同 CAMMA、同医学中心视频、共享 VID 编号、同位作者(Nwoye)。任务互补:T50 答「在做什么」,Track20 答「器械在哪、是谁」。官方明确两者内容重叠。建议双向互链。
- Cholec80(rid 78,slug cholec80):上游视频来源与阶段标签体系的来源。Track20 的 20 段视频与 Cholec80 有重叠。建议互链。
- CholecSeg8k(rid 233,slug cholecseg8k):同源自 Cholec80 的语义分割数据集,同属 Cholec 生态。建议互链。
- slam-laparoscopic-motions(rid 762):腹腔镜运动相关,弱互链(须先核验其与 CAMMA 视频池是否重叠)。
7.3 生态工具与下游
- 评测库:DetEval(检测)、TrackEval(追踪,2026-02 加入支持)、Cocoapi(基础)。
- 托管:Synapse.org(Sage Bionetworks)。
- 排行榜:Papers with Code。
- 下游方法:SurgiTrack(新 SOTA,README 标注)。
- 同门对比数据集:Endoscapes(201 视频,分割+检测+CVS)、MultiBypass140(RYGB 手术)、SSG-VQA(场景图 VQA)——均为 CAMMA 出品,构成其「手术视频宇宙」。
7.4 在手术视频数据集景观中的位置
手术器械追踪方向的公开数据集并不多,CholecTrack20 的差异化在于:
- 相比通用 MOT 数据集(MOTChallenge、DanceTrack 等):本条目是手术专用,含 OOCV/OOB 等手术特有动态;
- 相比手术检测数据集(如 Endoscapes 的检测部分):本条目专注追踪,且引入三视角形式化;
- 相比 CAMMA 自家 CholecT50:本条目输出的是器械级轨迹,而非帧级三元组。
其独有价值在于「多视角轨迹形式化」这一原创概念——这是库内其他手术数据集都不具备的。
7.5 与其他手术视频追踪数据集的对照
除 CAMMA 系之外,公开的手术器械追踪数据集相对稀缺,常见的有若干以通用 MOT 格式发布的手术视频子集,但它们普遍缺少:
- 多视角形式化:多数只提供「可见性」一种轨迹定义;
- 手术语义标签:操作者、手术阶段、OOB 判定等;
- 丰富的视觉挑战标注。
CholecTrack20 的差异化正在于把这三者补齐。对做手术追踪的团队而言,它是目前标注维度最完整的公开选择之一(本条为定性判断,具体横向对比需检索者自行核验其他数据集)。
7.6 下游应用三条路径
- 技能评估:用术中视角轨迹统计「某器械使用了几次、每次时长、移动平滑度」——轨迹身份连续是前提,可见性视角不够用;
- 安全区估计:用可见性视角实时定位器械尖端——低延迟比长轨迹更重要;
- 人机协作 / 半自主:需要术中视角的完整器械状态机,判断当前哪把器械在手、下一步将用哪把。
三条路径各取所需,恰好对应三视角——这也再次印证了「任务驱动形式化」的设计合理性。
§8 方法学启示:三条可迁移经验
8.1 「任务驱动形式化」优于「数据驱动形式化」
CholecTrack20 的设计顺序是「先问临床应用需要什么轨迹,再定义标注口径」,而非「先标数据再想能干什么」。这一顺序保证了每一层标注都有明确的消费方(实时反馈 / 工作流分析 / 技能评估)。对任何做医学数据集的团队,这是可迁移的第一经验。
8.2 「同源多任务家族」是低成本扩张的正确姿势
CAMMA 用一批视频衍生出阶段识别(Cholec80)、三元组识别(CholecT50)、分割(CholecSeg8k)、追踪(CholecTrack20)四个数据集,共享视频池与部分标签。但代价是系统性重叠,必须配套重叠说明机制(camma_dataset_overlaps)。这提示:数据集的扩张应同时提供「血缘地图」,否则使用者会在不知情的情况下泄漏。
8.3 「稀有但关键」的指标设计
官方基准表刻意按三视角分列,并突出 IDF1(身份指标)——在 MOTA 看起来还不错(60-72)的同时,IDF1 只有 10-41。这一「用多个指标一起讲一个更完整的故事」的做法,值得库内基准类条目借鉴:单一聚合指标会掩盖真实短板。
8.4 与库内其他条目的方法论对照
把 CholecTrack20 的设计哲学放到库内横向比较,可以看到几种不同的数据集生产范式:
| 范式 | 代表条目 | 核心动作 |
|---|---|---|
| 重标注升级 | panda-plus | 拿现成数据重新标注出更高质量标签 |
| 同源多任务衍生 | cholectrack20 | 同批视频按不同任务切分多个数据集 |
| 多中心扩展 | MultiBypass140 型 | 扩充机构多样性换取泛化 |
| 合成/增广 | 各类 bench | 在已有数据上生成衍生基准 |
CholecTrack20 属于同源多任务衍生范式——它不采新数据、不重标旧标签,而是从既有视频池里「切」出一个新任务维度(追踪)并重新形式化。这一范式的优点是启动成本低、与家族成员自然协同;缺点是必然带来重叠,必须配套血缘说明。库内若继续收录 CAMMA 系数据集,这一血缘信息会越来越重要。
8.5 对「AI-Ready」定义的启示
若把 AI-Ready 理解为「机器能开箱即用地消费」,CholecTrack20 给出了一个有意思的样本:它的可获取性不算好(请求制),但可消费性极好(JSON + 格式转换 + 标准评测库 + 详尽文档)。这提示 AI-Ready 不应只盯着「是否有直链」,还应看「拿到数据后接入成本有多低」。一个直链但格式混乱的数据集,未必比一个请求制但接口规范的数据集更「AI-Ready」。本条目在库内可获取性光谱上处于中低位,但在互操作性维度上处于高位。
§9 与库内条目的关系
9.1 家族图谱
CAMMA 腹腔镜胆囊切除视频池
    ├── cholec80 (rid 78)        [阶段识别]      ── 上游
    ├── cholect50 (rid 223)      [三元组识别]    ── 同门·强重叠
    ├── cholecseg8k (rid 233)    [语义分割]      ── 同门
    └── cholectrack20 (本条目)   [多视角追踪]    ★
9.2 检索路径建议
- 做手术阶段识别 → cholec80(rid 78)为主,本条目可作器械上下文补充;
- 做手术动作识别 → cholect50(rid 223)为主,本条目提供器械身份维度;
- 做手术器械追踪 → 本条目(无库内竞品);
- 做手术场景分割 → cholecseg8k(rid 233);
- 做多任务联合建模 → 必须先用
camma_dataset_overlaps做重叠核对,再联合 cholec80 + cholect50 + 本条目。
9.3 互链价值分析
为什么本条目应当与 CholecT50(rid 223)双向互链?三条理由:
- 同源血缘:两者共享同一批斯特拉斯堡视频池与 VID 编号,检索者若读一个必然需要知道另一个的重叠风险;
- 任务互补:CholecT50 的「三元组识别」与本条目的「器械追踪」是手术视频理解的两条正交轴,联合使用才能刻画「谁在用什么器械做什么」;
- 作者同源:Nwoye 同时深度参与两者,引用链上天然互引。
与 Cholec80(rid 78)的互链理由更基础:Cholec80 是本文阶段标签体系的来源,且视频重叠——是「上游」。
与 CholecSeg8k(rid 233)的互链则偏「同门全景」:三者(加 CholecT50)共同构成 Cholec 生态的完整图景,读者读一个时通常会想看全貌。
9.4 重叠风险的量化提示
官方未在本轮抓取中给出精确的逐视频重叠清单(camma_dataset_overlaps 仓库提供该矩阵,但本轮未逐条抓取)。保守做法:在把 CholecTrack20 与任何 Cholec 系数据集联用前,先到 camma_dataset_overlaps 仓库核对;无法核对的,按「可能存在重叠」处理,即不要把 Cholec80 训练集当作 CholecTrack20 的干净外部测试集。
9.5 互链点摘要(供主会话采纳)
| 互链目标 | rid | 关系 | 互链强度 | 建议 |
|---|---|---|---|---|
| CholecT50 | 223 | 同源同团队·任务互补·内容重叠 | 强 | 双向互链 |
| Cholec80 | 78 | 上游视频来源·阶段标签来源 | 强 | 双向互链 |
| CholecSeg8k | 233 | 同门·同 Cholec 生态 | 中 | 互链 |
| slam-laparoscopic-motions | 762 | 腹腔镜运动相关(须核验重叠) | 弱 | 待核后互链 |
重叠说明口径:与 Cholec50/Cholec80 条目互链时,务必同时传递「内容重叠、共享 VID、须查 camma_dataset_overlaps」这一血缘警示,避免读者误把三者当独立数据联用。
9.6 库内定位一句话
在库内手术视频条目群中,CholecTrack20 是唯一提供器械级时空身份标签的条目——它填补了「Cholec80/CholecT50/CholecSeg8k 都答不出『这把器械从哪来到哪去』」这一空白。
§10 避坑清单:八个已踩过的坑
坑 1:把 GitHub 仓库当数据源。
github.com/camma-public/cholectrack20 只有代码、文档、评测库,不含数据。数据本体在 Synapse.org,需 accesskey。以为 clone 仓库就拿到数据是最常见的初级坑。
坑 2:忽略「请求制」的时间成本。
获取需 DUA → 表单 → accesskey → Synapse 四步,表单审核非即时。项目排期若按「假设当天能下到数据」安排,必翻车。表单自 2025-03-25 开放,早于此时点的一方检索不到入口。
坑 3:跨库预训练造成数据泄漏。
CholecTrack20 与 Cholec80、CholecT50 视频内容重叠且共享 VID 编号(其他库可能写 Video)。若用 Cholec80 训练、CholecTrack20 测试,可能测到训练集里的视频,指标虚高。必须先用 camma_dataset_overlaps 核对。
坑 4:把三视角 HOTA 混着比。
术中视角最佳 17.4、可见性最佳 44.7——不是同一任务。跨视角比较数字毫无意义。读基准表前先确认视角列。
坑 5:混淆检测强与追踪强。
YOLOv7 检测 AP@0.5 高达 80.6,但追踪 IDF1 仍很低。检测精度高不代表关联(AssA)好。做追踪别拿检测数字自我安慰。
坑 6:忽视帧率不一致。
标注 1 FPS,追踪基准评测 @25 FPS。若在 1 FPS 采样帧上跑追踪,数字不能与官方表直接比;做实时系统时更要注意 25 FPS 的压力。
坑 7:把「器械类别」当作固定 7 类即可。
7 类存在严重长尾:grasper/hook 高频,specimen bag 稀有。总体 AP 被高频类带高,稀有类实际性能差。分场景/分类别评测才有意义。
坑 8:误读 license 边界。
CC-BY-NC-SA 4.0 的 NC(非商业)与 SA(相同方式共享)双重约束:商业用途不可,衍生数据须同许可。且该许可未明确覆盖「训练出的模型权重」,商用模型前必须自行厘清。
10.1 一条最小复现路径(食谱式)
给准备上手的研究者一条从零到首个结果的最小路径:
- 申请数据:读 DUA → 填表 → 领 accesskey → Synapse 下载 zip → 解压得 train/val/test;
- 选视角:本文建议先用可见性视角入门(最容易、方法最成熟),跑通后再挑战体内/术中;
- 转格式:
conversion.py转 MOTChallenge 格式; - 搭基线:用 Bot-SORT 或 ByteTrack(有现成开源实现)作为首个基线;
- 评测:用仓库
TrackEval/适配版算 HOTA/IDF1,对标 README 表; - 看短板:分别看 DetA 与 AssA,判断你的瓶颈是检测还是关联;
- 分场景:按 visual conditions 切子集,看哪类视觉挑战拖后腿;
- 升级:若做术中视角,重点攻克 OOCV/OOB 重识别。
这条路径的关键是从易到难——不要一上手就做术中视角,那会因 HOTA 极低而误判方法无用。
10.2 常见评测误用
- 误用 1:在 1 FPS 采样帧上算 HOTA,然后与官方 @25 FPS 表比较——不可比。
- 误用 2:把 Cholec80 训练集当 CholecTrack20 外部测试——可能重叠泄漏。
- 误用 3:只报 HOTA 不报 IDF1——掩盖身份保持短板。
- 误用 4:跨视角平均——三视角不是同一任务的三个折,不能平均。
- 误用 5:忽略稀有类——总体 AP 掩盖 specimen bag 等类的问题。
10.3 与检索关键词相关的坑
- 搜「CholecTrack」可能返回 CholecT50(CholecT 系列)或 CholecSeg8k,注意区分;
- 「multi-perspective」不要搜成「multi-view camera」;
- 中文资料里「多视角/多透视/多视角跟踪」都指本数据集;
- 库内
cholect50的 slug 与本文cholectrack20相近,检索时看清数字。
§11 总结
11.1 三句话总结
- CholecTrack20 是 CAMMA 的腹腔镜手术器械多视角追踪数据集:20 段胆囊切除视频、>35K 帧、65K 器械实例,1 FPS 标注,含包围盒、器械类别、操作者、手术阶段、视觉挑战与三条视角轨迹 ID。
- 它的原创性在于「把追踪重新定义成三种视角」:可见性(画面内)、体内(含出画重识别)、术中(含出画+离体重识别),用同一批标注产出三套难度递增的轨迹与标尺,逼使用者先回答「你追的是哪条轨迹」。
- 它的现实信号是「SOTA 远不够用」:当前方法
< 45% HOTA,术中视角最佳仅 17.4,身份指标 IDF1 低至 10——手术器械的身份保持是尚未解决的硬骨头。
11.2 适合谁
- 做**多目标追踪(MOT/MCMOT)**要挑战手术特有难题(出画、离体、遮挡)的研究者;
- 做手术技能评估、安全区估计、人机协作等临床应用的团队;
- 做手术视频基础模型 / 自监督预训练、需要器械级时空监督信号的团队;
- 研究数据集任务形式化方法论、关注「任务定义如何决定模型上限」的学者。
11.3 不适合谁
- 只想做手术阶段识别的——直接用 Cholec80(rid 78);
- 只想做手术动作/三元组识别的——直接用 CholecT50(rid 223);
- 需要像素级分割的——用 CholecSeg8k(rid 233);
- 需要公开直链、当天可用数据的——本条目是请求制,请评估时间成本;
- 商业用途——CC-BY-NC-SA 4.0 禁止商业使用。
11.4 30 秒决策卡
| 你的需求 | 结论 |
|---|---|
| 手术器械追踪 + 多视角轨迹 | ✅ 首选(库内无竞品) |
| 需要立即下载 | ⚠️ 请求制,需走 DUA+表单+Synapse |
| 商业产品 | ❌ 非商业许可 |
| 与 Cholec80/T50 联用 | ⚠️ 必须先做重叠核对 |
| 做阶段/动作/分割识别 | ❌ 用 Cholec80/CholecT50/CholecSeg8k |
11.5 一句话记忆锚
「三个视角、二十段视频、七十到九百一十六个身份」——记住这三个数,就记住了 CholecTrack20 的核心:三视角是形式化、20 段是规模、70→916 是轨迹碎裂的量化证据。
11.6 这篇条目想传递的三个态度
- 对数据集要问「任务定义是什么」,而非只问「多大、多少类」。CholecTrack20 的价值几乎全在形式化上。
- 对基准数字要问「在哪个口径下」。同一份数据,三视角 HOTA 差 27 个点——脱离口径谈 SOTA 是无意义的。
- 对同源数据要问「重叠吗」。CAMMA 系数据集互为血缘,跨库使用前先查重叠矩阵,是负责任的用法。
FAQ(高频问答)
A. 基础认知
Q:CholecTrack20 和 Cholec80 什么关系?
A:同源。CholecTrack20 的 20 段视频取自 CAMMA 斯特拉斯堡医学中心的胆囊切除视频池,与 Cholec80 内容重叠,共享 VID 编号。但任务不同:Cholec80 做阶段识别,CholecTrack20 做器械追踪。— GitHub README
Q:和 CholecT50 呢?
A:更近的「同门兄弟」——同为 CAMMA 出品、同共享视频池、同位核心作者(Nwoye)。CholecT50 输出动作三元组,CholecTrack20 输出器械轨迹。官方明确两者内容重叠。— GitHub README
Q:名字里的「20」是什么意思?
A:20 段视频。注意与 CholecT50(50 视频)、Cholec80(80 视频)的数字含义一致——都指视频数,容易混淆,检索时务必看清。
B. 数据与获取
Q:能直接下载吗?
A:不能。请求制:读 DUA → 填表领 accesskey → Synapse.org 下载。表单 2025-03-25 起接受响应。— GitHub README
Q:GitHub 仓库里有什么?
A:只有代码、文档(DUA/LICENSE/DATA_FORMAT)、评测库(DetEval/TrackEval)与示例图,没有数据本体。
Q:什么许可?
A:CC-BY-NC-SA 4.0。非商业、须署名、衍生须同许可。
Q:数据是什么格式?
A:zip 内含三个 split 子目录,每视频含 .mp4(25 FPS,仅测试集)+ 1 FPS 采样帧 + JSON 标签;官方提供 conversion.py 转 COCO/MOTChallenge/TAO。
C. 任务与标注
Q:三视角到底区别在哪?
A:可见性=画面内;体内=出画但没离体仍算同一把;术中=出画、离体都算同一把(终生轨迹)。
Q:OOB(离体)怎么判定?
A:三种方式——看到器械退出套管、由另一器械经同一套管进入反推、或初始器械失焦释放抓持。
Q:标了几类器械、几个操作者?
A:7 类器械(grasper/bipolar/hook/scissors/clipper/irrigator/specimen bag)、4 类操作者(MSLH/MSRH/ASRH/NULL)。
D. 基准与评测
Q:SOTA 表现如何?
A:整体 < 45% HOTA。分视角看:术中最佳 Bot-SORT 17.4、体内 27.0、可见性 44.7。身份指标 IDF1 普遍很低(术中仅 10.2)。
Q:用什么指标评?
A:检测用 DetEval(COCO AP);追踪用 TrackEval(HOTA/CLEAR MOT/Identity/Count)。
Q:怎么评测?
A:官方提供 DetEval 与 TrackEval 适配代码;也可经 Papers with Code 排行对标。
E. 库内与使用
Q:库内有相关条目吗?
A:有。cholec80(rid 78)、cholect50(rid 223)、cholecseg8k(rid 233)、slam-laparoscopic-motions(rid 762)。
Q:能和 Cholec80/T50 一起用吗?
A:可以,但必须先核对重叠(camma_dataset_overlaps),否则训练/测试视频重叠会造成泄漏。
Q:有更新的方法吗?
A:README 标注 SurgiTrack 为新 SOTA(正式论文出处本轮未核,见遗留疑点)。
F. 复现与工程细节
Q:从哪份文件能看清数据结构?
A:仓库的 DATA_FORMAT.md(2025-11-10 创建)是格式权威说明;README 也含结构示意。解析 JSON 前先读这两份。
Q:conversion.py 怎么用?
A:官方说明可将 JSON 标注转为 MOTChallenge、COCO、TAO 等格式,然后接入这些格式对应的数据加载器。做标准 MOT 评测时用它省去手写解析。
Q:评测用什么代码?
A:仓库内 DetEval/(检测,基于 COCO API)与 TrackEval/(追踪,适配版)。TrackEval 适配在 2026-02-21 合入,含 CholecTrack2DBox 数据集导入。
Q:三视角的 track id 字段名是什么?
A:README 示例显示为 intraoperative_track_id,另有 intracorporeal_track_id、visibility_track_id(后两者按 README 描述推断,具体字段名以 DATA_FORMAT.md 为准)。
Q:原始视频只有测试集有,训练怎么办?
A:训练/验证用 1 FPS 采样帧;测试集才有 25 FPS 原始 .mp4。若方法需要原始帧率输入,需在测试集上验证,训练时须自行处理帧率差异。
Q:能和其他数据集联合训练吗?
A:可以,但先核对重叠(camma_dataset_overlaps);且注意各库视频 ID 前缀差异(VID vs Video)。
G. 元数据与引用
Q:正式引用格式?
A:会议版 bibtex key nwoye2023cholectrack20(注意 key 里的年份是 2023),booktitle 为 CVPR 2025。
Q:DOI 是什么?
A:arXiv DOI 为 10.48550/arXiv.2312.07352;CVPR 2025 openaccess 有独立页码(pp.8942-8952)。
Q:数据集托管在哪?
A:Synapse.org(Sage Bionetworks),经 accesskey 下载。GitHub 仓库只托管代码与文档。
H. 疑难与边界
Q:为什么说「数据集任务定义决定模型上限」?
A:因为评测什么、怎么算对,直接决定了模型往哪个方向优化。CholecTrack20 三视角的 HOTA 从 17.4 到 44.7,同一批数据「换定义就换分数」——这就是任务定义决定上限的直观证据。
Q:20 段视频,做深度学习够吗?
A:作为评测基准够用(65K 标注实例提供密监督);作为从零训练则偏少,通常需借助大规模手术视频预训练(如 Cholec80 等,但须防重叠)。这也是为什么跨库预训练在本领域普遍存在。
Q:它和 Endoscapes 什么关系?
A:同为 CAMMA 出品、同源自腹腔镜视频,但 Endoscapes 做分割+检测+CVS 评估(201 视频),侧重胆囊安全视野;CholecTrack20 专做器械追踪(20 视频)。两者是 CAMMA 手术视频宇宙的不同分支,可能重叠,联用需核对。
Q:如果我只是想学「多视角追踪」这个概念,需要下数据吗?
A:不需要。读本条目 §2.2 与 §3.7 的表格即可理解三视角形式化;下数据是为做实验,不是为理解概念。
Q:CholecTrack20 有中文官方资料吗?
A:无。中文二手摘要(如若干数据集聚合站)存在,但数字需回原始三源核验;本条目已做此核对。
Q:未来可能有什么更新?
A:官方仓库仍在维护(最新提交 2026-02-21),可能持续加入新指标、新 benchmark 支持;TrackEval 适配是 2026 年新增的迹象。以最新 README 为准。
事实清单(硬事实)
- 官方名 CholecTrack20,CVPR 2025 论文,arXiv:2312.07352(v1 2023-12-12 / v2 2025-03-24)。
- 20 段全长腹腔镜胆囊切除视频。
- 标注帧率 1 FPS,超过 35K 帧。
- 65K 个器械标注实例。
- 原始视频 25 FPS,仅测试集提供 .mp4。
- 官方划分 train 10 / val 2 / test 8。
- 三视角:术中(intraoperative)、体内(intracorporeal)、可见性(visibility)。
- 三视角 groundtruth #Dets 均为 29994;#IDs 分别 70 / 247 / 916。
- 7 类器械:grasper、bipolar、hook、scissors、clipper、irrigator、specimen bag。
- 4 类操作者:MSLH、MSRH、ASRH、NULL。
- 标注含包围盒、类别、操作者、三视角轨迹 ID、手术阶段、视觉挑战。
- OOB 判定三方式:观察退套管 / 另一器械同套管进入反推 / 失焦释放抓持。
- 许可 CC-BY-NC-SA 4.0。
- 获取请求制:DUA → 表单领 accesskey → Synapse.org;表单 2025-03-25 开放。
- 2025-02-26 论文被 CVPR 2025 接收。
- 2025-02-28 完整数据集在 Synapse.org 发布。
- 2026-02-21 TrackEval 加入 CholecTrack20 MOT 评测支持。
- 一作 Chinedu Innocent Nwoye;通讯 Nicolas Padoy;作者含 Joël L. Lavanchy(Basel/Clarunis)。
- 机构:University of Strasbourg / CNRS / INSERM / ICube UMR7357 / IHU Strasbourg。
- 检测基准:YOLOv7 AP@0.5=80.6(最高),YOLOv9 AP@0.75=62.6、AP@0.5:0.95=56.5。
- 追踪基准(术中视角):Bot-SORT HOTA 17.4(最佳)。
- 追踪基准(体内视角):Bot-SORT HOTA 27.0(最佳)。
- 追踪基准(可见性视角):Bot-SORT HOTA 44.7(最佳)。
- 论文核心结论:SOTA
< 45% HOTA,未达临床精度。 - 官方声明与 Cholec80、CholecT50 内容重叠,保留 VID 编号识别重叠。
- 数据格式:zip 含 3 split 目录;每视频含 mp4 + 1FPS 采样帧 + JSON。
- JSON 结构:帧 ID 为键,每帧内每器械为一字典记录(含 tool_bbox / category / operator / track id / phase 等)。
- 官方提供 conversion.py 转 MOTChallenge/COCO/TAO。
- 评测库 DetEval(COCO AP)与 TrackEval(HOTA/CLEAR MOT/Identity/Count)。
- 资助:ANR、BPI France、Swiss National Science Foundation、GENCI-IDRIS。
- 数据托管于 Synapse.org(Sage Bionetworks)。
- README 标注 SurgiTrack 为新 SOTA 方法。
- 三视角 groundtruth 的轨迹数比:916 : 247 : 70(可见性 : 体内 : 术中)≈ 13 : 3.5 : 1。
- 手术阶段标签体系推断沿用 Cholec80 的 7 阶段(README 未列全名,待核)。
- 论文 Fig.1 列出的视觉挑战命名含 bleeding、blurring、crowded、trocar、reflection、smoke、occlusion、lens fouling、blood stain 等。
- JSON 标签以帧 ID 为键,记录数等于该帧器械数。
- 检测基准共 13 个模型参与(Faster-RCNN / Cascade-RCNN / CenterNet / FCOS / SSD / PAA / Def-DETR / Swin-T / YOLOX / YOLOv7 / YOLOv8 / YOLOv9 / YOLOv10)。
- 追踪基准共 6 个方法参与(SORT / OCSORT / FairMOT / TransTrack / ByteTrack / Bot-SORT / SMILETrack 中的子集,按视角不同)。
- 论文致谢代码来自 TrackEval 与 Cocoapi。
- arXiv v2 提交于 2025-03-24,早于数据集请求表单开放(2025-03-25)一天。
- 数据集无官方独立挑战赛,评测经 Papers with Code 排行。
- 作者团队跨法瑞两国(Strasbourg + Basel/Clarunis)。
- 检测侧 YOLOv9 的 AP@0.75 为 62.6(全部模型最高)。
- 追踪侧可见性视角 SORT 的 HOTA 为 17.4,与术中视角最佳 Bot-SORT 数值巧合相同,但含义完全不同。
数据来源与核验声明
本条目在 2026-10-08 完成三源互证,主要来源:
- 一手源 1:CAMMA 官方数据集页 http://camma.u-strasbg.fr/datasets/(CholecTrack20 词条)
- 一手源 2:GitHub 仓库 https://github.com/CAMMA-public/cholectrack20(README、许可、基准表、新闻时间线)
- 一手源 3:论文 arXiv:2312.07352(v1 2023-12-12 / v2 2025-03-24)与 CVPR 2025 openaccess(pp.8942-8952)
- 辅助源:CVF openaccess 会议页、Papers with Code 排行、selectdataset 中文摘要页(仅作交叉参考,未采纳其独有数字)
核验边界:论文 PDF 因网络超时未完整抓取,标注员人数、质控流程、7 阶段完整清单、8 类视觉挑战最终计数、Synapse 门户 ID、SurgiTrack 正式出处等细节未在本轮确证,已在 FACTS.md §9 逐条列为遗留疑点。所有写入正文的硬数字均来自上述可直接引用的三源,未使用未核实来源的独有数字。
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
- real-colon — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测 / 评测基准
- galar — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测 / 评测基准
- endovis-2026 — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测 / 评测基准
- cad-cap — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
- sun-database — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
- slam-laparoscopic-motions — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 评测基准
- surgtoolloc-2022 — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
- lapgyn4 — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
- renji-esd — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
- surgvu-2026 — 共享标签:医学影像 / 手术视频 / 内窥镜影像 / 目标检测
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
