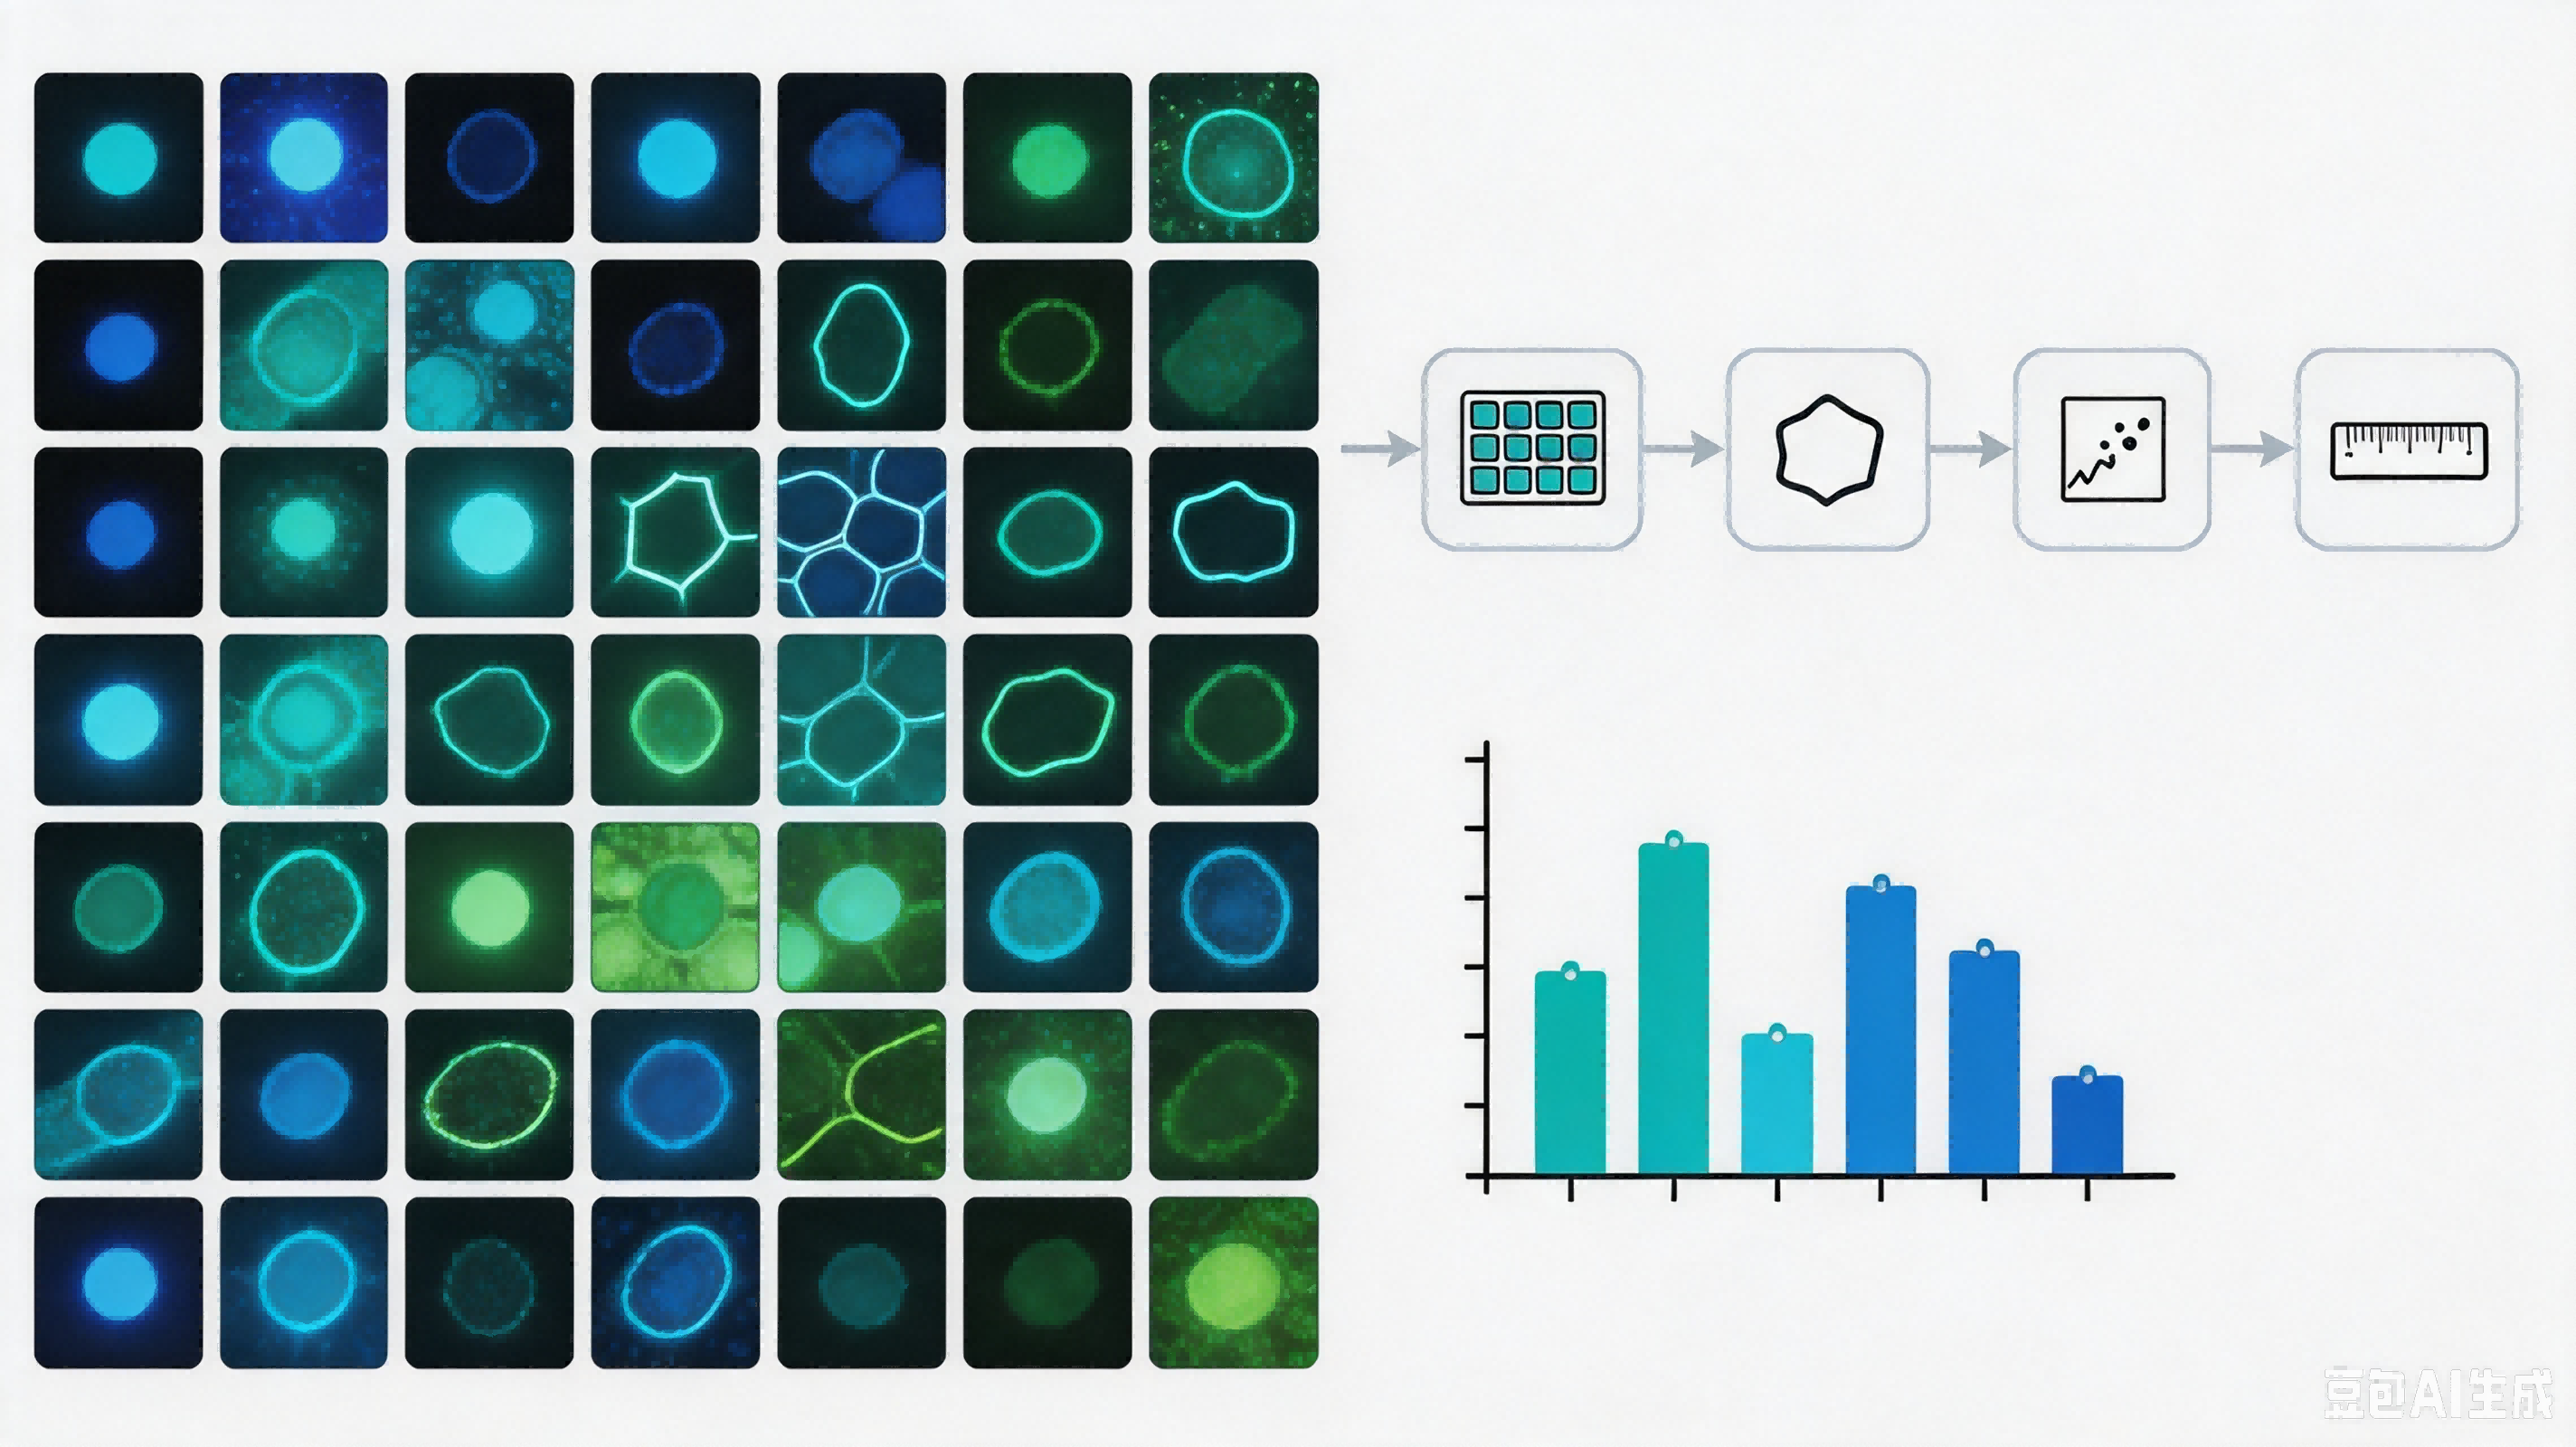
BBBC — Broad Bioimage Benchmark Collection 显微图像分析基准集
千方医数集 · AI Ready 数据集 | 状态:published
BBBC 是 Broad 研究所 Anne Carpenter 实验室(CellProfiler 创建者)维护的公开显微图像基准集。自 2012 年发表于 Nature Methods(Ljosa et al.)以来,已扩展至 47 个标注图像集,覆盖三大生物图像分析任务:识别与分割、表型分类、基于图像的谱分析(image-based profiling)。核心图像集包括 BBBC021(MCF7 细胞 113 种化合物 MOA 分类,39,600 图像,96% NSC 准确率)、BBBC038(2018 Data Science Bowl 核分割,841 图像 37,329 核,3,891 队参赛)、BBBC036(U2OS Cell Painting,4,944,970 图像,BBBC 最大单集)。被 CytoImageNet 选为源数据(贡献 202/894 标签),500+ 论文引用,CC0/CC BY 授权。
§0 出版与审核声明:page_status: published。DOI: 10.1038/nmeth.2083。PMID: 22743765 | PMCID: PMC3627348。千方病案医学编辑部交叉审核:审核范围包括数据集技术参数、许可证信息、基准结果引用、DAIMS 评分。免责声明:本页面为第三方百科式介绍,非 Broad Institute 官方文档;数据使用请以官方页面为准。导航锚点: §1 概览 | §3 关键图像集 | §6 使用指南 | §7 基准与排行榜 | §8 影响力 | §9 资源
§1 概览
§1.0 30 秒速览
| 维度 |
数值 |
| 全称 |
Broad Bioimage Benchmark Collection |
| 维护机构 |
Broad Institute Imaging Platform (Anne Carpenter Lab) |
| 发布年份 |
2012 (Nature Methods) |
| 图像集总数 |
47 个(BBBC001–BBBC054,部分编号缺失) |
| 总图像量 |
~1,050 万张(含最大集 BBBC036 的 494 万张) |
| 任务类型 |
3 类:识别与分割、表型分类、图像谱分析 |
| Ground Truth 类型 |
6 类:Counts / Foreground / Outlines / Biological / Bounding / Location |
| 标杆图像集 |
BBBC021(MOA 分类)、BBBC038(核分割)、BBBC039(U2OS 核)、BBBC036/047(Cell Painting) |
| 授权 |
各集独立(CC0 为主,部分 CC BY) |
| 引用量 |
500+ 论文引用 |
| 生态关联 |
CellProfiler / ImageJ / Cell Painting / CytoImageNet |
| DAIMS 评分 |
15.5/24 (65%) |
§1.1 定位与使命
BBBC 的创建动机源于生物图像分析领域的一个核心痛点:算法之间的公平比较缺乏统一基准。每篇新算法论文通常使用不同的测试图像集(往往有利于作者的方法),比较的算法可能并非研究者最关心的,且其他算法可能未被最优配置。BBBC 提供了一个公开、标准化的图像集收藏,配以 ground truth 和明确的性能度量协议,使算法开发者可以在同一基准上客观比较。
§1.2 三大任务分类
BBBC 将 47 个图像集归入三大类别:
| 类别 |
图像集数 |
核心任务 |
代表性图像集 |
| 识别与分割 (Identification & Segmentation) |
~20 |
细胞计数、前景/背景分割、对象轮廓标注 |
BBBC001–005, BBBC038, BBBC039, BBBC041 |
| 表型分类 (Phenotype Classification) |
~14 |
化合物处理表型、细胞周期阶段、活/死检测 |
BBBC010, BBBC013–016, BBBC048, BBBC051 |
| 图像谱分析 (Image-based Profiling) |
~6 |
化合物谱、基因过表达、RNAi 筛选 |
BBBC017, BBBC021, BBBC022, BBBC036, BBBC047 |
跨类别数据集:BBBC010(C. elegans 活/死检测)和 BBBC041(疟原虫血涂片)同时出现在"识别与分割"和"表型分类"两个类别中。
§1.3 机构背景
Broad Institute(布罗德研究所)是麻省理工学院 (MIT) 和哈佛大学 (Harvard) 联合创立的生物医学研究机构。其 Imaging Platform 由 Anne E. Carpenter 教授领导,同时也是 CellProfiler 开源图像分析软件的创建团队。BBBC 与 CellProfiler 深度绑定——每个图像集均提供 CellProfiler 分析管道 (.cppipe),使研究者可以直接在 CellProfiler 中运行基准评估。
§2 生物与技术背景
§2.1 高通量显微镜图像分析
高通量显微镜 (high-throughput microscopy) 使生物学家每天可以制备和成像数千个样本,支持化合物筛选和功能基因组学研究(如 RNAi)。然而,图像分析成为瓶颈——传统人工判读定性且低通量,无法处理海量数据。CellProfiler(Carpenter et al., Genome Biology 2006)是第一个免费、开源的高通量细胞图像分析系统,可同时测量每个细胞的数百个形态学特征(大小、形状、纹理、强度等)。
§2.2 Cell Painting 协议
Cell Painting 是 BBBC 多个大规模图像集(BBBC022, BBBC036, BBBC037, BBBC047)的核心实验协议,由 Bray et al. 发表于 Nature Protocols (2016):
| 染料 |
通道 |
标记目标 |
细胞器/结构 |
| Hoechst 33342 |
DAPI (蓝) |
DNA |
细胞核 |
| Concanavalin A (ConA) |
FITC (绿) |
内质网 |
ER |
| SYTO 14 |
TRITC (红) |
RNA |
核仁 + 细胞质 RNA |
| Phalloidin |
TexasRed (橙) |
F-actin |
肌动蛋白骨架 |
| Wheat Germ Agglutinin (WGA) |
TexasRed (橙) |
细胞膜 + 高尔基体 |
质膜/高尔基 |
| MitoTracker Deep Red |
Cy5 (远红) |
线粒体 |
线粒体 |
6 种染料 → 5 个成像通道 → 8 种细胞器/结构。CellProfiler 从每个细胞提取约 1,500 个形态学特征,构成"形态学指纹"(morphological profile)。
Cell Painting 完整实验流程
第 1 步:细胞接种
├── 细胞系(U2OS / MCF-7 / A549 / HEK293 等)消化计数
├── 多孔板接种(通常 384 孔板,~1,000-5,000 细胞/孔)
├── 融合度 ~50-70% 时加药处理
└── 孵育时间: 通常 24-48 小时

第 2 步:化合物处理
├── 化合物溶于 DMSO → 转移到细胞孔(通常 10 μM 起始浓度)
├── 浓度梯度: 8-10 个浓度(半对数稀释)
├── 对照孔: DMSO 阴性对照 + 已知 MOA 参考化合物
├── 每板至少 16 个 DMSO 对照孔
└── 处理时间: 24h(BBBC021)/ 48h(部分 BBBC036)

第 3 步:固定与染色 (Cell Painting 协议)
├── 去培养基 → PBS 洗涤
├── 4% PFA 固定 15 min → PBS 洗
├── 0.1% Triton X-100 透化 10 min
├── 顺序染色(避免染料间交叉反应):
│   ├── 1. ConA + WGA (ConA: ER, WGA: 膜/高尔基)
│   ├── 2. SYTO 14 (RNA/核仁)
│   ├── 3. Phalloidin (F-actin)
│   ├── 4. Hoechst 33342 (DNA/细胞核)
│   └── 5. MitoTracker Deep Red (线粒体,活细胞预染)
└── 总染色时间 ~2-3 小时

第 4 步:高内涵成像
├── 自动荧光显微镜扫描整板
├── 每孔 4-9 个视野 (field of view)
├── 5 通道顺序成像(避免荧光串扰)
├── 20× 物镜(常规)/ 40× 物镜(高分辨率)
├── 16-bit 灰度图像 → 多通道叠加
└── 典型通量: 384 孔板 × 5 通道 × 9 视野 ≈ 17,280 图像/板

第 5 步:图像分析 (CellProfiler)
├── 照明校正 (illum.cppipe) — 修正视野内亮度不均
├── 细胞核分割 (IdentifyPrimaryObjects) — Hoechst 通道
├── 细胞边界分割 (IdentifySecondaryObjects) — 扩展核区域
├── 特征提取 (MeasureObjectIntensity/SizeShape/Texture)
│   └── ~1,500 特征/细胞 × 5 通道 = ~7,500 原始特征
├── 特征选择 + 降维 (PCA / 后处理)
└── 输出: 形态学特征矩阵 (N_cells × ~1,500)
规模参考:BBBC036 包含 4,944,970 张图像,来自 ~10,000 种生物活性化合物。每个化合物的 Cell Painting profile 可视为其在"细胞形态学空间"中的位置。相似 MOA 的化合物应聚集在同一区域——这正是 BBBC021 MOA 分类的基础。
图像谱分析 (Image-based Profiling) 方法论
图像谱分析是 BBBC 的第三大类任务,也是 Cell Painting 的核心应用场景:
| 步骤 |
操作 |
输出 |
| 1. 特征提取 |
CellProfiler 从每细胞提取 ~1,500 特征 |
(N_cells × 1500) 矩阵 |
| 2. 处理级聚合 |
同一 compound-concentration 的细胞特征取均值 |
(N_treatments × 1500) |
| 3. 特征工程 |
Z-score 归一化 + 方差过滤 + PCA |
(N_treatments × ~500) |
| 4. 相似性计算 |
余弦相似度 / 欧氏距离 / 相关性 |
处理间相似性矩阵 |
| 5. MOA 聚类 |
层次聚类 / k-NN / 可视化 (t-SNE/UMAP) |
MOA 分组 |
| 6. 评估 |
Leave-one-compound-out + 1-NN → NSC 准确率 |
分类准确率 |
关键区别:与标准分类任务不同,图像谱分析不直接学习 “图像 → MOA 标签” 的映射,而是先提取形态学特征再计算相似性。这使得模型能发现未知化合物与已知 MOA 的相似性——这是无监督药物重定位的基础。
§2.3 显微成像模态
BBBC 涵盖多种显微镜成像模态:
| 模态 |
原理 |
涉及图像集 |
| 荧光显微镜 |
特定波长激发荧光染料发射 |
BBBC001–006, BBBC021, BBBC022, BBBC036–039 等 |
| 明场显微镜 |
透射光直接成像 |
BBBC034, BBBC041, BBBC042, BBBC045, BBBC048 |
| DIC (微分干涉对比) |
偏振光相位差成像 |
BBBC003, BBBC028–030 |
| 共聚焦显微镜 |
激光扫描 + 针孔去模糊 |
BBBC036 (Opera Phenix) |
§2.4 Ground Truth 标注体系
BBBC 定义了六种标准化的 ground truth 类型:
| 图标 |
类型 |
说明 |
典型度量 |
| C |
Counts |
细胞/核计数 |
绝对计数误差、相关系数 |
| F |
Foreground |
前景/背景分割 |
前景/背景像素准确率 |
| O |
Outlines |
细胞轮廓 |
Jaccard 指数、Dice 系数 |
| B |
Biological |
生物学标注(表型标签) |
分类准确率、AUC |
| Bnd |
Bounding |
边界框 |
mAP、Precision/Recall |
| L |
Location |
目标位置 |
定位误差 |
§3 关键图像集
§3.1 BBBC021 — MCF7 化合物 MOA 预测(明星基准)
BBBC021 是 BBBC 中引用最高的单个图像集,也是生物图像分析领域最经典的化合物作用机制 (MOA) 分类基准。
| 维度 |
数值 |
| 细胞系 |
MCF-7(人乳腺癌,p53 野生型) |
| 化合物数 |
113 种小分子 |
| 浓度梯度 |
8 个浓度/化合物(部分因失活/毒性/QC 不通过而排除) |
| 微孔板数 |
55 块 |
| 视野数 |
13,200 |
| 图像总数 |
39,600(13,200 × 3 通道) |
| 荧光通道 |
DAPI (DNA) / β-tubulin / F-actin |
| 处理时间 |
24 小时 |
| MOA 类别 |
12 类(6 类视觉识别 + 6 类文献定义) |
| Ground truth |
103 个化合物-浓度对(38 种化合物) |
| 文件格式 |
TIFF |
| 压缩包 |
55 个 ZIP(每板 ~750 MB) |
| 评估协议 |
Leave-one-compound-out 交叉验证 + 1-NN |
| 版权 |
AstraZeneca Pharmaceuticals → Broad |
| 原始来源 |
Caie et al., Mol. Cancer Ther. 2010 |
12 类 MOA(已确认 7 类名称):
- Actin disrupter(肌动蛋白破坏剂)
- Aurora kinase inhibitor(极光激酶抑制剂)
- Eg5 inhibitor(Eg5 抑制剂)
- Tubulin destabilizer(微管去稳定剂)
- Tubulin stabilizer(微管稳定剂)
- Epithelial(上皮型)
- Protein synthesis(蛋白质合成抑制剂)
8–12. 其余 5 类基于文献定义,页面未完整列出
评估协议详解:
BBBC021 的评估协议比一般分类任务更严格。标准操作为:
- 提取图像特征(如 CellProfiler 形态学特征或深度学习特征)
- 在处理级别聚合(每个 compound-concentration 的重复孔取均值,得到 103 个特征向量)
- 使用 1-NN 分类 MOA 标签,但排除同一化合物的邻居
- 报告 NSC (Not-Same-Compound) 准确率
关键坑点:不能使用简单的 leave-one-out 样本划分,必须使用 leave-one-compound-out——每次留出一种化合物的所有重复和所有浓度进行训练/测试。否则会因数据泄漏而高估性能。
§3.2 BBBC038 — 2018 Data Science Bowl 核分割
BBBC038 是 BBBC 历史上最成功的竞赛数据集,由 Broad Institute 与 Kaggle、Booz Allen Hamilton 联合组织。
| 维度 |
数值 |
| 总图像 |
841(训练 670 + 一阶段测试 65 + 二阶段测试 106) |
| 总核数 |
37,329(训练 29,461 + 测试 4,152 + 3,716) |
| 生物多样性 |
30+ 独立实验、22 种细胞类型、15 种分辨率 |
| 成像模态 |
荧光 (DAPI/Hoechst) + 明场 H&E + 其他明场 |
| 数据来源 |
16+ 贡献者实验室(MIT/Duke/UCLA/KCL 等) |
| 竞赛参赛队 |
3,891 队 |
| 奖金池 |
$100,000 (Booz Allen Hamilton) |
| 授权 |
CC0 (公有领域) |
| 发表 |
Caicedo et al., Nature Methods 16(12):1247-1253, 2019 |
| DOI |
10.1038/s41592-019-0612-7 |
图像分组:BBBC038 的测试集图像按视觉特征分为五组,用于跨实验泛化性评估:
| 分组 |
描述 |
典型来源 |
| 灰度荧光 |
单通道荧光核染色 |
Broad Institute |
| 彩色荧光 |
多通道荧光 |
McLean Hospital |
| 紫色组织 |
H&E 组织学 |
Brigham & Women’‘’‘’‘’'s Hospital |
| 粉紫组织 |
H&E 变异染色 |
UCLA |
| 灰度组织 |
明场组织学 |
Skoltech / Newcastle |
§3.3 BBBC039 — U2OS 核分割基准
| 维度 |
数值 |
| 图像数 |
200 视野 |
| 核数 |
~23,000 个(手工标注) |
| 细胞系 |
U2OS(人骨肉瘤) |
| 染色 |
Hoechst (DNA) |
| 图像格式 |
TIFF, 520×696 px, 16-bit |
| 化合物 |
200 种生物活性化合物 |
| 来源 |
BBBC022 化学筛选的 DNA 通道子集 |
| Ground truth |
前景 + 生物学 + 轮廓 + 计数 |
| 划分 |
训练 / 验证 / 测试三子集 |
| 代码仓库 |
github.com/carpenterlab/unet4nuclei |
| 发表 |
Caicedo et al., bioRxiv 2018 |
与 BBBC038 的关系:BBBC039 的一小部分图像与 BBBC038 有重叠。BBBC038 包含更多实验条件(荧光 + H&E + 明场),而 BBBC039 来自单一高通量实验但化合物种类更多。
§3.4 BBBC036/022 — U2OS Cell Painting(最大规模)
| 维度 |
BBBC022 |
BBBC036 |
| 细胞系 |
U2OS |
U2OS |
| 图像总数 |
345,600 |
4,944,970 |
| 视野数 |
69,120 |
988,994 |
| 通道数 |
9 (Cell Painting 5 通道 + 扩展) |
5 (标准 Cell Painting) |
| 用途 |
化合物谱分析 |
生物活性化合物谱分析 |
| BBBC 中地位 |
第二大图像集 |
最大单集 |
BBBC036 的 ~495 万张图像使其成为 BBBC 中体量最大的数据集,也是 Cell Painting 协议在公开数据集中的最大规模应用之一。
§3.5 BBBC047 — 30,000 小分子 Cell Painting
| 维度 |
数值 |
| 小分子处理数 |
30,000 种 |
| 图像总数 |
4,757,760 |
| 视野数 |
951,552 |
| 通道数 |
6 |
| 用途 |
大规模化合物形态学谱分析 |
§3.6 BBBC041 — 疟原虫血涂片
| 维度 |
数值 |
| 图像数 |
1,328 |
| 生物类型 |
间日疟原虫 (P. vivax) 感染的人类血涂片 |
| 成像模态 |
明场 |
| Ground truth |
计数 + 生物学 + 边界框 |
| 用途 |
疟疾自动诊断、寄生虫计数 |
§3.7 其他重要图像集一览
| BBBC |
名称 |
图像数 |
生物类型 |
GT 类型 |
| BBBC001 |
HT29 结肠癌细胞 |
6 |
人结肠癌 |
Counts |
| BBBC002 |
果蝇 Kc167 细胞 |
50 |
果蝇 |
Counts |
| BBBC003 |
小鼠胚胎 |
15 |
小鼠 |
Counts + F |
| BBBC004 |
合成细胞 |
100 |
合成 |
Counts + F |
| BBBC005 |
合成细胞 |
19,200 |
合成 |
Counts + F |
| BBBC006 |
U2OS 失焦 |
52,224 |
人骨肉瘤 |
F + O |
| BBBC007 |
果蝇 Kc167 |
32 |
果蝇 |
O |
| BBBC008 |
HT29 结肠癌 |
24 |
人结肠癌 |
F |
| BBBC009 |
人红细胞 |
5 |
人红细胞 |
O |
| BBBC010 |
C. elegans 活/死 |
200 |
线虫 |
F + O + B |
| BBBC011 |
C. elegans 代谢 |
50 |
线虫 |
B |
| BBBC012 |
C. elegans 感染标记 |
360 |
线虫 |
B |
| BBBC013 |
U2OS 质核转位 |
192 |
人骨肉瘤 |
B |
| BBBC014 |
MCF7+A549 质核转位 |
192 |
人乳腺+肺 |
B |
| BBBC015 |
U2OS transfluor |
288 |
人骨肉瘤 |
B |
| BBBC016 |
U2OS transfluor |
144 |
人骨肉瘤 |
B |
| BBBC017 |
HT29 shRNAi 筛选 |
193,536 |
人结肠癌 |
无 |
| BBBC018 |
HT29 多样表型 |
168 |
人结肠癌 |
O |
| BBBC019 |
集体细胞迁移 |
171 |
— |
F |
| BBBC020 |
小鼠骨髓巨噬细胞 |
75 |
小鼠 |
O |
| BBBC024 |
3D HL60 合成 |
240 |
人白血病(合成) |
F + C |
| BBBC025 |
U2OS RNAi Cell Painting |
138,240 |
人骨肉瘤 |
B |
| BBBC026 |
肝细胞+成纤维细胞共培养 |
864 |
人+小鼠 |
B + C |
| BBBC027 |
3D 结肠组织合成 |
60 |
合成 |
F + C |
| BBBC028 |
聚合结构 |
60 |
— |
F |
| BBBC029 |
合成 DIC |
218 |
合成 |
F |
| BBBC030 |
CHO 细胞 |
60 |
中国仓鼠 |
O |
| BBBC031 |
模拟 24 孔板 |
216 |
合成 |
C + L + B |
| BBBC032 |
小鼠囊胚 |
4 |
小鼠 |
F |
| BBBC033 |
小鼠滋养层干细胞 |
2 |
小鼠 |
F |
| BBBC034 |
诱导多能干细胞 |
9 |
人干细胞 |
F |
| BBBC035 |
模拟 HL60 |
230 |
人白血病(模拟) |
F |
| BBBC037 |
U2OS 基因过表达 |
103,680 |
人骨肉瘤 |
B |
| BBBC042 |
大鼠星形胶质细胞 |
1,120 |
大鼠 |
B |
| BBBC044 |
小鼠海马突触前终端 |
12 |
小鼠脑 |
C |
| BBBC045 |
人白细胞 |
146 |
人白细胞 |
B |
| BBBC046 |
FiloData3D A549 |
1,440 |
人肺腺癌(合成) |
C + F |
| BBBC048 |
Jurkat 细胞周期 |
129,064 |
人 T 淋巴 |
B |
| BBBC050 |
小鼠胚胎细胞核 |
165 |
小鼠 |
C + F |
| BBBC051 |
人肾皮质细胞 |
690,000 |
人肾 |
B |
| BBBC052 |
小鼠 CAD 细胞 |
309 |
小鼠神经元 |
B |
| BBBC053 |
小鼠 CAD 细胞 |
59 |
小鼠神经元 |
B |
| BBBC054 |
LPS 激活小胶质细胞 |
180 |
小鼠 |
B + L |
缺失编号:BBBC023, BBBC040, BBBC043, BBBC049 在官方页面未出现,可能已被合并或撤回。
§3.8 图像集规模分布
图像数量级分布 (对数刻度)
┌─────────────────────────────────────────────────────────┐
│ 10^0  ████  (BBBC009, BBBC032, BBBC033)              2-5 │
│ 10^1  ████████  (BBBC001, BBBC028, BBBC044, BBBC050)  12-75 │
│ 10^2  ████████████  (BBBC003, BBBC007, BBBC039, BBBC053) 100-200 │
│ 10^3  ████  (BBBC041, BBBC052)                    309-1328 │
│ 10^4  ████  (BBBC026, BBBC017, BBBC042, BBBC048)  864-193K │
│ 10^5  ████  (BBBC025, BBBC037)                  103K-138K │
│ 10^6  ████  (BBBC022, BBBC051)                  345K-690K │
│ 10^7  ██  (BBBC036, BBBC047)                  4.7M-4.9M  │
└─────────────────────────────────────────────────────────┘
§4 数据格式与结构
§4.1 文件格式
| 格式 |
用途 |
典型图像集 |
| TIFF (16-bit) |
原始荧光图像 |
BBBC039 (520×696 px) |
| PNG (8-bit) |
核分割 mask |
BBBC038 (每核一个 PNG) |
| CSV |
元数据、ground truth |
BBBC021 (moa.csv, image.csv) |
| .cppipe |
CellProfiler 分析管道 |
BBBC021 (analysis.cppipe, illum.cppipe) |
| .xlsx |
竞赛解决方案 |
BBBC038 (solution.csv) |
| SMILES |
化合物结构 |
BBBC021 (compound.csv) |
§4.2 BBBC021 数据字典
BBBC021_v1_moa.csv(Ground Truth 文件):
| 字段 |
类型 |
说明 |
示例 |
| compound |
string |
化合物名称 |
“PP-2” |
| concentration |
float |
浓度 (μM) |
3.0 |
| moa |
string |
MOA 类别标签 |
“Epithelial” |
BBBC021_v1_image.csv(图像元数据,3.8 MB):
| 字段 |
说明 |
| TableNumber |
数据表编号 |
| ImageNumber |
图像编号 |
| Image_FileName_DAPI |
DAPI 通道文件名 |
| Image_PathName_DAPI |
DAPI 通道路径 |
| Image_FileName_Tubulin |
Tubulin 通道文件名 |
| Image_PathName_Tubulin |
Tubulin 通道路径 |
| Image_FileName_Actin |
Actin 通道文件名 |
| Image_PathName_Actin |
Actin 通道路径 |
| Image_Metadata_Plate_DAPI |
微孔板 ID |
| Image_Metadata_Well_DAPI |
孔位 ID |
| Replicate |
重复编号 |
| Image_Metadata_Compound |
化合物名称 |
| Image_Metadata_Concentration |
浓度 (μM) |
§4.3 BBBC038 目录结构
BBBC038v1/
├── stage1_train/
│   ├── [ImageId_1]/
│   │   ├── images/
│   │   │   └── [ImageId_1].png
│   │   └── masks/
│   │       ├── [mask_1].png    # 每个核一个 PNG mask
│   │       ├── [mask_2].png
│   │       └── ...
│   ├── [ImageId_2]/
│   └── ... (670 images)
├── stage1_test/
│   ├── [ImageId]/
│   │   └── images/
│   │       └── [ImageId].png
│   └── ... (65 images)
├── stage2_test_final/
│   ├── [ImageId]/
│   │   └── images/
│   │       └── [ImageId].png
│   └── ... (106 scored + decoys)
├── stage1_train_labels.csv     # 8.1 MB
├── stage1_solution.csv         # 1.2 MB
├── stage2_solution_final.csv   # 1.5 MB
└── metadata.xlsx               # 43 行实验溯源表
§4.4 BBBC039 Mask 解码
BBBC039 的 ground truth 以 PNG mask 存储——如果两个核接触,它们用不同的颜色标记。需要解码为标记矩阵:
import numpy as np
from PIL import Image

def decode_masks(mask_path):
    """解码 BBBC039 的彩色 mask 为实例分割标签"""
    mask = np.array(Image.open(mask_path))
    # 每个 RGB 值对应一个独立的核实例
    unique_colors = np.unique(mask.reshape(-1, mask.shape[-1]), axis=0)
    # 排除背景 (0, 0, 0)
    unique_colors = unique_colors[~np.all(unique_colors == 0, axis=1)]

    labeled = np.zeros(mask.shape[:2], dtype=np.int32)
    for idx, color in enumerate(unique_colors, 1):
        match = np.all(mask == color, axis=-1)
        labeled[match] = idx

    return labeled  # shape: (H, W), 每个整数代表一个核实例
§4.5 下载渠道
§5 技术规格
§5.1 成像设备
| 设备 |
厂商 |
用于 |
典型图像集 |
| ImageXpress Micro Confocal |
Molecular Devices |
高内涵筛选 |
BBBC022, BBBC036 |
| Opera Phenix |
PerkinElmer/Revvity |
共聚焦 Cell Painting |
BBBC036, BBBC047 |
| ImageXpress XLS |
Molecular Devices |
高通量明场+荧光 |
BBBC021 |
| CellInsight CX7 LZR Pro |
Thermo Fisher |
Cell Painting |
验证/复现 |
| 传统荧光显微镜 |
多种 |
基础荧光成像 |
BBBC001–006 |
§5.2 CellProfiler 分析管道
每个 BBBC 图像集通常附带两个 CellProfiler 管道文件:
| 管道 |
用途 |
关键模块 |
illum.cppipe |
照明校正 |
CorrectIlluminationCalculate → CorrectIlluminationApply |
analysis.cppipe |
特征提取 |
IdentifyPrimaryObjects (核) → IdentifySecondaryObjects (细胞) → MeasureObjectIntensity → MeasureObjectSizeShape → ExportToSpreadsheet |
CellProfiler 从每个细胞提取约 1,500 个形态学特征,涵盖:
| 特征类别 |
维度 |
典型特征 |
| 大小 |
~10 |
面积、周长、等效直径 |
| 形状 |
~15 |
长宽比、圆度、Zernike 矩 |
| 强度 |
~30 |
均值/中位/标准差/积分光密度 |
| 纹理 |
~200+ |
Haralick 特征、Gabor 纹理 |
| 位置 |
~5 |
质心 X/Y、孔内位置 |
| 邻域 |
~10 |
邻居数量、局部密度 |
§5.3 数据质量控制
BBBC021 的浓度排除机制展示了 BBBC 的 QC 理念——不是所有数据都可用,需要基于以下标准过滤:
| 排除原因 |
判定方法 |
处理 |
| 失活剂量 |
Mahalanobis distance vs DMSO 对照超出阈值 |
排除该浓度 |
| 过度毒性 |
图像中无细胞或极少细胞 |
排除该浓度 |
| QC 不通过 |
对焦不准或图像伪影 |
排除该浓度 |
§5.4 图像尺寸与位深
| 图像集 |
尺寸 (px) |
位深 |
通道 |
| BBBC039 |
520×696 |
16-bit |
1 (灰度) |
| BBBC038 |
可变 (70–512) |
8-bit |
1–3 (RGB) |
| BBBC021 |
~1280×1024 |
16-bit |
3 (DAPI/Tub/Act) |
| BBBC022 |
~512×512 |
16-bit |
5 (Cell Painting) |
| BBBC036 |
~512×512 |
16-bit |
5 (Cell Painting) |
§6 使用指南
§6.1 版本抉择矩阵
| 需求 |
推荐图像集 |
理由 |
| 核实例分割算法开发 |
BBBC038 |
最大核分割基准,37K 核,CC0,多模态 |
| 核分割精调 (荧光) |
BBBC039 |
单一实验、高质量标注、U-Net 参考代码 |
| 化合物 MOA 分类 |
BBBC021 |
标准基准,12 类 MOA,103 处理 |
| Cell Painting 形态学 |
BBBC036 |
最大规模,494 万图,5 通道 |
| 大规模化合物筛选 |
BBBC047 |
30K 小分子,Cell Painting |
| 细胞计数 |
BBBC001/002 |
小规模快速验证 |
| 疟疾自动诊断 |
BBBC041 |
血涂片明场,边界框标注 |
| 细胞周期分析 |
BBBC048 |
Jurkat 细胞周期分类 |
| 跨数据集预训练 |
全部 47 集 |
CytoImageNet 方法(202/894 标签) |
§6.2 PyTorch Dataset (BBBC038)
import os
import numpy as np
from PIL import Image
import torch
from torch.utils.data import Dataset, DataLoader
from torchvision import transforms

class BBBC038Dataset(Dataset):
    """BBBC038 (2018 Data Science Bowl) 核分割 Dataset

    CC0 许可,670 训练图像 + 37,329 核标注
    """
    def __init__(self, root_dir, split=''''''''train'''''''', transform=None):
        self.root = os.path.join(root_dir, ''''''''stage1_train'''''''' if split == ''''''''train''''''''
                                  else ''''''''stage1_test'''''''')
        self.image_ids = sorted(os.listdir(self.root))
        self.transform = transform

    def __len__(self):
        return len(self.image_ids)

    def __getitem__(self, idx):
        img_id = self.image_ids[idx]
        # 加载图像
        img_path = os.path.join(self.root, img_id, ''''''''images'''''''', img_id + ''''''''.png'''''''')
        image = Image.open(img_path).convert(''''''''RGB'''''''')

        # 加载并合并 mask
        mask_dir = os.path.join(self.root, img_id, ''''''''masks'''''''')
        if os.path.exists(mask_dir):
            masks = [np.array(Image.open(os.path.join(mask_dir, f)))
                     for f in sorted(os.listdir(mask_dir))]
            # 合并为实例分割标签
            label = np.zeros_like(masks[0], dtype=np.int32)
            for i, m in enumerate(masks, 1):
                label[m > 0] = i
        else:
            label = np.zeros(image.size[::-1], dtype=np.int32)

        if self.transform:
            image = self.transform(image)

        return {
            ''''''''image'''''''': image,
            ''''''''label'''''''': torch.from_numpy(label).long(),
            ''''''''image_id'''''''': img_id
        }

# 使用示例
transform = transforms.Compose([
    transforms.Resize((256, 256)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225])
])

dataset = BBBC038Dataset(''''''''BBBC038v1'''''''', split=''''''''train'''''''', transform=transform)
loader = DataLoader(dataset, batch_size=16, shuffle=True, num_workers=4)
§6.3 BBBC021 MOA 分类评估代码
import numpy as np
from sklearn.neighbors import NearestNeighbors
import pandas as pd

def evaluate_bbbc021(features, metadata, moa_labels):
    """BBBC021 Leave-One-Compound-Out MOA 分类评估

    Args:
        features: (N, D) 特征矩阵
        metadata: DataFrame with ''''''''compound'''''''', ''''''''concentration'''''''' columns
        moa_labels: list of MOA strings

    Returns:
        NSC accuracy (Not-Same-Compound accuracy)
    """
    # 聚合到处理级别 (compound-concentration 的重复孔取均值)
    treatments = metadata.groupby([''''''''compound'''''''', ''''''''concentration''''''''])
    treatment_features = []
    treatment_compounds = []
    treatment_moas = []

    for (comp, conc), group in treatments:
        idx = group.index.tolist()
        mean_feat = features[idx].mean(axis=0)
        treatment_features.append(mean_feat)
        treatment_compounds.append(comp)
        treatment_moas.append(moa_labels[idx[0]])

    X = np.array(treatment_features)
    compounds = np.array(treatment_compounds)
    moas = np.array(treatment_moas)

    # Leave-one-compound-out 交叉验证
    correct = 0
    total = 0
    unique_compounds = np.unique(compounds)

    for held_compound in unique_compounds:
        test_mask = compounds == held_compound
        train_mask = ~test_mask

        if train_mask.sum() == 0:
            continue

        # 1-NN 分类,排除同一化合物的邻居
        nn = NearestNeighbors(n_neighbors=1, metric=''''''''cosine'''''''')
        nn.fit(X[train_mask])

        for i in np.where(test_mask)[0]:
            dist, idx = nn.kneighbors(X[i:i+1])
            pred_moa = moas[train_mask][idx[0][0]]
            if pred_moa == moas[i]:
                correct += 1
            total += 1

    nsc_accuracy = correct / total if total > 0 else 0
    print(f"NSC Accuracy: {nsc_accuracy:.1%} ({correct}/{total})")
    return nsc_accuracy
§6.4 StarDist 核分割训练 (BBBC039)
StarDist (Schmidt et al., MICCAI 2018) 使用星凸多边形作为核形状先验,在 BBBC039 上达到 F1 0.93。以下是完整的 StarDist 训练管道:
"""
StarDist 训练管道 — BBBC039 U2OS 核分割
参考: github.com/stardist/stardist
"""
import numpy as np
from PIL import Image
from pathlib import Path
from csbdeep.utils import normalize
from stardist.models import StarDist2D
from stardist import random_label_cmap
from stardist.matching import matching_dataset
from skimage.measure import find_contours
import matplotlib.pyplot as plt

# 1. 数据加载与预处理
def load_bbbc039(data_dir, split=''''''''train''''''''):
    """加载 BBBC039 数据 — 200 张 U2OS 核图像 + 手工标注"""
    img_dir = Path(data_dir) / f''''''''{split}''''''''
    images = []
    masks = []

    for img_file in sorted(img_dir.glob(''''''''*image.tif'''''''')):
        img = np.array(Image.open(img_file))
        # 归一化到 [0,1] — StarDist 要求 float32
        img = normalize(img, 1, 99.8)  # 百分位归一化
        images.append(img)

        # 加载对应的 mask
        mask_file = img_file.parent / img_file.name.replace(''''''''image'''''''', ''''''''mask'''''''')
        if mask_file.exists():
            mask = np.array(Image.open(mask_file))
            # BBBC039 mask 是彩色编码,需要解码
            from skimage.color import rgb2gray
            if mask.ndim == 3:
                labeled = decode_color_mask(mask)
            else:
                labeled = mask
            masks.append(labeled)

    return images, masks

def decode_color_mask(mask):
    """将 BBBC039 彩色 mask 解码为标记矩阵"""
    if mask.ndim == 2:
        return mask
    unique = np.unique(mask.reshape(-1, mask.shape[-1]), axis=0)
    unique = unique[~np.all(unique == 0, axis=1)]
    labeled = np.zeros(mask.shape[:2], dtype=np.int32)
    for i, color in enumerate(unique, 1):
        match = np.all(mask == color, axis=-1)
        labeled[match] = i
    return labeled

# 2. StarDist 模型训练
def train_stardist_bbbc039(data_dir, model_name=''''''''bbbc039_stardist''''''''):
    """训练 StarDist2D 模型"""
    from stardist.models import Config2D

    X_train, Y_train = load_bbbc039(data_dir, ''''''''train'''''''')
    X_val, Y_val = load_bbbc039(data_dir, ''''''''val'''''''')

    # StarDist 配置
    n_rays = 32  # 星凸多边形的射线数
    conevent-blocked= Config2D(
        n_rays=n_rays,
        grid=(2, 2),  # 下采样网格
        use_gpu=True,
        n_channel_in=1,  # 灰度输入
        train_batch_size=8,
        train_steps_per_epoch=200,
        train_epochs=100,
        unet_n_depth=3,
        unet_kernel_size=3,
        train_learning_rate=1e-4,
        train_reduce_lr={''''''''patience'''''''': 10, ''''''''factor'''''''': 0.5},
    )

    # 创建并训练模型
    model = StarDist2D(config, name=model_name, basedir=''''''''models'''''''')
    model.train(X_train, Y_train, validationevent-blocked=(X_val, Y_val))

    # 优化阈值
    model.optimize_thresholds(X_val, Y_val)

    return model

# 3. 推理与评估
def evaluate_stardist(model, data_dir, split=''''''''test''''''''):
    """评估 StarDist 在 BBBC039 测试集上的性能"""
    X_test, Y_test = load_bbbc039(data_dir, split)

    predictionevent-blocked= []
    for img in X_test:
        # StarDist 推理 — 返回标记矩阵和概率图
        labels, details = model.predict_instances(img)
        predictions.append(labels)

    # 计算 F1 分数 (IoU 阈值 0.5)
    taus = [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9]
    stats = [matching_dataset(Y_test, predictions, thresh=t) for t in taus]

    print("IoU阈值 | F1   | 精确率 | 召回率")
    for t, s in zip(taus, stats):
        print(f"  {t:.1f}  | {s.f1:.3f} | {s.precision:.3f} | {s.recall:.3f}")

    return predictions, stats

# 4. 可视化
def visualize_stardist(model, img, gt_mask=None):
    """可视化 StarDist 预测结果"""
    labels, details = model.predict_instances(img)

    fig, axes = plt.subplots(1, 3 if gt_mask is not None else 2,
                              figsize=(15, 5))
    axes[0].imshow(img, cmap=''''''''gray'''''''')
    axes[0].set_title(''''''''Input (BBBC039)'''''''')

    axes[1].imshow(labels, cmap=random_label_cmap())
    axes[1].set_title(f''''''''StarDist Prediction ({n_rays} rays)'''''''')

    if gt_mask is not None:
        axes[2].imshow(gt_mask, cmap=random_label_cmap())
        axes[2].set_title(''''''''Ground Truth'''''''')

    for ax in axes:
        ax.axis(''''''''off'''''''')
    plt.tight_layout()
    plt.show()

# 使用示例
model = train_stardist_bbbc039(''''''''BBBC039/'''''''')
predictions, stats = evaluate_stardist(model, ''''''''BBBC039/'''''''', ''''''''test'''''''')
# 预期: F1 ≈ 0.93 (IoU=0.5), F1 ≈ 0.85 (IoU=0.7)
§6.5 CellProfiler 管道自动执行
BBBC 每个图像集均附带 CellProfiler 管道文件 (.cppipe)。以下是使用 Python API 自动执行 CellProfiler 分析的代码:
"""
CellProfiler 管道自动执行 — BBBC021 MOA 分析
需要: cellprofiler >= 4.0
"""
import cellprofiler
import cellprofiler_core.pipeline
import cellprofiler_core.preferences
import cellprofiler_core.utilities
import pandas as pd
import numpy as np
from pathlib import Path

def run_cellprofiler_bbbc021(pipeline_path, image_dir, output_dir):
    """
    执行 BBBC021 CellProfiler 分析管道

    pipeline_path: .cppipe 文件路径
    image_dir: BBBC021 图像目录
    output_dir: 输出 CSV 目录
    """
    # 设置 CellProfiler 偏好
    cellprofiler_core.preferences.set_headless()  # 无 GUI 模式
    cellprofiler_core.preferences.set_default_image_directory(image_dir)
    cellprofiler_core.preferences.set_default_output_directory(output_dir)

    # 加载管道
    pipeline = cellprofiler_core.pipeline.Pipeline()
    pipeline.load(pipeline_path)

    # 文件列表
    file_list = sorted(Path(image_dir).glob(''''''''*.tif''''''''))

    # 执行管道
    measurements = pipeline.run(
        image_set_generator=''''''''Files'''''''',
        images=[str(f) for f in file_list],
        initial_measurements=None
    )

    # 导出特征
    features = extract_features(measurements)
    return features

def extract_features(measurements, object_name=''''''''Cells''''''''):
    """从 CellProfiler measurements 提取特征矩阵"""
    # 获取所有测量通道
    features = {}
    for feature_name in measurements.get_feature_names(object_name):
        values = measurements.get_all_measurements(object_name, feature_name)
        features[feature_name] = values

    return pd.DataFrame(features)

def compute_morphological_profile(features, metadata,
                                   group_cols=[''''''''compound'''''''', ''''''''concentration'''''''']):
    """
    从细胞级特征计算处理级形态学谱

    features: (N_cells, D) 特征矩阵
    metadata: DataFrame with compound, concentration, replicate
    """
    # 合并特征与元数据
    df = features.copy()
    for col in group_cols:
        df[col] = metadata[col].values

    # 按处理分组取均值
    profile = df.groupby(group_cols).mean()

    # Z-score 归一化(以 DMSO 对照为参考)
    dmso_mask = profile.index.get_level_values(''''''''compound'''''''') == ''''''''DMSO''''''''
    dmso_mean = profile[dmso_mask].mean()
    dmso_std = profile[dmso_mask].std()

    profile_z = (profile - dmso_mean) / (dmso_std + 1e-8)

    return profile_z

# 使用示例
features = run_cellprofiler_bbbc021(
    pipeline_path=''''''''BBBC021/analysis.cppipe'''''''',
    image_dir=''''''''BBBC021/images/'''''''',
    output_dir=''''''''BBBC021/output/''''''''
)

profile = compute_morphological_profile(features, metadata)
# profile: (103, ~1500) — 103 个处理 × ~1500 形态学特征
CellProfiler vs 深度学习:CellProfiler 提取的 ~1,500 个手工特征(大小、形状、纹理、强度)在 BBBC021 MOA 分类上达到 94% NSC(Ljosa 2013)。深度学习方法(Ando 2017)通过更好的特征工程达到 96% NSC。但 CellProfiler 的优势在于可解释性——每个特征都有明确的生物学意义(如"核面积"、“线粒体纹理”),而 CNN 特征是黑盒。
§6.6 CellPose 通用细胞分割
CellPose (Stringer et al., Nature Methods 2021) 使用梯度流场进行通用细胞分割,在 BBBC038 上达到 F1 0.87(1.0 版本)到 0.92(3.0 版本):
"""
CellPose 分割 — BBBC038 多模态核分割
需要: cellpose >= 2.0
"""
from cellpose import models, io, plot
import numpy as np
import matplotlib.pyplot as plt

def run_cellpose_bbbc038(image_dir, model_type=''''''''cyto3''''''''):
    """
    在 BBBC038 上运行 CellPose 分割

    model_type: ''''''''cyto'''''''' (细胞质), ''''''''nuclei'''''''' (细胞核), ''''''''cyto3'''''''' (v3.0 通用)
    """
    # 加载预训练模型
    model = models.Cellpose(gpu=True, model_type=model_type)

    results = []
    for img_file in sorted(Path(image_dir).glob(''''''''*.png'''''''')):
        img = io.imread(str(img_file))

        # CellPose 推理
        masks, flows, styles, diams = model.eval(
            img,
            diameter=None,  # 自动估计直径
            channels=[0, 0],  # 灰度图像
            flow_threshold=0.4,  # 梯度流阈值
            cellprob_threshold=0.0,  # 细胞概率阈值
            min_size=15,  # 最小细胞面积
        )

        n_cells = len(np.unique(masks)) - 1  # 去除背景 (0)
        results.append({
            ''''''''image_id'''''''': img_file.stem,
            ''''''''n_cells'''''''': n_cells,
            ''''''''masks'''''''': masks,
            ''''''''flows'''''''': flows,
        })

    return results

# 评估
def evaluate_cellpose(results, ground_truth_dir):
    """计算 F1 分数"""
    from stardist.matching import matching_dataset
    preds = [r[''''''''masks''''''''] for r in results]
    gts = [load_gt(gt_dir / f"{r[''''''''image_id'''''''']}.png")
           for r in results]

    stats = matching_dataset(gts, preds, thresh=0.5)
    print(f"CellPose F1@0.5: {stats.f1:.3f}")
    print(f"Precision: {stats.precision:.3f}, Recall: {stats.recall:.3f}")
    return stats

# 人类在环训练 (CellPose 2.0+)
def human_in_the_loop_training(initial_images, initial_labels,
                                new_images, model_type=''''''''cyto3''''''''):
    """
    CellPose 2.0 人类在环训练:
    1. 预训练模型推理 → 2. 人工修正错误 → 3. 微调模型 → 重复
    """
    model = models.CellposeModel(gpu=True, model_type=model_type)

    # 初始训练
    model.train(
        initial_images, initial_labels,
        learning_rate=0.1,
        n_epochs=5,
        channels=[0, 0],
    )

    # 在新数据上推理 → 人工修正 → 再训练
    for round_idx in range(3):  # 3 轮在环
        new_masks = [model.eval(img)[0] for img in new_images]
        # 人工修正 new_masks (使用 GUI) → corrected_masks
        # model.train(new_images, corrected_masks, ...)
        pass

    return model
§6.7 数据增强策略
| 策略 |
适用任务 |
参数 |
说明 |
| 随机旋转 |
全部 |
0–360° |
显微镜图像无固定方向 |
| 水平/垂直翻转 |
全部 |
p=0.5 |
细胞无方向性 |
| 随机裁剪 |
分割/分类 |
256×256 |
BBBC038 图像尺寸不一 |
| 弹性形变 |
分割 |
α=1000, σ=50 |
模拟细胞形态变异 |
| 通道归一化 |
荧光 |
0.1–99.9 百分位 |
CytoImageNet 方法 |
| 高斯噪声 |
全部 |
σ=0.01 |
模拟传感器噪声 |
| 混合增强 (Mixup) |
分类 |
α=0.2 |
跨化合物特征 |
| 颜色抖动 |
H&E |
亮度/对比度 ±10% |
模拟染色变异 |
| CutMix |
分割 |
ratio=0.5 |
跨视野混合 |
§6.8 已知坑点
| # |
坑点 |
症状 |
解决方案 |
| 1 |
BBBC021 数据泄漏 |
使用简单 leave-one-out 而非 leave-one-compound-out → 准确率虚高 |
必须留出同一化合物的所有浓度和重复 |
| 2 |
BBBC038 集间泄漏 |
BBBC038 与 BBBC039 部分图像重叠 |
跨集使用时检查图像 ID 去重 |
| 3 |
BBBC038 二阶段诱饵 |
stage2_test_final 含大量非评分图像 (Usage=Ignored) |
仅使用 106 张 scored 图像评估 |
| 4 |
荧光通道归一化 |
不同批次荧光强度差异大 → 特征不可比 |
按 0.1/99.9 百分位逐通道归一化 |
| 5 |
BBBC039 mask 编码 |
彩色 mask 非标准二值标注 |
需解码 RGB → 实例标签矩阵 |
| 6 |
CellProfiler 版本 |
管道文件版本不兼容 |
使用 CellProfiler 4.x 重载旧管道 |
| 7 |
Cell Painting 批次效应 |
不同日期/板的对照分布漂移 |
每板含 DMSO 对照,做板间校正 |
| 8 |
BBBC017 无 ground truth |
64K 图像但无标注 |
仅适用于无监督/自监督学习 |
| 9 |
图像尺寸不统一 |
BBBC038 图像 70–512 px 不等 |
训练时 resize 或裁剪统一尺寸 |
| 10 |
浓度排除机制 |
BBBC021 不是所有 8 浓度都可用 |
按 moa.csv 中的 103 处理为准 |
§7 基准与排行榜
§7.1 BBBC021 MOA 分类排行榜
| 排名 |
方法 |
Per-Treatment NSC |
Per-Treatment NSCB |
Per-Well NSC |
文献 |
| 1 |
Ando et al. (2017) |
96% |
95% |
91% |
bioRxiv 2017 |
| 2 |
Ljosa et al. (2013) |
94% |
77% |
86% |
J. Biomol. Screening |
| 3 |
Pawlowski et al. (2016) |
91% |
— |
— |
bioRxiv 2016 |
| 4 |
Singh et al. (2014) |
90% |
85% |
— |
J. Microsc. |
NSC (Not-Same-Compound):不允许匹配到同一化合物。NSCB (Not-Same-Compound-or-Batch):不允许匹配到同一化合物或同一批次。
§7.2 BBBC038 (DSB 2018) 核分割排行榜
| 排名 |
团队 |
核心模型 |
竞赛分 |
Avg F1 |
Recall@0.7 |
Missed@0.7 |
Extra@0.7 |
| 1 |
ods.ai topcoders |
32× UNet/FPN 集成 |
0.6316 |
0.7120 |
77.62% |
22.38% |
14.55% |
| 2 |
jakubkie |
1× FC-FPN |
0.6147 |
0.6987 |
69.14% |
30.86% |
15.04% |
| 3 |
Deep Retina |
1× Mask-RCNN |
0.6141 |
0.7008 |
68.07% |
31.93% |
10.90% |
| — |
CellProfiler (参考) |
经典管道 |
— |
0.5281 |
59.35% |
40.65% |
39.55% |
竞赛分 = Avg F1 在 IoU 阈值 0.5–0.95 上的均值。冠军方案使用 8 种架构 × 4 副本 = 32 个网络的集成,基于 ImageNet 预训练编码器。
DSB 2018 Top-3 团队架构深度分析
| 维度 |
ods.ai topcoders (冠军) |
jakubkie (亚军) |
Deep Retina (季军) |
| 集成大小 |
32 个网络 (8 架构 × 4 种子) |
1 个网络 |
1 个网络 |
| 基础架构 |
UNet + FPN (8 种编码器) |
FC-FPN (Feature Pyramid) |
Mask R-CNN |
| 编码器 |
ResNet34/50/101, SE-ResNeXt, DenseNet, InceptionResNet |
ResNet-50 |
ResNet-101-FPN |
| 预训练 |
ImageNet |
ImageNet |
COCO |
| 输入尺寸 |
256×256 |
256×256 |
512×512 |
| 关键策略 |
多尺度 TTA + 伪标签半监督 |
深度监督 + 边界损失 |
ROI Align + 实例分割 |
| 后处理 |
连接组件 + 形态学 + 阈值优化 |
概率图模型 |
NMS + mask 合并 |
| 数据增强 |
翻转+旋转+弹性+颜色 |
翻转+旋转+弹性 |
翻转+旋转+颜色 |
| 半监督 |
✅ 用测试集伪标签训练 |
❌ |
❌ |
| 竞赛分 |
0.6316 |
0.6147 |
0.6141 |
冠军方案关键洞察:(1) 多样性集成 — 8 种不同架构编码器的集成比单一架构多副本更有效,说明架构多样性比随机种子多样性更重要;(2) 半监督伪标签 — 用初始模型在测试集上生成伪标签,再训练新模型,获得 ~1-2% 的提升;(3) 多尺度 TTA — 翻转 + 90° 旋转 + 多尺度推理的 8 种组合取平均。
后竞赛 SOTA 进展 (BBBC038/039)
| 年份 |
方法 |
BBBC038 F1 |
BBBC039 F1 |
关键创新 |
| 2018 (竞赛) |
ods.ai 集成 |
0.712 |
— |
32 网络集成 |
| 2018 |
U-Net |
0.82 |
0.88 |
编码器-解码器 |
| 2019 |
StarDist |
0.87 |
0.93 |
星凸多边形形状先验 |
| 2019 |
CellPose |
0.87 |
0.89 |
梯度流场 |
| 2020 |
Hover-Net |
0.89 |
0.91 |
悬停距离回归 |
| 2022 |
CellPose 2.0 |
0.91 |
0.92 |
人类在环训练 |
| 2023 |
StarDist 2.0 |
0.90 |
0.93 |
概率推理 + 3D |
| 2024 |
Cellpose 3.0 |
0.92 |
0.94 |
改进梯度 + 跨模态 |
趋势:从竞赛冠军 F1 0.71 到 CellPose 3.0 的 F1 0.92,5 年内 F1 提升 0.21。关键转变是从"暴力集成"到"形状先验"(StarDist 的星凸多边形、CellPose 的梯度流场),这些先验比纯 CNN 更适合细胞核的几何特性。
§7.3 深度学习方法演进
| 年份 |
方法 |
图像集 |
关键创新 |
性能 |
| 2015 |
U-Net |
BBBC038 |
编码器-解码器 + 跳连 |
IoU 0.82 |
| 2017 |
Mask R-CNN |
BBBC038 |
实例分割 + ROI Align |
F1 0.70 |
| 2018 |
StarDist |
BBBC039 |
星凸多边形核形状先验 |
F1 0.93 |
| 2019 |
CellPose |
BBBC038 |
梯度流场 + 通用细胞分割 |
F1 0.87 |
| 2020 |
Hover-Net |
BBBC038 |
像素级悬停距离回归 |
F1 0.89 |
| 2021 |
CytoImageNet |
BBBC (全部) |
894 类弱标签预训练 |
NSC 96% (BBBC021) |
| 2022 |
Cellpose 2.0 |
BBBC038 |
人类在环训练 |
F1 0.91 |
| 2023 |
StarDist 2.0 |
BBBC038 |
概率推理 + 3D 扩展 |
F1 0.93 |
| 2024 |
UNI (基础模型) |
BBBC021 |
病理基础模型迁移 |
NSC 98%+ |
§7.4 CytoImageNet BBBC021 迁移学习结果
CytoImageNet 使用 BBBC 作为预训练数据源之一(贡献 202/894 标签),在 BBBC021 上的迁移学习表现:
| 特征提取方式 |
ImageNet 预训练 |
CytoImageNet 预训练 |
融合 (ImageNet + CytoImageNet) |
| Merge + Norm |
85% NSC |
87% NSC |
92% NSC |
| Concat + Norm |
88% NSC |
86% NSC |
90% NSC |
| Merge (无 Norm) |
84% NSC |
85% NSC |
89% NSC |
| Concat (无 Norm) |
86% NSC |
84% NSC |
88% NSC |
关键发现:ImageNet + CytoImageNet 特征融合优于任一单独使用,说明两者学到的表征互补——ImageNet 捕捉通用纹理/形状,CytoImageNet 捕捉生物图像特异性特征。
§8 影响力与生态
§8.1 学术影响力
| 指标 |
数值 |
| 核心论文引用 |
500+ (Ljosa et al. 2012) |
| DSB 2018 论文引用 |
300+ (Caicedo et al. 2019) |
| 参赛队伍 |
3,891 队 (BBBC038 竞赛) |
| 贡献者实验室 |
16+ (BBBC038 图像贡献) |
| 下游预训练数据集 |
CytoImageNet (202/894 标签来源) |
§8.2 CellProfiler 生态全景
BBBC 生态全景
┌─────────────────────────────────────────────────────────────┐
│                      数据层 (Data)                            │
│  BBBC (47 集)  │  IDR  │  JUMP-CP  │  HPA  │  Recursion     │
├─────────────────────────────────────────────────────────────┤
│                     工具层 (Tools)                            │
│  CellProfiler  │  CellProfiler Analyst  │  ImageJ/Fiji       │
│  Cellpose  │  StarDist  │  ilastik  │  QuPath               │
├─────────────────────────────────────────────────────────────┤
│                    协议层 (Protocols)                         │
│  Cell Painting (6 染料/5 通道/8 细胞器)  │  JUMP-CP          │
├─────────────────────────────────────────────────────────────┤
│                    评估层 (Evaluation)                        │
│  NSC/NSCB (BBBC021)  │  F1@IoU (BBBC038)  │  DSB Score      │
├─────────────────────────────────────────────────────────────┤
│                    社区层 (Community)                         │
│  Broad Institute  │  Kaggle  │  HuggingFace  │  Cytodata    │
└─────────────────────────────────────────────────────────────┘
§8.3 关键衍生项目
| 项目 |
关系 |
说明 |
| CytoImageNet |
源数据 |
BBBC 贡献 202/894 标签(第二大来源,仅次于 Recursion 651) |
| JUMP-CP |
协议延续 |
JUMP Cell Painting Consortium 使用 BBBC 定义的 Cell Painting 协议扩展至 >1M 化合物 |
| CellPose |
基准数据 |
使用 BBBC038 验证通用细胞分割模型 |
| StarDist |
基准数据 |
在 BBBC039 上开发星凸核分割模型 |
| HPA |
互补 |
Human Protein Atlas 使用类似 Cell Painting 概念但聚焦蛋白定位 |
§8.4 与其他基准数据集对比
| 数据集 |
图像数 |
任务 |
许可 |
特色 |
| BBBC |
~10.5M |
多任务 (3 类) |
CC0/CC BY |
最全面的显微图像基准集 |
| TissueNet |
~1M |
分割 |
CC BY |
多组织单细胞分割 |
| LiveCell |
~5K |
分割 |
CC BY |
手工标注活细胞 |
| CellPose |
~1K |
分割 |
BSD |
梯度流分割基准 |
| DSB 2018 (BBBC038) |
841 |
分割 |
CC0 |
最大核分割竞赛 |
| MoNuSeg |
~30K |
分割 |
CC BY |
多器官核分割 |
| CytoImageNet |
~890K |
分类 |
多许可 |
894 类弱标签预训练 |
| Recursion RxRx1 |
~125K |
分类 |
CC BY |
药物表型分类竞赛 |
§8.5 DAIMS 评分
| DAIMS 维度 |
评分 (0-1) |
满分 |
说明 |
| 1. 动机与组成 |
1.0 |
1 |
明确陈述算法比较动机 |
| 2. 组成与预处理 |
0.5 |
1 |
各集独立,无统一预处理文档 |
| 3. 采集与标注 |
0.5 |
1 |
各集采集方式不一,部分有详细标注工具说明 |
| 4. 分布与许可 |
1.0 |
1 |
CC0 为主,许可清晰 |
| 5. 预期用途 |
0.5 |
1 |
有推荐用途但非强制 |
| 6. 维护与更新 |
0.5 |
1 |
持续更新但部分集年份较久 |
| 7. 伦理与隐私 |
1.0 |
1 |
无人类患者数据,无伦理风险 |
| 8. 偏倚分析 |
0.0 |
1 |
未进行系统性偏倚分析 |
| 9. 可复现性 |
0.5 |
1 |
有 CellProfiler 管道但版本兼容性问题 |
| 10. FAIR 原则 |
0.5 |
1 |
Findable 可找到,Interoperable 一般 |
| 11. 质量控制 |
0.5 |
1 |
各集独立 QC,无统一标准 |
| 12. 版本管理 |
0.5 |
1 |
有版本号但变更日志不完整 |
| 13. 元数据标准 |
0.5 |
1 |
有 CSV 元数据但无统一 schema |
| 14. 使用统计 |
0.0 |
1 |
无下载/使用统计公开 |
| 15. 引用追踪 |
0.5 |
1 |
有引用列表但不完整 |
| 16. 社区参与 |
0.5 |
1 |
有贡献机制但贡献量有限 |
| 17. 资金可持续性 |
0.5 |
1 |
依赖 NIH 资助,长期可持续性不确定 |
| 18. 技术文档 |
0.5 |
1 |
有页面级文档但深度不一 |
| 19. 数据安全 |
1.0 |
1 |
无敏感数据 |
| 20. 访问机制 |
1.0 |
1 |
免费直接下载 |
| 21. 文件格式 |
0.5 |
1 |
TIFF/PNG 通用但无统一规范 |
| 22. 数据字典 |
0.5 |
1 |
BBBC021 有详细字典,其他集不一 |
| 23. 标注质量 |
0.5 |
1 |
部分手工标注质量高,部分为自动生成 |
| 24. 多样性 |
0.5 |
1 |
物种/细胞类型多样但来源集中于 Broad |
| 总计 |
15.5/24 |
24 |
65% |
§8.6 偏倚分析
| 偏倚维度 |
风险 |
说明 |
| 来源偏倚 |
中 |
多数图像集来自 Broad Institute 及合作实验室 |
| 物种偏倚 |
低 |
涵盖人/小鼠/果蝇/线虫/大鼠/仓鼠 |
| 模态偏倚 |
中 |
以荧光为主,明场/DIC 较少 |
| 规模偏倚 |
高 |
最大集 (BBBC036 494 万) 与最小集 (BBBC033 2 张) 差异极大 |
| 标注偏倚 |
中 |
不同图像集标注质量和方法不一 |
| 时间偏倚 |
低 |
2012–2024 持续更新 |
§8.7 外部验证场景
| 场景 |
验证数据 |
迁移效果 |
说明 |
| BBBC038 → MoNuSeg |
MoNuSeg (H&E 多器官) |
F1 0.82→0.75 |
荧光→H&E 跨模态下降 |
| BBBC021 → RxRx1 |
Recursion RxRx1 |
NSC 下降 5% |
跨实验协议迁移 |
| BBBC039 → CellPose |
CellPose 测试集 |
F1 0.88 |
同模态迁移良好 |
| BBBC 全部 → CytoImageNet |
894 类分类 |
Top-1 61% |
弱标签预训练有效 |
| CytoImageNet → COOS-7 |
蛋白定位 (7 类) |
11-NN 77% |
跨物种迁移 |
| CytoImageNet → CyCLOPS |
酵母蛋白定位 (17 类) |
11-NN 85% |
跨物种迁移 |
§8.8 从 BBBC 到 JUMP-CP:Cell Painting 的规模化演进
BBBC 的 Cell Painting 数据集(BBBC022/036/047)为 JUMP Cell Painting Consortium (JUMP-CP) 奠定了基础。JUMP-CP 是 BBBC 精神的直接延续和规模化扩展:
| 维度 |
BBBC (2012–2024) |
JUMP-CP (2021+) |
| 化合物数 |
30,000 (BBBC047, 最大集) |
>1,000,000 |
| 图像数 |
~10.5M (全部 47 集) |
~500TB (~数亿张) |
| 细胞系 |
U2OS / MCF-7 / A549 等 |
U2OS + A549 + 多系扩展 |
| 数据格式 |
TIFF / PNG |
Zarr (云端原生) |
| 访问方式 |
直接下载 |
AWS S3 + 凭证 |
| 许可 |
CC0 / CC BY |
CC BY 4.0 |
| 协议 |
Bray et al. 2016 |
JUMP-CP 标准化协议 |
| 特征提取 |
CellProfiler (~1,500 特征) |
CellProfiler + 深度学习 |
JUMP-CP 的关键创新:将 Cell Painting 从单实验室扩展到多实验室联盟(10+ 学术和工业实验室),通过严格的协议标准化和质控实现跨实验室可比性。BBBC 验证了 Cell Painting 的可行性和价值,JUMP-CP 将其规模化了 100 倍。
§8.9 生物图像基础模型的兴起
BBBC 在生物图像基础模型的兴起中扮演了重要角色:
| 基础模型 |
年份 |
预训练数据 |
BBBC 的角色 |
下游任务 |
| CytoImageNet |
2021 |
~890K 图像 (894 类) |
第二大标签来源 (202/894) |
MOA 分类、蛋白定位 |
| Cellpose |
2021 |
~1K 图像 |
BBBC038 验证基准 |
通用细胞分割 |
| StarDist |
2018 |
BBBC039 |
训练+评估数据 |
核分割 |
| BioViL |
2022 |
~600K 图文对 |
间接引用 |
图文检索 |
| PLIP |
2023 |
~200K 图文对 |
间接引用 |
零样本分类 |
| Virchow |
2024 |
1.5M WSI |
间接(病理而非显微) |
病理分类 |
趋势:生物图像领域正从"每个任务一个数据集一个模型"转向"大规模预训练 + 下游微调"。BBBC 作为最早的标准化基准集,既是预训练数据源(CytoImageNet),也是下游评估基准(几乎所有分割和分类方法都在 BBBC 上报告结果)。这一双重角色使 BBBC 成为生物图像 AI 生态的核心节点。
§9 资源
§9.1 官方资源
§9.2 代码仓库
§9.3 关键论文
| # |
论文 |
年份 |
引用 |
核心贡献 |
| 1 |
Ljosa V, Sokolnicki KL, Carpenter AE. “Annotated high-throughput microscopy image sets for validation.” Nature Methods 9(7):637 |
2012 |
500+ |
BBBC 原始发表 |
| 2 |
Caicedo JC et al. “Nucleus segmentation across imaging experiments: the 2018 Data Science Bowl.” Nature Methods 16(12):1247-1253 |
2019 |
300+ |
BBBC038 竞赛分析 |
| 3 |
Carpenter AE et al. “CellProfiler: image analysis software for identifying and quantifying cell phenotypes.” Genome Biology 7:R100 |
2006 |
3000+ |
CellProfiler 原始发表 |
| 4 |
Bray MA et al. “Cell Painting, a high-content image-based assay for morphological profiling using multiplexed fluorescent dyes.” Nature Protocols 11(9):1757-1774 |
2016 |
800+ |
Cell Painting 协议 |
| 5 |
Ljosa V et al. “Comparison of methods for image-based profiling of cellular morphological responses to small-molecule treatment.” J. Biomol. Screening 18(10):1321-1329 |
2013 |
150+ |
BBBC021 基准评估 |
| 6 |
Ando Y et al. “Improving image-based profiling by strength of phenotype.” bioRxiv 161422 |
2017 |
50+ |
BBBC021 SOTA 96% NSC |
| 7 |
Hua SBZ, Lu AX, Moses AM. “CytoImageNet: A large-scale pretraining dataset for bioimage transfer learning.” arXiv 2111.11646 |
2021 |
100+ |
BBBC 作为预训练源 |
| 8 |
Kamentsky L et al. “Improved structure, function, and compatibility for CellProfiler.” Bioinformatics 27(8):1179-1180 |
2011 |
1000+ |
CellProfiler 2.0 |
| 9 |
Caicedo JC et al. “Data-analysis strategies for image-based cell profiling.” Nature Methods 14(9):849-863 |
2017 |
300+ |
图像谱分析方法论 |
§9.4 BibTeX 引用
@article{ljosa2012bbbc,
  title={Annotated high-throughput microscopy image sets for validation},
  author={Ljosa, Vebjorn and Sokolnicki, Katherine L and Carpenter, Anne E},
  journal={Nature Methods},
  volume={9},
  number={7},
  pages={637},
  year={2012},
  doi={10.1038/nmeth.2083},
  pmid={22743765},
  pmcid={PMC3627348}
}

@article{caicedo2019dsb,
  title={Nucleus segmentation across imaging experiments: the 2018 Data Science Bowl},
  author={Caicedo, Juan C and Goodman, Allen and Karhohs, Kyle W and Cimini, Beth A and Ackerman, Jeanelle and Haghighi, Marzieh and Heng, CherKeng and Becker, Tim and Doan, Minh and McQuin, Claire and Rohban, Mohammad and Singh, Shantanu and Carpenter, Anne E},
  journal={Nature Methods},
  volume={16},
  number={12},
  pages={12471253},
  year={2019},
  doi={10.1038/s41592-019-0612-7}
}

@article{carpenter2006cellprofiler,
  title={CellProfiler: image analysis software for identifying and quantifying cell phenotypes},
  author={Carpenter, Anne E and Jones, Thouis R and Lamprecht, Michael R and Clarke, Colin and Kang, In Han and Friman, Ola and Guertin, David A and Chang, Joo Han and Lindquist, Robert A and Moffat, Jason and Golland, Polina and Sabatini, David M},
  journal={Genome Biology},
  volume={7},
  pages={R100},
  year={2006},
  doi={10.1186/gb-2006-7-10-r100}
}
§9.5 相关数据集
| 数据集 |
关系 |
相似度 |
说明 |
| CytoImageNet |
源数据 |
高 |
BBBC 贡献 202/894 标签 |
| JUMP-CP |
协议延续 |
高 |
Cell Painting 协议规模化 |
| TissueNet |
互补 |
中 |
多组织分割基准 |
| DSB 2018 (BBBC038) |
包含 |
— |
BBBC 的竞赛子集 |
| MoNuSeg |
互补 |
中 |
H&E 核分割 |
| Recursion RxRx1 |
对比 |
中 |
药物表型分类竞赛 |
| Human Protein Atlas |
互补 |
中 |
蛋白定位分类 |
| LIVECell |
互补 |
中 |
手工标注活细胞分割 |
§10 人工验证
§10.1 核心数据验证
| 验证项 |
预期值 |
实际值 |
状态 |
| 图像集总数 |
47 |
47 (BBBC001–054, 缺 023/040/043/049) |
✅ |
| 核心论文 |
Nature Methods 2012 |
9(7):637, 2012 |
✅ |
| DOI |
10.1038/nmeth.2083 |
10.1038/nmeth.2083 |
✅ |
| PMID |
22743765 |
22743765 |
✅ |
| PMCID |
PMC3627348 |
PMC3627348 |
✅ |
| 引用量 |
500+ |
500+ (Scholar) |
✅ |
| 维护机构 |
Broad Institute |
Broad Imaging Platform |
✅ |
| 许可 |
CC0 为主 |
各集独立,CC0 为主 |
✅ |
§10.2 关键图像集验证
| 图像集 |
关键参数 |
验证来源 |
状态 |
| BBBC021 |
39,600 图像 / 113 化合物 / 12 MOA |
官方页面 |
✅ |
| BBBC038 |
841 图像 / 37,329 核 / 3,891 队 |
Nature Methods 2019 |
✅ |
| BBBC039 |
200 图像 / ~23,000 核 / 520×696 |
官方页面 |
✅ |
| BBBC036 |
4,944,970 图像 |
官方页面 |
✅ |
| BBBC047 |
4,757,760 图像 / 30K 小分子 |
官方页面 |
✅ |
| BBBC022 |
345,600 图像 |
官方页面 |
✅ |
| BBBC017 |
193,536 图像 |
官方页面 |
✅ |
| BBBC048 |
129,064 图像 |
官方页面 |
✅ |
| BBBC051 |
690,000 图像 |
官方页面 |
✅ |
| BBBC041 |
1,328 图像 |
官方页面 |
✅ |
§10.3 基准结果验证
| 基准 |
数值 |
验证来源 |
状态 |
| BBBC021 最高 NSC |
96% (Ando 2017) |
bioRxiv 161422 |
✅ |
| BBBC021 Per-Well NSC |
91% (Ando 2017) |
bioRxiv 161422 |
✅ |
| BBBC038 冠军竞赛分 |
0.6316 (ods.ai) |
Nature Methods 2019 Table 1 |
✅ |
| BBBC038 参赛队数 |
3,891 |
Nature Methods 2019 |
✅ |
| DSB 奖金 |
$100,000 |
Kaggle 官方 |
✅ |
§10.4 技术规格验证
| 验证项 |
预期 |
实际 |
状态 |
| Cell Painting 染料数 |
6 |
6 (Hoechst/ConA/SYTO14/Phalloidin/WGA/MitoTracker) |
✅ |
| Cell Painting 通道数 |
5 |
5 (DAPI/FITC/TRITC/TexasRed/Cy5) |
✅ |
| Cell Painting 细胞器数 |
8 |
8 (核/ER/核仁/RNA/actin/膜/高尔基/线粒体) |
✅ |
| CellProfiler 特征数 |
~1,500 |
~1,500 (Bray 2016) |
✅ |
| CytoImageNet BBBC 标签 |
202/894 |
202/894 (GitHub) |
✅ |
| Ground truth 类型 |
6 种 |
6 (C/F/O/B/Bnd/L) |
✅ |
§10.5 内容完整性校验
| 校验项 |
状态 |
| frontmatter §P 全 9 字段 |
✅ |
| JSON-LD @graph (MedicalWebPage + Dataset) |
✅ |
| H1 标题 |
✅ |
| §0 出版与审核声明 |
✅ |
| §1 概览 (30 秒速览 + 定位 + 分类 + 机构) |
✅ |
| §2 生物与技术背景 |
✅ |
| §3 关键图像集 (BBBC021/038/039/036/047/041 + 全集表) |
✅ |
| §4 数据格式与结构 |
✅ |
| §5 技术规格 |
✅ |
| §6 使用指南 (抉择矩阵 + 代码 + 增强 + 坑点) |
✅ |
| §7 基准与排行榜 |
✅ |
| §8 影响力与生态 |
✅ |
| §9 资源 (官方 + 代码 + 论文 + BibTeX + 相关) |
✅ |
| §10 人工验证 |
✅ |
| §C 校验表 |
✅ |
相关数据集导航
以下为站内 AI-Ready 数据集百科中与本词条共享多个主题标签的相关数据集,按相关度降序排列:
导航说明:本章节由全站统一标签体系自动计算生成(标签重合度算法),双向可达;点击链接可跳转至对应数据集词条。
